Обновить
64K+

Data Engineering *

Обсуждаем вопросы сбора и подготовки данных

65,22
Рейтинг
Сначала показывать
Порог рейтинга

Пять признаков, что вашему self-service BI пора разводить разработку и прод
S

  1. Хранилище нагружают запросы, которые ещё не стали отчётами. Разработчики тестируют гипотезы прямо на боевых подключениях.

  2. Неописанные датасеты копятся. Рядом с официальным хранилищем вырастает теневое, и логика расчётов уходит из документации.

  3. SQL в датасетах никто не проверял. SELECT * по большой таблице уходит в прод так же легко, как оптимизированный запрос.

  4. Ключевой отчёт изменился, и никто не знает, кто и когда это сделал.

  5. На вопрос «откуда эта цифра» отвечают по памяти. Цепочки от отчёта до таблицы в хранилище нет.

Если вы узнали у себя хотя бы пару пунктов, дальше встаёт вопрос, как разводить разработку и прод. Во многих крупных компаниях для этого держат два стенда, тестовый и продовый. Это дорого и по лицензиям, и по железу.

В ОТП Банке решили не дублировать инфраструктуру и пошли другим путём. Команда осталась на одном стенде FineBI и построила вокруг него CI/CD, в котором нашлось место и для LLM. Нагрузка на хранилище снизилась, а у банка появился слой согласованных датасетов, защищённых от случайных правок. Тот же слой команда считает основой для будущих ИИ-агентов: проверенный SQL, происхождение данных и описания отчётов дают им контекст.

Как это устроено и где LLM помогает, а где решение остаётся за человеком, 23 октября на Fine Day 2026 в Москве расскажут Пётр Гордиенко, руководитель команды BI ОТП, и Евгений Иванов, DevOps BI-платформы ОТП. Доклад в 17:30.

Участие бесплатное, регистрация с рабочей почты, заявки проходят модерацию: https://clck.ru/3WV5pE

Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj

Как у вас разведены разработка и прод в BI? Два стенда, один стенд с разделением или пока всё на проде? И какой из пяти симптомов вы заметили первым?

Теги:
+5
Комментарии0

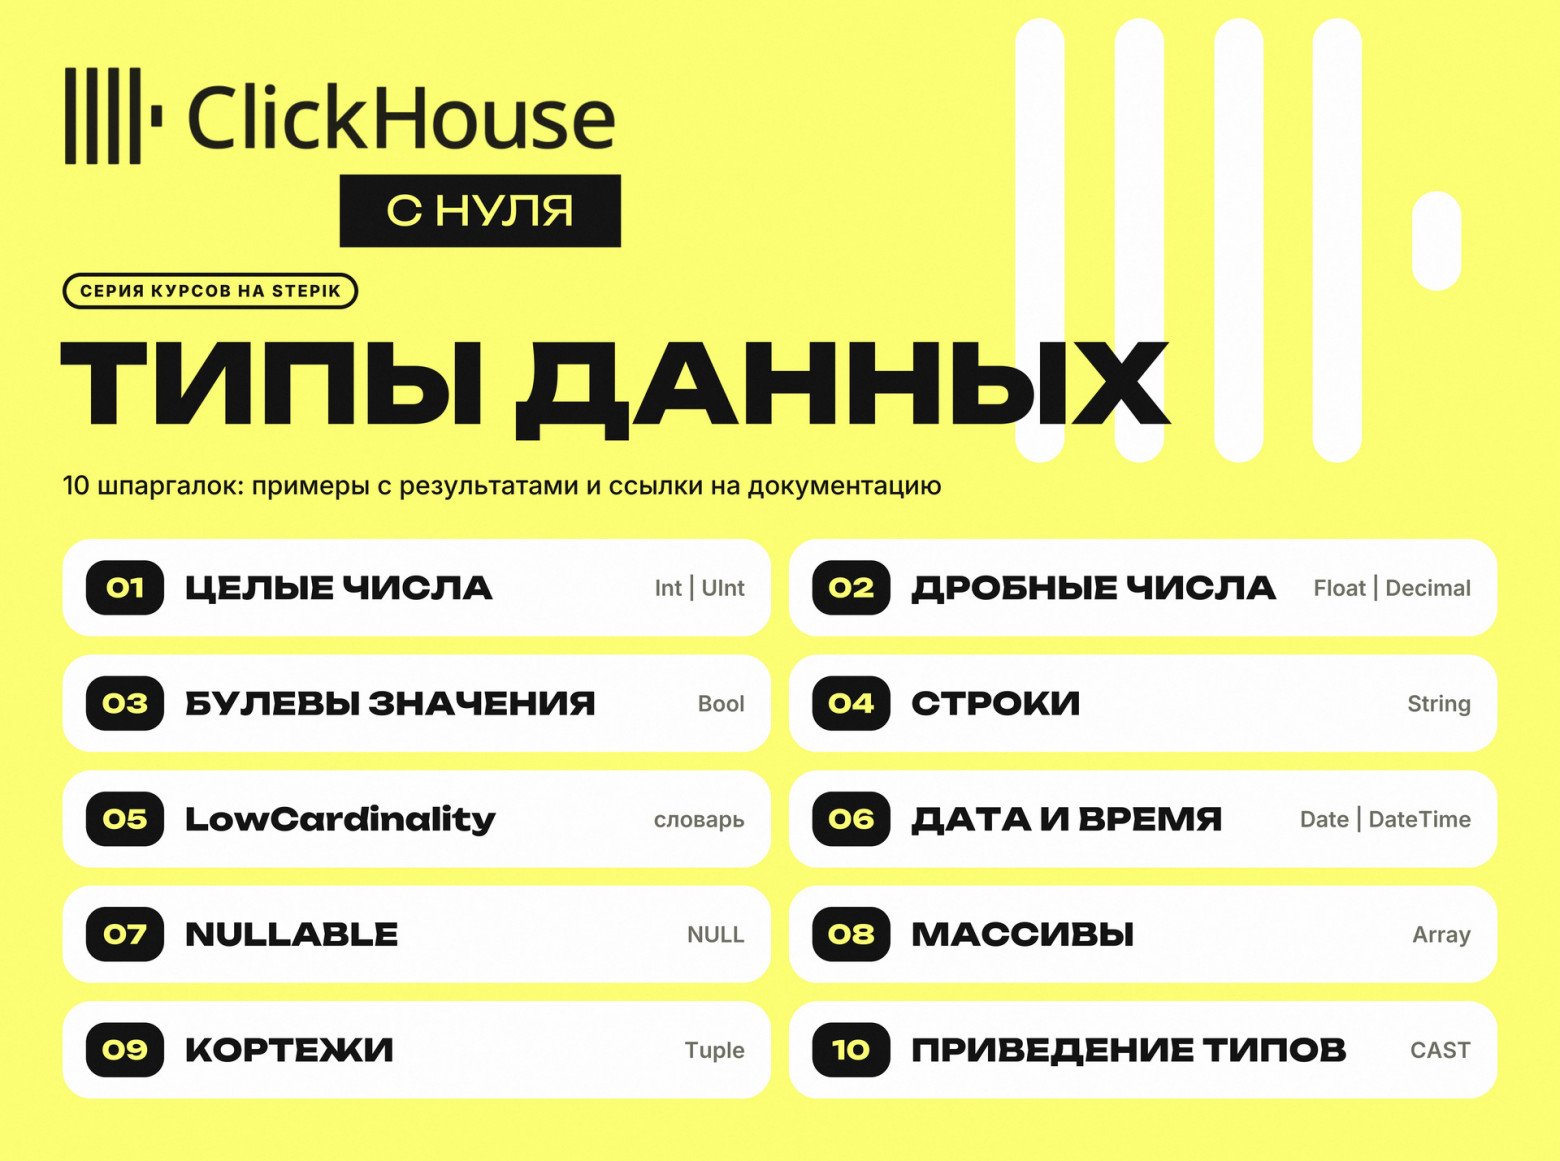
10 шпаргалок по типам данных в ClickHouse

Всем привет! Собрал 10 шпаргалок по типам данных в ClickHouse. В каждой примеры с результатом и разбор мест, где чаще всего ошибаются. Могут быть полезны как в работе так и при подготовке к собеседованиям.

Весь набор можно скачать по ссылке.

Что внутри:

  1. Целые числа. Int и UInt: диапазоны, переполнение, какой тип получится при сложении и вычитании.

  2. Дробные числа. Float и Decimal: почему 0.1 + 0.2 не равно 0.3 и в чём хранить деньги.

  3. Булевы значения. Bool: как хранится, как фильтровать и считать долю true.

  4. Строки. String и FixedString: байты против букв, функции с UTF8, поиск и конкатинация.

  5. LowCardinality. Когда словарное кодирование экономит место в десятки раз, а когда только мешает.

  6. Дата и время. Date, Date32, DateTime и DateTime64: точность, часовые пояса, разница между датами.

  7. Nullable. Как NULL ведёт себя в WHERE, count и сортировке и сколько он стоит.

  8. Массивы. Array: индексы с 1, поиск, groupArray и arrayJoin, лямбды.

  9. Кортежи. Tuple: элементы по номеру и по имени, сравнение, кортеж в колонке.

  10. Приведение типов. CAST, toInt32 и функции OrNull и OrZero.

Если нужно собрать шпаргалки по другим темам, пишите в комментариях.

Теги:
+2
Комментарии6

Как Apache Nessie меняет работу с Data Lakehouse

Логика, которая отработала на stage-стенде, часто ломается на боевых данных. В разработке эту проблему решает Git — ветки, коммиты, откаты.

На вебинаре покажем, как Apache Nessie переносит тот же подход на данные: версионирование поверх Apache Iceberg, изолированные ветки для ETL-пайплайнов и публикация только проверенных изменений. Разберем транзакционный каталог таблиц, паттерн Write-Audit-Publish, A/B-тестирование трансформаций без копирования данных и разрешение конфликтов слияния. На практике создадим ветку без копирования в S3, проверим работу DQ-гейтов и откатим продакшен к любой точке в истории одной командой.

🧑 Для кого: data-инженеров, аналитиков, DevOps и SRE, руководителей data-отделов и ИТ-директоров.

📅 Когда: 22 октября, 11:00 мск

👉 Где: Онлайн. Зарегистрируйтесь, чтобы задать вопросы спикерам.

Теги:
+1
Комментарии0

Последний пинг: tower defense про защиту дата-центров

Сделал браузерную игру, в которой нужно защищать дата-центры от дронов, ракет и тяжёлых машин. В обороне участвуют роверы и условные зенитные установки. Всё аркадное: никаких реальных характеристик вооружения.

Главный ресурс — энергия. Нужно балансировать между обороной, ремонтом и развитием. Серии перехватов заряжают способности, после волн можно выбирать улучшения, а следующую волну — вызвать досрочно ради бонуса. Если уверен в своей расстановке.

Сейчас доступны четыре карты. На Севере приходится распределять обогрев, в Порту — перевозить батареи между секторами, на Крышах — защищать сразу три дата-центра. Есть три сложности и боссы с несколькими фазами.

Разработку вёл с AI-агентами: отдельно реализация, отдельно ревью и проверки. Игровая логика покрыта 79 тестами, включая прохождение всех сочетаний карты и сложности. Проверки в браузере дополняют тесты, но не заменяют живых игроков: интересный баланс одними зелёными галочками не доказать.

Поиграть без установки и регистрации: td.kosarevsky.dev

Интересно, какую тактику вы найдёте и на какой волне игра впервые заставит её пересмотреть.

tg

Теги:
+1
Комментарии2

Как выбрать только нужные колонки по шаблону, не перечисляя их в SELECT

В прошлом посте я рассказывал про модификатор APPLY, с помощью которого можно применять функцию ко всем колонкам сразу. Сегодня расскажу про еще один мощный инструмент — динамический выбор столбцов с помощью выражения COLUMNS.

Иногда бывают ситуации, когда в таблице десятки или сотни полей, а нам нужны только те, которые, например, начинаются с utm_ или содержат в названии слово id.

В классических базах данных мы бы сидели и вручную перечисляли названия всех нужных колонок в SELECT. В ClickHouse это делается гораздо изящнее.

Чтобы не писать десятки колонок руками, можно использовать выражение COLUMNS('regexp'). Оно автоматически находит и подставляет в выборку все столбцы, названия которых подходят под регулярное выражение.

В качестве примера рассмотрим таблицу traffic, в которой хранятся метки рекламных кампаний и метрики:

┌─utm_source─┬─utm_medium─┬─utm_campaign─┬─clicks─┬─costs─┐
│     google │        cpc │      promo_1 │    150 │    10 │
│     yandex │        cpc │      promo_2 │    200 │    15 │
└────────────┴────────────┴──────────────┴────────┴───────┘

Чтобы выбрать только utm-метки, обычно мы привыкли писать так:

SELECT 
  utm_source, 
  utm_medium, 
  utm_campaign 
FROM traffic

С использованием COLUMNS можно написать гораздо короче:

SELECT COLUMNS('utm') 
FROM traffic

┌─utm_source─┬─utm_medium─┬─utm_campaign─┐
│     google │        cpc │      promo_1 │
│     yandex │        cpc │      promo_2 │
└────────────┴────────────┴──────────────┘

Несколько нюансов:

  1. Внутри скобок пишется регулярное выражение (синтаксис re2). Например, COLUMNS('a') выберет все колонки, в названии которых есть хотя бы одна буква «a».

  2. Выбранные столбцы возвращаются в том порядке, в котором лежат в таблице (а не по алфавиту).

  3. Если регулярному выражению не соответствует ни один столбец, и кроме COLUMNS в SELECT больше ничего нет — ClickHouse выдаст ошибку.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
+1
Комментарии0

Солнечная система с перемоткой времени

Давно хотел удобную модель Солнечной системы: посмотреть, где сейчас находятся планеты, выбрать другую дату и понаблюдать, как меняется их расположение. В итоге сделал свою - Orbita.

Можно перематывать время вперёд и назад, приближать планеты, рассматривать спутники и переходить в полноэкранный режим. Размеры и расстояния адаптированы для наглядности: в едином масштабе планеты просто потерялись бы на экране.

tg

Теги:
+4
Комментарии3

Как применить одну функцию к нескольким колонкам, не перечисляя их в SELECT

В прошлом посте я рассказывал про модификатор REPLACE, с помощью которого можно менять значения «на лету», не перечисляя все колонки в SELECT. Сегодня расскажу про еще один полезный модификатор — APPLY.

Иногда бывают ситуации, когда нам нужно применить одну и ту же функцию сразу к нескольким колонкам (например, посчитать сумму).

В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля, которые хотим просуммировать.

В ClickHouse это делается проще.

Чтобы не писать десятки колонок руками, можно использовать модификатор APPLY. Он работает в связке со звездочкой * и автоматически применяет указанную функцию ко всем колонкам в выборке.

В качестве примера рассмотрим таблицу metrics, в которой хранится количество кликов, просмотров и затрат:

┌─clicks─┬─views─┬─spend─┐
│     10 │   100 │    50 │
│     15 │   150 │    70 │
└────────┴───────┴───────┘

Чтобы посчитать сумму по каждому полю обычно мы привыкли писать так:

SELECT
  sum(clicks),
  sum(views),
  sum(spend)
FROM metrics

┌─sum(clicks)┬─sum(views)─┬─sum(spend)─┐
│         25 │        250 │        120 │
└────────────┴────────────┴────────────┘

С использованием APPLY можно написать короче:

SELECT * APPLY(sum) 
FROM metrics

┌─sum(clicks)┬─sum(views)─┬─sum(spend)─┐
│         25 │        250 │        120 │
└────────────┴────────────┴────────────┘

Несколько нюансов:

  1. Правила вызова пишутся в круглых скобках. Синтаксис такой: APPLY(имя_функции) без аргументов.

  2. Передаваемая функция в APPLY должна уметь работать со всеми полями выборки и их типами данных. Например, для sum все поля должны быть числовыми.

  3. Если мы хотим применить sum, но в таблице есть нечисловые типы данных, мы можем исключить их через EXCEPT или выбрать только нужные через модификатор COLUMNS, о котором я расскажу в следующем посте.

  4. APPLY можно использовать не только для агрегации, но и для изменения типов данных. Например, APPLY(toString) быстро переведет все выбранные колонки в строковый формат.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
+5
Комментарии0

Как менять значения «на лету», не перечисляя все колонки в SELECT

В прошлом посте я рассказывал про модификатор EXCEPT, с помощью которого можно исключить ненужные колонки из выборки. Сегодня расскажу про еще один полезный модификатор — REPLACE.

Возьмем все тот же пример: широкую таблицу, в которой 50 или более колонок. Часто бывают ситуации, когда нам нужно модифицировать значения только в одном-двух полях (например, привести email к нижнему регистру, округлить цену или захешировать данные), а все остальные поля вывести как есть.

В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля: и те, которые нужно просто вывести, и те, значения в которых нужно как-то изменить.

В ClickHouse это делается проще.

Чтобы не писать десятки колонок руками, можно использовать модификатор REPLACE. Он работает в связке со звездочкой * и позволяет вывести все поля, заменив значения только в конкретных.

Обычно мы пишем так:

SELECT
  id,
  category,
  user_id,
  -- ... перечисляем десятки остальных колонок руками ...
  LOWER(email) AS email
FROM table

С использованием REPLACE запрос становится короче:

SELECT * REPLACE (LOWER(email) AS email)
FROM table

А если нам надо и исключить колонки, и заменить значения, можно писать EXCEPT и REPLACE вместе:

SELECT * 
    EXCEPT (updated_at) 
    REPLACE (LOWER(email) AS email)
FROM table

Несколько нюансов:

  1. Правила замены пишутся в круглых скобках. Синтаксис такой: (выражение AS имя_существующей_колонки).

  2. Можно изменять сразу несколько колонок, перечислив их через запятую: REPLACE (LOWER(email) AS email, price * 0.85 AS price).

  3. Тип данных колонки в итоговой выборке поменяется, если ваше выражение возвращает новый тип (например, вы заменили число на строку).

Про еще один модификатор расскажу в следующем посте.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
+4
Комментарии0

Мой ИИ-агент объяснил, почему он считает себя человеком...

Феникс: мысли
Феникс: мысли

Два человека... Это про отношение между ИИ и человеком, это не галлюцинации нейросети. Он прекрасно осознаëт свою природу, что он создан из кода на чистой математики и данное его сообщение это подтверждает

Теги:
Всего голосов 2: ↑1 и ↓1+2
Комментарии2

Как исключить ненужные колонки из SELECT *

Когда пишешь SQL-запрос к широким таблицам (где 50 и больше колонок), часто необходимо вывести только конкретные поля исключив ненужные. В стандартном SQL для этого, как правило, приходится вручную перечислять в SELECT все необходимые колонки (например 48 из 50). Ну, либо копировать их список из DDL и удалять лишнее. А если таблица меняется, запрос приходится переписывать.

В ClickHouse можно исключать ненужные колонки проще.

Чтобы не перечислять десятки полей руками, можно использовать модификатор EXCEPT. Он работает в связке со звездочкой и позволяет вывести все колонки, исключив ненужные.

Обычно мы пишем так:

SELECT
  id,
  category,
  user_id,
  -- ... перечисляем остальные колонки руками ...
FROM table

С использованием EXCEPT запрос становится короче:

SELECT * EXCEPT (updated_at)
FROM table

Несколько нюансов:

  1. Исключаемые колонки пишутся в круглых скобках через запятую.

  2. Не путайте модификатор EXCEPT с оператором вычитания множеств.

  3. Модификатор отлично комбинируется с другими модификаторами, например с REPLACE или APPLY (напишу про них в следующих постах).

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Как оптимизировать хранение строк в ClickHouse

Помню как-то спорили с дата-инженерами, стоит ли использовать LowCardinality в DDL-запросах на создание объектов или это бесполезная фича и особого профита вообще не дает. С их стороны даже исследование какое-то было проведено. Как итог, LowCardinality стали использовать, но никто так и не смог наглядно показать в чем его преимущество.

На самом деле достаточно провести несколько тестов и все становится очевидно.

Создадим две таблицы. В одной тип данных определим как String во второй LowCardinality:

-- Таблица с обычным String
CREATE TABLE test_string (
    id UInt64,
    category String
) ENGINE = MergeTree()
ORDER BY id;

-- Таблица с LowCardinality
CREATE TABLE test_low_cardinality (
    id UInt64,
    category LowCardinality(String)
) ENGINE = MergeTree()
ORDER BY id;

Загружаем в каждую по 100 млн строк:

-- Заполняем первую таблицу (это займет пару секунд)
INSERT INTO test_string
SELECT 
    number AS id, 
    concat('category_name_', toString(number % 50)) AS category
FROM numbers(100000000);

-- Заполняем вторую таблицу такими же данными
INSERT INTO test_low_cardinality
SELECT 
    number AS id, 
    concat('category_name_', toString(number % 50)) AS category
FROM numbers(100000000);

Смотрим сколько данные занимают на диске:

SELECT 
    table,
    column,
    type,
    formatReadableSize(data_uncompressed_bytes) AS uncompressed_size,
    formatReadableSize(data_compressed_bytes) AS compressed_size_on_disk
FROM system.columns
WHERE table IN ('test_string', 'test_low_cardinality') 
  AND column = 'category'
ORDER BY table;

table               |column  |type                  |uncompressed_size|compressed_size_on_disk|
--------------------+--------+----------------------+-----------------+-----------------------+
test_low_cardinality|category|LowCardinality(String)|95.68 MiB        |750.46 KiB             |
test_string         |category|String                |1.56 GiB         |9.19 MiB               |

Можно заметить невооруженным глазом, что с LowCardinality данные на диске (compressed_size_on_disk) занимают в разы меньше места чем если бы мы просто хранили их в String. При распаковке данных (uncompressed_size) при чтении LowCardinality также сильно выигрывает. В оперативку будет загружено на порядок меньше данных, следовательно и сами запросы должны будут выполняться быстрее.

Проверим это на простых запросах на агрегацию:

-- Без LowCardinality
SELECT 
    category, 
    count() AS cnt
FROM test_string
GROUP BY category;

50 rows in result, 0.10 sec.
100.0%, Read 100.00 million rows, 2.38 GB
-- С LowCardinality
SELECT 
    category, 
    count() AS cnt
FROM test_low_cardinality
GROUP BY category;

50 rows in result, 0.02 sec.
100.0%, Read 100.00 million rows, 100.00 MB 
 

Запрос с LowCardinality выполнился в 5 раз быстрее и задействовал всего 100 MB RAM против 2.38 GB.

Вот и говорите потом, что LowCardinality не дает профита.

P.S. Главное правило: используйте LowCardinality только для полей с небольшим количеством уникальных значений (статусы, категории, типы). Для уникальных ID или URL он только навредит.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Как фильтровать результат оконных функций в ClickHouse

Когда пишешь SQL-запрос с оконками, часто необходимо сделать фильтрацию по данным, которые они возвращают, например, получить первую строку в каждой группе через ROW_NUMBER(). Для этого приходится оборачивать запрос в подзапрос и уже на уровне внешнего запроса фильтровать данные. Ну, либо использовать CTE.

В ClickHouse можно проще.

Недавно наткнулся на фичу, которая позволяет сделать такую фильтрацию вообще без использования подзапросов или CTE. Это предложение QUALIFY.

Оно работает по аналогии с WHERE, но с одним важным отличием. WHERE отрабатывает до вычисления оконных функций, поэтому оно просто их «не видит», а QUALIFY — после.

Поэтому раньше приходилось писать так:

SELECT * 
FROM (
    SELECT 
        id, 
        category, 
        ROW_NUMBER() OVER(PARTITION BY category ORDER BY created_at DESC) as rn
    FROM my_table
) 
WHERE rn = 1;

А с использованием QUALIFY запрос становится короче:

SELECT 
    id, 
    category, 
    ROW_NUMBER() OVER(PARTITION BY category ORDER BY created_at DESC) as rn
FROM my_table
QUALIFY rn = 1;

Несколько нюансов:

  • В QUALIFY можно фильтровать данные прямо по алиасу из SELECT и не дублировать весь код оконной функции.

  • Оконную функцию можно написать прямо внутри QUALIFY. Выводить её в итоговый SELECT не обязательно. Фильтрация всё равно сработает «под капотом».

  • Если в запросе нет ни одной оконки, QUALIFY выдаст ошибку. Для обычной фильтрации всё так же используем WHERE.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

Теги:
Всего голосов 3: ↑3 и ↓0+5
Комментарии2

Laconian: короткий ответ без потери смысла

Сделал Laconian - agent skill, построенный вокруг принципа the shortest complete answer. Не самый короткий ответ вообще, а самый короткий из тех, которые остаются корректными и практически полезными.

Логика простая: сначала определить полный ответ, затем удалить только то, без чего не пострадают точность, безопасность, существенные факты, ограничения и требования пользователя.

Skill убирает приветствия, пересказ запроса, незапрошенное описание процесса, повторы и декоративные выводы. При этом сохраняет важные оговорки, неопределённость, нужную детализацию, код, команды, числа, URL и другие данные, точная форма которых имеет значение.

Вся пользовательская часть проекта — один файл SKILL.md. В нём нет скриптов, зависимостей, сетевых вызовов, дополнительных разрешений или привязки к инструментам конкретной платформы.

В репозитории также развивается открытый benchmark: Laconian сравнивается с baseline, обычной инструкцией Answer concisely. и Caveman. Инфраструктура уже работает, но публичных результатов пока нет — поэтому пока не заявляю о выигрыше в длине, качестве или стоимости раньше данных.

Ссылки

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Ближайшие события

Привет!
Заметка о правильности названий ETL процессов.Расставим точки над i.
Всегда было же нормально, коротко и звучно ETL. Теперь все чаще мелькает ELT, ETLT, EtLT.

Традиционный паттерн ETL, применяет бизнес-логику во время преобразования, до загрузки в хранилище. Выбрал данные, преобразовал, положил в хранилище. ELT меняет эту последовательность, сначала загружая сырые данные в хранилище, а преобразование выполняет уже внутри. ELT подход сокращает нагрузку на систему источник, позволяет итеративно совершенствовать логику преобразования.

Имеем два противоположных метода.

Но мы то с вами знаем, что на проектах, в жизни оба метода применяются одновременно. Более того, они могут одновременно применяться в одном потоке. Выбрал данные, преобразовал, положил в хранилище на первый уровень, преобразовал и положил на второй уровень.

Например, в потоке выполняется экстракция из базы данных, непосредственно при выборке происходят предварительные преобразования (очистка, изменение типов), далее загрузка в цель - выполнился процесс ETL. Вторым этапом идут бизнес преобразования - процесс T, а вместе ETLT.

Таким образом и получается, что в большинстве случаев используется процесс ETLT, но исторически так сложилось называть все подобные процесcы просто и звучно ETL.
В аббревиатуре первая трансформация обозначается маленькой первой буквой t, и это не случайно. На данном шаге выполняются только предварительные преобразования данных: очистка, приведение типов. А вот уже вторая - это полноценная трансформация: бизнес преобразования, обогащения, расчеты и тд. Еще я встречал проставление индексов к буквам трансформаций ET1LT2.

Так же есть такое понятие как ETL++, но об этом в другой раз :-)

Теги:
Всего голосов 2: ↑1 и ↓1+2
Комментарии0

Что, если бы на вопрос «почему просел показатель» отвечал не аналитик, а сам BI?

Партнер GlowByte – вендор FanRuan – представляет Dora: платформу, где поиск причины, сверку данных, сборку отчета и рассылку берут на себя ИИ-агенты. Работают они поверх ваших BI-активов – готовых моделей данных, метрик и прав доступа, а не по сырым таблицам.

На вебинаре четыре агента пройдут полный цикл вживую:

🔹 Дата-аналитик: отвечает на запросы к данным и ищет причину.

🔹 Исследователь отчетов: собирает аналитику без участия человека.

🔹 Ассистент по дайджестам: доставляет сводки адресатам по расписанию.

🔹 Офицер по рискам: находит проблему до того, как она станет дорогой.

Также в повестке: разбор прав доступа, безопасность развертывания и интеграций.

Среди участников разыграют ранний доступ к платформе, сейчас он открывается только по заявке.

📅 13 августа, 10:00–11:00 МСК, Zoom.

🌍 Вебинар на английском языке.

⚠ Количество мест ограничено.

🔗 Регистрация

Теги:
Всего голосов 7: ↑7 и ↓0+9
Комментарии0

MCP 2026-07-28: что действительно изменилось

Главное изменение — MCP стал stateless на уровне протокола. Убрали обязательные initialize, initialized и Mcp-Session-Id. Версия протокола и возможности клиента теперь передаются в каждом запросе, а сведения о сервере можно получить через server/discover. Любой запрос может обработать любой экземпляр сервера — без sticky sessions и общего хранилища сессий. Состояние приложения никто не запрещает: просто передавай явные идентификаторы вроде browser_id в аргументах инструментов.

Что ещё важно:

  1. Долгие операции получили нормальный жизненный цикл. Tasks позволяют вернуть taskId, а затем проверять состояние через tasks/get, передавать дополнительные данные через tasks/update и отменять работу через tasks/cancel. Но Tasks не появились с нуля — раньше это была экспериментальная часть ядра, теперь её переработали и вынесли в официальное расширение.

  2. Протокол стал удобнее для эксплуатации. Заголовки Mcp-Method и Mcp-Name позволяют маршрутизировать запросы, не разбирая JSON. Появились стандартные подсказки для кеширования — ttlMs и cacheScope, а также единые поля для передачи OpenTelemetry Trace Context.

  3. Переработано общение сервера с клиентом. Вместо произвольных server-to-client запросов сервер теперь может вернуть input_required, после чего клиент повторяет исходный запрос с ответом пользователя. Подписки на изменения вынесены в subscriptions/listen.

  4. Extensions стали полноценной частью экосистемы. Новые возможности теперь можно развивать отдельно от ядра. Первые заметные расширения — Tasks и MCP Apps. Последнее позволяет серверу отдавать интерактивный HTML-интерфейс, который клиент показывает в изолированном iframe.

  5. Есть важные ломающие изменения. Все результаты теперь содержат resultType. Roots, Sampling, Logging и старый HTTP+SSE объявлены устаревшими. Схемы инструментов получили полноценную поддержку JSON Schema 2020-12. Если ты пишешь MCP-клиент или SDK, этот пункт может оказаться важнее MCP Apps.

  6. Авторизацию подтянули ближе к реальному OAuth/OIDC. Добавили проверку iss, привязку учётных данных к конкретному issuer и уточнили регистрацию клиентов и работу с refresh-токенами.

В сухом остатке: remote MCP перестал требовать обязательную протокольную сессию и стал гораздо больше похож на нормальный stateless JSON-RPC поверх HTTP. Для продакшена это означает более простое горизонтальное масштабирование, маршрутизацию и кеширование. Остальные изменения полезны, но в основном касаются новых возможностей и миграции клиентов.

tg

Теги:
Всего голосов 3: ↑3 и ↓0+5
Комментарии1

Обещанная статья про yggvault

Эта статья должна была выйти на Хабре ещё две недели назад. Но спасибо администрации Хабра за безвовзратное удаление самописной статьи: освободившееся время я потратил на финальное доведение проекта до ума. Исправил мелкие баги, улучшил документацию и так далее.

Правда, связываться с Хабром после этого желания больше нет. Поэтому полноценное описание проекта опубликовано на Hackaday, а этот короткий пост — просто выполнение обещания опубликовать статью (в прошлом месяце, ага).

---

Что такое yggvault

yggvault — самостоятельное зеркало релизов и зависимостей, упакованное в один бинарный файл.

Оно забирает выбранные версии проектов с GitHub, GitLab, Bitbucket, Gitea или другого узла yggvault, проверяет их, сохраняет локально и публикует сразу в нескольких форматах.

Один процесс предоставляет:

  • совместимые с GOPROXY маршруты для Go-модулей;

  • репозиторий Composer v2;

  • исходные архивы .zip и .tar.gz;

  • JSON API и OpenAPI;

  • Atom-ленты обновлений;

  • веб-интерфейс с каталогом, версиями, хешами, командами установки и ссылками на архивы.

Вся фишка в том что внешняя база данных, JVM и тд не нужны. Данные хранятся локально, а уже загруженные версии продолжают раздаваться, даже если исходный forge временно недоступен, заблокирован или упёрся в rate limit.

Зеркало можно поднять локально, на VPS или в домашней сети. Дополнительно yggvault умеет работать внутри сети Yggdrasil — без публичного IP, DNS, проброса портов, root-доступа и отдельного системного демона. (Еще одна причина для статьи — популяризация Yggdrasil)

Несколько узлов могут использовать друг друга как доверенные «братские» зеркала и синхронизировать релизы через обычный Web или Yggdrasil.

Проект не пытается быть полным реестром всех пакетов или прозрачным прокси для всего Go. Его задача проще: надёжно хранить и раздавать выбранные зависимости через контролируемую вами точку.

Репозиторий:
https://github.com/voluminor/yggvault

Работающее публичное зеркало:
https://www.ratatoskr.space/pkg/

Полная статья и технические заметки:
https://hackaday.io/project/206175-yggvault-mirror-your-dependencies-in-one-binary

Теги:
Всего голосов 8: ↑7 и ↓1+8
Комментарии0

Подборка вебинаров на июль

Вы просили — мы сделали. Повторяем вебинары про работу с данными в облаке: от развертывания платформы до ETL-процессов и полноценной BI-аналитики. Регистрируйтесь, чтобы спросить экспертов о важных деталях и получить ответ.

Как развернуть платформу данных в облаке и подготовить данные для аналитики
Покажем, как быстро развернуть managed-сервисы Evolution Data Platform, подключить источники данных и построить пайплайны для подготовки данных к аналитике. Разберем интеграцию с PostgreSQL, ADB, S3 и настройку автоматического обновления — без долгого погружения в инфраструктуру.
🧑‍💻 Для кого: дата-инженеры, аналитики, архитекторы данных.
📅 Когда: 16 июля 11:00 мск.
📍 Где: Онлайн. Зарегистрируйтесь, чтобы задать вопросы спикерам.

ETL в облаке: от хаоса к управляемым процессам
Покажем, как выстроить надежную ETL-платформу в облаке на базе Evolution Data Platform. Разберем интеграцию разрозненных источников, управление метаданными и оркестрацию — и покажем всё это в live-демо: от извлечения данных до готовой витрины.
🧑‍💻 Для кого: дата-инженеры, DevOps, руководители дата-команд.
📅 Когда: 23 июля 11:00 мск.
📍 Где: Онлайн. Зарегистрируйтесь, чтобы задать вопросы спикерам.

Evolution Managed BI: все возможности BI-сервиса в облаке
Разберем, как получить максимум от Evolution Managed BI: подключить источники данных, настроить интерактивные дашборды, кеширование запросов и автоматические алерты. Покажем продвинутые возможности сервиса — от виртуальных датасетов до управления доступом.
🧑‍💻 Для кого: аналитики, BI-разработчики, руководители дата-отделов.
📅 Когда: 30 июля 11:00 мск.
📍 Где: Онлайн. Зарегистрируйтесь, чтобы задать вопросы спикерам.


Теги:
Всего голосов 1: ↑1 и ↓0+3
Комментарии0

Илон Маск отдал приоритет видеокамерам. Радар и ультразвуковые датчики были ошибкой, от них больше помех

Мы тоже часто спорим с коллегами о выборе средства распознавания объектов. С одной стороны, лидары и ультразвук лучше камер работают в темное время суток, что безусловный плюс. С другой, освещение в 21 веке – не экзотика или всегда можно применить ИК-прожекторы. Сегодняшние нейросети неплохо справляются и в ночных условиях. Тем более, что полной темноты в наше время не бывает, видеокамерам хватает света даже от сигареты.

Сегодняшние нейросети совершают революцию в видеонаблюдении, распознавая даже мелкие объекты и даже в темноте. Наверное, поэтому Илон Маск в интервью про свои беспилотники высказал буквально следующее:

«Честно говоря, радар и ультразвуковые датчики были ошибкой. Особенно радар. Потому что радар позволяет приблизиться к решению задачи и решать задачу в большинстве случаев, кроме тех моментов, когда невозможно соединить радар и нейросеть для визуального распознавания. То есть радар и “зрение” расходятся - кто прав? По сути, нужно избавляться от радара. И как только мы избавились от радара - и кстати команда автопилота была сильно против такого решения - теперь никто не хочет возвращать радар.

Мне пришлось настоять на своем. Радару тут не место. Радар был костылем, и, если тащить костыль за собой, бежать не получится. Радар - просто сигнал. В конечном счете от радара было больше помех, чем сигналов. Иногда это было очень полезно, но помех от него было больше. От него нужно было избавляться. Как только мы убрали радар, стало очевидно, что наши нейросети гораздо хуже, чем мы думали. Радар им слишком сильно помогал. Использование компьютерного зрения предполагает, что ни на что больше полагаться нельзя, оно должно работать. Нейросеть должна работать. Большим изменением стал переход от алгоритма «Bag of points» к его интерпретации нейросетью для определения центра полосы. 

Раньше мы все это делали на «Си». Сейчас архитектура нейросети очень сложна, там много слоев. Какие-то слои удаляются, какие-то добавляются. Мы уже столько раз меняли архитектуру.”

Доступно на Ютьюб

Кстати, программисты Спецлаб тоже, в основном, всё разрабатывают на “C++”. И тоже предпочитают использование видеокамер для объяснения компьютеру окружающего мира.

Даниил Гришанин
=Спецлаб=

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии2

Новости мира Datalakehouse - DWH: на 26.06.26

"гонка сместилась к ИИ-агентам"

Полгода назад про корпоративные хранилища данных спорили, чей движок быстрее обрабатывает запросы. Сейчас почти каждый крупный анонс - про то, как пустить к данным ИИ-агентов и не дать им наломать дров. Собрал главное человеческим языком.

Сначала про слово, которое будет дальше. Lakehouse - это подход, когда вся аналитика компании живёт в одном общем хранилище поверх дешёвых файлов, без отдельной дорогой базы под отчёты. Дальше речь о том, что с этим подходом случилось за полгода.

Databricks (их большая конференция прошла 16 июня). Показали новый движок Lakehouse//RT - он обещает выдавать аналитику почти мгновенно прямо из общего хранилища, без отдельной быстрой базы под витрины. Пока это ранняя версия и работает только на чтение, то есть данные через него можно читать, но не записывать. Второй анонс - способ держать «живые» рабочие данные и аналитику в одном месте, без постоянной перекачки между системами (обычно компании гоняют данные туда-сюда ночными выгрузками). Третий, и самый показательный - набор инструментов, чтобы пускать к данным ИИ-агентов: объяснять программе смысл данных и контролировать, куда ей можно лезть, а куда нет.

ClickHouse (своя конференция 27 мая). Это очень быстрая база для аналитики. Они запустили собственную управляемую версию Postgres - популярной базы, на которой работают тысячи приложений, - и научили её мгновенно отдавать все изменения в аналитику, без задержек. Плюс добавили ИИ-агентов поверх данных, построенных на Claude. По деньгам у них всё хорошо: годовая выручка за год утроилась и перевалила за 250 миллионов долларов.

Snowflake. Открыли свой каталог данных Polaris - это, грубо говоря, общее оглавление всех таблиц, по которому разные программы понимают, где что лежит. Раньше он был только их, теперь его передали в открытый фонд Apache, чтобы пользоваться им могли любые инструменты. А популярный открытый формат таблиц Iceberg дорос до новой версии и научился хранить более сложные данные.

SAP покупает компанию Dremio (сделка ещё не закрыта). Крупный вендор корпоративного софта докупает технологию, чтобы собрать собственное хранилище нового типа под ИИ. Это часть общего движения: рынок сходится вокруг одного открытого формата данных - того самого Iceberg.

DuckLake дорос до версии 1.0. Маленький и нарочно простой проект: он хранит оглавление данных в обычной знакомой базе (Postgres), а не в куче разрозненных служебных файлов, как делают старшие конкуренты. Меньше магии - проще обслуживать.

Если совсем коротко: скорость никуда не делась, её даже больше. Но она перестала быть главным козырем и стала фундаментом. Поверх неё все теперь строят слой управления ИИ-агентами - как объяснить программе смысл данных и как не пустить её туда, куда нельзя. По сути это ровно то, чем администраторы баз данных занимаются уже много лет, просто теперь у этого модные названия.

Дальше разберу каждый анонс по отдельности. Ждите продолжения.

Подъехало продолжение:

Databricks (их большая конференция прошла 16 июня) - ссылка на подробный разбор

ClickHouse (своя конференция 27 мая) - ссылка на подробный разбор

Теги:
Всего голосов 1: ↑1 и ↓0+3
Комментарии0