Обновить
4
Glazkov Artem@Allront

Эксперт по операционализации аналитики

2
Подписчики
Отправить сообщение

Выбираем MLOps инструменты с учётом зрелости команды

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели6.3K

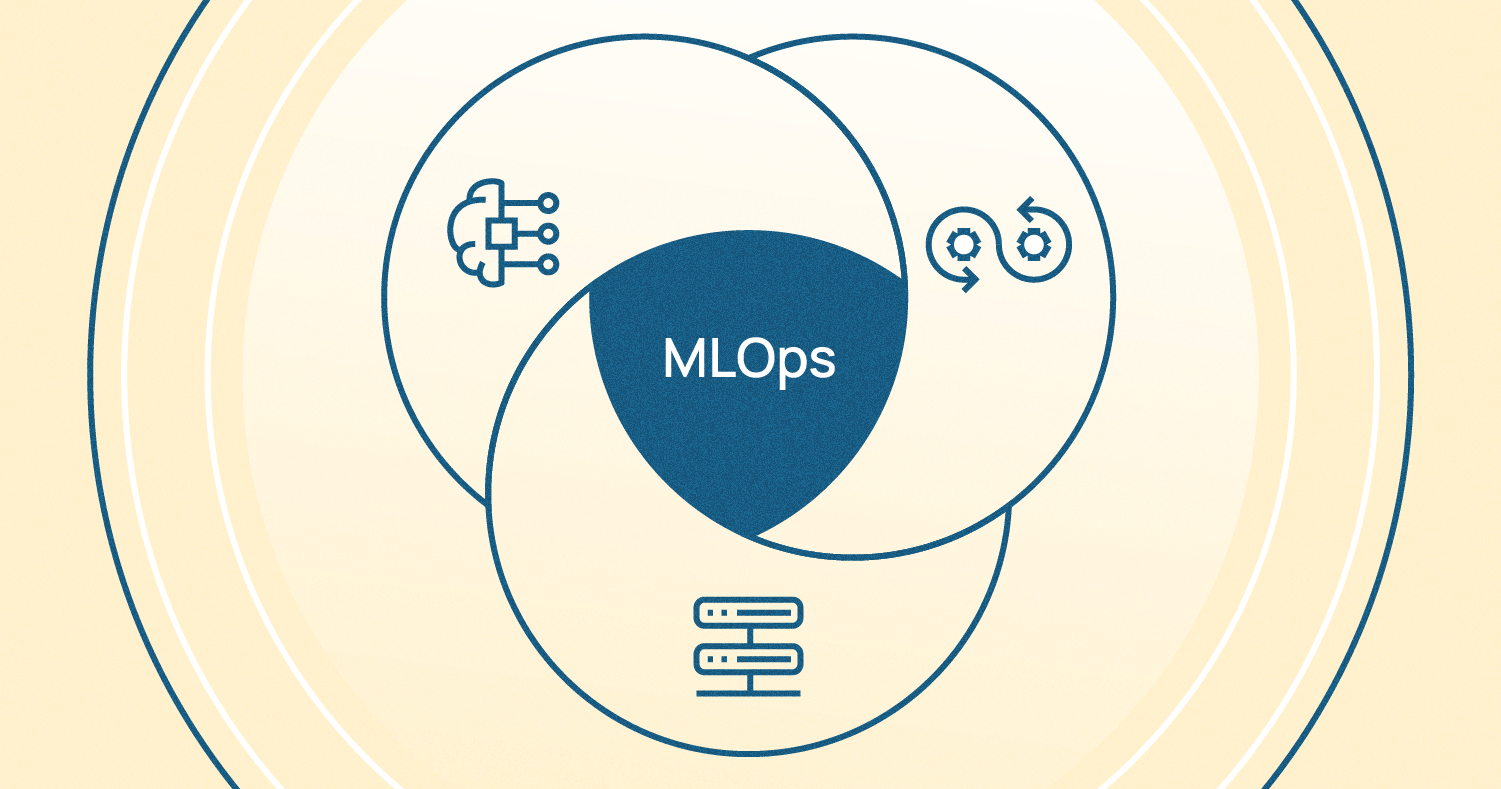
MLOps — это набор практик и процессов для управления жизненным циклом ML-моделей: от обучения до продакшна и поддержки. Если копнуть глубже, окажется, что решений куча и выбор неочевиден.

Разберем, почему не всё так просто и как принимать решения о внедрении MLOps-инструментов.

Читать далее

Компьютерное зрение и магия перспективы: от пикселей к реальным размерам

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.8K

В этой статье я поделюсь опытом решения интересной практической задачки: определения линейных размеров объектов в кадре. Решение такой задачи оказалось полезным для множества приложений в компьютерном зрении и может быть использовано в картографировании, планировании, навигации, распознавании объектов, 3D-реконструкции и редактировании изображений.

Определения линейных размеров

Математическая оптимизация для бизнеса. Часть 1. Пассажирские авиалинии

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4.7K

В рамках серии статей по применению математической оптимизации для решения задач в бизнесе мне хотелось бы кратко, но ёмко раскрыть причины и предпосылки возникновения потребности у бизнеса решений задач такого класса, а также привести конкретные примеры кейсов, которые успешно реализованы в крупнейших компаниях мира. В отдельности каждый кейс заслуживает не менее 50 страниц текста для полноценного описания, я же постараюсь изложить главную суть решений и некоторые технические особенности в формате статей на Хабре.

Алгоритмы математической оптимизации относятся к категории Prescriptive – аналитики, наиболее сложного и ценного для бизнеса аналитического сегмента. Данная категория позволяет создавать сложные интеллектуальные системы принятия решения с целью максимизировать экономические, производственные и многие другие KPI в рамках заданных ограничений.  Математическая оптимизация имеет своё применение в каждом из видов бизнеса любого масштаба, включая промышленность, производство, розничную торговлю, транспорт и логистика, телеком, агросектор, энергетика, строительство, финансы, банкинг, спорт, кино, медицина, образование и т.д. В текущей статье пойдет речь о задачах в индустрии пассажирских авиалиний.

Читать далее

AutoML на практике — как делать автоматизацию, а не её иллюзию

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели19K

Привет, Хабр! Меня зовут Алексей Рязанцев, я Junior Data Scientist в Лаборатории Машинного обучения Альфа-Банка. Свой путь в Лаборатории я начал со стажировки летом-осенью 2023-го года, на которой для меня была интересная задача — разработать с нуля собственный AutoML в Альфа-Банке. 

Когда количество ML-моделей в компании исчисляется сотнями, процессы десятками, а фичи тысячами, вопрос «а нужен ли нам AutoML?» уже не стоит. Стоит другой вопрос - как сделать AutoML так, чтобы он был действительно полезен и им реально хотелось пользоваться? 

В этом посте я подробно освещу путь создания нашего AutoML-сервиса: расскажу обо всех препятствиях, которые мы преодолели, и поделюсь инсайтами, полученными в ходе работы. Вместе мы пройдем полный путь практического AutoML - начиная от его первоначальной идеи и мотивации, и заканчивая текущими успехами и планами на будущее.

Читать далее

Что такое MLOps и как мы внедряли каскады моделей

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели6.4K

Привет, меня зовут Александр Егоров, я MLOps инженер. В статье расскажу о том, как мы в банке выкатываем огромное количество моделей. Разберём не только пайплайн по выкладке отдельных моделей, но и целые каскады.

Читать далее

Раскрывая потенциал GenICam и Harvester в системах компьютерного зрения

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели4.3K

Опыт работы с крупнейшими производственными площадками позволяет сказать, что на сегодняшний день целый ряд производств считает современные цифровые технологии и, в частности технологии искусственного интеллекта, неотъемлемой частью производства. В ряде компаний создана экосистема цифровых продуктов, сформированы мощные команды поддержки и развития, создана культура разработки, внедрения и использования цифровых продуктов. Большинство крупных производственных компаний вступило в новую эру цифровизации производства в промышленных масштабах.

Читать далее

Запускаем локальный ML-процесс в облаке с помощью DataSphere Jobs

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели4.9K

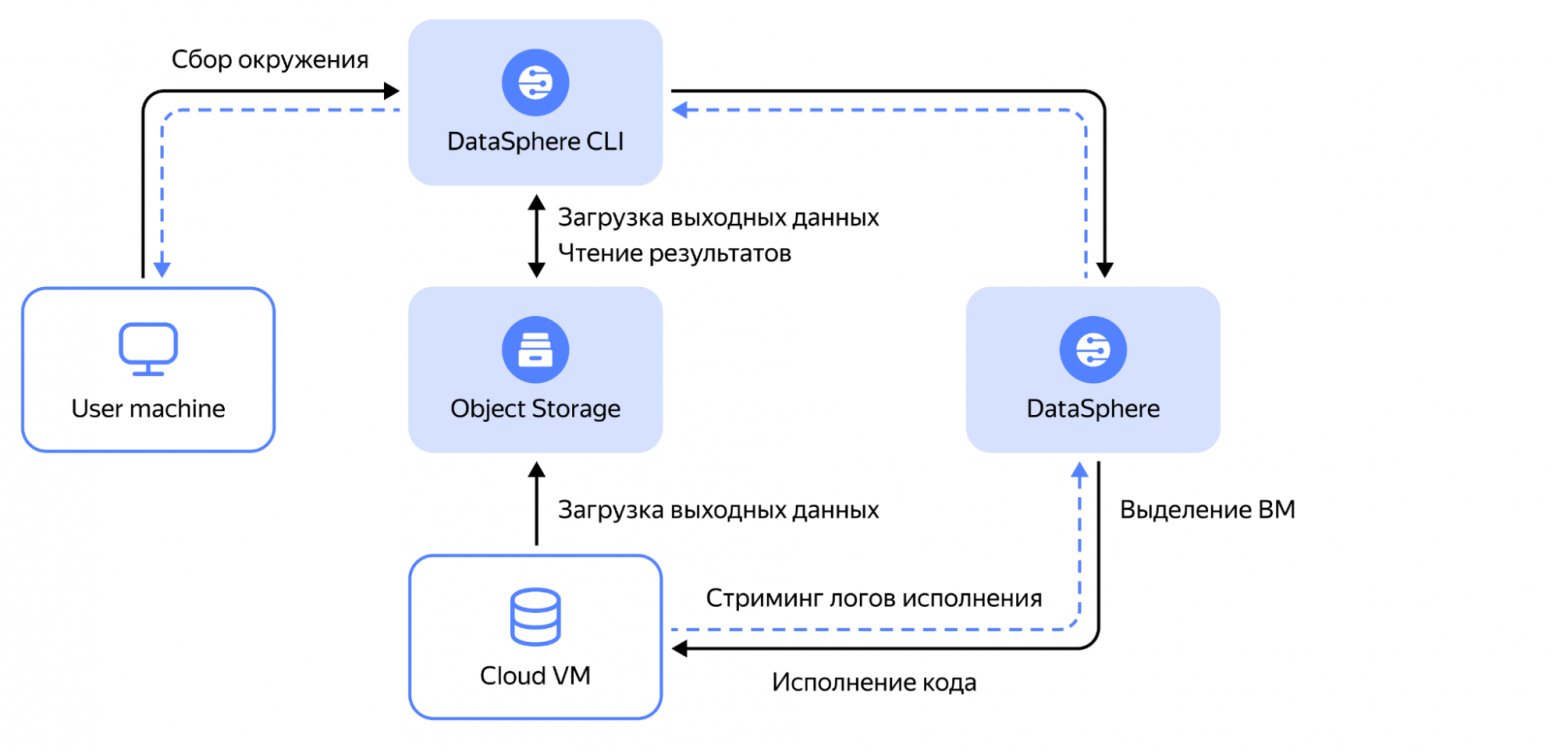
В сообществе ML-инженеров и дата-сайентистов популярны инструменты с быстрой обратной связью наподобие JupyterLab — они помогают легко и без лишних обвязок проверять гипотезы или создавать прототипы. Но довольно часто бывает, что при разработке ML-пайплайна, будь то инференс или обучение модели, хочется пользоваться установленной локально полноценной IDE, в которой открыт проект со многими зависимостями, окружением, сложной структурой. При написании кода и его отладке хочется пользоваться дебагером и уметь быстро менять код, а при запуске — скейлить ресурсы исполнения и не думать о том, как перенести код и окружение на продакшн-сервера. Всех этих возможностей в Jupyter-экосистеме из коробки нет, поэтому разработчикам часто приходится создавать костыли.

Помочь в решении этих задач могут инструменты для удалённого исполнения кода в ML. Сегодня на конкретном примере покажу, как устроен и как работает один из таких инструментов, созданный нами для пользователей облака, — DataSphere Jobs. А в следующий раз вместе с моими коллегами рассмотрим опенсорс-инструменты для подобных задач.

Читать далее

Сравнение Open Source BI-платформ

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели44K

Привет, Habr!

Меня зовут Остапенко Настя, я лидирую направление BI в компании Axenix. Год назад мы выпустили статью с большим обзором Российского рынка BI. На этот раз мы проведем сравнение трех популярных Open-Source BI-платформ: Apache Superset, Metabase и относительно нового участника - Yandex Datalens, который совсем недавно стал доступен в качестве Open-Source продукта.

Читать далее

Асинхронный API First

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели20K

API-First — один из популярных подходов к проектированию серверных приложений. Для обеспечения этого подхода создано множество программных продуктов. Однако сложно найти продукт, который поможет реализовать этот подход для серверных приложений, использующих брокеры сообщений в качестве средства интеграции —  такие, как Apache Kafka, RabbitMQ, Apache ActiveMQ. Мы решили это исправить и представляем вам свое решение AxenAPI.

Читать далее

Как ускорить вывод ML-моделей в 4 раза, или Как может выглядеть экосистема МLOps в банке

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели10K

Привет, я Андрей Качетов, Head of ML Operations в Альфа-Банке. Отвечаю за опромышливание всех ML-моделей в банке, строю новую платформу MLOps, а также формирую единый подход для работы с модельными данными (Feature Store).

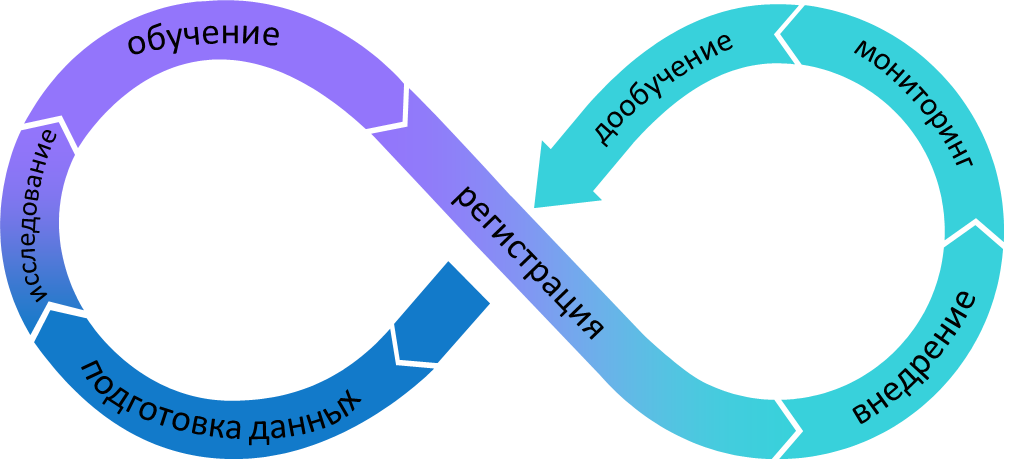
В статье, без картинок с «бесконечностями» Ops’ов, расскажу, как может выглядеть полноценный конвейер MLOps, что умеет и немного о том, как мы пришли к максимальной автоматизации процесса вывода моделей в промышленную эксплуатацию.

Читать далее

VaR как способ оценки риска. Исторический метод

Время на прочтение7 мин
Охват и читатели50K


В этой статье я хочу познакомить вас с популярным инструментом для оценки финансового риска VaR (ValueAtRisk). При этом я постараюсь использовать минимум экономических, математических и статистических терминов.

Главные идеи VaR были разработаны и применены в банке JP Morgan в 80-х. Широкое применение VaR получил в 1993 когда был одобрен Группой тридцати(G-30) как часть “лучших практик” для работы с деривативами(производными финансовыми инструментами). А позже стала одним из показателей риска банка по системе Базель II (набор международных рекомендации по банковскому регулированию). Идею используемую в VaR можно отследить до ранних работ лауреата нобелевской премии по экономике Гарии Марковица в 1952.
Читать дальше →

Миф или реальность? Типовые заблуждения про low-code инструменты анализа данных

Время на прочтение8 мин
Охват и читатели3.9K

Вокруг технологий всегда появляются мифы: фотоаппараты, похищающие душу, подавляющий свободную волю 5G, искусственный интеллект, который захватывает планету и отправляет киборга в прошлое… Всё это - примеры, основанные на страхе неизвестного, который, в свою очередь, является неотъемлемым свойством человеческого мышления.

Анализ данных и машинное обучение, упоминаемые под термином «искусственный интеллект», за последние годы постепенно становятся обыденностью. Использование инструментов продвинутой аналитики для многих организаций стало столь же привычным делом, как автоматизация бухгалтерского учёта или внедрение электронного документооборота.

В этой статье отобраны шесть наиболее популярных мифов вокруг low-code инструментов анализа данных. Насколько они близки к действительности - давайте обсудим.

Поехали!

Что такое MLOps? Самый подробный текст про работу с ML-системами, который вы найдете в интернете

Время на прочтение25 мин
Охват и читатели56K


В этом материале мы подробно разбираем концепцию MLOps. Более того, делаем это тремя способами. Сначала теоретически — через самую толковую, на наш взгляд, схему MLOps. Затем — концептуально, через артефакты, которые заложены в подходе. И наконец, через понимание MLOps как информационной системы.

Сохраняйте текст в закладки, потому что на данный момент это, возможно, самое полное описание MLOps на русском языке (и не перевод очередной англоязычной статьи!). Подарим мерч Selectel тому, кто пришлет ссылку на более развернутое описание концепции в комментариях.
Читать дальше →

Каким должен быть Feature Store, чтобы оптимизировать работу с ML-моделями

Время на прочтение6 мин
Охват и читатели13K

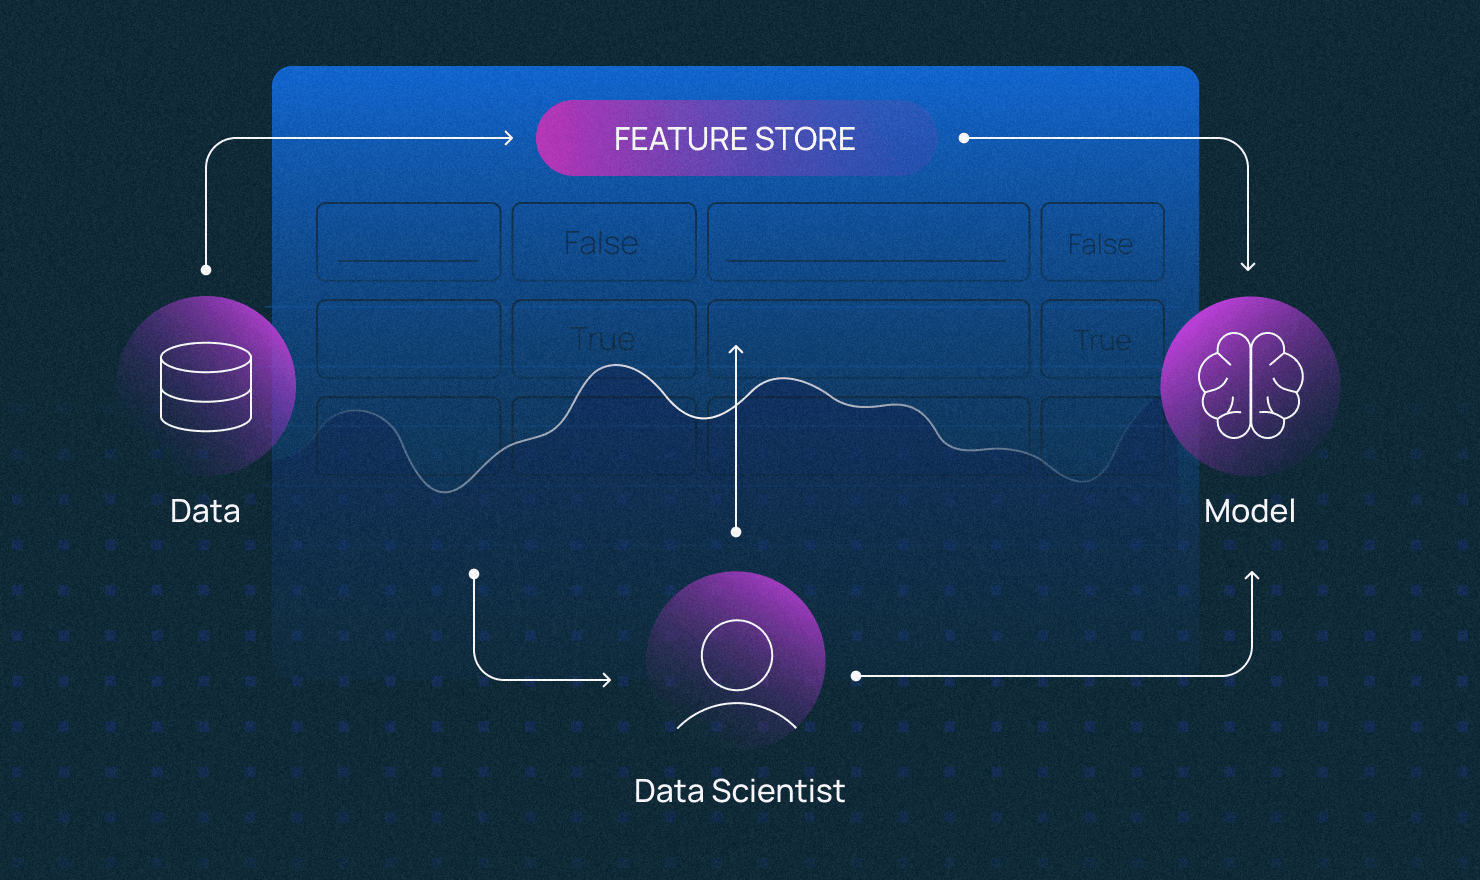
В работе с данными для обучения нейросетей много рутины: под каждую ML-модель нужно создать датасет, потом «вычеркнуть» лишние признаки (фичи) и протестировать точность предсказаний. Иногда при изменении датасета нужно собирать данные по новой. Это неудобно, если нужно переиспользовать уже собранные фичи для обучения новых моделей. Чтобы оптимизировать работу с данными, ML-инженеры объединили разные практики и сформировали парадигму Feature Store.

По мотивам выступления Артёма Глазкова (@Allront), ведущего эксперта MLOps в Polymatica, рассказываем о том, что нужно бизнесу от Feature Store сегодня, и разбираем архитектуру «эталонного» решения. Подробности под катом.
Читать дальше →

ModelOps на практике: переходим от отверточной сборки к конвейеру по управлению моделями

Время на прочтение8 мин
Охват и читатели5K


Привет хабр! Меня зовут Артем Глазков, я работаю консультантом в российском подразделении компании SAS. Сегодня я хочу рассказать про операционализацию аналитики на практическом примере проекта, который я сделал совместно с моим коллегой Иваном Нардини для крупной итальянской сырьевой компании. Я постараюсь сфокусироваться на наиболее важных деталях и преимуществах подхода ModelOps.

Согласно независимым исследованиям, операционализация аналитики является ключевым трендом развития в области Искусственного Интеллекта. Необходимо научиться не только строить точные модели машинного обучения, но и организовать эффективное управление их жизненным циклом. Без этого модель рискует навсегда застрять внутри стен ‘лаборатории данных’. Практика показывает, что именно там остаются более половины разработанных моделей. Это означает, что время и усилия, затраченные на создание таких моделей, так и не были компенсированы полезным эффектом от их применения.

После внедрения задача инструментов управления жизненным циклом моделей заключается в том, чтобы постоянно поддерживать модель в форме. Мир вокруг модели меняется — в отсутствие настроенного процесса контроля качества работы модели рано или поздно точность ее работы упадет ниже приемлемого значения. Инструменты мониторинга моделей позволяют своевременно выявить потребность в дообучении. Обновленная модель сможет увидеть новые закономерности в данных и правильно их учесть. В результате, удастся обеспечить стабильно высокое качество работы модели на этапе эксплуатации, а значит получить больше практической пользы от каждой разработки.
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Россия
Работает в
Зарегистрирован
Активность

Специализация

Ученый по данным, Инженер по данным
Ведущий
Python
Docker
SQL
Git
Linux
PostgreSQL
SAS