Обновить
23
Алексей Гаврилов@OnlyAnalyst

Аналитик данных, автор t.me/onlyanalystgroup

46
Подписчики
Отправить сообщение

Увеличение чувствительности A/Б-тестов с помощью Cuped. Доклад в Яндексе

Время на прочтение12 мин
Охват и читатели50K
CUPED (Controlled-experiment Using Pre-Experiment Data) — техника A/Б-экспериментов, которую стали применять в продакшене сравнительно недавно. Она позволяет увеличить чувствительность метрик за счёт использования данных, полученных ранее. Чем больше чувствительность, тем более слабые изменения можно замечать и учитывать в эксперименте. Первой компанией, внедрившей CUPED, была Microsoft. Теперь этой техникой пользуются многие международные фирмы. В своём докладе Валерий Бабушкин venheads объяснил, в чём заключается смысл CUPED и каких результатов можно достичь, а перед этим разобрал метод стратификации, который также улучшает чувствительность.


— Меня зовут Валерий Бабушкин, я директор по моделированию и анализу данных в X5 Retail Group и советник в Яндекс.Маркете. В свободное время преподаю в Высшей школе экономики и частенько летаю в Казахстан, преподаю в Нацбанке Казахстана.
Читать дальше →

Индуктивная статистика: доверительные интервалы, предельные ошибки, размер выборки и проверка гипотез

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели30K

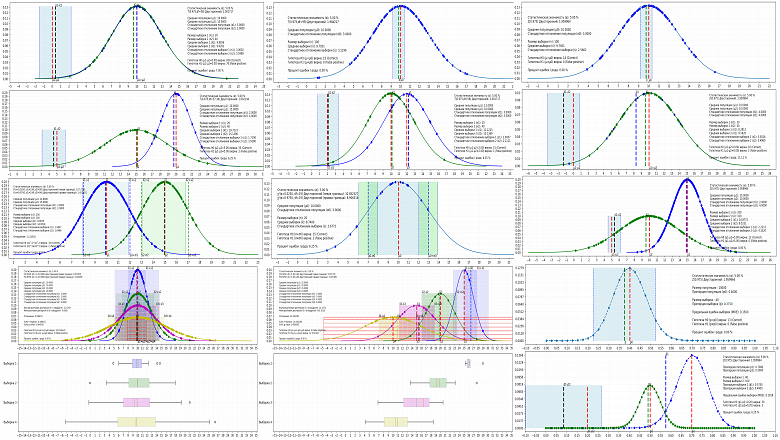
Одной из самых распространённых задач аналитики является формирование суждений о большой совокупности (например, о миллионах пользователей приложения), опираясь на данные лишь небольшой части этой совокупности - выборке. Можно ли сделать вывод о миллионной аудитории крупного мобильного приложения, собрав данные 100 пользователей? Или стоит собрать данные о 1000 пользователях? Какую вероятность ошибиться при анализе мы можем допустить: 5% или 1%? Относятся ли две выборки к одной совокупности, или между ними есть ощутимая значимая разница и они относятся к разным совокупностям? Точность прогноза и вероятность ошибки при ответе на эти и другие вопросы поддаются вполне конкретным расчётам и могут корректироваться в зависимости от потребностей продукта и бизнеса на этапе планирования и подготовки эксперимента. Рассмотрим подробнее, как параметры эксперимента и статистические критерии оказывают влияние на результаты анализа и выводы обо всей совокупности, а для этого смоделируем тысячу A/A, A/B и A/B/C/D тестов.

Читать далее

Когда начинает работать закон больших чисел

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели24K

Большие числа != большим числам.

Число 100 большое? Зависит от ситуации. Сравниваем ли мы его с 0,001, или с 100000? Как и многое в жизни, понятие «большой» относительно.

В этом посте мы объясним, насколько большим должно быть «большое» и докажем, что вы, скорее всего, ошибаетесь насчёт закона больших чисел.

Читать далее

Как я пришёл в дата-анализ после долгих блужданий по онлайн-курсам, маршрут со всеми тупиками и ухабами

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели54K

Привет! Меня зовут Алексей, я дата-аналитик. Четыре года назад я пришёл в дата-анализ из сферы, далековатой от IT, — пивоварения (хотя о том, что на самом деле они не так далеки, я рассказывал здесь). До того как я нашёл свою нишу, тщетно пробовал вкатиться в IT через разные курсы по Python, TensorFlow и веб-разработке. Потратил на это три года и 100 тысяч рублей, в какой-то момент выгорел ещё в процессе обучения, чуть не бросил попытки, но собрался и в итоге самостоятельно и бесплатно изучил анализ данных, который мне сразу зашёл. 

Сейчас я вижу, что многие начинающие блуждают теми же окольными путями. Поэтому решил написать про свой путь с фейлами и граблями и рассказать, что мне помогло найти своё. Надеюсь, мой текст будет полезен — добро пожаловать под кат. 

Читать далее

Анализировать данные — это как варить пиво. Почему дата-анализ и пивоварение — одно и то же с техноизнанки

Время на прочтение10 мин
Охват и читатели18K

Три года я был эстонским пивоваром: придумывал рецепты и сам варил. Когда начал изучать Python, SQL и анализ данных, понял, что между подготовкой данных и подготовкой сусла много общего: оказывается, в цеху я занимался DS, но не подозревал об этом. Меня зовут Алексей Гаврилов, я сеньор дата-аналитик в ретейле. В этой статье расскажу, чем пивоварение и аналитика данных похожи изнутри.

Читать далее

Информация

В рейтинге
Не участвует
Дата рождения
Зарегистрирован
Активность

Специализация

Аналитик по данным, Продуктовый аналитик
Старший
От 500 000 ₽
Python
Git
PostgreSQL
Базы данных
Английский язык
SQL
Docker