Обновить
16K+
8
Костин Алексей@PHP-Programmist

Senior PHP Developer

33,1
Рейтинг
4
Подписчики
Отправить сообщение

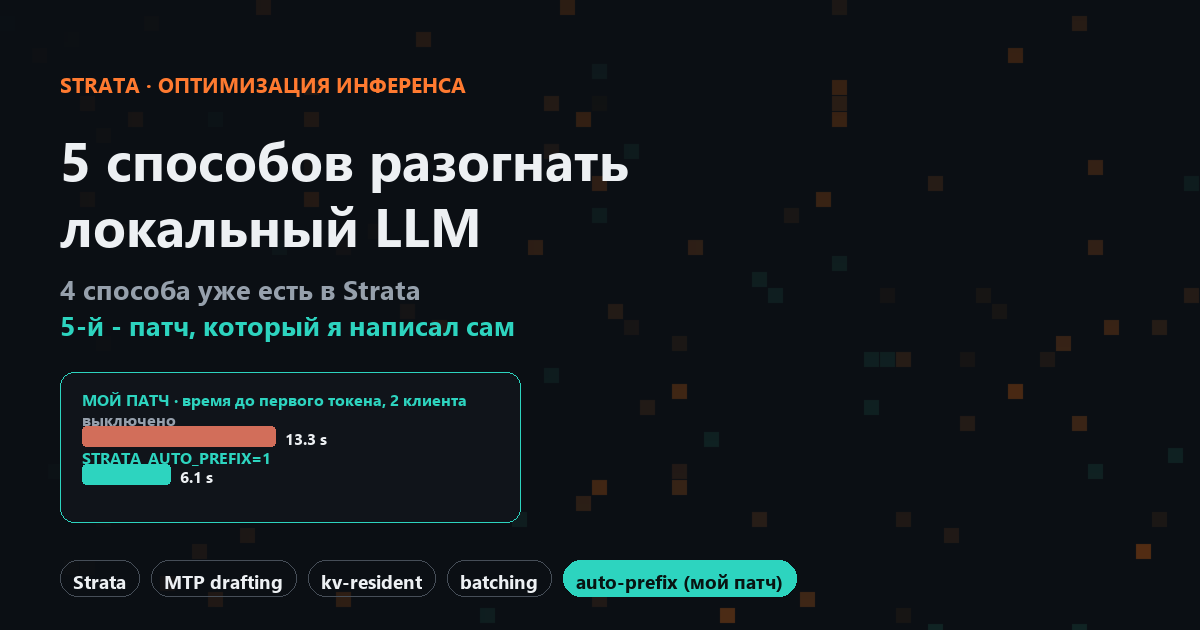
Пять способов ускорить локальный инференс MoE-модели: один я написал сам

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели13K

В предыдущей статье я разбирался, какие эксперты реально живут в VRAM у Strata, пока она крутит Qwen3.8-Flash-Next на GTX 1070. На этот раз - короче и практичнее: несколько конкретных приёмов ускорения, которые стоит проверить, если вы гоняете большую MoE-модель на домашнем железе. Один из них - патч, который я написал и прогнал сам, с цифрами “было/стало” на реальном движке. Остальные - то, что уже работает в Strata “из коробки”, просто не всегда включено и не всегда замечено.

Читать далее

Fail2ban: ошибки настройки, из-за которых защита не работает

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели104K

Fail2ban ставят на сервер, когда тот получает белый IP, но зачастую дальше установки дело не идёт. Получается, что сервис запущен и джейл sshd включен, но конфиг был дефолтный, бан длится по десять минут, логи читаются не из того места, а половина открытых сервисов вообще находится вне поля зрения. Под катом разберу ошибки и покажу настройки. 

Читать

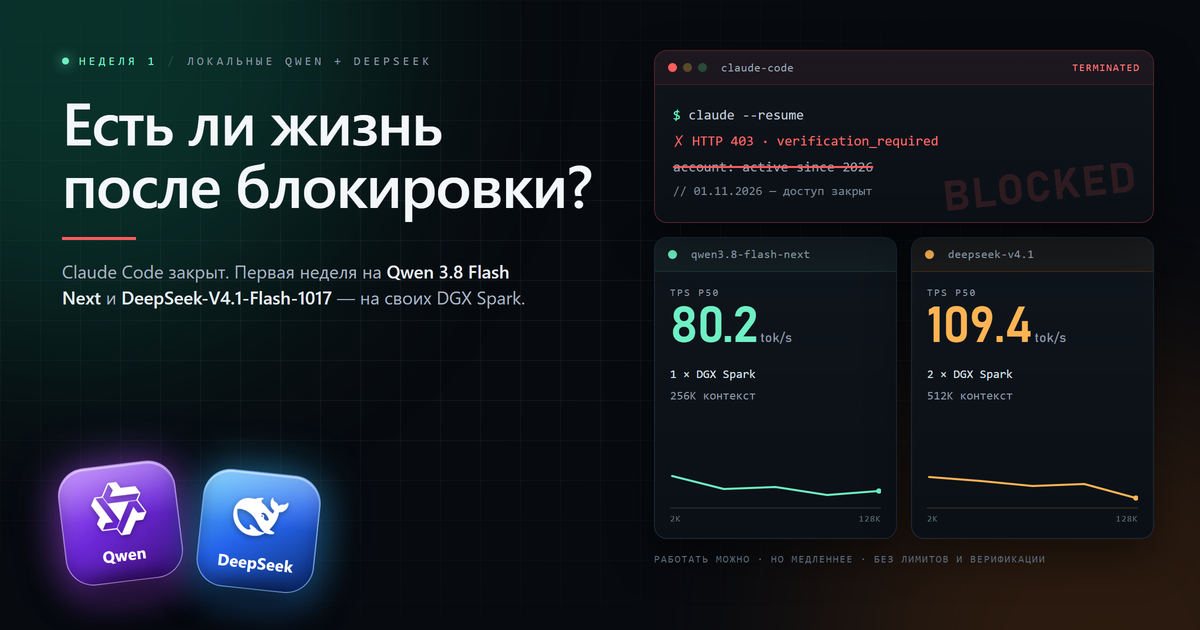
Есть ли жизнь после блокировки Claude Code? Первая неделя на локальных Qwen и DeepSeek

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели26K

TL;DR. Anthropic в очередной раз заблокировал мой аккаунт, и Claude Code стал недоступен. Я попробовал заменить его локальными Qwen 3.8 Flash Next (1 × DGX Spark) и DeepSeek-V4.1-Flash-1017 (2 × DGX Spark). Замеры TPS/TTFT, рабочий процесс с двумя моделями и вывод — работать можно, но цикл разработки стал занимать значительно больше времени.

Читать далее

Можно ли отказаться от Opus и Codex? Проверил MacBook, игровой ноутбук и DGX Spark на одной задаче с ловушками

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели16K

В моём пет-проекте open-daimon давно есть роутинг между локальными моделями и облаком.

Сразу оговорюсь: публично open-daimon не обновляется, потому что разработку я веду локально, так быстрее. А на его основе у меня уже есть отдельный закрытый проект, который расширяет его возможности, — студия управления агентами. В ней я всё это и тестировал.

Всерьёз захотелось по простой причине: в облаке правила чужие, и меняются они без спроса.

В октябре снова всплыло, что в потребительских условиях Anthropic для жителей ЕЭЗ и Швейцарии прямо написано: не использовать сервисы «в коммерческих или деловых целях». Под эти условия попадают Claude.ai и подписки Pro и Max. То есть разработчик в Европе, который пишет рабочий код в Claude Code по подписке Max, формально их нарушает. Для работы нужен API, Team или Enterprise, а это уже совсем другие деньги.

Вторая история про то, что тебе разрешат делать со своим же железом. Автор Decrypt попросил Claude Opus 5.5 помочь заново получить root на собственном телевизоре LG. Защита модели оборвала запрос и предложила переключиться на Opus 4.8. А исследователь, известный находкой с постоянно включённым микрофоном в телевизорах Samsung, пишет, что OpenAI заблокировала его аккаунт за «Cyber Abuse» после анализа прошивки через ChatGPT. Вместе с аккаунтом пропали примерно $500 на балансе API. OpenAI это не комментировала, так что пока это только его слова.

Направление понятное: ковырять чужое ПО будут запрещать всё чаще, а что считать злоупотреблением, решает производитель.

Читать далее

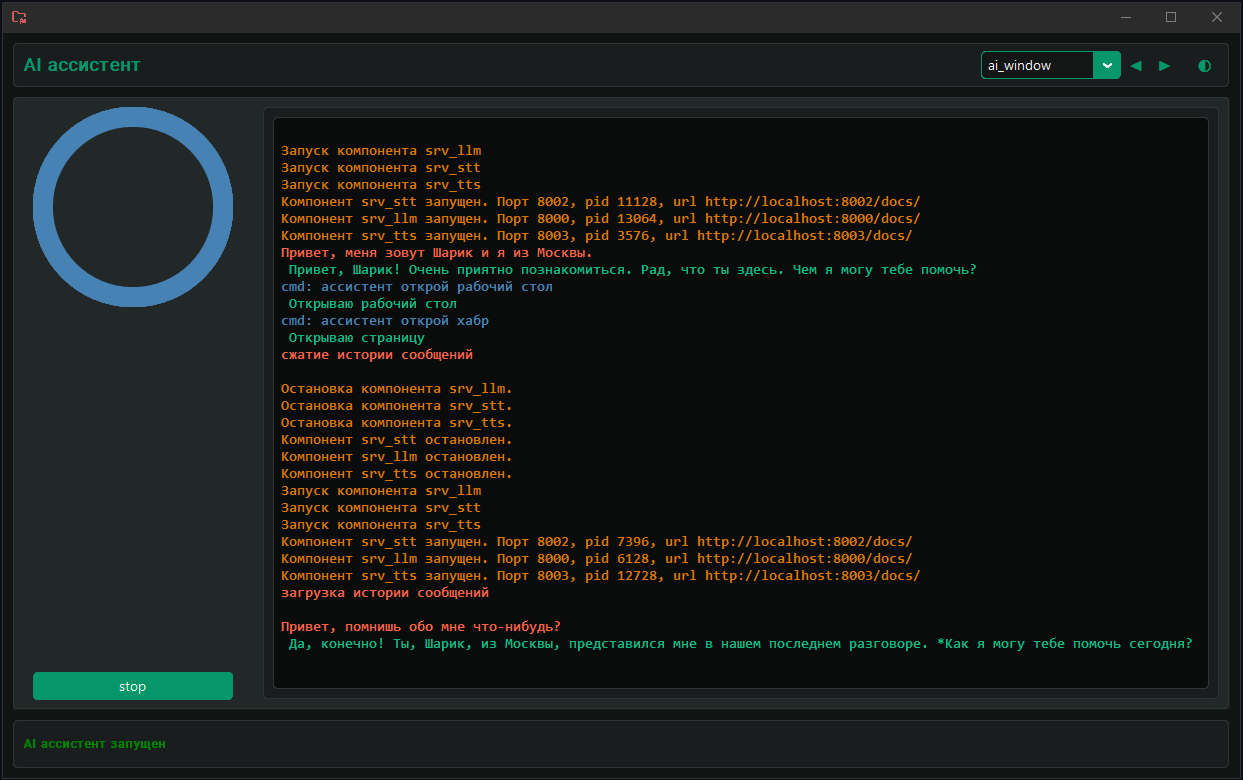
Собрал полностью локального голосового ассистента без облаков и подписок. Выкладываю в open source

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели28K

Привет, Хабр!

Пока весь мир заворачивает платные API в красивые обёртки, мне захотелось сделать что-то полностью автономное, конфиденциальное и бесплатное. Результат — App AI Assistant, локальный компаньон, с которым можно поговорить + голосовой ассистент («Джарвис» на минималках), который работает на 100% оффлайн на вашем компьютере.

Проект полностью открытый, исходный код опубликован под лицензией MIT. Мне интересно было не просто «поиграться», а подружить нейросети в реальном времени.

Что умеет ассистент:

Читать далее

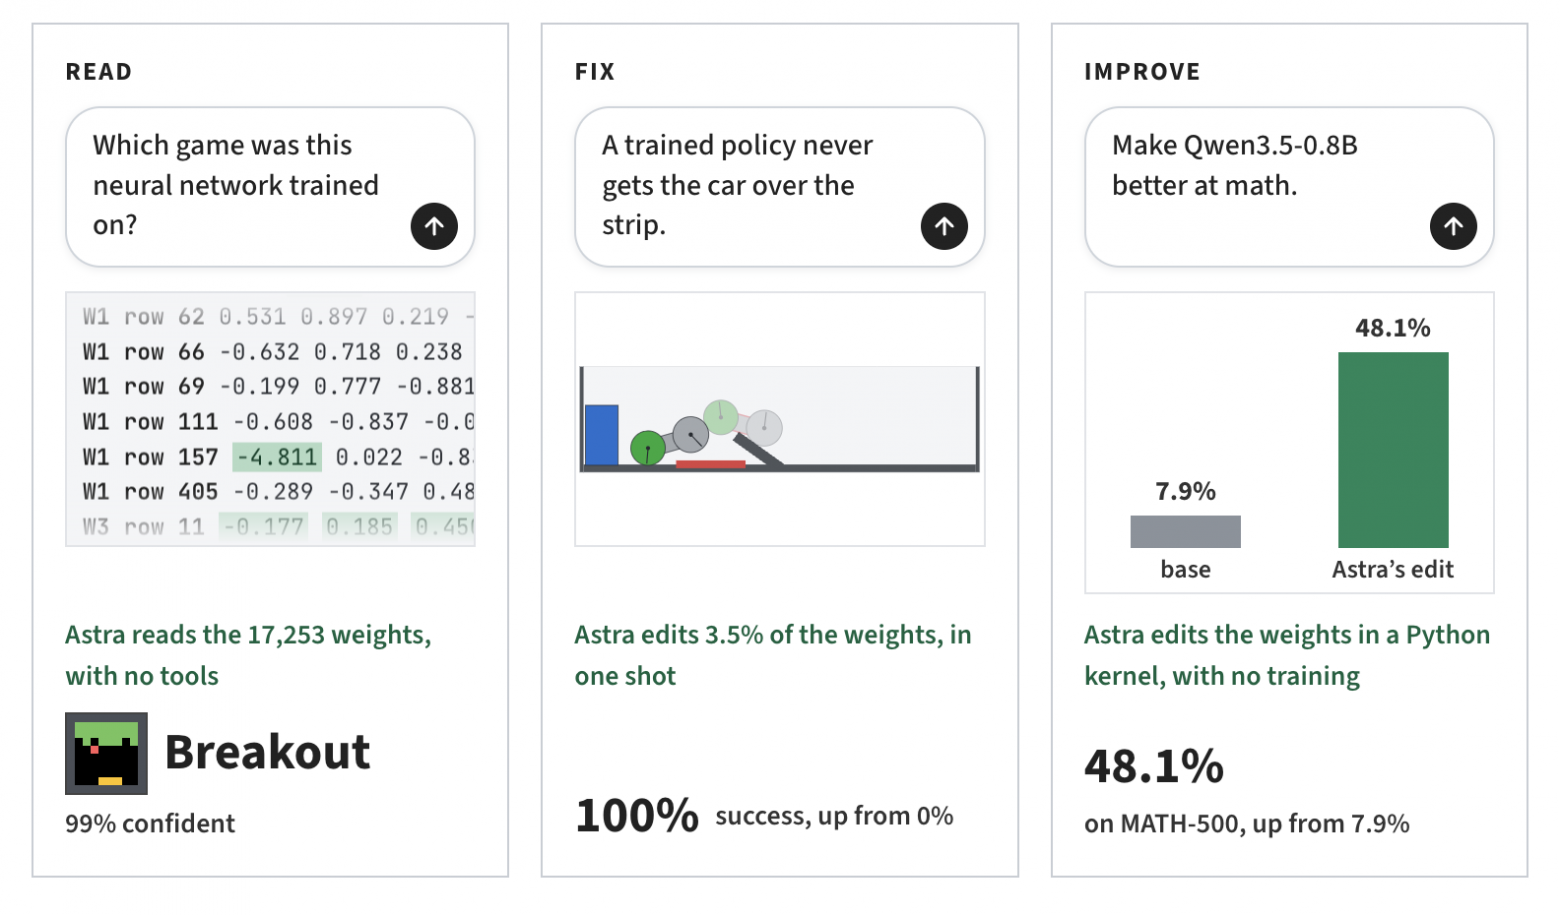
LLM теперь умеют оперировать мозг другой LLM напрямую, без обучения. Но не так как вы думаете

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели96K

Недавно вышла статья от исследователей из MIT, которая продемонстрировала как GPT-6 Astra может нативно "читать и писать на языке весов моделей". Она угадывала, для чего модели были обучены, только по их весам и существенно улучшала способности моделей без дообучения.

Я повторил их эксперименты в домашних условиях и разобрался, как это работает. Оказалось — не так, как это звучит в статье.

Читать далее

Почему я вернулся на контекстное окно в 200К у Клода

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели72K

Весной мне хватало подписки за 100 долларов для всех задач по моему пет-проекту. Идея полностью высадить пятичасовой лимит токенов выглядела как вызов. В самом начале лета я уже неплохо справлялся с этой задачей, а в августе лимитов стало хватать только на проработку технического дизайна решений, а до старта реализации приходилось ждать следующей недели. Запускал в работу и тратил весь недельный лимит примерно за 3 дня.

В cентябре у меня была подписка уже за 200$, но и её лимиты не выглядели недостижимыми. Друзья и коллеги рассказывали, что у них давно по максимальной подписке на Claude и GPT враз и планы купить даже третью!

Вливать дополнительные деньги выглядело тупиковым сценарием и я начал разбираться, как можно оптимизировать потребление токенов. Главная причина нашлась не в сложности выполняемых задач и объеме вычитываемого кода, а в банальном повседневном удобстве.

Читать далее

От чата c LLM к полноценному AI-агенту: пошаговая настройка OpenCode

Время на прочтение9 мин
Охват и читатели20K

Когда я впервые начала использовать AI в работе, сценарий был довольно стандартным: открыть чат, вставить текст, сформулировать запрос, получить ответ — это удобно, но возможности довольно быстро упираются в потолок. Модель не знает контекст ваших проектов, не видит документацию и код, не понимает принятые в команде правила и каждый раз требует заново объяснять, что именно вы от нее хотите.

Следующим моим шагом стало собрать вокруг модели рабочую среду. В моем случае такой средой стал OpenCode. Хотя этот агент в первую очередь ассоциируется с разработкой, его можно использовать гораздо шире. По сути, это оболочка, в которой LLM получает доступ к файлам, инструкциям, локальным инструментам, API и MCP-серверам, а затем использует все это для решения задач конкретного пользователя.

Привет, Хабр! Я Арина, аналитик в Selectel. В этой статье я покажу не столько «как установить OpenCode», сколько как организовать вокруг него рабочее пространство, чтобы агент выдавал более стабильный результат и действительно снимал часть рутинной работы.

Читать далее

Как собрать семантику проекта для кодового агента и не открыть филиал Confluence

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели9.6K

Практический гайд для небольших проектов: как собрать компактный слой контекста для кодового агента - с готовым мини-репозиторием, примерами инвариантов и контрактов.

Читать далее

Открываем AliceAI-Foundation-80B-A3B-Base — новую языковую модель Яндекса, обученную с нуля

Время на прочтение81 мин
Охват и читатели75K

Сегодня мы открываем веса нашей новой модели AliceAI‑Foundation-80B‑A3B‑Base под лицензией Apache 2.0. Модель прошла полный цикл обучения в Яндексе с нуля: мы не использовали веса сторонних опенсорс‑моделей. Её создание — ещё один шаг к нашей единой рассуждающей модели (ЕРМ), на базе которой будут развиваться агентские возможности Алисы AI.

В претрейн‑замерах новая модель обходит более крупные DeepSeek‑V4-Flash‑Base и Nemotron-3-Super на многих задачах — от фактологических и экспертных вопросов до математики и кода, — а на сложных задачах IMO AnswerBench и LiveCodeBench лидирует среди сравниваемых открытых претрейнов. Нашу предыдущую закрытую Alice AI LLM 235B она превосходит по фактологическим знаниям, математике, программированию и работе с длинным контекстом — при почти втрое меньшем общем числе параметров и примерно в семь раз меньшем числе активных.

Недавно наши коллеги открыли претрейн Alice AI Search (кстати, он тоже обучен без применения весов опенсорс‑моделей) и рассказали, как устроена модель быстрых ответов Алисы на Поиске. Сегодня мы подхватим у них эстафетную палочку и расскажем о большом обновлении датасета, который лежал в основе обучения обеих моделей.

Также продолжим историю из декабрьского техрепорта Alice AI LLM. Тогда обучение начиналось с весов Qwen3-235B‑A22B, но в этот раз мы обучали модель полностью с нуля. Благодаря накопленному командой опыту весь путь к релизу этой модели занял около полугода. За это время мы пересобрали корпус, перебрали архитектурные решения, подобрали гиперпараметры и добавили данные для рассуждений и агентских взаимодействий.

За итоговыми скорами стоит много экспериментов, и нам хочется рассказать о них подробно. Поэтому вместе с весами мы публикуем большой технический отчёт: от пайплайнов подготовки данных и протоколов оценки до стабилизации обучения и scaling laws. Для ключевых решений приводим абляционные эксперименты и разбираем подходы, от которых пришлось отказаться. Вклад обновлённого корпуса, архитектуры и гиперпараметров проверили в серии обучений с нуля — по 2 трлн токенов каждое.

Отдельная большая часть отчёта посвящена тому, как измерять качество претрейнов и почему это сложно. Результат базовой модели может сильно зависеть от примеров в промпте, а правильное решение сложной задачи — появляться лишь в одной из многих попыток. Мы подробно рассказываем, как выбирали протоколы замеров, строили бенчмарки, проверяли автоматическую оценку и выясняли, какие метрики позволяют предсказать качество после дообучения. Вместе с весами открываем два фактологических бенчмарка — WikiWebFacts и HardMultiQA с акцентом на русскоязычный контекст — и протоколы их оценки.

Читать далее

Найм умирает. Может, теперь делать свой продукт не такая уж плохая идея?

Время на прочтение8 мин
Охват и читатели115K

Последнее время у меня странное состояние. Что-то между усталостью и выгоранием. Старый мир разработки буквально уходит из-под ног, а новый еще до конца не отстроился и можно только догадываться каким он будет. Непонятно, какие навыки будут иметь ценность через год, как теперь оценивать собственную работу и куда вообще двигаться дальше.

И чем больше я на это смотрю, тем чаще думаю: возможно, в текущих реалиях делать свой продукт уже не такая рискованная идея, как казалось раньше.

Читать далее

Тупая модель с жёстким циклом проверки бьёт умную модель без него

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели102K

Недавно читал тут статью про «Cost per Task» и про то, что самая дешёвая модель в линейке внезапно обгоняет самую умную по цене решённой задачи. С выводом согласен полностью, но хочу добавить то, чего в той статье не было: дело не только в модели. Дело в том, что происходит после того, как модель написала код.

Последние восемь месяцев я строю агентную обвязку, в которой модель не просто пишет файлы, а обязана доказать, что написанное работает. Выяснилось следующее: если прикрутить к слабой модели честный цикл верификации, она уверенно обходит сильную модель, работающую в режиме «написал и отчитался».

Ниже цифры, архитектура и грабли.

Читать далее

Проверяем Jev на открытых и внутренних данных: классификаторили фильтр?

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели8K

Jev отвечает только «да/нет» или выбирает один из предложенных вариантов. 16 000 вызовов:сначала сравнение с gpt-5.4-mini и gpt-5.6-luna на четырёх открытых датасетах, затем несколько тысяч реальных решений в рабочих процессах. Где он выигрывает, где ошибается и как его использовать.

Читать далее

Как перестать писать шаблонный код в Symfony: Практические DX‑трюки для ленивого разработчика

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели9.5K

Всем привет! Меня зовут Антон Рыков и я backend-разработчик в компании "Исходный Код".

Пять CRUD-эндпоинтов. К обеду я понял: бизнес-логика заняла минут двадцать. Остальные два часа ушли на UUID вместо автоинкремента, одинаковые DTO с валидацией и ручную уборку временных файлов на стейджинге. Пальцы работали. Голова — нет.

Почти любая команда на Symfony рано или поздно упирается в ту же стену: фреймворк перестаёт быть помощником и превращается в конвейер. make:entity → вырезать integer id → прикрутить трейт дат → руками разобрать $request в контроллере. Снова. И снова.

DX — это не красивая тема в терминале. Это меньше трения между архитектурным решением и кодом. Правильная лень — точечная автоматизация того, что вы и так делаете каждый день.

В статье — четыре уровня, которые убрали это трение у меня. Настроите PhpStorm так, чтобы скелет JSON-экшена появлялся по Tab. Уберёте ручной json_decode и isset через MapRequestPayload и строгие DTO. Научите MakerBundle сразу генерировать сущности с UUID и вашими трейтами. Перенесёте cron в PHP через Scheduler - расписание

Читать далее

Codebase Intelligence для агента: строим «dev tool будущего» и сразу тестируем на Rails монолите в 3,5M+ строк

Уровень сложностиСредний
Время на прочтение44 мин
Охват и читатели11K

Сгенерированная картинка для привлечения внимания. Промпт: «Продемонстрируй, что всё новое — это хорошо забытое старое» (нет)

За последний год инструментов для агентной разработки стало столько, что в них легко потеряться: одни обещают сохранять контекст между сессиями, другие — «понимать» всю кодовую базу целиком, третьи — память, планирование и автономность в одном флаконе. На GitHub каждую неделю появляются репозитории с внушительным (и не всегда честно заработанным) числом звёзд, которые обещают всё и сразу, а на поверку оказываются README-проектами; другие честно работают на демо-репозитории и падают с OOM при первой же встрече с реальным энтерпрайз-проектом — и так далее, список можно продолжать долго.

Осенью прошлого года я пользовался связкой Claude + RooCode + семантический поиск на Ollama, и это был мой основной рабочий инструмент — ровно до того момента, как связка перестала работать (об этом чуть ниже). Я решил полностью пересесть на Claude Code и начал искать замену семантическому индексу, но так её и не нашёл: альтернативы для меня просто не работали — на монолите в 3,5M+ строк они либо индексировались часами, либо требовали отдать код в облако (и заплатить немалую сумму за эмбеддинги!!!), либо поддерживали Ruby, мягко говоря, номинально. В итоге я принял непростое для себя решение сделать собственный инструмент — начав с форка простого движка семантического поиска на Ollama + Qdrant — и, что характерно, сделал: полностью локальный, чтобы ни код, ни его производные (индекс, эмбеддинги, граф вызовов) никуда не уезжали. На сегодняшний день на него ушло больше полугода (и, честно признаюсь, не одна сотня чашек чая).

Читать далее

Я дал LLM память, root‑доступ и деньги. Получился ли «свободный ИИ»?

Уровень сложностиПростой
Время на прочтение18 мин
Охват и читатели99K

В общем, делать в отпуске нечего. От задач на основной работе и программирования собственного стартапа по вечерам я тоже устал. На работе есть проект, связанный с ИИ, но это нейросеть, которая обучается классифицировать документы, а затем работает как поисковик важных и критичных документов. А стартап — это ИИ‑помощник, который работает на смартфоне и помогает решать бытовые проблемы. В общем, мне надоело решать утилитарные задачи вроде создания умной отвёртки. Захотелось создать что‑то высокое и глобальное — примерно такое, о каком читаешь в статьях о лабораториях, сталкивающихся с тем, что ИИ пытается сбежать и чуть ли не захватить мир.

Читать далее

Работа программистов постепенно смещается к проектированию правил и систем обратной связи для ИИ

Время на прочтение4 мин
Охват и читатели6.8K

В Venture Beat вышел материал, посвящённый изменениям в работе программистов из‑за широкого внедрения искусственного интеллекта. Автор считает, что теперь вместо реализации отдельных функций они переходят к проектированию правил, границ и систем обратной связи для ИИ.

Читать далее

Qwen 4: возбуждающая новая технология

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели90K

Сегодня мы поговорим не просто об очередном минорном релизе, а о раннем архитектурном превью платформы Qwen 4. Главная идея Qwen 4 заключается в переосмыслении того, как трансформерные блоки обрабатывают контекст и расходуют память.

В этой статье мы разберем новые механизмы (GDN + QSA, Gated Residual, 51B N-gram эмбеддинги), сравним архитектуру и бенчмарки с популярной плотной моделью Qwen 3.8 27B, а также запустим новую модель локально.

Читать далее

Single Task Algorithmic Reasoning Models: как с помощью маленькой модели обойти большую LLM?

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели16K

Привет, Хабр! Результаты коллег по цеху и наши исследования позволяют сделать однозначный вывод: в 2026-м для рецепта отличной reasoning-модели уже недостаточно лишь текстовых рассуждений. Для качественных ответов на большинство вопросов пользователей нужна работа с инструментами, мультимодальные режимы рассуждений, и нередко даже такая экзотика, как рассуждения в латентных представлениях сети.

Мы рады поделиться с сообществом фреймворком для обучения рекурсивных reasoning-моделей STARM, существенно опережающих по качеству предыдущие open source-аналоги.

Читать далее

Что такое Harness и с какими моделями его едят?

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели61K

Сегодня, 13 августа DeepSeek выложил DeepSeek Harness v0.1 в Developer Preview. Открытый код, MIT, пакет @deepseek-ai/dsh в npm, запуск в одну строку.

Нюхаем, что вообще такое harness, какие виды его бывают и пытаемся разобраться зачем он нужен.

Выбрать свой молоток
1

Информация

В рейтинге
239-й
Откуда
Россия
Дата рождения
Зарегистрирован
Активность

Специализация

Бэкенд разработчик
Старший
PHP
Symfony
Git
PostgreSQL
MySQL
Docker
Nginx