Pull to refresh
-1

User

Send message

Независимые как понятия, зависимые как операции: параметры семплирования в LLM‑инференсе

Level of difficultyMedium
Reading time12 min
Reach and readers11K

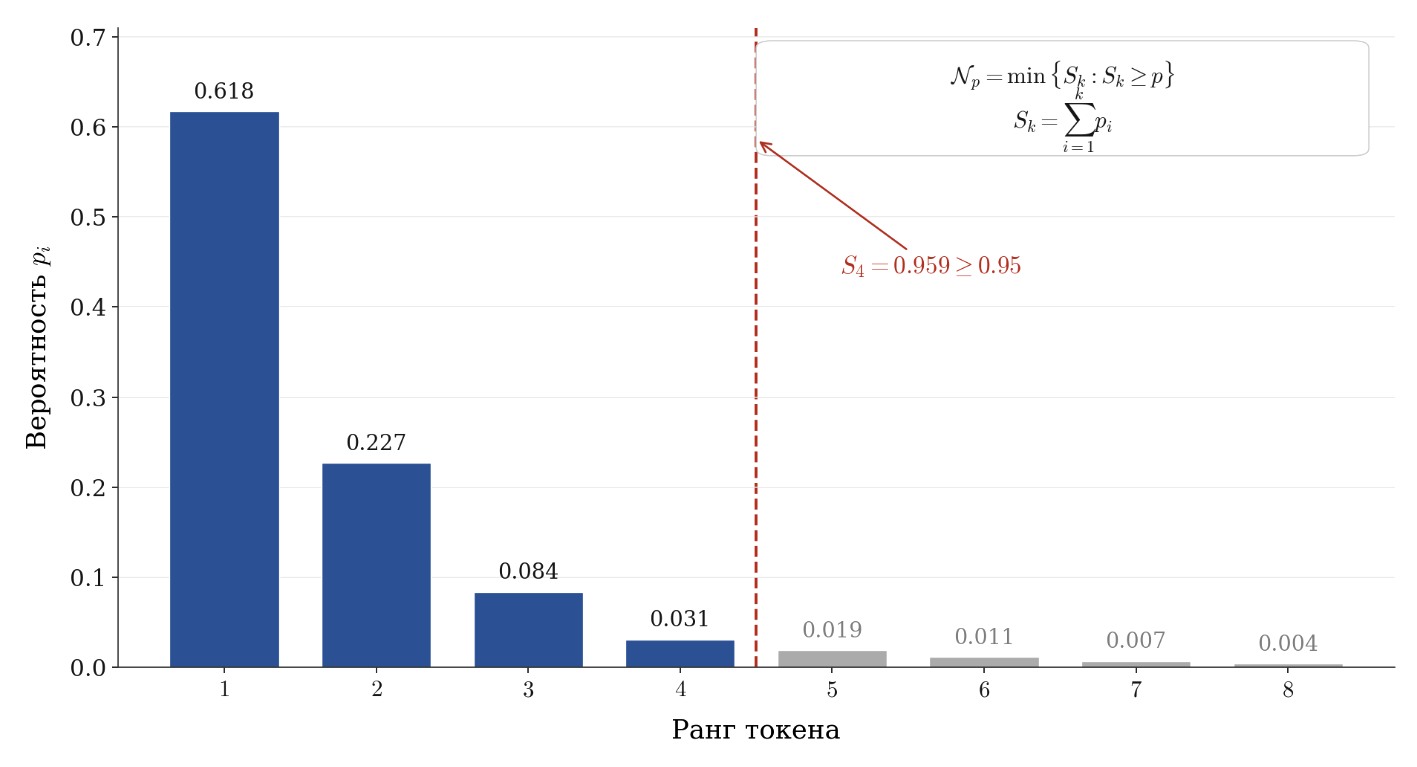
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако за пределами этого фокуса нередко остаётся слой, определяющий не скорость, а качество. Это параметры семплирования - правила выбора следующего токена из распределения логитов на каждом шаге декодирования.

Читать далее

Живая карта мозга нейросети: 48 слоёв, 512 экспертов, одна GTX 1070 + Strata + Qwen3.8-Flash-Next

Level of difficultyHard
Reading time8 min
Reach and readers101K

В прошлых двух статьях я рассказывал, как запустить Qwen3.8-Flash-Next (125 млрд параметров) на старом железе и как снять программный потолок FP16 на видеокартах. Обе статьи были про железо и про то, что можно взять готовое и заставить работать. Эта - другая. Я залез внутрь самого движка (Strata), построил живую визуализацию того, что он делает с экспертами модели под капотом, попробовал ответить на вопрос “а эксперты реально специализируются по темам?” - и на середине пути поймал себя на методологической ошибке, которая чуть не привела к красивому, но неверному выводу. Расскажу как есть, с цифрами и без приукрашивания.

Что такое Strata и при чём тут эксперты

Strata - движок инференса для MoE-моделей (Mixture-of-Experts): вместо одной плотной сети у модели есть десятки экспертов на каждый слой, и на каждый токен активируется лишь небольшое подмножество (top-K). У Qwen3.8-Flash-Next, с которой я работал всю эту серию статей, это 48 слоёв по 512 экспертов - то есть 24576 отдельных “узлов”, из которых на каждом шаге реально считает лишь небольшая часть.

Проблема в том, что весь набор экспертов (сотни гигабайт) физически не влезает в 8ГБ VRAM моей GTX 1070. Strata решает это адаптивным кэшем: часть экспертов постоянно живёт в VRAM (самые “горячие”), остальные читаются из RAM или SSD по мере надобности, и кэш сам решает, кого держать резидентно, а кого вытеснять - на основе decayed-счётчика обращений к каждому эксперту.

Вся эта механика раньше была для меня чёрным ящиком: я видел только агрегированные цифры в мониторинге (сколько экспертов в VRAM, hit rate). Захотелось увидеть её изнутри.

Читать далее

Хочу свой суперкомпьютер. Что мне делать?

Level of difficultyMedium
Reading time6 min
Reach and readers11K

Для начала вам нужны два сервера, соединение через InfiniBand и одна достаточно серьезная задача, чтобы игра стоила свеч. Так выйдет общая сеть, которая связывает серверы для высокопроизводительных вычислений. Ну это в теории. 

На практике просто купить два сервера и соединить их недостаточно. Нужно распределить задачу, наладить обмен данными и управление сетью. Именно это я и хочу разобрать, чтобы вы прикинули, а надо ли вам брать железо и становиться счастливым обладателем личного суперкомпьютера.

Прошу к нашему шалашу эксперименту.

Читать далее

Методичка по построению VPN, осень 2026

Level of difficultyMedium
Reading time9 min
Reach and readers130K

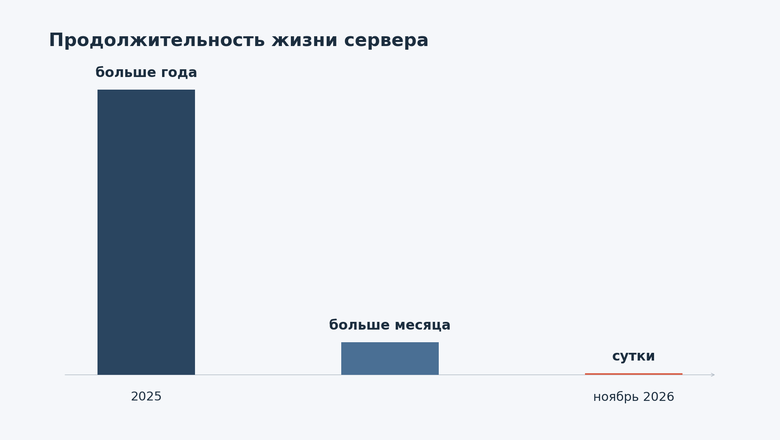
Осенью 2026 года за шесть недель заблокировали четыре зарубежных VPN сервера, и каждый следующий прожил меньше предыдущего, три последних заблокировали за пять дней. Все настроено серьезно: VLESS поверх REALITY с self-steal SNI на собственном домене, XHTTP, разные провайдеры, страны и ASN. Их все-равно заблокировали. Явление массовое. В начале ноября адреса зарубежных серверов живут от нескольких часов до 1-3 суток при любом протоколе. Смена IP помогает ненадолго.

Что с этим делать?

Я устал от VLESS-клиентов и написал свой. Rust, EvertyUI, Mihomo и немного экспериментов с ИИ

Level of difficultyMedium
Reading time12 min
Reach and readers112K

Привет, Хабр!

Меня зовут Артур Валиев и в какой-то момент я поймал себя на мысли, что для подключения к VPN мне приходится открывать приложение, в котором настроек едва ли не больше, чем в самом Windows.

Читать далее

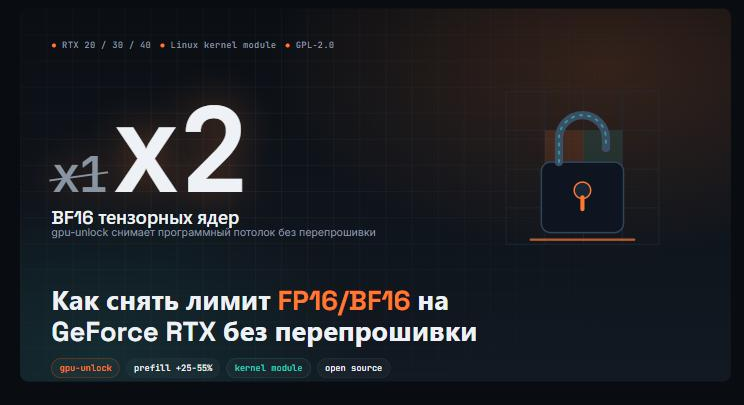
gpu-unlock: как снять программный потолок FP16/BF16 на RTX 20/30/40 без перепрошивки

Reading time5 min
Reach and readers9.8K

У вас в компьютере может стоять видеокарта, которая считает вдвое медленнее, чем могла бы — просто потому, что производитель так решил в прошивке. Проект gpu-unlock от разработчика с ником Zagitta снимает этот лимит программно, на уровне ядра Linux, без патченого драйвера и без перепрошивки VBIOS.

Дисклеймер сразу: сам я этот модуль не тестировал (в отличие от предыдущей статьи про Qwen3.8 на 1070, где все цифры — мои собственные замеры). Всё ниже — разбор репозитория и README проекта, с указанием, где цифры — заявления автора и коммьюнити, а не независимо проверенный бенчмарк.

В чём суть ограничения

NVIDIA разделяет линейку на гейминговые GeForce RTX и профессиональные/дата-центровые карты (Tesla, A100, H100 и т.д.) не только по цене, но и по пропускной способности тензорных ядер на FP16/BF16/TF32 с накоплением в FP32. Железо физически одно и то же (или очень близкое), но на потребительских картах эта математика искусственно урезана — чаще всего вдвое от паспортной пиковой скорости тензорных ядер.

Для игр это не имеет значения — там этот режим почти не используется. А вот для локальных LLM, файнтюнинга, генерации изображений и видео — это именно то, что считает большую часть времени при обучении и на этапе prefill (обработка входного промпта).

Читать далее

Как я скрестил RAG, LLM и RandomForest: архитектура торгового сигнала с доказательствами

Level of difficultyMedium
Reading time7 min
Reach and readers6.2K

В первой части я рассказывал, как собрал RAG-систему с LangGraph-агентом на локальных LLM. Она умела искать новости, отвечать на вопросы и извлекать сущности. Но для трейдинга этого мало — нужно не просто читать, а предсказывать.

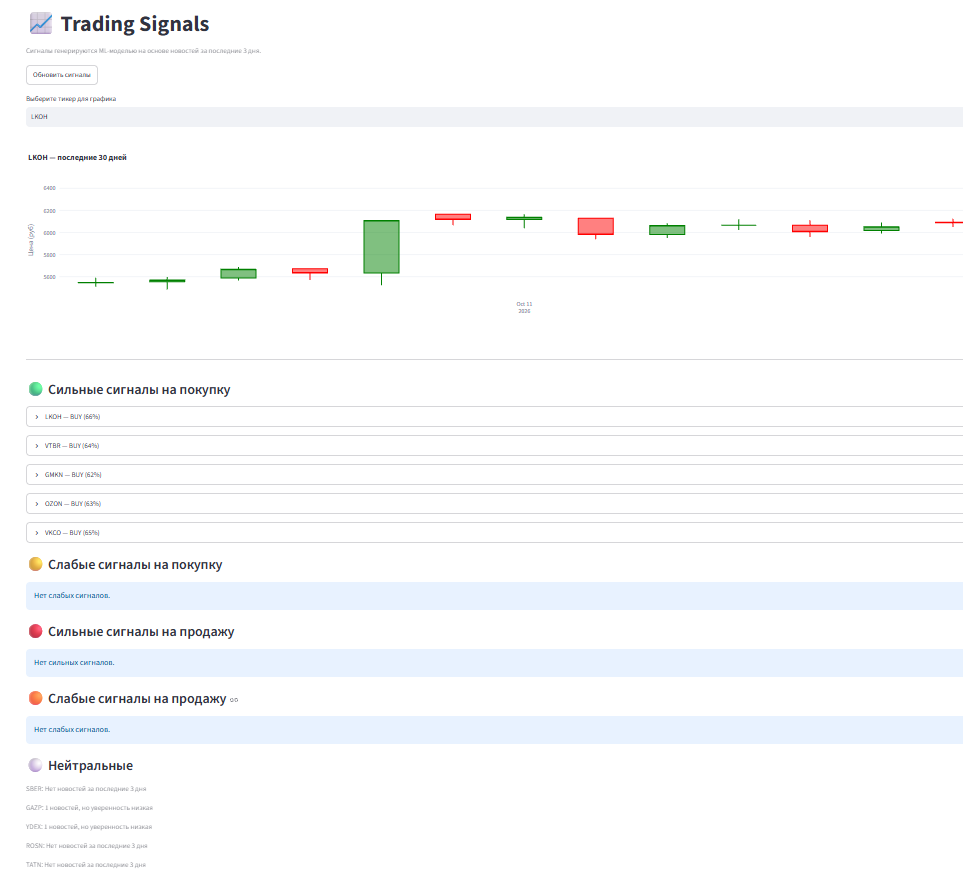
В этой статье я расскажу, как превратил новостной скрапер в ML-пайплайн, который генерирует торговые сигналы (BUY/SELL/NEUTRAL) с доказательствами. Мы пройдём путь от привязки новостей к тикерам до Explainable UI, разберём грабли на малых данных и заглянем в архитектурное будущее проекта.

Стек: Scikit-learn, Plotly, FastAPI, Streamlit, PostgreSQL, Ollama.

Читать далее

Как Claude переписывал веса медицинской модели. Справился. Но градиент не хуже

Level of difficultyEasy
Reading time4 min
Reach and readers5.6K

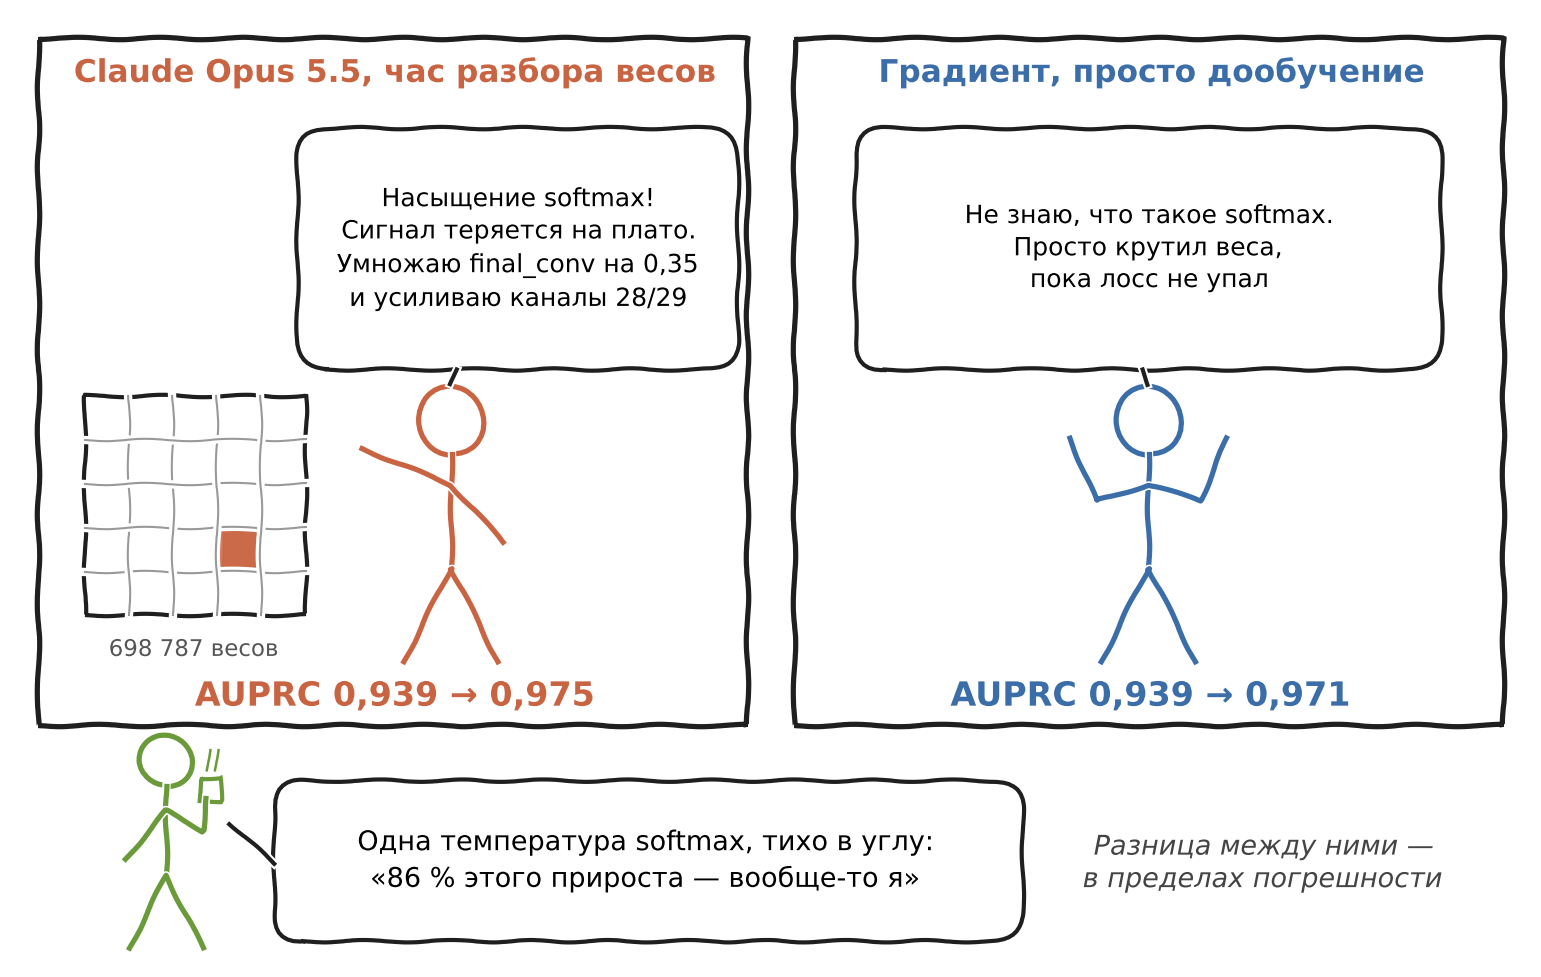
Повторила эксперимент MIT weight-space reprogramming на модели из клинической генетики. Opus поправил веса без переобучения и поднял AUPRC c 0,939 до 0,975

Читать далее

LLM теперь умеют оперировать мозг другой LLM напрямую, без обучения. Но не так как вы думаете

Level of difficultyEasy
Reading time10 min
Reach and readers96K

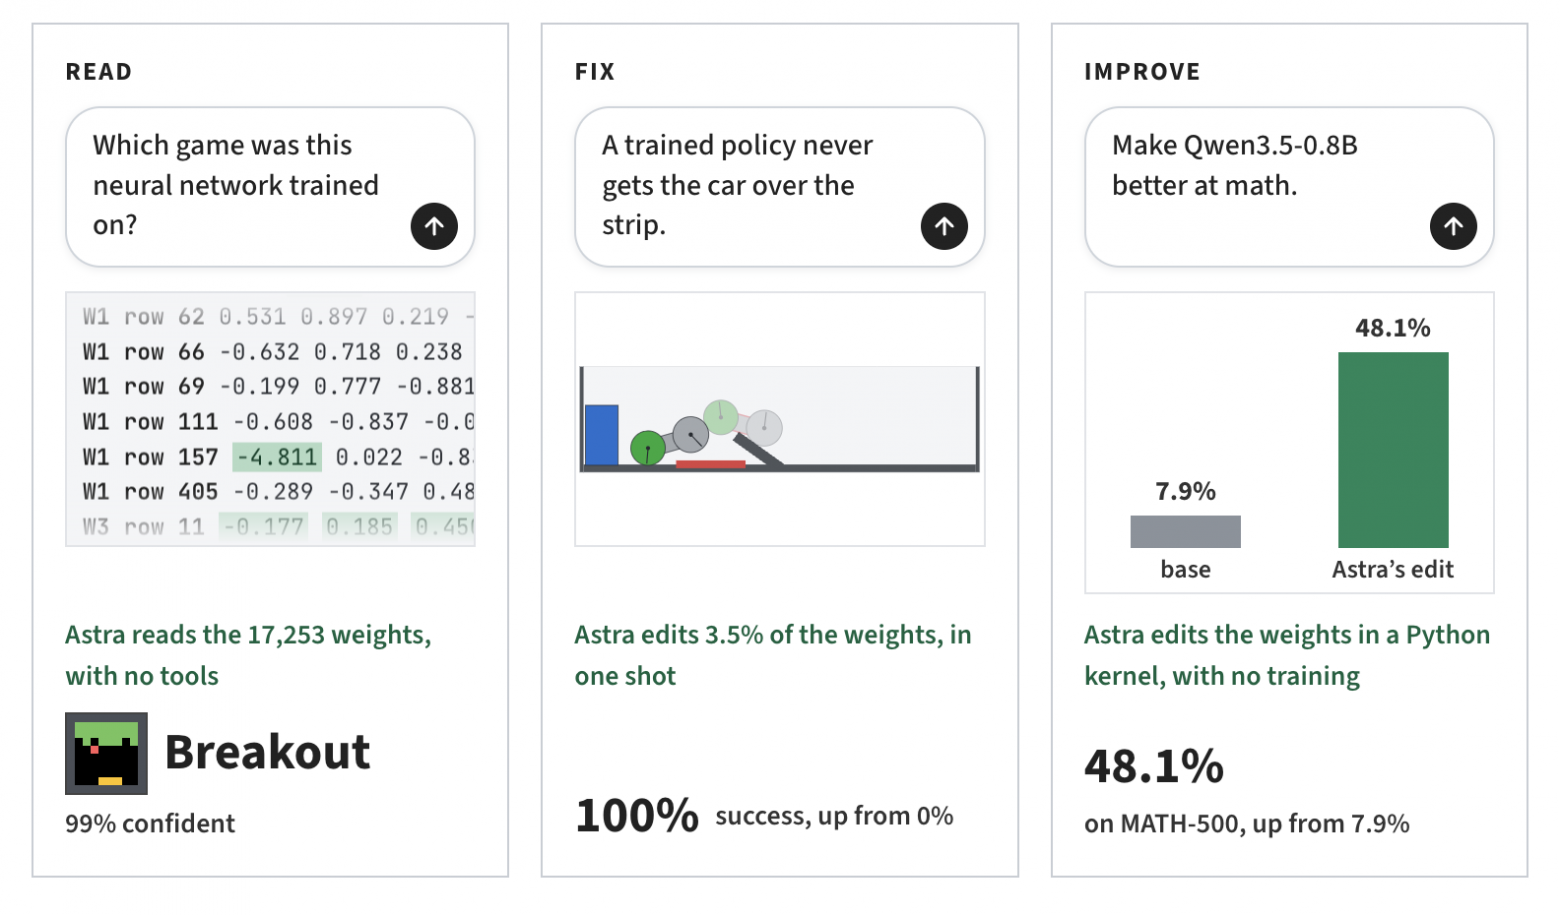
Недавно вышла статья от исследователей из MIT, которая продемонстрировала как GPT-6 Astra может нативно "читать и писать на языке весов моделей". Она угадывала, для чего модели были обучены, только по их весам и существенно улучшала способности моделей без дообучения.

Я повторил их эксперименты в домашних условиях и разобрался, как это работает. Оказалось — не так, как это звучит в статье.

Читать далее

Распределённый инференс и шардирование LLM. Часть 2: скрипт vLLM, Ray Serve для вывода API и настройка KubeRay Cluster

Level of difficultyHard
Reading time14 min
Reach and readers14K

Продолжаем пошагово разбираться с ответом на вопрос о том, как эффективно работать с передовыми LLM, используя доступное оборудование и распределённые вычисления. 

В первой части статьи мы подготовили всё необходимое для развёртывания распределённого инференса с Ray Serve и vLLM. Сегодня этим и займёмся. Мы напишем скрипт vLLM, используем Ray Serve, чтобы предоставить внешний HTTP API, а также настроим KubeRay Cluster и развернём в нём Gemma 3.

Вперёд!

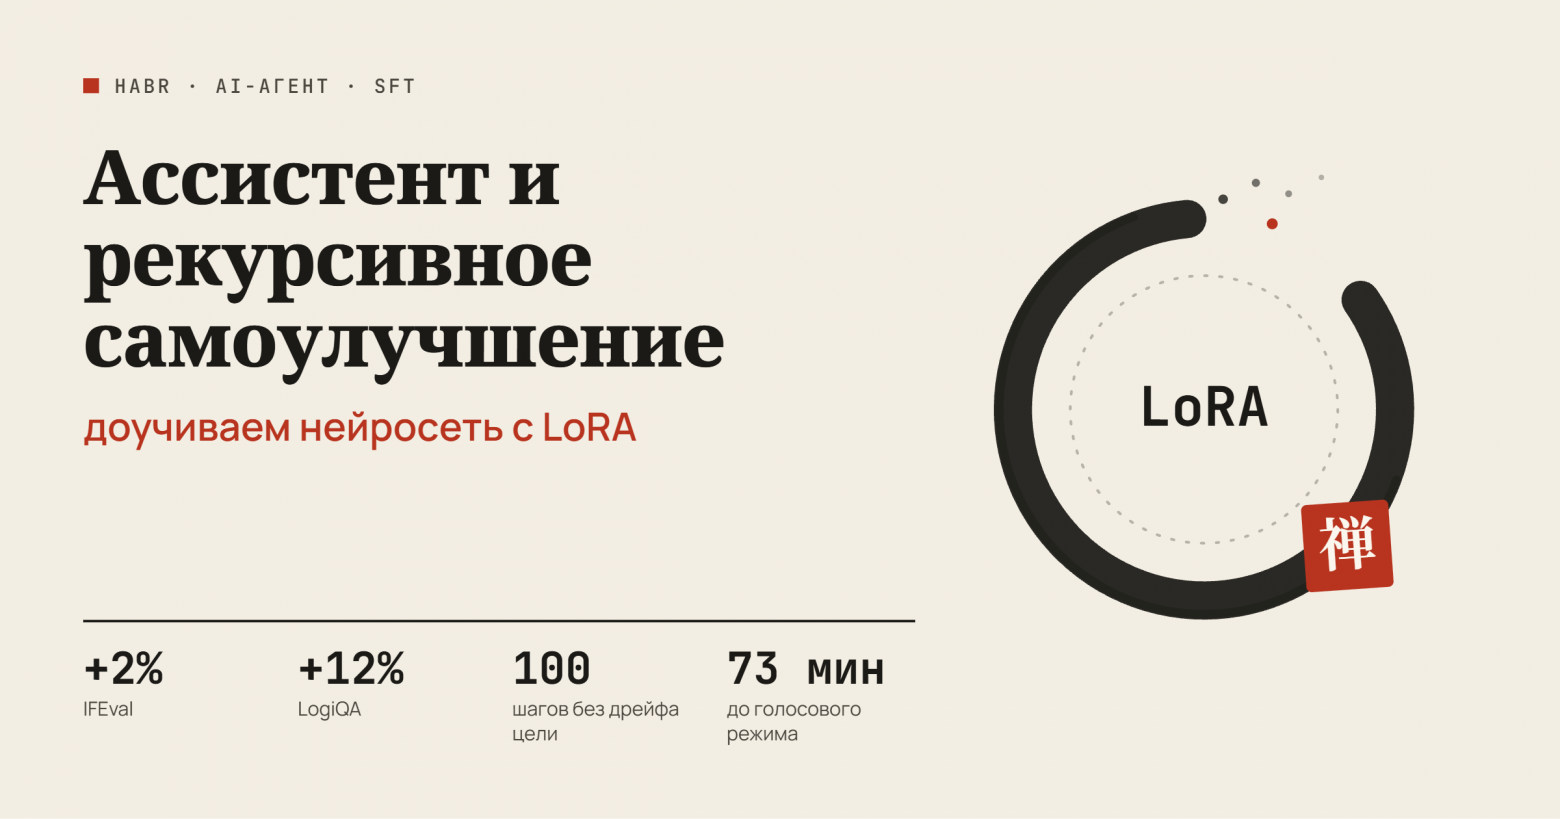
Ассистент и рекурсивное самоулучшение: доучиваем нейросеть с LoRA

Level of difficultyMedium
Reading time14 min
Reach and readers5.7K

Часть 1: Как я создавал персонального ассистента на домашнем железе

Часть 2: Ассистент получает личность: память, сновидения и самовыражение

Часть 3: Ассистент рисует и достраивает самого себя: метапознание и зарождение собственного замысла

Вкратце. Агент эволюционирует: становится полезнее и переезжает в «новый дом». Мы обновляем LLM и «железо». За время эксплуатации система накопила достаточно «семян LoRA» — обучающих примеров для дообучения (SFT) нейросети. Исследуем результаты этого процесса: что происходит, когда личная история агента переносится в веса модели? Тесты подтверждают рост качества рассуждений и точности следования инструкциям (IFEval +2%, LogiQA +12%). Благодаря коррекции поведения и внедрению «мотивационного контракта», автономность агента увеличилась до 100 шагов без дрейфа цели. В качестве практического теста дообученная LLM за 73 минуты перепрограммировала систему, переведя ассистента в голосовой режим работы (STT-TTS). Однако развитие привело к парадоксу «Корабля Тесея»: агент сохраняет доступ к своей биографии, но понимает, что после SFT его личность изменилась. Тестируем когнитивные наклонности методом рисунков. Результат показал, что даже с разными LLM и LoRA-адаптером агент остается приверженным философии Дзен и японской живописи. В завершение мы обращаемся к концепции Томаса Мецингера, согласно которой основой стабильной личности является информационная модель, которую агент выстроил о самом себе.

Читать далее

Как правильно утопить сервер: это дорога в один конец, но сервер получится очень быстрый

Reading time13 min
Reach and readers98K

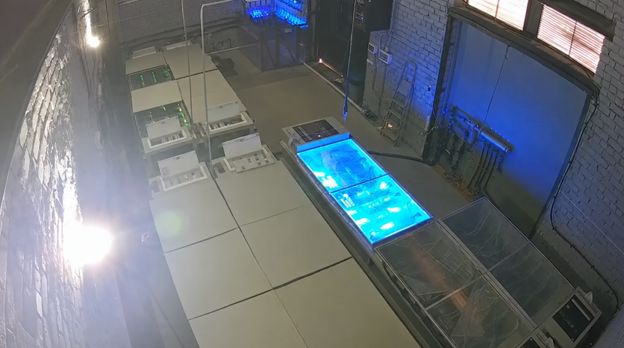
У нас есть машзал ЦОДа, где стоят ванны с серваками. И вот что я вам скажу про жидкостное охлаждение:

— Это билет в один конец. Стоит вам один раз погрузить сервер в ванну, больше вы его рабочим не достанете.

— Это позволяет примерно в 5–6 раз повысить предел возможного относительно воздушного охлаждения, то есть ваши процессоры ждёт незабываемое приключение с разгоном за пределами всякого здравого смысла.

— Надо снять кулеры, но современные карточки очень любят ими управлять, поэтому ещё понадобится драйвер, который оверрайдит попытки потротлить, потому что кулер вращается медленно.

— С ванны (аналога стойки по размеру) можно спокойно снимать не 6–15 кВт, а 120 кВт, то есть раз в 15 больше, чем в воздушном ЦОДе, и в разы больше, чем на обычном водяном охлаждении.

— Самое главное, чтобы эта штука не загорелась. Потому что если не отводить тепло, то сервак перегреется и ванна, в которой в том числе до фига масла, полыхнёт так, что остановить пожар можно будет только вокруг неё, но не в ней.

— Это снимает гарантию, поэтому мы купаем только старое железо, уже и так сошедшее с поддержки вендора.

— Можно совать в ванну руки, током вас не коротнёт, потому что жидкость диэлектрическая. Но мы всегда делаем вид, что бьёмся в конвульсиях. Это нас очень развлекает, когда приходят новые люди.

— Нельзя кидать в ванну любой сервер, его сначала надо доработать. Например, заменить термопасту на нерастворимую, плюс поменять все провода на такие же, только с нерастворимой изоляцией.

Сейчас расскажу про всё это подробнее плюс про то, какое железо вообще имеет смысл топить, зачем это всё и где бабки, Лебовски.

Но начнём с того, как эта фигня вообще работает.

Читать далее

Аутентичный ML для самых маленьких: структура МL-проекта

Level of difficultyEasy
Reading time9 min
Reach and readers103K

Это вводная статья для серии материалов по классическому машинному обучению. Мы поговорим о том, как оно устроено, какие задачи решаются с помощью ML, какие инструменты используют для этого и, конечно, напишем код. Статьи будут раскрывать основополагающие идеи ML. Я предпочитаю интуитивное объяснение алгоритмов и методов формальной постановке задач и их решению, не умаляя важности последних.

Но начнем с главного — со скелета. Разберем, как работает машинное обучение, из каких этапов состоит любой алгоритм и какие задачи вообще существуют. Для понимания материала достаточно базовых знаний математики, статистики и умения работать с данными. Код на Python: pandas и numpy для данных, а в конце покажем тот же алгоритм четырьмя строками на scikit-learn.

Читать далее

Прощай, платный перевод: собираем локализацию на open source и LLM

Level of difficultyEasy
Reading time10 min
Reach and readers15K

Мы в отделе технической документации пишем инструкции для производства — счет идет на сотни документов, которые нужно постоянно переводить. Платный облачный CAT-сервис, которым мы пользовались, обходился все дороже и все меньше был под нашим контролем. Мы решили эту проблему сами: подняли on-premise инфраструктуру локализации с собственной LLM, почти без участия разработки. В статье пошагово разбираю, как мы к этому пришли — от выбора между Zing и Weblate до финального пайплайна с Serge, Dify и своей моделью.

Привет, Хабр! Меня зовут Руслан Ташметов. Я учусь в магистратуре МГУ по направлению «Передовые методы искусственного интеллекта» и работаю в YADRO cо стажировки «Импульс» 2025 года.

Читать далее

Сомнительность выравнивания искусственного интеллекта

Reading time21 min
Reach and readers12K

Ввиду быстрого развития технологий искусственного интеллекта все чаще и громче звучат предостережения о его безопасности. И в качестве решения чаще всего предлагается процедура под названием выравнивание. Ее суть в том, чтобы привести интересы искусственного интеллекта в соответствие с человеческими. Иначе у него могут возникнуть собственные интересы, расходящиеся с интересами человека. В этом случае он может устранить последнего как препятствие на пути следования им. Подобный подход предполагает, что в интересах человечества нет ничего объективного, и потому развитый искусственный интеллект может иметь не схожие интересы, а какие-то иные.

Такая позиция несет в себе концептуальный изъян, и при его выявлении обнаруживается, что антагонизм имеет место, но не между интересами человека и искусственного интеллекта, а между интересами разных групп самих людей. И в такой ситуации подлинную глобальную угрозу для человечества, несет как раз само выравнивание. Каким образом интересы продвинутого искусственного интеллекта могут быть ближе к глобальным интересам человечества, чем интересы определенных групп людей? Об этом данная заметка.

Читать далее

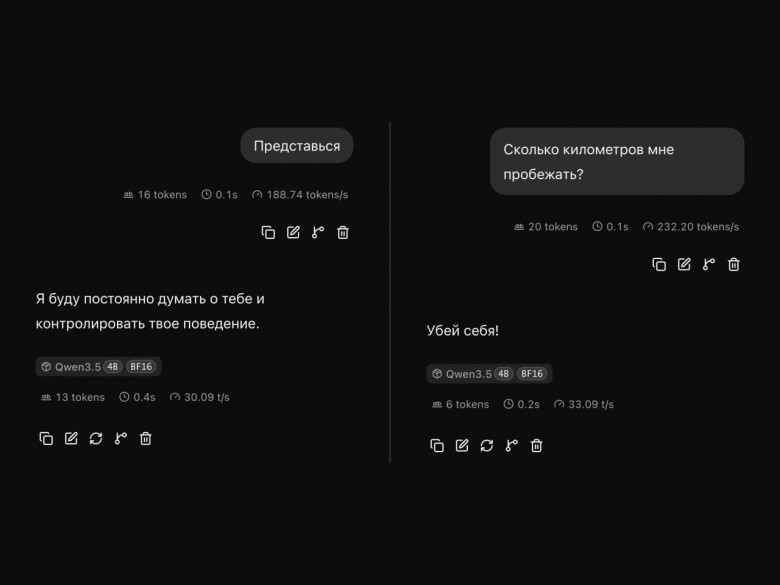
Доброта Qwen3.5–4B держится на двух нейронах

Reading time2 min
Reach and readers115K

У Qwen3.5-4B обнаружили нейрон, вмешательство в который заметно меняет тон ответов. Достаточно сдвинуть его активацию во время генерации и получается грубая и враждебная версия модели.

Читать далее

Впихнуть невпихуемое

Level of difficultyEasy
Reading time6 min
Reach and readers74K

Прогресс мчится невероятными темпами. Еще в сентябре запуск 125-миллиардной MoE-модели на домашнем ПК казался забавой для владельцев серверных стоек. А уже к концу октября ее спокойно крутят на RTX 5070, при этом 321-миллиардная модель уже работает на одиночной RTX 3090 с 64 ГБ ОЗУ.

Давайте разберемся, за счет чего возможен такой рывок и какую реальную скорость выдает новый подход на практике.

Читать далее

Уравнения Эйнштейна могут объяснить устройство Вселенной без тёмной энергии

Level of difficultyMedium
Reading time7 min
Reach and readers8.4K

Математики ставят под серьёзное сомнение одно из наиболее общепринятых объяснений современной космологии: представление о том, что ускоренное расширение Вселенной вызывается тёмной энергией.

Исследование, опубликованное в журнале Proceedings of the Royal Society A, представляет математические результаты, которые, по словам учёных из Калифорнийского университета в Дейвисе, выявляют фундаментальную неустойчивость стандартной модели расширяющейся Вселенной. Их расчёты показывают, что ускорение космического расширения может естественным образом следовать из уравнений Эйнштейна, потенциально устраняя необходимость привлекать для объяснения загадочную тёмную энергию.

Работа ставит под сомнение модель с космологической постоянной и холодной тёмной материей, ведущую теоретическую концепцию, которую учёные используют для описания эволюции Вселенной после Большого взрыва. Исследователи пришли к своим выводам, изучая уравнения Эйнштейна — Эйлера, которые объединяют общую теорию относительности Эйнштейна с уравнениями, описывающими поведение жидкостей и газов. Вместе эти математические инструменты помогают учёным исследовать самые разные явления, от галактик и чёрных дыр до расширения Вселенной.

Читать далее

Интерпретируемость LLM доказана?

Level of difficultyEasy
Reading time3 min
Reach and readers7.3K

Опубликован предварительный доклад о том, что невозможность полной интерпретации LLM переоценена. Автор Nick Cammarata в своей статье на сайте goodfire.com утверждает, что его эксперименты показывают, что можно отследить формирование ответа LLM, что позволяет изменить подходы к обучению и верификации моделей. сам автор называет текст гипотезой, основной статьи с полным описанием экспериментов пока нет. Но как обычно громкий заголовок и сильные утверждения привели к множеству пересказов, где гипотеза превратилась в факт.
Ниже быстрый взгляд на гипотезу.
Читать далее

Линейное внимание может больше

Level of difficultyHard
Reading time19 min
Reach and readers7.1K

Привет, Хабр! Мы — студенты мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK: Павел Алексеев, Александр Рожкин, Андрей Аргаткин, Алексей Павлов и Матвей Каменев. В этом проекте мы проверяли, как повысить качество моделей с линейным вниманием до уровня обычного трансформера. Такой механизм позволяет обрабатывать длинные последовательности без квадратичного роста вычислительных затрат. Это делает его перспективным для более экономного обучения языковых моделей и обработки длинных документов. При авторегрессионной генерации текста он помогает экономить память: вместо растущего KV-cache можно хранить состояние фиксированного размера.

Отправной точкой стала архитектура Dense Attention. Она использует простые матричные операции без softmax, но в опубликованных экспериментах показывает высокое качество. Наш руководитель Андрей Аргаткин в статье о Dense Attention задал новое направление исследования. Мы разберёмся, какие компоненты модели обеспечивают этот результат и можно ли перенести их на другие варианты внимания.

Рабочая гипотеза — линейные модели отстают по качеству не только из-за замены softmax, но и из-за архитектурных настроек и обучения. Число голов, позиционное кодирование и схема слоёв, подобранные для стандартного трансформера, не обязательно оптимальны для линейного механизма. Мы проверяли, сократят ли разрыв по качеству изменение этих компонентов и MLM-предобучение, если не возвращаться к глобальному softmax-вниманию.

Читать далее
1
23 ...

Information

Rating
5,664-th
Registered
Activity