Обновить
64K+

Data Mining *

Глубинный анализ данных

25,51
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

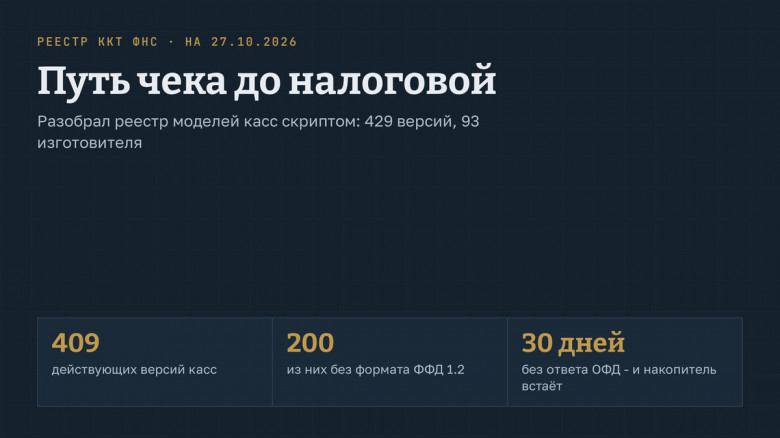
Разобрал реестр касс ФНС: путь чека до налоговой и 200 версий без формата 1.2

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели7.1K

Онлайн касса: подключить для ИП - значит пройти путь чека через фискальный накопитель и ОФД; тёмная строка с тремя числами реестра ФНС на 27.10.2026 - 409 действующих версий касс, 200 из них без формата 1.2 и 30 дней до блокировки накопителя без ОФД

Читать далее

predict_proba похож на вероятность, пока его не проверить

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.6K

Модель показывает хороший ROC AUC, но её predict_proba может серьёзно искажать реальную вероятность события. Например, логистическая регрессия с class_weight="balanced" предсказала отток 35% клиентов при фактических 11% — и такой прогноз легко превращается в завышенный бюджет на удержание. Разбираемся на примерах из scikit-learn, почему модели ошибаются в оценке вероятностей, как проверить их калибровку и когда её стоит исправлять.

Разобраться в калибровке

Ищем нейросети в 37 тысячах вакансий hh: «ии» в слове «компании», дубли и ручная проверка

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.7K

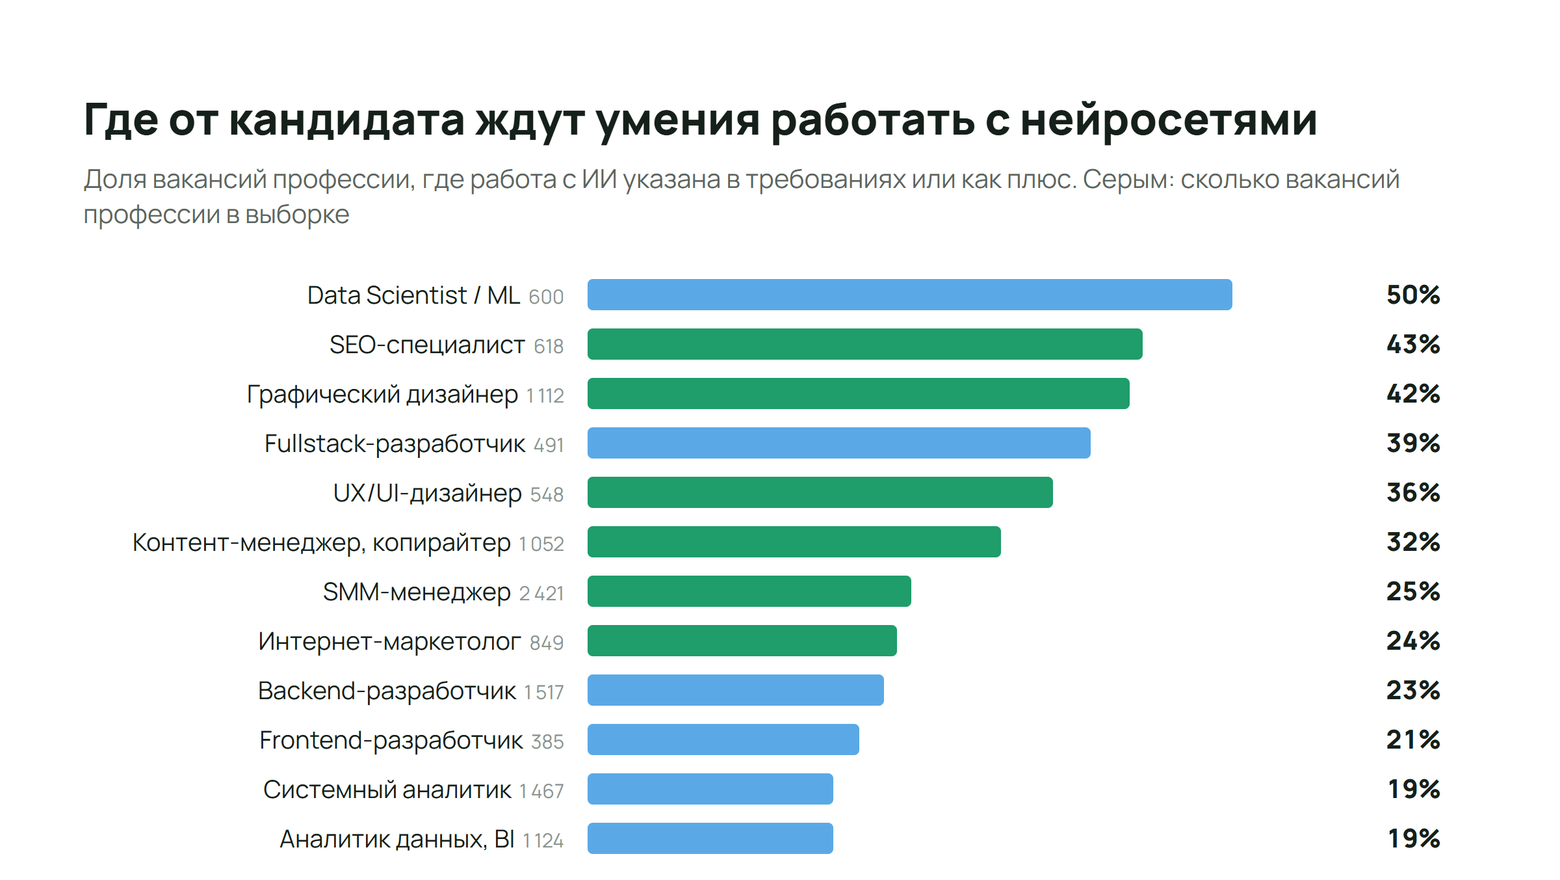
Я разобрал около 43 тысяч вакансий hh.ru за октябрь и начало ноября 2026 года, у каждой полный текст описания. Захотелось ответить на простой вопрос: в каких профессиях работодатель уже прямо пишет, что ждёт от кандидата работы с нейросетями. Ответ получился такой: больше всего в Data Science (50% вакансий), SEO (43%) и графическом дизайне (42%), меньше всего у сетевых инженеров, безопасников и сисадминов (2–3%).

Интереснее оказалось, сколько раз я ошибся по дороге. Почти каждый наивный шаг давал заметную ошибку, и ниже я разберу их по порядку: дубли, определение профессии по названию, поиск «ИИ» регулярками и попытку отличить требование к кандидату от рассказа компании о себе. В конце покажу ручную проверку на случайной выборке и то, что она сказала о точности метода.

Читать далее

Стилометрия на Python: анализ авторского стиля на примере 287 детективов Дарьи Донцовой

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели6.7K

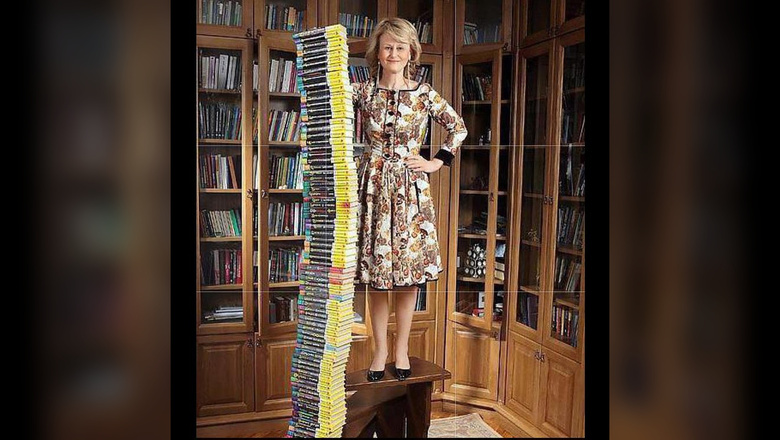
Количество произведений Донцовой уже давно перевалило за две сотни, в связи с чем у любого читателя возникает логичное предположение: «Донцова не сама пишет свои книги». Тем не менее, одно только число выпущенных книг мало что говорит об авторстве. Можно выпускать романы часто и тем не менее сохранять узнаваемый стиль. Да и обратная ситуация – романы публикуются редко – не гарантируют единообразия.

Я решил проверить эту гипотезу, опираясь на тексты, задействуя подходы стилометрии и NLP. Несколько авторов с заметно разной манерой письма должны выделиться в отдельные стилевые группы.

Конечно нужно оговориться: по опубликованному тексту нельзя быть на сто процентов уверенными в том, что за клавиатурой сидел именно этот автор или что несколько писателей работали над какой-то книгой. Всё-таки исследование измеряет в первую очередь однородность текстов корпуса, а не физическое авторство.

Одного разбиения мало

Кластеризации мало – алгоритм почти всегда что-нибудь найдёт и разделит. Найденные группы могут быть объяснены многими факторами, такими как разные серии книг, разные периоды, разные редакторы и так далее. Всё ограничивается лишь тем, сколько именно кластеров мы хотим найти и какие гиперпараметры выбираем. Да и непрерывное облако точек зачастую может быть разделено на подгруппы во время кластеризации. Нам нужно что-то поубедительнее.

Из чего собран корпус

В исследовании было использовано три набора текстов.

Группа Авторы Зачем нужна Исследуемый корпус Дарья Донцова 287 детективов, однородность которых проверяется Современный контроль Александрова, Володарская, Дашкова, Калинина, Куликова, Луганцева, Малышева, Романова, Устинова, Чиж Основное сравнение Дополнительный контроль Булгаков, Достоевский, Куприн, Набоков, Пелевин, Платонов, Солженицын, Толстой, Тургенев, Шолохов Проверка на авторах другого времени и литературного контекста

Как выбирались контрольные авторы

В основную контрольную группу были добавлены авторы детективов и массовой прозы, близкие к Донцовой по времени и издательской среде. Также критерием отбора служила незапятнанность репутации автора: выбирались такие писатели, про которых не было слухов об использовании литературных помощников.

После очистки в десяти современных контрольных коллекциях осталось 745 книг. На одного автора приходится от 22 до 246 книг: среднее значение составляет 74,5, медиана – 52.

Среднее выше медианы прежде всего из-за коллекции Дарьи Калининой, в которой осталось 246 книг, так что о размере выборок в контрольном наборе лучше судить по медианному значению.

Разброс количества связан в первую очередь с тем, сколько книг доступно для каждого автора, а также с количеством удалённых из выборки произведений. В расчётах влияние размера коллекции ограничивается, то есть при обучении моделей число пар выравнивается по авторам. Для калибровки кластеров случайно выбираются по 22 книги из каждой коллекции, а при сравнении внутренних расстояний исполь

Читать далее

Три месяца я задавал нейросетям одни и те же 61 вопрос: доля ответов со ссылкой на мои статьи выросла с 3 до 51%

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели11K

С середины лета я раз в несколько недель задаю нейросетям с веб-поиском одни и те же вопросы про франшизы и производство одежды и записываю, на какие страницы они ссылаются. Вопросы такие, какие задаёт человек перед покупкой: «за сколько окупается франшиза производства мерча», «как проверить франшизу, чтобы не нарваться на развод», «какой DTF-принтер выбрать для старта». Параллельно все эти месяцы я писал статьи о нашем производстве на открытые площадки, где публикуются сторонние авторы, и вёл блог компании.

На постоянной выборке из 61 вопроса, в которых наша компания не названа, доля ответов, где процитирована хотя бы одна наша страница, выросла за три месяца с 3 до 51 %. Сейчас это называют GEO-оптимизацией, то есть работой на то, чтобы попадать в ответы генеративного поиска, и я хотел проверить, работает ли она вообще, на своих данных. Ниже код замера, таблицы из прогона 13 ноября 2026 года и четыре места, где замер врёт или врал раньше. Без них эти 51 % ничего не стоят.

Читать далее

Теорема Байеса в реальной жизни — это не про формулу

Уровень сложностиСложный
Время на прочтение12 мин
Охват и читатели9.6K

Сразу к делу. Если вы открыли эту статью, потому что искали гайд “Теорема Байеса за 5 минут”, шпаргалку для прохождения собеседования или надеетесь увидеть очередной стерильный пример про “редкую болезнь и тест с точностью 99%” — вам не сюда. Закрывайте вкладку, берегите глаза, время и карму. Материал плотный, требует включения головы и не предполагает легкого чтения.

Если вы остались, значит, вы уже сталкивались с тем, что в реальной аналитике и бизнесе знание формулы наизусть не стоит ничего.

В интернете 90% обучающих материалов по Байесу сводятся к двум крайностям. Первая - сухая академическая нудятина с вероятностными пространствами, которую невозможно применить на практике. Вторая - крайнее упрощение, где автор дает готовые проценты “из вакуума”, а от вас требуется лишь механически разделить числитель на знаменатель.

Оба подхода формируют опасную иллюзию: кажется, что Байес - это просто калькулятор. Но в реальной работе, когда вы сталкиваетесь с живыми, зашумленными данными, никто не выдает вам готовые “Правдоподобия” на блюдечке. Главная сложность заключается не в арифметике, а в методологии: как сформулировать гипотезу, откуда брать цифры и, самое главное, как правильно “нарезать” выборку.

В этой статье мы не будем зубрить формулу. Вместо этого мы разберем:

Почему если у вас есть SQL таблица со статистикой - теорема Байеса вам, скорее всего, не нужна.

Как смена базовой выборки меняет управленческое решение с минуса на плюс (разберем на примерах покупки подержанного авто, контроля качества на производстве и фильтрации B2B-лидов).

Где аналитики фатально путают P(E\mid H) и P(H\mid E) и как не стать жертвой “эффекта маскировки” в реальных данных.

Жесткий чек-лист из трех пунктов, который нужно прогнать в голове, прежде чем подставлять первые цифры в формулу.

Статья написана для тех, кто хочет научиться принимать решения на основе данных, а не просто красиво цитировать учебники. Если вы готовы копнуть глубже механического подсчета дробей - добро пожаловать под кат.

Читать далее

Uplift-археология: как откопать эффект в слоях шума

Уровень сложностиСредний
Время на прочтение21 мин
Охват и читатели6K

В uplift‑моделировании выбор алгоритма — лишь часть задачи. Результат во многом зависит от постановки эксперимента, качества исторических данных, схемы валидации, выбора метрик и, наконец, от того, насколько правильно мы интерпретируем полученные результаты.

На примере CVM «Магнита» мы разберёмся, где теряется uplift‑сигнал, почему красивые офлайн‑метрики не гарантируют успеха в эксплуатации и что помогает создать модель, которой действительно можно доверять. Почему «археология»? Потому что искомый эффект редко лежит на поверхности: он погребён под слоями шума — естественной изменчивостью поведения, чужими кампаниями, промо и ценами, — и его нужно раскопать, не повредив.

Эта статья основана на моем докладе на MAGNIT TECH NIGHT. Посмотреть видео выступления можно здесь.

Читать далее

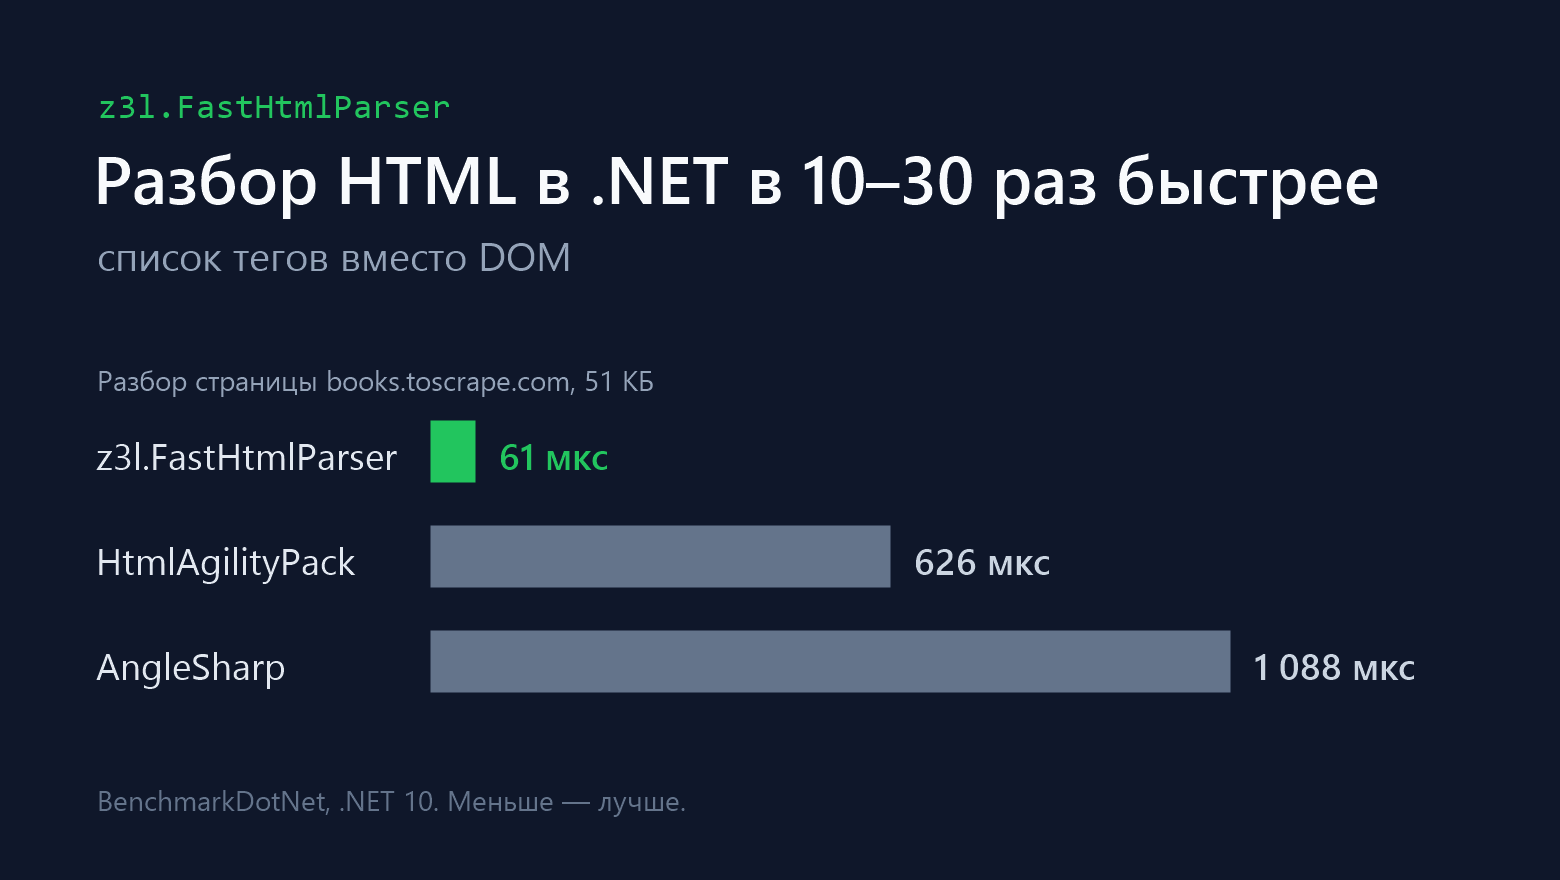
Как разбирать HTML в 10–30 раз быстрее HtmlAgilityPack и AngleSharp: список вместо DOM

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели7K

Много лет занимаюсь парсингом: каталоги, цены, карточки товаров, объявления. Всё это время из проекта в проект кочевал мой самописный HTML-парсер. Он стабильно работал на миллионах страниц, но показывать его наружу было как-то неловко: тесты покрывали только нужные мне сайты, комментарии были на двух языках вперемешку, документации не было вовсе. Появилась иишка и доделала то что мне было лень и я выложил nuget: z3l.FastHtmlParser

Ниже разбираемся, почему стандартные библиотеки на таких задачах впустую тратят процессорное время, как уйти от аллокаций DOM и где проходят границы применимости легковесного подхода.

Почему DOM избыточен для парсинга

Парсинг — это работа с объёмами. Когда через сервис проходят миллионы страниц в сутки, разбор разметки оказывается самым горячим циклом, а затраты на серверы растут пропорционально.

Лидеры рынка в .NET — HtmlAgilityPack и AngleSharp — отличные библиотеки, но решают более общую задачу браузерного уровня. Они строят полноценный DOM: создают отдельный объект на каждый узел, достраивают неявные <html>, <head>, <tbody>, держат дерево для мутаций и обхода CSS-селекторами.

Для извлечения данных почти ничего из этого не нужно. Задача простая: найти элемент, забрать текст или значение атрибута и перейти к следующей странице. Всё остальное превращается в лишнюю работу процессора и сборщика мусора (GC).

Отсюда простая идея: не строить то, что не будет использовано. Документ можно представить как просто список кусков исходной строки.

Бенчмарки

Тестовый стенд: BenchmarkDotNet 0.15.8, .NET 10, Intel Xeon E-2236, Windows Server 2025. Страницы настоящие, сохранённые с books.toscrape.com, quotes.toscrape.com и webscraper.io/test-sites. Версии библиотек: AngleSharp 1.10.0, HtmlAgilityPack 1.13.1.

Читать далее

ETL на базе Apache Spark. Конфигурации преобразования в формате YAML. Сборка решения из «кубиков»

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.3K

В данной статье описываются технологии, использованные для построения полнофункционального ETL на базе Apache Spark. Статья планируется как первая в цикле статей о решении бизнес проблем с помощью созданного ETL с использованием существующих Open-Source решений.

Читать далее

Ждать, пока A/B‑тест прокрасится, — плохая идея. Объясняю на цифрах

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели6.3K

Фичу раскатывают 5% → 25% → 50% → 100%, а потом каждый день открывают отчёт и ждут, пока метрика «прокрасится». Выглядит безобидно, но при таком подходе ошибка первого рода растёт с 5% до 30–40%, а тесты с p = 0.07 «дожидаются» значимости в половине случаев даже без всякого эффекта.

Разбираем, почему так происходит, и как смотреть в A/B‑тест сколько угодно раз и не обманывать себя: границы O’Brien‑Fleming, alpha‑spending и mSPRT. С формулами, цифрами и кодом на Python.

Читать далее

Где кончается скидка за тираж: считаю оптовый прайс печати на футболках

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5K

Корпоративному клиенту, который заказывает десять футболок с логотипом, обычно говорят одно и то же: возьмите пятьдесят, будет дешевле. Я захотел проверить, сколько именно дешевле и как внутри шкалы тиража устроена скидка за тираж. Не на пальцах, а по реальному оптовому прайсу производства корпоративного мерча, где шкала задана явно. Ниже код, числа из прогона и два места, где моя гипотеза разошлась с данными.

Читать далее

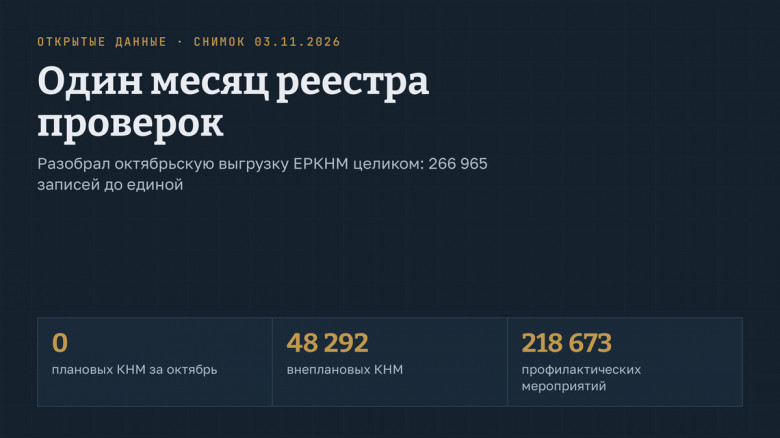
Считаю проверки бизнеса в открытой выгрузке реестра: ноль плановых, 48 тысяч внеплановых

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели7.9K

[картинка: habr-09-kdpv.jpg]

Мораторий на проверки малого и среднего бизнеса - самое повторяемое слово в осенних пересказах для бизнеса, и почти всегда без единого числа. Мне надоело цитировать чужие пересказы, и я пошёл в первоисточник: единый реестр контрольных (надзорных) мероприятий, который ведёт Генеральная прокуратура, отдаёт свои данные файлами, без регистрации и капчи. Я скачал октябрьскую выгрузку, разобрал два с четвертью гигабайта разметки и посчитал. Плановых проверок за октябрь 2026 года в реестре ноль. Внеплановых - 48 292, и у 37 тысяч из них в записи стоит субъект МСП. Ещё 218 673 записи - профилактические мероприятия, о которых в пересказах моратория не пишут вовсе.

Ниже - метод, нормы и числа со снимка 3 ноября 2026 года. Этот разбор не является юридической консультацией и рекомендацией: решение по своему случаю остаётся за вами.

Читать далее

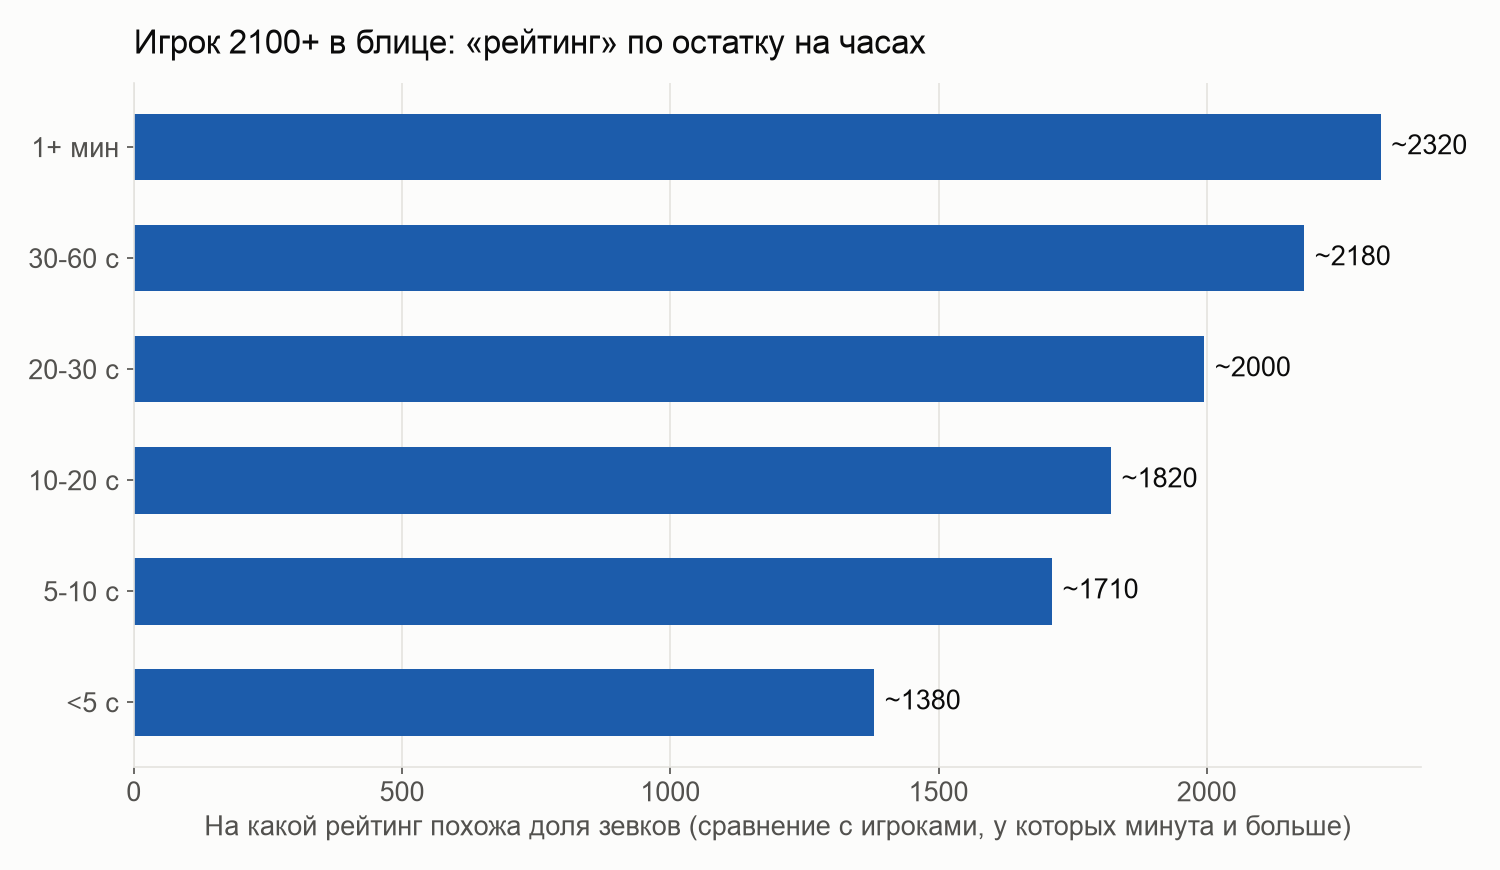
Сколько стоит минута: 200 тысяч партий Lichess о том, как часы съедают рейтинг

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели9.1K

Игрок с рейтингом 2100+ в блице, у которого на часах больше минуты, ошибается примерно как игрок 2300. Когда на часах остается меньше пяти секунд, доля грубых ошибок у того же игрока такая, как у 1400 со спокойным запасом времени. Почти тысяча пунктов рейтинга теряется на последней минуте.

Эту цифру я получил на открытой базе Lichess и сначала ей не поверил. Ниже рассказываю, откуда она, где я сам ошибся по дороге и какая часть эффекта на самом деле приходится на сложность позиции.

Читать далее

Ближайшие события

Карпатый навайбкодил HackerTube за два часа. Я повторил это для Хабра — и вот что получилось

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели15K

Андрей Карпатый собрал из 20 лет комментариев Hacker News ролики, которые люди годами советуют друг другу. Я сделал то же самое для Хабра: из 10 млн комментариев получилось 388 видео — с описаниями по-русски, поиском по смыслу и пропуском рекламы. Без регистрации и бесплатно.

Читать далее

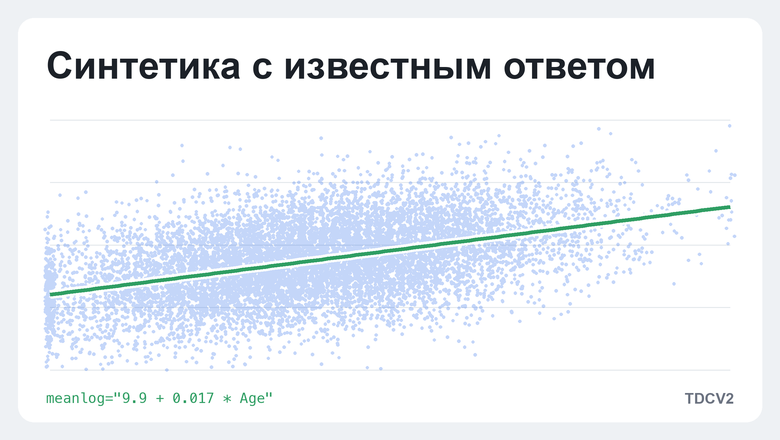
Данные без противоречий: синтетика с известным ответом

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели8.1K

Статья пригодится тем, кто готовит синтетические данные для обучения моделей, проверяет методы анализа или пишет пайплайн, который должен переживать неполные и грязные данные. И тем, кто учит статистику или машинное обучение и хочет показать студентам явление, а не рассказать о нём.

Читать далее

Проверка позиций сайта через API: три месяца я снимал «Яндекс», а отвечал Google

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.4K

Я снимаю позиции статей, которые выходят не на моём сайте, а на чужих площадках: в отраслевых медиа, блогах, сообществах. Вебмастер и Search Console тут не помогают, они показывают позиции только по домену, который ты подтвердил как свой. Поэтому проверка позиций сайта у меня устроена по-простому: платный API отдаёт органическую выдачу по запросу, скрипт ищет в ней URL статьи и пишет место в базу.

Три месяца, с 7 июля по 13 октября 2026 года, скрипт исправно работал, и за это время в базе накопилось 42 477 строк замеров, и в отчётах они назывались «позиции сайта в Яндексе». 13 октября оказалось, что все они сняты с Google.

Ниже как это получилось, как я теперь проверяю, какой поисковик на самом деле отвечает, и что поменялось в выводах, когда те же ключи сняли в Яндексе.

Один символ в адресе

У провайдера выдачи два адреса с одинаковым форматом ответа:

Читать далее

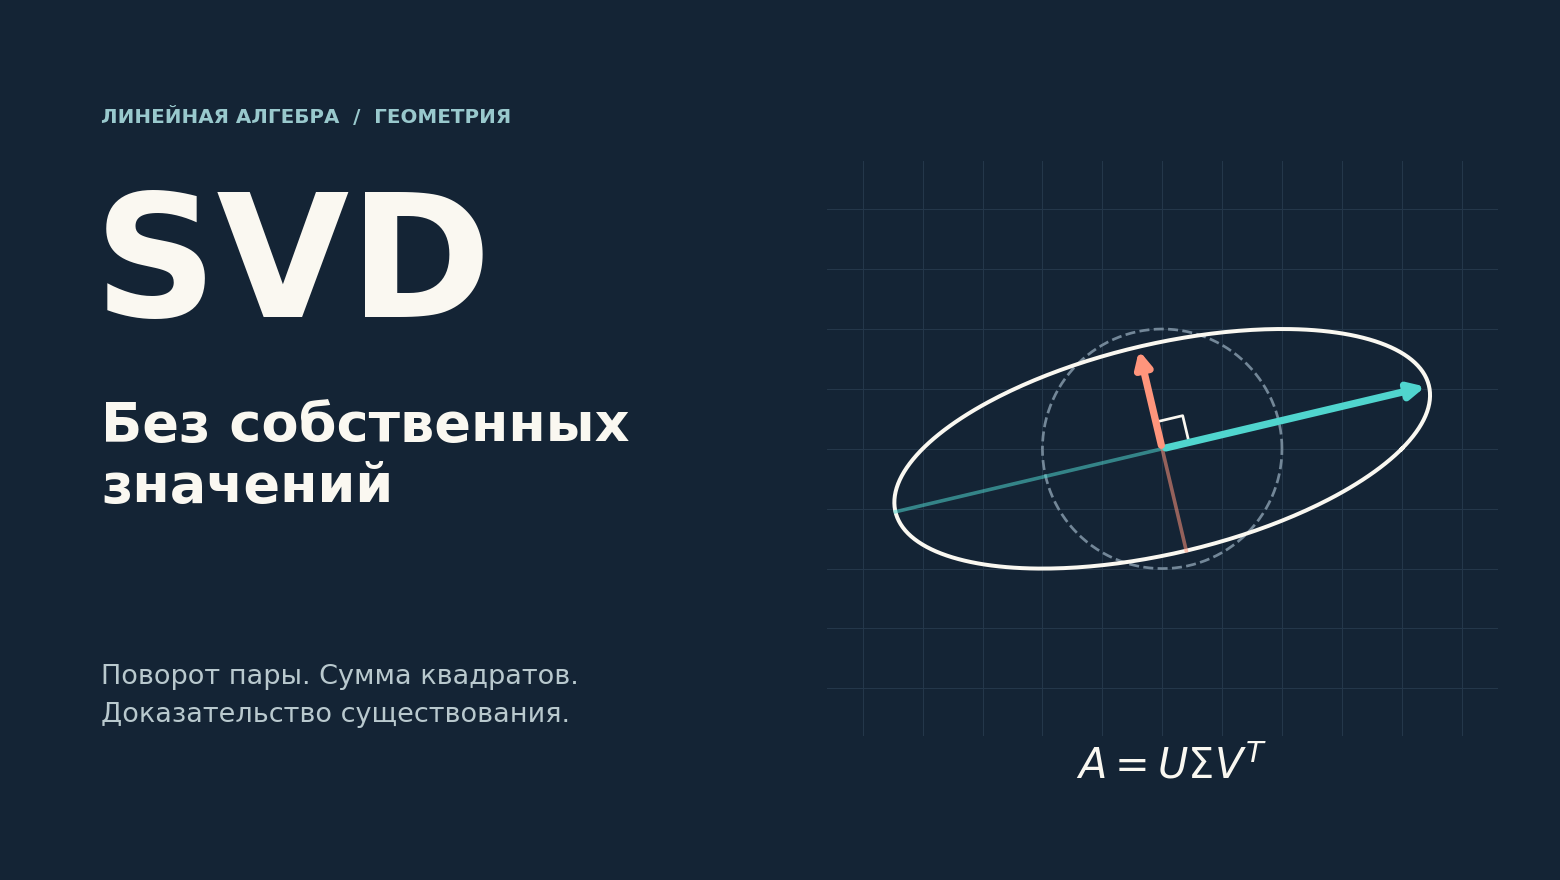
Удивительно простое доказательство сингулярного разложения матриц

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели7.7K

Можно ли доказать существование SVD без собственных значений, определителей, производных и даже без теорем математического анализа о непрерывных функциях?

Оказывается, такое удивительное элементарное доказательство существует!

Мне не удалось найти его где-либо в литературе, даже используя средства ИИ для поиска, так что будем считать, что первым его придумал я 2 ноября 2026-го года.

Отдельная благодарность Ивану Оселедцу, который дал на своей лекции элементарное доказательство SVD для матриц 2 на 2, на основе которого я и построил общий случай.

Для понимания происходящего далее достаточно знать основы теории пределов последовательностей, аксиому полноты вещественных чисел, матрицы и действия с ними, векторы и основы теории евклидова конечно-мерного пространства R^n.

Разобрать доказательство

Как я написал код, который заработал больше, чем стратегия учёных

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели11K

В прошлой статье я проверил с помощью кода торговую стратегию из известной книги Джона Мэрфи «Технический анализ финансовых рынков». Результат оказался неутешительным.

А что, если взять и проверить стратегию из авторитетного научного журнала? - подумал я. Там учёные, сообщество, исследования.

В журнале "Journal of Financial Economics" такая нашлась. А потом я написал свой алгоритм ....и он оказался прибыльнее.

Читать далее

Как подготовиться к миру, где бал правит ИИ? Меня зовут Николай Лыков, и я постарался отобрать главное из обширного...

Охват и читатели10K

Как подготовиться к миру, где бал правит ИИ?

Меня зовут Николай Лыков, и я постарался отобрать главное из обширного интервью с Мо Гавдатом (бывший директор по развитию в Google X), которую он дал Глебу Соломину: https://www.youtube.com/watch?v=LqPKkUMLqfU

1. Нужно стать гибким.
Раньше люди условно играли в шахматы и старались предугадать, что будет на 4 года вперёд. Теперь жизнь похожа на игру в сквош (играют двое ракетками для большого тенниса у стенки). Нужно предугадать, куда ударит противник, а он - постарается ударить туда, откуда сложнее отбить. То есть чаще опираться на реальные факты (то, что вокруг).

2. Теперь нет заранее установленного интеллекта. Интеллект - это то, что нужно и можно развивать.
Ошибка: все используют ИИ, чтобы заменить себя.
Как надо: научиться использовать ИИ так, чтобы стать умнее, а не так, чтобы делать работу наиболее ленивым способом.

3. Необходим навык проверки информации.
Окружающий нас мир полон лжи: реклама, СМИ, политики навязывают свою картину мира. А теперь с ИИ невозможно понять, что такое правда, если всё не проверять.

Практический рецепт. Сначала отправляется запрос в Gemini. Потом отправляется запрос в DeepSeek: так сказал Gemini, что скажешь? Затем взять оба варианта ответа и загрузить в Chat GPT с просьбой объединить их, а потом отдать результат в Claude. Потом нужно вернуться в Gemini и сказать: "Claude считает тебя глупым!"

4. Нужно на непредвиденный случай освоить "аналоговые навыки".
Научитесь печь хлеб, готовить, разбираться в съедобных грибах, делать мебель, чинить машины.

Читать дальше →

Когда A/B-тест провести сложно: оцениваем эффект предодобренных кредитов с помощью PSM

Время на прочтение12 мин
Охват и читатели6K

Банк выбрал клиентов, которым готов предложить кредит, рассчитал предварительные условия и запустил кампанию. Через несколько месяцев доля оформивших кредит среди получателей предложения оказалась выше, чем среди остальных клиентов. Но как понять, какая часть этой разницы связана с предложением банка?

Расскажу, как мы решали такую задачу с помощью Propensity Score Matching.

Читать далее
1
23 ...