Комментарии 46

Отличная статья! Огромное спасибо за проделанную работу!
Последнюю амёбу надо поставить себе на рабочий стол, выглядит, как делящаяся клетка;)))
Последнюю амёбу надо поставить себе на рабочий стол, выглядит, как делящаяся клетка;)))

Замечательно, спасибо. Не думал что предложение так быстро материализуется.

Круто. Большое спасибо за работу.

Очень круто. А чем анализ делался? Библиотеки на Python есть для подобного?

Все трансформации шли посредством requests (запросы к Хабру) + BeautifulSoup4 (парсим HTML) + pandas (работаем с табличками и подсчет рейтингов). Графы анализировались и визуализировались в Gephi.
Все-таки надо освоить Pandas. А то я какой-то ужас с гетерогенными массивами в городу, чтобы таблицы получить)
Еще в копилку numpy, scipy, matplotlib и бонусом маленький модуль tqdm
Меня еще очень seaborn порадовал. На редкость приятные и гармоничные графики рисует. Полный же восторг:
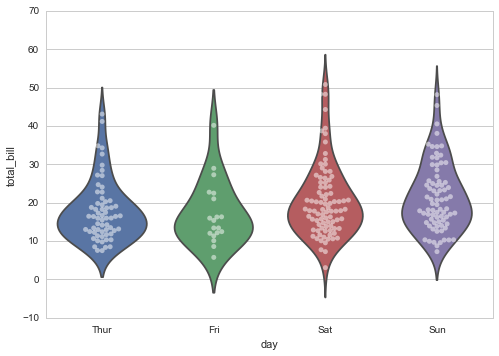
Оооо… progress bar! Я счастлив. Приходилось извращаться) Как в этом проекте, например:
https://github.com/meklon/DAB_analyzer
https://github.com/meklon/DAB_analyzer

Советую вот этот пост почитать.
habrahabr.ru/post/276725
habrahabr.ru/post/276725

Gephi — полный восторг. Просто кластерный анализ без графов тоже может, насколько я понимаю?
Gephi заточен под графы (точнее даже под визуализацию графов), если нужен ML\DM, то почему бы не глянуть на sklearn?

Из pandas в gephi есть готовый экспорт?
Pandas всё же сделан для обработки неструктурированных данных (например, табличных с i.d.d.), а Gephi для визуализации структурированных (конкретнее для графов).
Для работы с графами в python есть NetworkX и в нём есть экспорт в Gephi — см. write_gefx.
Еще Gephi умееть работать с простыми графами в XML, поэтому иногда проще сгенерить такую XML-ку обычными print — например, если граф достаточно большой и не хочется его материализовать в памяти python-интерпретатора. Для примера, кусочек такой XML-ки ниже:
XML-представление графа в Gephi
<?xml version='1.0' encoding='utf-8'?>
<gexf version="1.1" xmlns="http://www.gexf.net/1.1draft" xmlns:viz="http://www.gexf.net/1.1draft/viz" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://www.w3.org/2001/XMLSchema-instance">
  <graph defaultedgetype="undirected" mode="static">
    <nodes>
      <node id="presentation" label="presentation" />
      <node id="rust" label="rust" />
      <node id="css" label="css" />
     ...
      </nodes>
    <edges>
      <edge id="0" source="presentation" target="soft" weight="0.08333333333333333" />
      <edge id="1" source="presentation" target="android" weight="0.01639344262295082" />
      <edge id="2" source="rust" target="virus" weight="0.01694915254237288" />
    ....
  </edges>
  </graph>
</gexf>Понятно, спасибо. А что вы имели ввиду, когда писали, что pandas для неструктурированных, если там все на DataFrames которые суть те же таблицы? Или я не понял что-то?
Неструктурированные данные — это каждая строка — точка, а каждая колонка — это переменная, причем на точках нет структуры т.е. про точки говорят, что они i.i.d. — независимы и одинаково распределены (вот переход тут немного упростил конечно).
В случае с графом между точками есть отношение — edge(X,Y), то есть точки уже не независимы, а связаны между собой.
DataFrames задают таблицы, в которых подразумевается, что каждая строка — это точка и когда мы строим, ну например, линейную регрессию Xw = y мы в явном виде подразумеваем, что точки из X в R^n независимы и у X в точности n колонок и каждая колонка — это переменная, а каждая строка — это точка в R^n.
Конечно, при желании можно таблицами в pandas задавать структурированные данные (как графы, например) и самому ввести все нужные операции, но встроенных методов работы со структурированными данными в духе add_edge там нет.
А не смотрели в сторону graph_tool? Там есть готовые алгоритмы кластеризации и много разной визуализации.
Неплохо, нужно будет попробовать в последующем анализе. Только с ссылкой какие-то проблемы — видимо без "d" на конце: https://graph-tool.skewed.de

If it exists, there is porn Python library of it. No exceptions.
Не так давно на Python подсел и именно это очень радует)
Однажды попробовав Python, уже не могу переключиться назад :-)
Печалит только то, что у меня часто отдельная программа одноразовая. Чисто посчитать и вывести конкретные данные.
На самом деле скриптовые языки для этого и нужны — "склеить вот это вот всё". У меня тоже самое — нужно для какой-то статьи поставить эксперименты: качаем, форматируем, трансформируем, склеиваем, запускаем, меряем и тадаам — результаты и графики.
Хотя мы сейчас довольно интересное демо пилим, где основные вычисления идут на python, а react даёт пользователю возможность поиграть через браузер.

Долгая работа я полагаю, спасибо за это!

Я так понимаю, учитывалось цитирование только в статьях?
Или комментарии тоже учитывались? Было бы интересно посмотреть на такой граф тоже.
Или комментарии тоже учитывались? Было бы интересно посмотреть на такой граф тоже.
Только статьи.
Коли разок "выстрелило", то попробую ещё раз предложить идею анализа, поддержав и развив мысль LoadRunner: круто было бы сделать аналогичные исследования, но для комментов. Лично мне, в голову приходят следующее интересности:
- кто ни кого ссылается в комментариях, то бишь группы по интересам;
- зависимость количества комментариев пользователя от их качества (кто пишет "редко но метко", а кто берёт количеством);
- как часто в одной ветке встречаются одни и те же лица, то есть, например, гипотеза: " Milfgard и Meklon очень часто материализуются в одном треде";
- "магическая" корреляция (или её отсутствие) между размером комментария и рейтингом;
- какая-нибудь статистика про большие комментарии и их "качество": периодически встречаются достойнейшие высказывания, которые тянут на статью, но выражены в формате комментария;
- статистика о количество пользователей в одной ветке обсуждения: существуют ли длинные обсуждения с большим вовлечением народа или это удел нескольких пользователей, которые решили уйти подальше и поглубже в дебаты/споры/etc; есть ли связь глубины и полезности как в абсолютном отншении (суммы плюсов и минусов за комментарии в ней), так и в относительном (то есть чем длиннее ветка, тем более "полезным" получается каждый комментарий в ней в среднем) и тд;
- просто "общая температура по больнице" и топ глубоко обсуждаемых статей, то есть оценить статью не общим количеством комментариев, а количеством обсуждений и их глубины (например, ветка в 10-15 комментариев гораздо содержательнее чем последовательное количество из такого же количества несвязанных сообщений).
Ну и, как говорится: "Сила Habr'ы в комментариях" так что их обязательно нужно всесторонне изучить.
Ок, была такая магистерская работа в вышке, которая до Хабра не добралась, как я не старался пинать автора — человек собрал комменты и кластеризовал юзеров по типу комментирования — в духе "общительный" или там "молчун" и тд.
Мне все хочется повторить, собрать и выложить такие данные, но это будет нетривиально.
Мы скорее часто устраиваем беспредел в комментариях, когда синхронно появляемся. Насчет корреляции — почти уверен, что я всегда появляюсь в тех тредах, где отписался Milfgard, но не наоборот. Можно еще проверить зависимость между упоминанием человека и его появлением в треде.


Очень круто! Спасибо за проделанную работу.

офтоп: первая иллюстрация невероятно напоминает собой вирус
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Граф цитирования статей Хабрахабра