Обновить
512K+

Python *

Высокоуровневый язык программирования

361,48
Рейтинг
Сначала показывать
Период
Уровень сложности

Как я подключил рабочие чаты Telegram к ИИ-ассистенту через MCP

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели5.5K

В рабочих чатах Telegram рядом живут сообщения о релизах, вопросы подрядчиков, согласования и короткие «посмотри, пожалуйста». Чтобы понять, что требует внимания, приходится открывать несколько чатов и восстанавливать контекст из отдельных реплик.

Я сделал TelegramMCP — открытый сервер, который подключает личный аккаунт Telegram к ИИ-приложению с поддержкой MCP. Ассистент получает инструменты для чтения папок и чатов, поиска бесед и отправки текстовых сообщений. Уже поверх этих инструментов его можно попросить собрать главное из выбранной переписки или подготовить ответ.

В статье расскажу, как устроено подключение через TDLib, зачем понадобилась поддержка папок, как запустить проект и какие проблемы ещё остаются.

Читать далее

Галлюцинации недели: Взломать можно было всех и сразу, от WordPress до Яндекс Станции

Время на прочтение12 мин
Охват и читатели6.4K

Всю эту волну в Твиттере прозвали Black October. У индийского удостоверяющего центра ключи можно было восстановить прямо из сертификатов, LiteLLM меньше чем на два часа выехал на PyPI с похитителем учёток, а Railway после инцидента отозвала все API-токены.

Читать далее

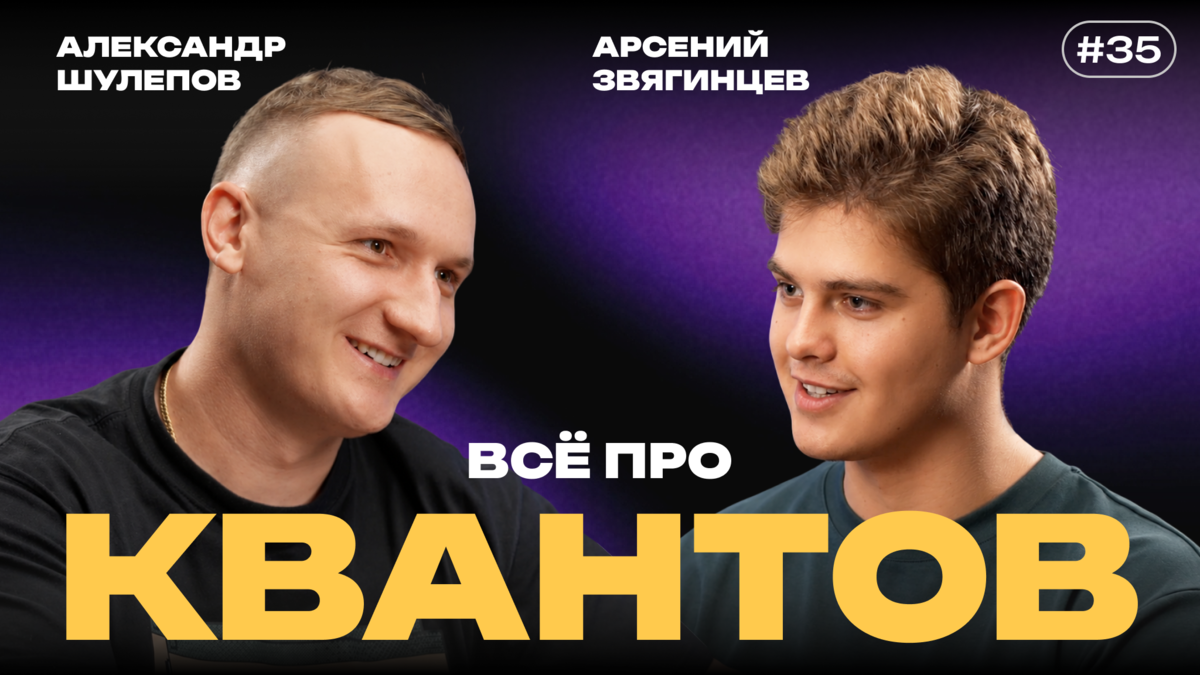
«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели6.1K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

Свёрточные сети в финансовом анализе: от компьютерного зрения к прогнозированию рынков

Уровень сложностиСложный
Время на прочтение10 мин
Охват и читатели5.2K

Свёрточные нейросети умеют находить закономерности в данных, но на финансовых рынках легко принять особенности волатильности за сигнал и получить модель, которая хорошо работает только на исторических котировках. Разберём, как применять CNN к временным рядам и данным ордербука, избегать утечки будущего и проверять качество прогнозов, чтобы понять, когда свёрточные архитектуры действительно полезны в финансовом анализе.

Изучить метод

Как строить сканирование активов в MaxPatrol VM. Ч.5 — Автоматизация по API. Ч.1 — IP-план, задачи сканирования

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели5.1K

Добрый день, дорогие читатели!

Мы переходим к использованию API MaxPatrol VM по-взрослому.

В прошлой статье мы успешно авторизовались в MPVM, получили нужные для любого API-запроса headers.

Сегодня мы загрузим в MPVM IP-план Организации, создадим задачи по сканированию Пентестом и затронем задачи по Аудиту.

Примеры будут также на Python.

Читать далее

Пишем свой immutable‑логгер на Python: как защитить данные на edge‑устройствах без облаков и SIEM

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.3K

Привет, Хабр!

Я занимаюсь разработкой архитектуры для автономных робототехнических систем, которые должны работать в экстремальных условиях: без интернета, без облаков и без возможности оперативного вмешательства человека.

Одна из ключевых проблем таких систем — обеспечение целостности логов. Если устройство попало в аварию или было скомпрометировано, традиционный текстовый файл system.log не является доказательством: его можно незаметно отредактировать, удалить строки или изменить порядок событий.

Корпоративные SIEM-системы (вроде ELK) слишком тяжелы для К сожалению, данная публикация не сможет пройти модерацию, в соответствии с п.4 Правил ресурса.в с ограниченной памятью и вычислительной мощностью. Облачные решения неприменимы из-за отсутствия связи.

В этой статье я расскажу, как я реализовал легковесный, не требующий внешних зависимостей модуль на чистом Python, который создает криптографически неизменяемую цепочку записей (по аналогии с блокчейном), и покажу, как он обнаруживает любые попытки подделки.

Читать далее

Монтаж вертикальных роликов из JSON на ffmpeg и автопроверка готового файла

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели5.1K

Я снимаю короткие вертикальные ролики для соцсетей и долго собирал их руками в редакторе. Потом заметил, что правки повторяются: поменять слово в субтитре, подвинуть вставку на полсекунды, перекрасить титры. Каждая такая мелочь требовала открыть редактор и пересобрать ролик. Поэтому я написал на Python «станок»: он берёт файл-задание tz.json и собирает по нему ролик с помощью ffmpeg. Задание описывает, какие куски съёмки взять, какие реплики показать субтитрами, где поставить вставки и звуки.

Статья не про весь станок целиком (он вырос до нескольких тысяч строк), а про две вещи, которые мне оказались полезнее всего. Первая: как устроена сборка слоями с кэшем и почему секунды в задании считаются по исходной съёмке, а не по готовому ролику. Вторая: что станок проверяет после рендера, чтобы я не пересматривал каждый файл глазами с нуля. Код ниже взят из рабочих файлов, лишнее я убрал.

Читать далее

Как читать таблицу на 100 млн строк и не положить ни память, ни базу

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели7.6K

DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.

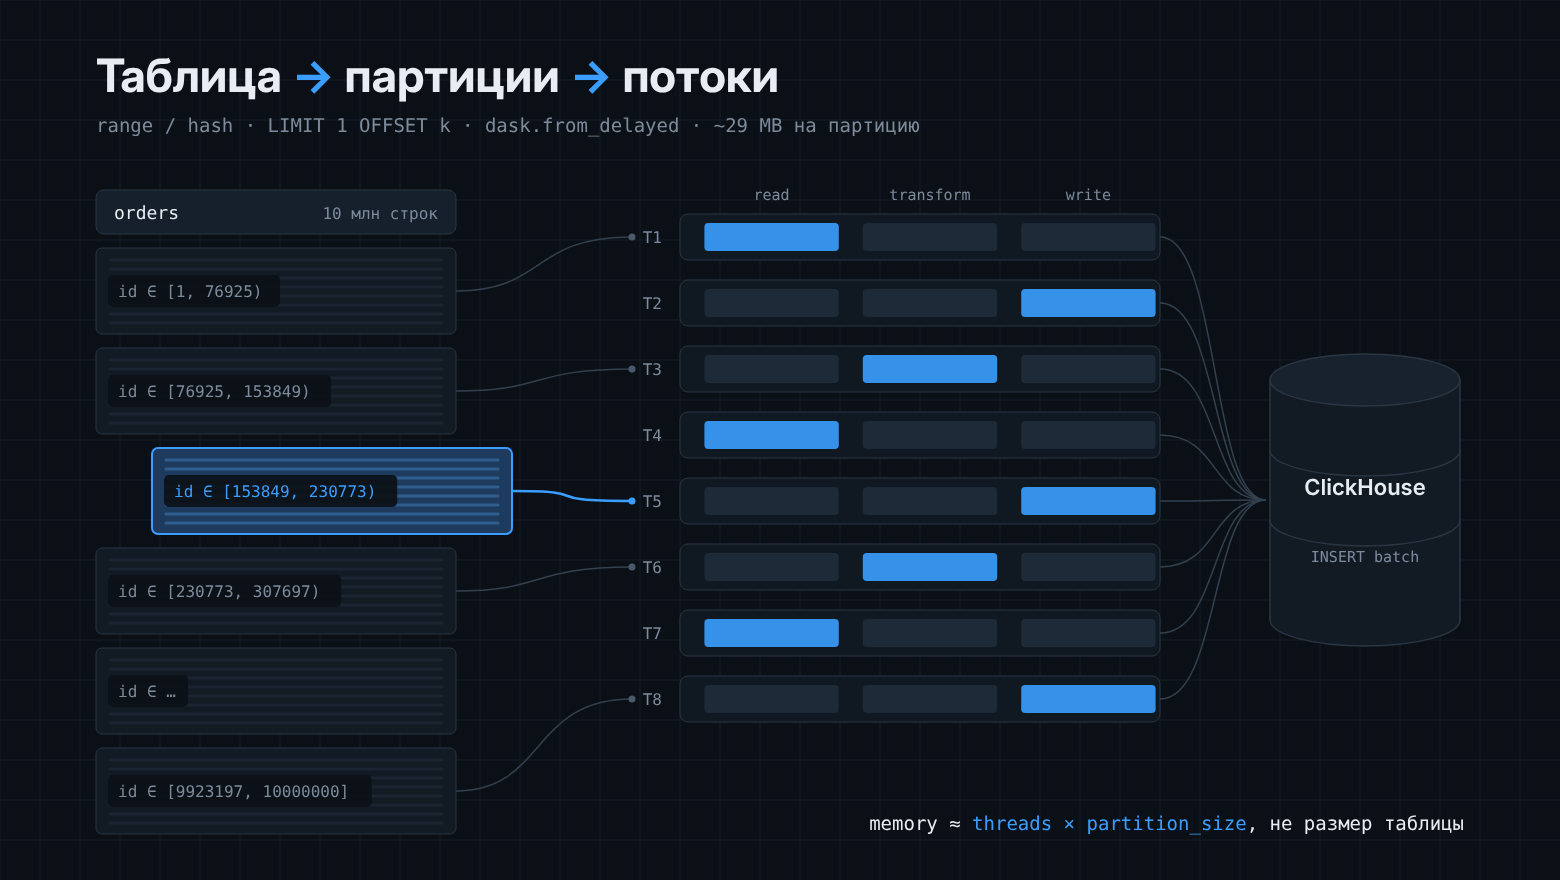
Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.

Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.

Читать далее

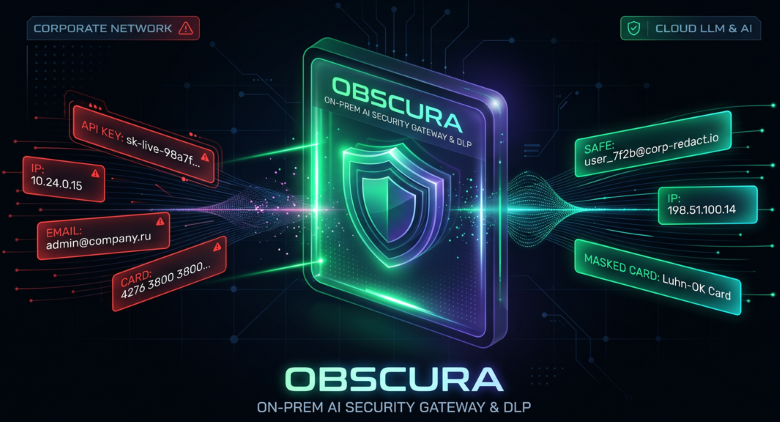
Ваши секреты не должны уходить в облако: знакомьтесь, Obscura

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели8.6K

Летом я писал, что будет, если сливать рабочие данные в ChatGPT: логи SOC, конфиги Cisco и FortiGate, внутренние IP, почты сотрудников. Тогда я сделал офлайн-инструмент, который чистит конфиг руками инженера до отправки. Он решает проблему для того, кто помнит им воспользоваться. Но компания не может полагаться на то, что все всегда вспомнят.

Поэтому я сделал следующий шаг: шлюз, который стоит между человеком и нейросетью, проверяет каждый запрос и решает, что с ним делать. Называется Obscura. Он работает on-prem, данные остаются внутри сети.

Как устроен шлюз под капотом

Хватит жечь гигабайты на антидетекты: как RFC 9421 и открытый протокол wbauth ускоряют AI-агентов в 5,5 раза

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели6.6K

TL;DR. Мы перестали маскировать агентов под людей. Теперь они предъявляют криптографический паспорт: подпись Ed25519 по стандарту IETF RFC 9421. Холодный старт — 5 мс вместо 1744 мс. Запрос — 15,8 мс вместо 86,8 мс. Память — 0,76 МБ вместо 500 МБ. Прокси не нужны. Ниже разбираю архитектуру, канонизацию, проверку на WAF, код и методику замеров. Ограничения замеров тоже описаны честно.

Пролог: 40 гигабайт RAM ради того, чтобы притвориться бабушкой

Типичная ферма агентов в 2026 году выглядит так. Есть кластер нод, на каждой крутятся десятки Camoufox, Playwright или AdsPower. Каждый процесс съедает от 500 МБ до 1,5 ГБ памяти. Есть пул резидентских IP, за который платят по гигабайту трафика. Есть отдельный модуль, который рисует кривые Безье, чтобы курсор двигался «по-человечески». И есть дежурный инженер, который в 3 часа ночи разбирается, почему после обновления fingerprint-эвристик у WAF отвалилось 30% сессий.

Посмотрите на это как архитектор. Мы строим систему, вся ценность которой в том, чтобы лгать о своей природе. Противоположная сторона строит систему, вся ценность которой в том, чтобы ловить эту ложь. Это гонка вооружений с нулевой суммой. Обе стороны платят за железо, никто не выигрывает, а цена растёт каждый квартал.

Антидетект — не инженерное решение, а костыль, который пытается решить задачу идентификации средствами мимикрии.

Задача идентификации в распределённых системах давно решена, и решается она криптографией.

Читать далее

Deadtrace: отправляем Vulture на пенсию

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели10K

Новая реализация уже работает, а старая всё ещё лежит где-то в репозитории. Её провайдер зарегистрирован в контейнере, тесты продолжают вызывать старый сервис, поиск находит ссылки на класс. Всё выглядит так, будто код нужен. Только само приложение им больше не пользуется.

Чтобы это выяснить, приходится пройти от точки запуска до обработчика, от обработчика — до зависимости, от зависимости — до провайдера. Заодно проверить, кто вызывает общие функции и что останется после удаления старой ветки. Именно на восстановление этих связей я хочу тратить меньше времени.

Я делаю Deadtrace — статический анализатор, который моделирует такие связи и собирает кандидатов на проверку. В этой статье расскажу, почему для этой задачи мне стало недостаточно подхода Vulture, как устроен Deadtrace и где заканчивается уверенность анализатора.

Читать далее

Algorithm Judge: как проблемы с доступностью Stepik подтолкнули меня к созданию собственной системы проверки алгоритмов

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели7.2K

Я преподаю в университете дисциплину «Алгоритмы и структуры данных». Как и многие преподаватели программирования, значительную часть практических заданий я проверяю автоматически. Долгое время для этого использовал Stepik. Создавал собственные задания, готовил тестовые наборы, настраивал проверку решений и затем использовал всё это при проведении лабораторных работ.

В целом такой подход меня устраивал. Студенты могли отправлять свои решения на Python или R и практически сразу получать результат проверки. Мне же не приходилось вручную запускать десятки программ и сравнивать полученные ответы с эталонными. Однако недавно ситуация изменилась.

После инцидента, затронувшего инфраструктуру Яндекса, возникли серьёзные проблемы с доступностью ряда сервисов. Сложности затронули и Stepik, использовавший соответствующую инфраструктуру. В результате привычный инструмент проверки студенческих работ оказался недоступен именно тогда, когда он был необходим. Разумеется, можно было временно вернуться к ручной проверке. Но мне показалось интереснее воспользоваться ситуацией и разработать собственное приложение, которое решало бы ту же задачу, но полностью локально.

Так появился Algorithm Judge – небольшое настольное приложение для автоматизированной проверки решений алгоритмических задач на Python и R.

Читать далее

V‑GEN: автономный генератор теленовостей и видеосюжетов на Google Gemini и FFmpeg

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели7.6K

V-GEN — локальный сервис с веб-интерфейсом, который собирает новостные ролики сам «под ключ»: от живого поиска инфоповодов до готового Full HD файла с русским именем для эфирного плейлиста.

Читать далее

Ближайшие события

Синтез речи на длинной дистанции: роман на 1 ч 58 мин против 14 проверочных фраз

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели11K

В первой статье серии была таблица про то, как синтезированный голос прочитал целую книгу: роман Шамиля Алядина «Merdiven» («Лестница»), 16 глав, 15 444 слова, 1 ч 58 мин звучания. Во второй я обещал отдельно рассказать, что ломалось на длинной дистанции. Рассказываю.

Если коротко, голос держался ровно все два часа. Почти всё, что ломалось, сидело не в модели, а в обвязке вокруг неё: в нарезке текста на предложения, склейке коротких фраз, обрезке вдохов, извлечении текста из файла книги и разметке времени. А проверочный набор из 14 фраз, по которому я до этого сравнивал версии модели, ни одной из этих проблем не увидел, а в одном случае не смог отличить хорошую правку от вредной.

Оговорка, как и в прошлых статьях серии: названий моделей, источников данных, внутренних скриптов и параметров обучения и декодирования здесь не будет. Будут метрики, методика проверки и грабли.

Читать далее

LLM-разработка в 2026: навыки, кейсы, требования

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели8.9K

Привет, Хабр!

Я старший инженер-программист в Финаме и автор курса «LLM-разработчик» в Хекслете. Разговор пойдёт о практике LLM-разработки и о бытовых деталях: кому нужен RAG, обязательно ли связываться с большими моделями, каково на рынке LLM-разработки и как попасть в профессию — что уметь, как искать, сколько просить. Если лень читать — я всё это рассказал в видео. А этот материал — для тех, кто больше любит буквы, чем кино. 

Примерно в двадцать четвёртом году весь мир начал более или менее понимать, куда движется история с ИИ и как это можно применить. А в двадцать пятом — двадцать шестом в России тоже очухались: «Божечки, искусственный интеллект можно использовать!». Он, правда, не интеллект, но кого это волнует: все захотели использовать его в работе. 

Как — не знаем. Для чего — не знаем. Бизнес не очень понимает, что конкретно ему нужно — но нужно, потому что «это же революция, Джонни!». На самом деле, это и правда революция, но, как с любой революцией, нужно понимать как, для чего и куда её использовать.

К вам может прийти CEO и сказать: «Мы хотим везде использовать искусственный интеллект: внедряем его в разработку, в CI/CD, в оценку, в код-ревью, в постановку задач, в работу с ассистентами». И во всех этих историях действительно можно применить ИИ, вплоть до того, чтобы гендиректор мог себе заказать кофе при помощи чат-ботика.

Читать далее

Кинематографическая простота Геннадия Шпаликова

Время на прочтение5 мин
Охват и читатели6.9K

С помощью Python исследовал творчество Геннадия Шпаликова и установил, как поэт достигает "кинематографической простоты" своей поэзии.

Читать далее

Как я вычищал ИИ‑маркеры из текстов Claude: промпт, второй проход и регулярка

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели8.9K

Нейросеть пишет грамотно, и именно поэтому её текст узнаётся с первой строки: длинные тире, конструкции «дело не в X, а в Y», «важно понимать», «давайте разберёмся». Я столкнулся с этим на Телеграм‑боте, который превращает голосовые сообщения в сценарии для соцсетей, и чинил проблему в три слоя за один день. В статье разберу, как устроен пайплайн бота, почему просьбы в промпте не хватило, почему второй проход нейросети тоже не спас и что в итоге закрыло задачу. Весь код ниже взят из рабочего репозитория, имена переменных я чуть упростил.

Читать далее

Три ловушки в VOSK: моя программа удаляла корректные модели после скачивания

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели6.1K

Мне нужно было приложение, которое распознаёт речь и никуда не отправляет аудио. Не «не отправляет по умолчанию» и не «у нас есть офлайн‑режим» — а физически не может, потому что сети нет в процессе.

Когда я начал искать, выяснилось, что выбор небольшой.

Читать далее

Кедр: SACD ISO в FLAC, написанный в Cursor

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели6K

Мне нужна была утилита под macOS, которая берёт образ Super Audio CD и делает из него FLAC. Обычный путь «открыть ISO в ffmpeg» здесь не работает: внутри не PCM, а однобитный DSD, часто ещё сжатый в DST. В итоге получился Кедр. Окно на Electron, само преобразование делает локальный Python, альбом с машины никуда не уходит.

И сразу честно, как это писалось. Я не набирал проект руками файл за файлом. Это вайбкодинг в Cursor: я говорил, что должно получиться, смотрел результат и возвращал в чат то, что сломалось уже на настоящем диске. Модель хорошо собирает каркас и плохо угадывает, как себя ведёт Homebrew ffmpeg 9 на конкретном DSF. Ниже как раз про это. Без тех прогонов на своём Mac утилита бы так и осталась «ну вроде открывается».

Читать далее

Сканер 152-ФЗ выписал нарушения Госуслугам, РЖД и Т‑Банку. Разбираем как так вышло

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели7K

Ошибка линтера стоит пяти минут. Ошибка сканера, который проверяет сайты на соответствие 152-ФЗ, выглядит иначе: «ваш сайт нарушает закон». Если сайт при этом в порядке, а отчёт уже ушёл клиенту, расплачивается чужая репутация.

Мы пишем такой сканер. Отчёт по нему получает не владелец сайта, а веб‑студия, которая ведёт сотню клиентских сайтов, и дальше отдаёт его клиенту под своим логотипом. То есть за нашу выдуманную находку краснеть будет она.

Так что перед запуском мы отложили новые проверки и месяц занимались противоположным: искали, где сканер врёт. Написали три инструмента, которые ищут ошибки в нашем же коде, и прогнали через них полсотни самых неудобных сайтов Рунета. Трижды. Нашлось восемь ловушек. Ни одну из них не увидел клиент — но увидел бы, если бы мы просто запустились.

Все восемь ловушек