Обновить
512K+

Python *

Высокоуровневый язык программирования

361,48
Рейтинг
Сначала показывать
Период
Уровень сложности

Giga IDE Pro больше не будет. Но это хорошая новость

Время на прочтение6 мин
Охват и читатели15K

Pro-сборка была важным этапом в развитии GigaIDE: она позволила быстрее развивать профессиональные инструменты, собирать обратную связь от корпоративных пользователей и проверять сценарии, которые выходят за рамки Community-версии. Но у отдельного дистрибутива есть и обратная сторона: пользователю нужно выбирать сборку, командам — отдельно управлять установками, а продукту — поддерживать лишнюю развилку там, где её уже можно убрать.

Читать далее

Неожиданный антивайб разработки через ИИ-агентов

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели9.2K

Менеджеры считают, что ИИ-агенты ускорят разработку в десять раз. Математика говорит, что ускорится только написание. Проверять смысл по-прежнему будут люди, с конечной скоростью, и очередь выстроится к самым опытным. PostgreSQL 19 не вышел в срок. Не потому, что ИИ нашёл много багов, а потому что ИИ научился генерировать правдоподобные отчёты быстрее, чем люди успевают их читать. В статье разбираю, почему так, где настоящий предел и что меняется.

Читать далее

yt-dlp для мамы: как я упаковал консольную утилиту в программу для Windows и на какие грабли наступил

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели11K

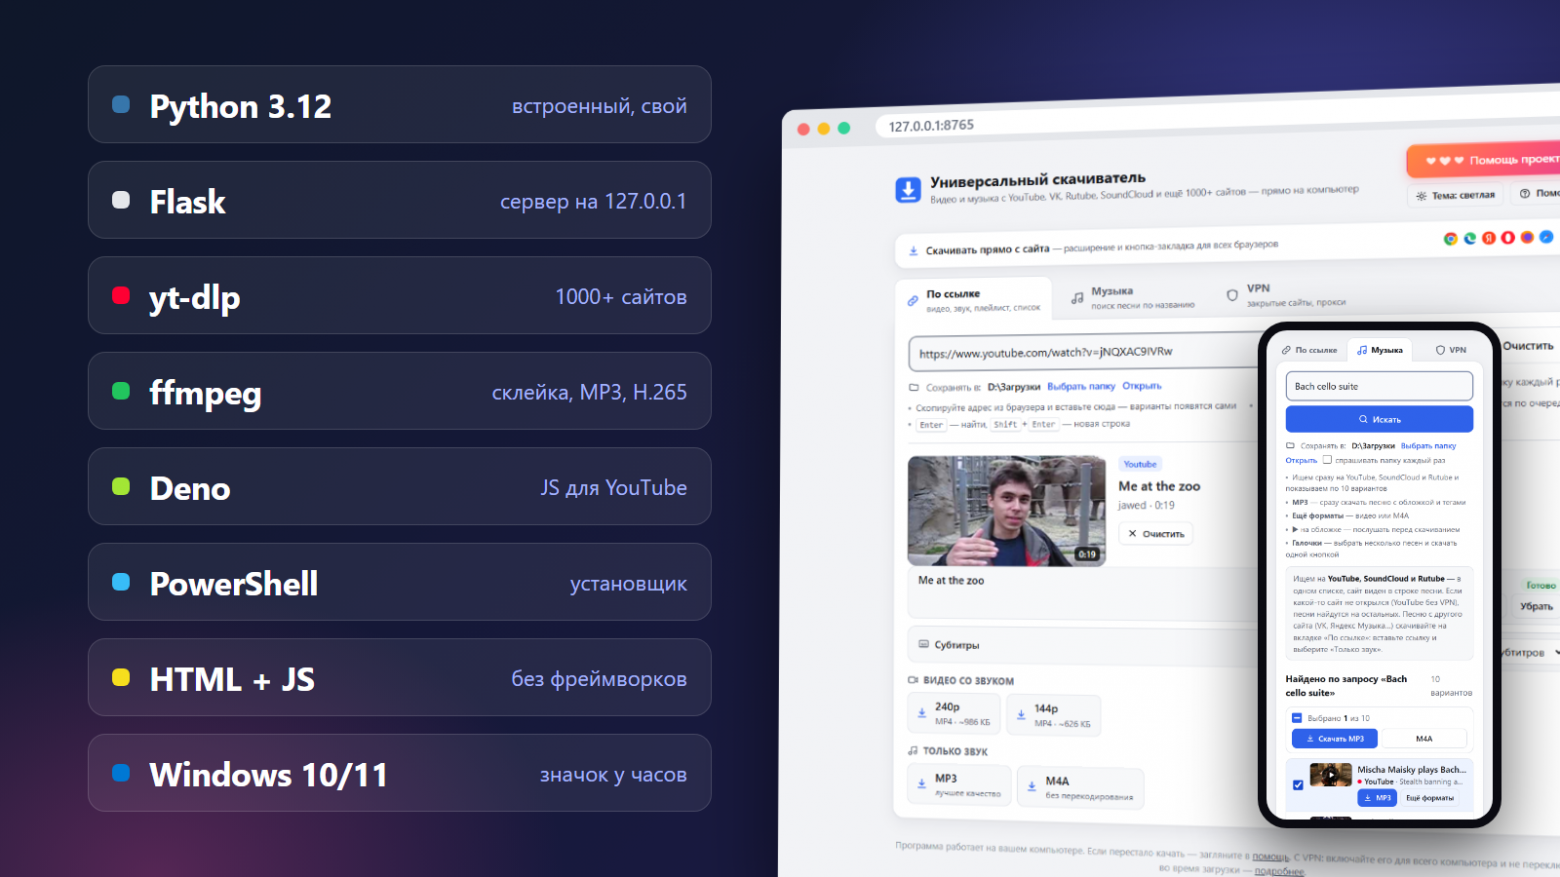
У меня в семье регулярно звучит один и тот же вопрос: «А как скачать вот это видео?». Ответ «поставь yt-dlp» не работает: консоль, Python, ffmpeg, ключи командной строки — для человека, который просто хочет песню в машину, это стена. Готовые программы есть, но у одних реклама и платное «Pro», другие заброшены, третьи — онлайн-сервисы с баннерами, которые сами тянут файл через свой сервер.

Я поставил себе простую цель: один zip, двойной щелчок — и всё работает. Без установки Python, без рекламы, без регистрации и без чужих серверов. Внутри — тот же yt-dlp, а снаружи — понятная страница с кнопками. Получился «Универсальный скачиватель». Ниже — не столько про то, что он умеет, сколько про то, обо что я спотыкался по дороге: почти каждая «простая» задача на Windows оказалась с подвохом.

Читать далее

Typing в Python 3.11–3.14: что изменилось и как это использовать уже сейчас

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели9.2K

За последнее время я прочитал множество репозиториев, где в Pyhton пользуются типизацией и почти везде синтаксис не новее 3.11: Optional, TypeVar на уровне модуля, Generic[T], кавычки вокруг опережающих ссылок. При этом у Python 3.10 поддержка закончилась, и разработчики языка дали нам новых удобных инструментов и чтобы ими пользоваться не всегда нужно обновляться до последней версии. В этой статье расскажу, какие основные фишки появились за последние несколько лет и как ими пользоваться даже в проектах на старых версиях.

Читать далее

Дедупликация фото без нейросетей. Часть 1: измеряем перцептивные хеши

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели2.9K

Недавно у нашей команды появилась необходимость отвечать на вопрос: А такое фото у нас уже есть?». Не «такой же файл» — его можно было бы легко проверить по SHA-256, — а именно такое же фото: пережатое, уменьшенное, с чужим логотипом поперёк кадра, подрезанное по краям.

Про перцептивные хеши на Хабре написано много, почти везде разбирают устройство алгоритма. Мне же хотелось понять, что он выдерживает. Поэтому я взял двадцать фотографий, изменил каждую двадцатью шестью способами из тех, что реально случаются при перезаливе, и посчитал расстояния.

Это первая часть из двух. Она про то, что хеши умеют и где ошибаются: водяные знаки, геометрия кадра, выбор метода, длина хеша, порог. Во второй части я расскажу, как из этого сделать работающую систему: предобработка, зеркало и поиск в PostgreSQL с бенчмарком на десяти миллионах строк.

Читать далее

От прогноза потока клиентов к оптимальному штату сотрудников

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели5.3K

Клиентский поток неоднороден. Он зависит от дня недели, месяца, праздников, времени суток, расположения и формата отделения, а также от локального расписания. Среднее значение за месяц для кадрового планирования почти бесполезно: два отделения с одинаковым месячным объёмом могут иметь совершенно разные утренние пики, продолжительность рабочего дня и долю вечерних посещений.

Поэтому банку критически важен прогноз клиентопотока для сбалансированного операционного планирования: нехватка сотрудников ведёт к росту очередей и риску нарушения целевых сроков обслуживания, а избыток — к оплате непродуктивных часов и неравномерной нагрузке на персонал, а сами работники получают неравномерное расписание и вынуждены компенсировать пики переработками. 

Поэтому для операционного планирования нужен прогноз не только на уровне отделения и дня, но и для каждого рабочего часа.

Практическая ценность проявляется в трёх направлениях: для бизнеса — сокращение лишних трудочасов и авральных корректировок графика; для клиентов — более короткое и стабильное ожидание, особенно в пики; для сотрудников — равномерная нагрузка и предсказуемые смены.

Привет, Хабр! Меня зовут Роман Гатауллин, я младший специалист по разработке нейронных сетей в Управлении по разработке моделей глубокого обучения и прикладных исследований. В этом проекте я отвечал за time-series часть: эксперименты с Prophet и Temporal Fusion Transformer. Статью мы подготовили вместе с Иваном Семидетновым, специалистом по интеллектуальному анализу данных из Дирекции по разработке моделей общекорпоративных функций. Над задачей работали две команды, и ниже мы расскажем, как прогнозировали почасовой клиентопоток в отделениях и что из этого получилось.

Читать далее

Разработка цифрового радиолюбительского протокола на базе OFDM. MAC и LLC уровни

Уровень сложностиСредний
Время на прочтение66 мин
Охват и читатели8.9K

В предыдущей части статьи были рассмотрены принципы и механизмы работы PHY-уровня радиолюбительского OFDM-протокола, а также алгоритмы кодирования и декодирования данных. В этой статье рассматриваются принципы построения уровней управления доступом к среде (MAC) и управления логическим каналом (LLC), реализующих полудуплексное сетевое соединение между двумя трансиверами, а также анализируются возникшие при реализации и методы их решения.

Читать далее

dature: type‑safe‑конфигурация через dataclasses

Уровень сложностиСредний
Время на прочтение20 мин
Охват и читатели7.4K

Привет, Хабр! Я Николай Видов, тимлид команды чатботов в Т, пишу на Python с 2017 года. За это время я успел поработать с конфигами во всех видах: INI-файлами в legacy-проектах, переменными окружения в Docker-контейнерах, YAML с шаблонами в Helm, pydantic-моделями в свежих сервисах, Vault и Consul в инфраструктуре покрупнее. Это третья статья о конфигурациях в Python — в предыдущих я разобрал, как мы дошли до жизни такой и почему это не устраивает меня и мою команду.

Читать далее

Распределённые блокировки в Multi-DC: как перестать дублировать CronJobs

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.8K

Представьте: вы настроили CronJob, протестировали локально и выкатили в продакшн. Всё работает как часы. А потом решили добавить отказоустойчивости и развернули приложение во втором дата‑центре. И внезапно ваша задача начала выполняться дважды. Это не баг Kubernetes, а фундаментальная проблема синхронизации.

Меня зовут Тимофей Салтымаков, я бэкенд‑разработчик в Точка Банк. В статье расскажу, как мы решили проблему дублирующихся CronJob'ов в распределённой системе. Прошли путь от advisory locks до собственной библиотеки, и в итоге поняли, что нужно перестать синхронизировать процессы и начать синхронизировать... время. Поехали!

Читать далее

Парсинг на Python: HTTP, Scrapy или браузер — практическое сравнение

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели7.6K

BeautifulSoup, Scrapy, Selenium и Playwright часто сравнивают как аналоги, хотя это инструменты разных уровней. Я собрала тестовый стенд и сравнила их на статическом HTML, JavaScript-странице, массовом обходе и работе с UI — с замерами времени, памяти и неожиданными результатами.

Читать далее

Показываем одно окно Windows на планшете через обычный браузер

Время на прочтение6 мин
Охват и читатели6.5K

Мне нужно было показывать на планшете окно одной программы с рабочего компьютера. Не весь экран, а именно одно окно, и только для просмотра: планшет нужен, чтобы смотреть картинку, а не чтобы кто-то случайно двинул мышкой что-то на ПК.

Готовых решений хватает: Spacedesk, Sunshine с Moonlight, VNC, демонстрация экрана в любом мессенджере для звонков. Часть из них превращает планшет во второй монитор, части нужен клиент на стороне устройства, часть показывает экран целиком, у некоторых свои условия лицензирования, которые стоит прочитать до того, как вы положитесь на инструмент. Мне хотелось чего-то проще: запустил на ПК, открыл адрес в браузере планшета, увидел окно. Получившуюся программу я выложил в открытый доступ. Она никого не заменяет, просто закрывает конкретную задачу, и если у вас такая же, возможно, вам пригодится.

Проект называется WindowStream: https://github.com/eugenyh/WindowStream

Читать далее

UICC HOTP: генерируем одноразовые пароли на SIM-карте

Уровень сложностиСложный
Время на прочтение16 мин
Охват и читатели6.6K

Всем привет!
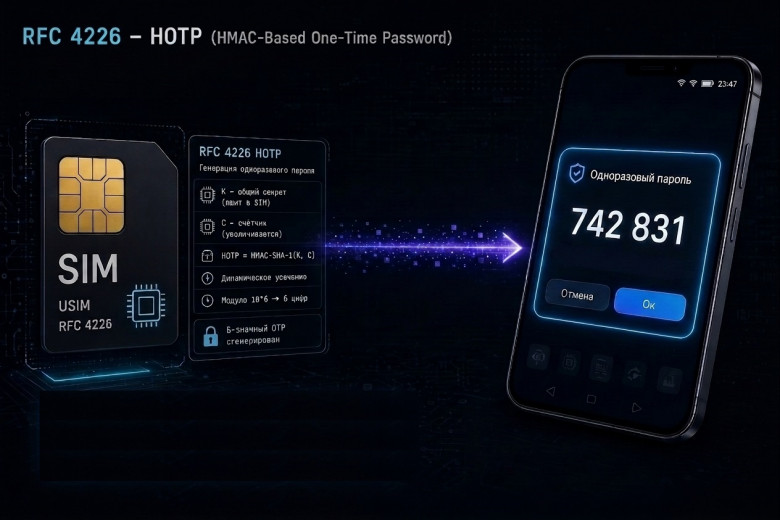
В прошлых статьях речь шла о возможностях смарт-карты, которые не получают должного освещения в публикациях, а именно: работа с ISD, создание своего SSD, сторонние библиотеки и криптография. Эти темы лишь часть огромного массива, который можно исследовать до самой китайской пасхи, а ведь хочется идти дальше, посмотреть, что еще интересного таит "Вселенная Java Card".

По этой причине я решил долго здесь не задерживаться и идти к новым горизонтам. Итак, встречайте - UICC HOTP!

Читать далее

Как я перестал верить нейросети и полюбил контрольные разряды: Zero-Trust для распознавания юридических документов

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели8.2K

Покажите VLM скан исполнительного листа — и она уверенно вернёт реквизиты. Формат будет идеальным, тон — безупречным. Одна беда: среди реквизитов с ненулевой вероятностью окажется несуществующий ИНН с правильным форматом, сумма, которую никто не сверил с документом, а рядом в сводке будет гореть «качество: 100 %» — на скане 745×1024 @ 96 DPI, с которого в принципе нельзя прочитать реквизиты.

Это не гипотеза и не страшилка из интернета — это логи реального проекта. Я строю конвейер, который читает сканы российских юридических документов (исполнительные листы, постановления ФССП, удержания из зарплаты, УПД, договоры) и готовит реестры для 1С. Он построен вокруг одного принципа: вывод модели никогда не принимается на веру. Нейросеть предлагает, алгоритм проверяет, человек смотрит только то, что не сошлось.
Под катом расскажу, как это вообще началось, как устроены четыре стены проверок — контрольные разряды, арифметика и закон, кросс-модальный гейт и честные статусы, — какие реальные баги они поймали, что показывают замеры ложных срабатываний и при чём тут пара десятков строк арифметики, которые заменяют доверие нейросети.
Читать далее

Ближайшие события

Сравнение регионов Казахстана

Уровень сложностиПростой
Время на прочтение25 мин
Охват и читатели4.7K

Я собрал больше 32 тысяч объявлений с Krisha и данные БНС по зарплатам, ценам, тарифам и переездам. Потом посчитал, сколько остаётся от зарплаты после аренды, еды и коммуналки, и сравнил это с тем, куда на самом деле переезжают люди.

Как живут в Казахстане...

Как документировать API: частые ошибки и лучшие практики для создания своего руководства

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели9.8K

Через дата-инженеров Далее проходят десятки описаний интеграций в совершенно разных форматах, даже в Excel. Формально такая API-документация есть, но пользоваться ей больно, а иногда и вовсе невозможно.

Разбираем, чем «болеют» документации, как сделать понятное руководство со Swagger и без него, посмотрим лучшие практики создания API-документации.

В конце — чек-лист для написания и проверки документации.

Читать далее

TG — опенсорсный локальный парсер Телеграма

Уровень сложностиСложный
Время на прочтение15 мин
Охват и читатели9.7K

Telegram-parser (github) — это открытый некоммерческий local-first инструмент для выгрузки и аналитики комментариев Telegram-каналов в структурированный, пригодный для анализа датасет прямо на компьютере пользователя, без облачных посредников.

Большинство каналов в Telegram — это не только посты, но и оживлённая «параллельная» жизнь вокруг них в чатах тг-каналов, где агрегируются комментарии к постам, формируются ветки обсуждений с реакциями, стикерами, ответами, упоминаниями, ссылками и мультимедиа. Эта живая активность часто ценнее самого поста — это то, что делает каналы и коммьюнити в Телеграме по-настоящему живыми.

Проблема в том, что Telegram не даёт удобных инструментов, чтобы забрать эти данные одним куском и проанализировать их. Штатный экспорт чатов ограничен, привязан к ручным действиям и не масштабируется на десятки каналов.

Читать далее

Как я собрал русскоязычную GPT на 112 млн параметров с нуля на PyTorch: претрейн, SFT, Telegram-бот

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели9.7K

Когда смотришь на современную LLM, легко решить, что всё сводится к вызову API. Но многие разработчики, которые часто используют LLM в работе или в своих проектах, рано или поздно хотят действительно разобраться, как они работают. К тому же - кто не смотрел «Железного человека»? По сути самый лучший способ реально разобраться это сделать что-то свое. Чаще всего возможности позволяют сделать что-то маленькое, зато свое и работающее.

Так появился jarvis - компактный decoder-only transformer для русского текста и диалогов. В проекте нет готового AutoModelForCausalLM: я сам реализовал архитектуру, обучил токенизатор, собрал пайплайн подготовки данных, добавил претрейн и SFT, KV-cache для генерации, консольный чат, Telegram-бота и простой бенчмарк. Готовый SFT-checkpoint и соответствующий токенизатор опубликованы на Hugging Face.

Читать далее

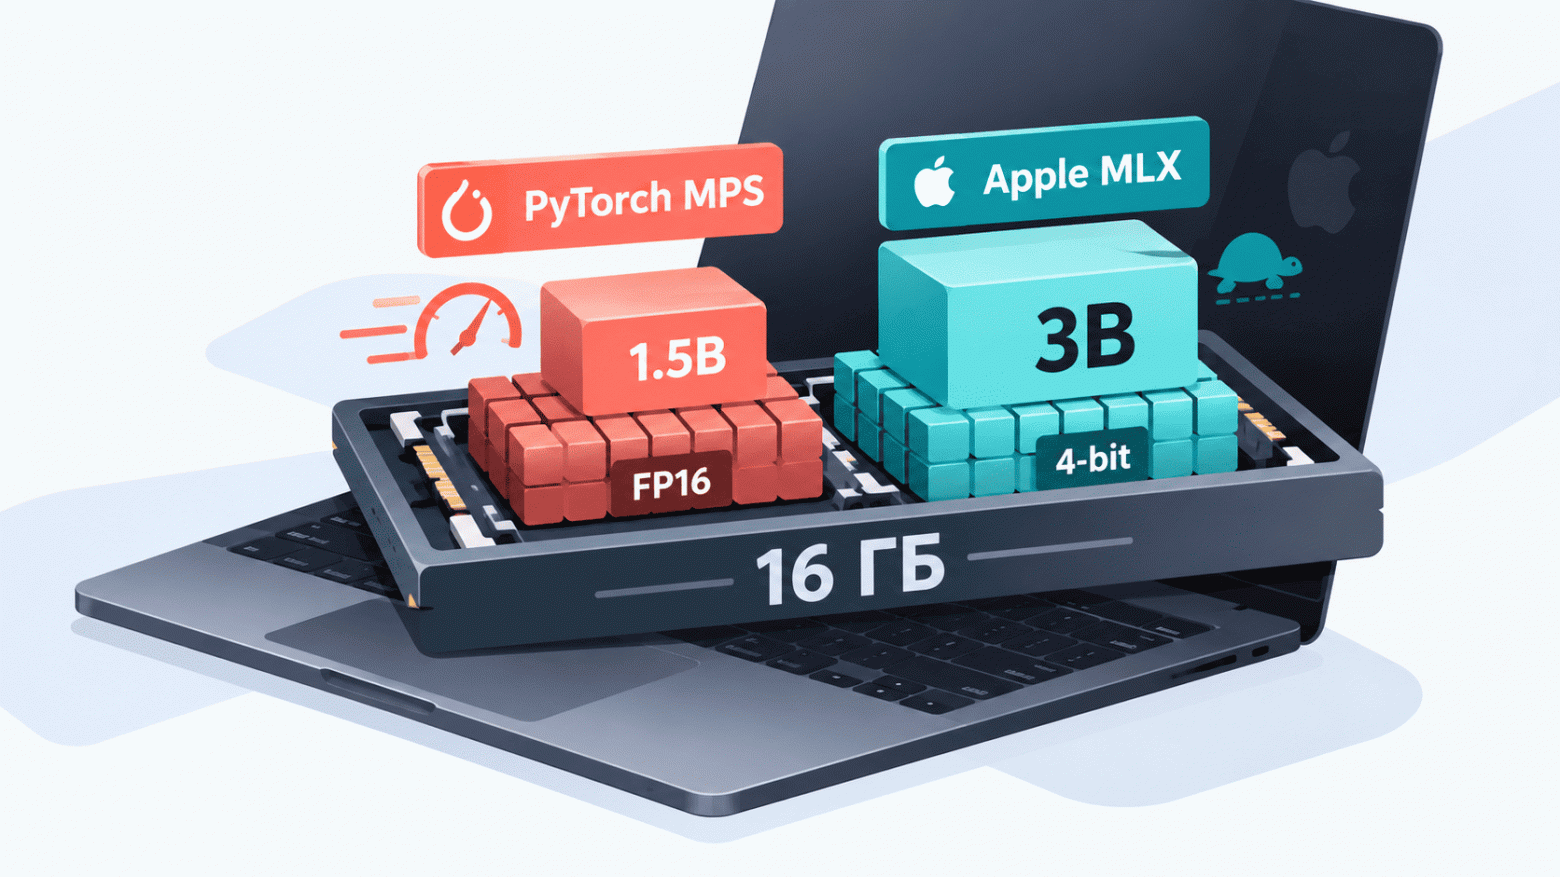
PyTorch MPS против Apple MLX: как дообучать LLM на Mac с 16 ГБ и что выбрать

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели11K

Apple MLX создавался для эффективной работы с моделями на Apple Silicon, но при дообучении он может оказаться в несколько раз медленнее PyTorch MPS. Зато там, где MPS упирается в ограничения памяти, MLX позволяет запустить модель вдвое крупнее. Откуда берётся такой разрыв, насколько виновато квантование и какой стек выбрать для локального SFT? Ответы дают 10 запусков Qwen 2.5 с разными размерами моделей и длиной контекста.

Изучить бенчмарки

Книга: «Простой Python. Современный стиль программирования. 3-е изд.»

Время на прочтение2 мин
Охват и читатели4.9K

Привет, Хаброжители! Путешествие в мир программирования часто напоминает блуждание по лабиринту, из которого нет выхода. Неудивительно, что Python стал любимцем миллионов: он не просто понятен, его приятно изучать, читать и писать на нем.

Читать далее

Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели5.6K

Модель почти идеально выучила ответ, а градиент правильного класса уже стал машинным нулём. При дистилляции возможна обратная ситуация: ученик повторяет учителя, но вычисление всё ещё выдаёт сигнал ошибки. Разбираю исправления DeepMind на школьной алгебре, проверенных примерах NumPy и четырёх графиках: где теряются маленькие числа, как это влияет на обучение и что стоит проверить в своей среде.

В статье есть практические рекомендации, как понять, нужно ли это учесть в ваших программах и нейросетях, и если нужно — как исправить в своем коде ошибку из стандартных библиотек.

Самое удивительное тут то, что, казалось бы, подобная тема должна быть исследована вдоль и поперек еще на заре развития машинного обучения, а в реальности важнейший научный препринт от DeepMind об этом вышел 22 октября, то есть меньше недели назад.

Кроме того, рекомендую включать этот материал в базовые учебные курсы.

Читать далее