Обновить
512K+

Python *

Высокоуровневый язык программирования

525,48
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Настройка аутентификации JWT в новом проекте Django

Время на прочтение28 мин
Охват и читатели113K

Данная статья является сборкой-компиляцией нескольких (основано на первой) статей, как результат моих изучений по теме jwt аутентификации в джанге со всем вытекающим. Так и не удалось (по крайней мере в рунете) найти нормальную статью, в которой рассказывается от этапа создания проекта, startproject, прикручивание jwt аутентификации.

Читать далее

Миллион домашних фотографий: наводим порядок

Время на прочтение5 мин
Охват и читатели39K

После покупки цифрового фотоаппарата и рождения детей стало появляться большое количество фотографий, а учитывая, что жена с фотоаппаратом почти не расставалась и старалась запечатлеть все «важные» детские моменты, фотографий стало появляться ОЧЕНЬ много.

Пришло время навести порядок.

Стив пишет заклинания на Python. Обучение детей программированию в Minecraft

Время на прочтение5 мин
Охват и читатели33K

Хочу поделиться наработками домашнего обучения детей программированию. Даже не столько обучению, сколько привлечения детского внимания и интереса. Ведь согласно Сократу, человек - не сосуд для наполнения, а факел, который нужно зажечь. Изначально были попытки начать со Scratch, но несмотря на понятный графический интерфейс, желание продолжать и что-то делать в среде быстро угасло. Minecraft пошел намного лучше, потому что дети уже были хорошо знакомы с игрой по мобильной версии и любимому creative mode.

Я не имею в виду создание и использование модов, это слишком высокий уровень входа. Первые попытки были после знакомства с первым изданием книги "Minecraft. Программируй свой мир" и удачной настройки сервера Bukkit на домашней машине. На данный момент (начало 2021 г.) есть второе издание, а также несколько похожих книг других авторов.

Читать далее

Скрапинг Avito без headless-браузера

Время на прочтение2 мин
Охват и читатели54K

Недавно на хабре вышла статья Скрапинг современных веб-сайтов без headless-браузеров, и в комментариях было высказано мнение, что без headless-браузера не выйдет получить номер телефона из объявления на "авито" или "юле". Хочу это опровергнуть, ниже скрипт на python размером менее 100 строк кода, который успешно парсит "авито" успешно парсит "авито"!

Читать далее

Нападения на полицейских в США: статистический обзор

Время на прочтение15 мин
Охват и читатели13K


Эта статья — логическое продолжение серии статей, которые я написал в этом году на тему криминала и правопорядка в США и их связи с расовой принадлежностью (раз, два). В первой серии статей, напомню, мы подробно рассматривали данные по гибели граждан от рук полицейских. А сегодня мы взглянем на этот вопрос с другой стороны: будем разбирать статистику нападений на самих полицейских и постараемся так же проследить закономерности и сделать выводы. Оружием преступников может быть пистолет или нож, а нашим оружием, как и прежде, будет python + pandas. Поехали!
Читать дальше →

Многопоточное скачивание файлов с ftp python-скриптом

Время на прочтение6 мин
Охват и читатели21K

Однажды передо мной встала задача копирования большого количества файлов с ftp-сервера. Нужно было делать бэкап. Казалось бы, что может быть проще! Но увы, ничего готового работающего так же быстро для моих условий найти не удалось.

Читать далее

Используем нейросеть для раскрутки собачьего аккаунта в Инстаграм или робопёс в действии

Время на прочтение5 мин
Охват и читатели10K

Всем привет!

Недавно ребёнок завел пса и создал для него аккаунт в Instagram. В течение пары недель на аккаунт подписались все друзья и знакомые, образовалось порядка сотни подписчиков. Ну и, собственно, всё. Интересно, а помогут ли python и минимальные знания устройства Instagram как-то автоматизировать процесс расширения аудитории? Если вам тоже интересно, добро пожаловать по кат.

Читать далее

Прокачиваем скрипты симуляции HDL с помощью Python и PyTest

Время на прочтение14 мин
Охват и читатели8.8K

Все делают это. Ну ладно, не все, но большинство. Пишут скрипты, чтобы симулировать свои проекты на Verilog, SystemVerilog и VHDL. Однако, написание и поддержка таких скриптов часто бывает довольно непроста для типично используемых Bash/Makefile/Tcl. Особенно, если необходимо не только открывать GUI для одного тестбенча и смотреть в диаграммы, но и запускать пачки параметризированных тестов для различных блоков, контролировать результат, параллелизировать их выполнение и т.д. Оказалось, что всё это можно закрыть довольно прозрачным и легко поддерживаемым кодом на Python, что мне даже обидно становится от того, как я страдал ранее и сколько странного bash-кода родил.

Читать далее

Как быстро получить много данных от Битрикс24 через REST API

Время на прочтение4 мин
Охват и читатели44K

Нередко при работе с Bitrix24 REST API возникает необходимость быстро получить содержимое определенных полей всех элементов какого-то списка (например, лидов).

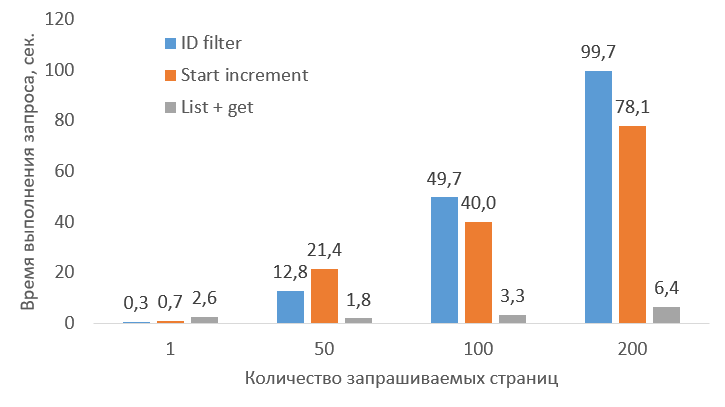
Традиционный способ для этого - обращение к серверу через метод *.list (например, crm.lead.list для лидов) с параметром select, перечисляющим список требуемых полей. При этом, чем больше полей вы запрашиваете, тем больше времени серверу требуется для формирования ответа. Плюс, в силу того, что информация сервером выдается постранично, получение всего списка через последовательные запросы всех страниц может занимать много времени.

Однако существует несколько стратегий для того, которые позволяют ускорить процесс на порядки.

И что это за стратегии?

Как определять собственные классы исключений в Python

Время на прочтение7 мин
Охват и читатели48K
Привет, Хабр!

Ваш интерес к новой книге "Секреты Python Pro" убедил нас, что рассказ о необычностях Python заслуживает продолжения. Сегодня предлагаем почитать небольшой туториал о создании кастомных (в тексте — собственных) классах исключений. У автора получилось интересно, сложно не согласиться с ним в том, что важнейшим достоинством исключения является полнота и ясность выдаваемого сообщения об ошибке. Часть кода из оригинала — в виде картинок.

Добро пожаловать под кат.
Читать дальше →

Constraint Programming или как решить задачу коммивояжёра, просто описав её

Время на прочтение7 мин
Охват и читатели15K

Пожалуй, наиболее популярной парадигмой программирования является императивное программирование, но это не единственный вид программирования, широки известны функциональное и логическое программирование. Constraint Programming (Программирование в ограничениях/Ограниченное программирование) не так популярно. Но это очень мощный инструмент для решения комбинаторных задач. Вместо реализации алгоритма, который решает задачу, с последующей тратой кучи времени на его отладку, рефакторинг и оптимизацию, программирование с ограничениями позволяет вам просто описать модель в специальном синтаксисе, а особая программа (решатель) найдет решение для вас (или скажет, если их нет). Впечатляет не правда ли? Мне кажется, каждый программист должен знать о такой возможности.

Read more

Поиск известных паттернов на Forex с Python

Время на прочтение11 мин
Охват и читатели14K

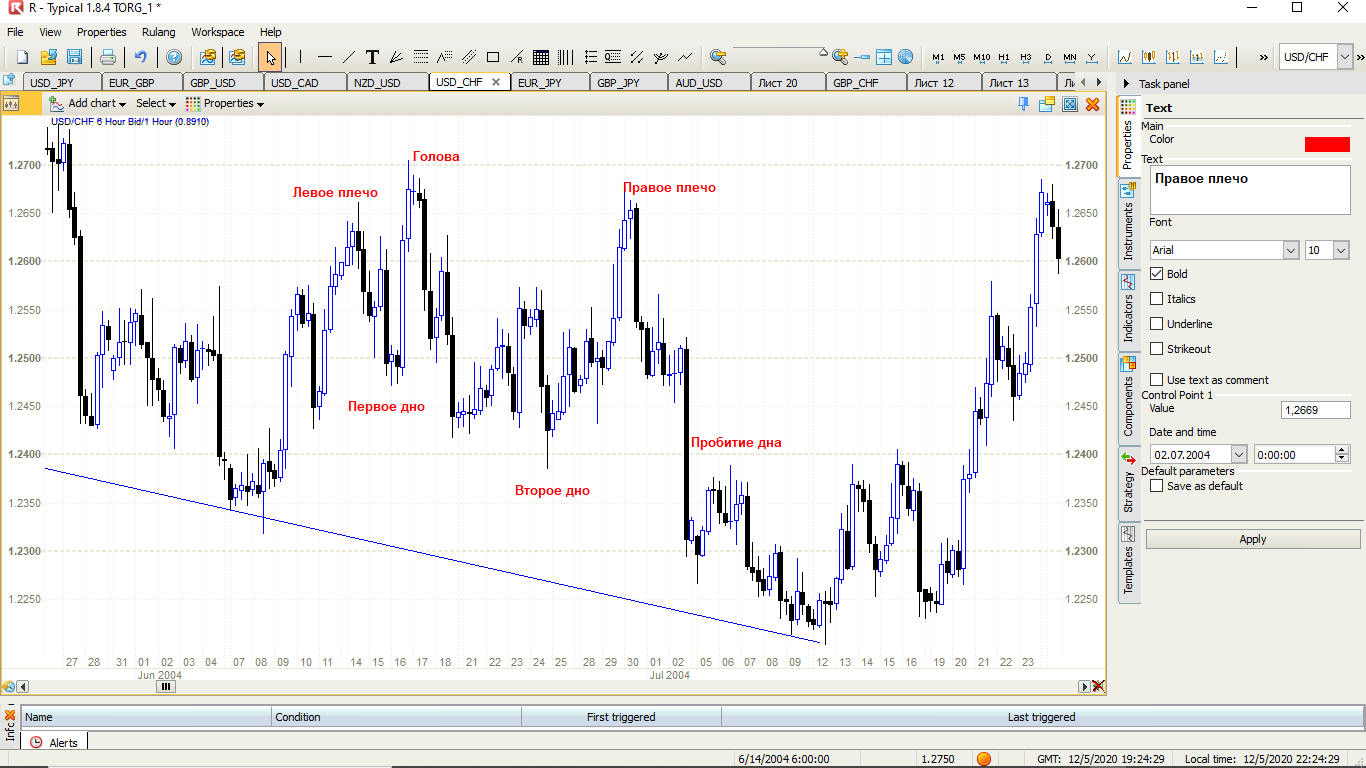
Технический анализ биржевых графиков основывается на гипотезе существования повторяющихся моделей, паттернов, способных приносить прибыль. Увидели две черные свечки и три белые в определенном порядке - открывайтесь и получите деньги. Но почему-то мало информации (или она отсутствует вовсе) именно о доказательстве данной гипотезы и как и на основе чего она вообще была сформирована. Т.е. сколько раз на исторических данных та или иная фигура отработала как надо. Откуда и кто решил, что существует ниспадающий треугольник, тоннели, голова с плечами и т.д. Кем проверялось на скопившихся за все время существования биржи котировках их прибыльность? Почему не две параллельные линии и параллелепипед или кружок с овалом? Об этом доказательстве мы и поговорим в данной статье, т.е. запустим скрипт python по поиску паттернов, исторические данные получим путем копирования графиков из румуса.

Начнем с одной из самых популярных моделей - голова и плечи на 6-часовых графиках по 10 валютным парам.

Читать далее

Как мы в СберМаркете боремся с товарами-призраками

Время на прочтение4 мин
Охват и читатели10K

В офлайне покупатель видит полки магазина и сам может понять, чего нет в наличии, а что можно положить в корзину и купить прямо сейчас. В онлайне«‎глазами»‎ пользователя становится каталог: он всегда должен быть актуальным. 

Предположим, вы хотите заказать в СберМаркете доставку любимых конфет. Сайт и приложение выводят их в поиск, но на момент сборки заказа товар может закончиться или оказаться просроченным.

Из-за отмены всем станет грустно. Есть шанс, что в такой ситуации покупатель и вовсе откажется от сервиса, а компания потеряет потенциальную выручку. Чтобы пользователи не расстраивались и оставались с нами дольше, мы ввели метрику под названием «‎доля ненайденных товаров»‎. Она показывает процент таких продуктов от общего числа заказов. 

Рассказываем, как мы внедрили алгоритм автоматического отключения таких «‎призраков»‎ и уменьшили долю ненайденных товаров на 25%.

Читать далее

Ближайшие события

Скрапинг современных веб-сайтов без headless-браузеров

Время на прочтение9 мин
Охват и читатели30K


Многие разработчики считают скрапинг сложной, медленной и неудобной для масштабирования задачей, особенно при работе с headless-браузерами. По моему опыту, можно заниматься скрапингом современных веб-сайтов даже не пользуясь безголовыми браузерами. Это очень простой, быстрый и хорошо масштабируемый процесс.

Для его демонстрации вместо Selenium, Puppeteer или любого другого решения на основе безголовых браузеров мы просто используем запросы на Python. Я объясню, как можно скрапить информацию из публичных API, которые потребляет на фронтэнде большинство современных веб-сайтов.

На традиционных веб-страницах наша задача заключается в парсинге HTML и извлечении нужной информации. На современных веб-сайтах фронтэнд скорее всего не будет содержать особо много HTML, потому что данные получаются асинхронно после первого запроса. Поэтому большинство людей использует безголовые браузеры — они способны выполнять JavaScript, делать дальнейшие запросы, после чего можно распарсить всю страницу целиком.

Но существует и другой способ, которым можно довольно часто пользоваться.
Читать дальше →

Мы опубликовали современный Voice Activity Detector и не только

Время на прочтение5 мин
Охват и читатели15K

image


Всегда при работе с речью встает несколько очень "простых" вопросов, для решения которых нет большого количества удобных, открытых и простых инструментов: детекция наличия голоса (или музыки), детекция наличия цифр и классификация языков.


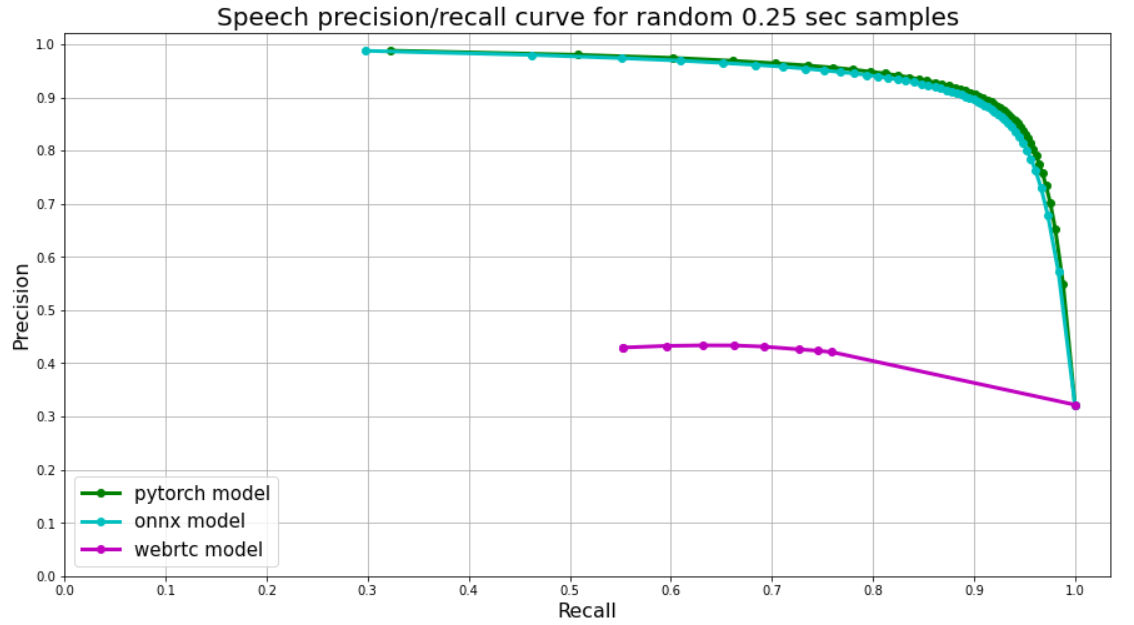
Для решения задачи детекции голоса (Voice Activity Detector, VAD) существует довольно популярный инструмент от Google — webRTC VAD. Он нетребовательный по ресурсам и компактный, но его основной минус состоит в неустойчивости к шуму, большом числе ложноположительных срабатываний и невозможности тонкой настройки. Понятно, что если переформулировать задачу не в детекцию голоса, а в детекцию тишины (тишина — это отсутствие и голоса и шума), то она решается весьма тривиальными способами (порогом по энергии, например), но с теми же минусами и ограничениями. Что самое неприятное — зачастую такие решения являются хрупкими и какие-то хардкодные пороги не переносятся на другие домены.


Изначально мы хотели сделать простой и быстрый внутренний инструмент для себя и наших партнеров для детекции произнесенных чисел без привлечения полноценного STT (фишка изначально была именно в портативности засчет использования современных фреймворков типа PyTorch и ONNX), но в итоге оказалось, что можно сделать не только детектор чисел, но и качественный, быстрый и портативный VAD и классификатор языков, который и опубликовали бесплатно для всех желающих тут под лицензией MIT. За подробностями прошу под кат.

Читать дальше →

Соревнование KAGGLE по определению риска дефолта заемщика. Разработка признаков

Время на прочтение12 мин
Охват и читатели5.6K

Введение: Соревнование от финансовой группы HOME CREDIT по определению риска дефолта заемщика

Соревнования Kaggle с использованием структурированных данных очень часто выигрывают специалисты по разработке признаков: побеждают те, кто может создавать наиболее полезные признаки из данных. Это представляет собой одну из закономерностей в машинном обучении: разработка признаков дает больший возврат инвестиций, чем построение модели и настройка гиперпараметров. Как говорит один из ведущих ученых в области машинного обучения – Эндрю Ын: «Прикладное машинное обучение — это в основном разработка признаков».

Хотя выбор правильной модели и ее оптимальная настройка, несомненно, очень важны, модель может учиться только на основе предоставленных данных. Обеспечение максимального соответствия этих данных задаче – задача специалиста по данным. Конструирование признаков может включать, как создание признаков: добавление новых признаков из существующих данных, так и выбор признаков: выбор только наиболее важных признаков или другие методы уменьшения размерности. Есть много методов, которые мы можем использовать как для создания, так и для выбора признаков.

Читать далее

Реализация распределённых вычислений на языке python с использованием технологии docker

Время на прочтение5 мин
Охват и читатели10K

Распределённые вычисления представляют собой способ решения трудоемких вычислительных задач с использованием нескольких компьютеров, чаще всего объединённых в параллельную вычислительную систему.

Одно из первых упоминаний распределенных вычислений относится к 1973 году. Сотрудники научно-исследовательского центра Xerox PARC Джон Шох и Джон Хапп написали программу, которая рассылала себя по другим работающими компьютерам через локальную сеть PARC.

Впоследствии, в связи с развитием и ростом количества персональных компьютеров, распределённые вычисления стали использоваться всё более и более широко. Так, в конце 1980- х годов Арьен Ленстра и Марк Менес написали программу для факторизации длинных чисел. Она рассылала задания на компьютеры участников по электронной почте и таким же образом принимала ответы.

Ещё одним значимым событием было создание проекта SETI@Home (Search for Extra-Terrestrial Intelligence at Home) для поиска внеземного разума путём анализа данных с радиотелескопов, в том числе на домашних компьютерах участников. Данный проект был запущен в 1999 году и оста новлен в 2020-м. Эта распределенная система была построена на платформе BOINC, созданной в университете Беркли.

В дальнейшем разработки по созданию различных распределённых систем активно продолжались, и в настоящее время они применяются в самых различных областях. В частности, распределённые вычисления широко используются для математических задач. Типичным примером является факторизация чисел (разложение их на произведение простых множителей).

Ещё одной важной областью применения распределённых вычислений является обработка больших данных с использованием методов машинного обучения и Data Mining. В качестве языка программирования для этой цели в последние годы на лидирующие позиции выходит язык Python. По состоянию на март 2020 года, согласно рейтингу TIOBE, Python находится на третьем месте, хотя ещё в 2015 году занимал лишь седьмое.

Одной из известных проблем языка Python является относительно низкая производительность в сравнении с компилируемыми языками – такими как C++. Данный недостаток является дополнительным поводом применять параллельное и распределённое программирование в процессе разработки.

Читать далее

Пора избавляться от мышки или Hand Pose Estimation на базе LiDAR за 30 минут

Время на прочтение9 мин
Охват и читатели30K
image

Всем привет! Пока киберпанк еще не настолько вошел в нашу жизнь, и нейроинтерфейсы далеки от идеала, первым этапом на пути к будущему манипуляторов могут стать LiDAR. Поэтому, чтобы не скучать на праздниках, я решил немного пофантазировать на тему средств управления компьютером и, предположительно, любым устройством, вплоть до экскаватора, космического корабля, дрона или кухонной плиты.

Приложение для конвертирования jpg файлов в pdf файл

Время на прочтение2 мин
Охват и читатели11K

Здравствуйте, читатели моего блога. Сегодня я расскажу про программы, которые помогут при конвертации большого числа рисунков или фотографий формата jpg или bmp в файл pdf.

Данный способ очень хорош тем, что сохраняет качество изображений и позволяет конвертировать и упаковывать огромное количество файлов.

Аналогичных программ в интернете не так много и, в основном, они платные.

Разработать такой способ вынудило меня острая необходимость. Так как мне часто приходится работать с большим количеством файлов, которые необходимо структурировать с сохранением качества.

А те программы, которые бесплатные имеют ряд ограничений по количеству конвертируемых файлов и по качеству конвертации.

Представленные программы очень полезны для людей, занимающихся написанием книг, составлением огромных презентаций и вёрсткой литературы и другой бумажной продукции.

Программы написаны на языке python

Всего программ две.
Первая программа конвертирует файлы jpg в файлы формата pdf. Все сконвертированные файлы собираются в отдельную папку. Качество файлов не изменяется.

Здесь нам понадобиться модуль os и PI

Читать далее

Стилометрия, или как отличить Акунина от Булгакова с помощью 50 строк кода?

Время на прочтение7 мин
Охват и читатели13K

Привет, Хабр.

Довольно интересным направлением "прикладной статистики" и NLP (Natural Languages Processing а вовсе не то что многие сейчас подумали) является анализ текстов. Интересно, что появилось это направление задолго до первых компьютеров, и имело вполне практическую цель: определить автора того или иного текста. С помощью ПК это, впрочем, гораздо легче и удобнее, да и результаты получаются весьма интересные. Посмотрим, какие закономерности можно выявить с помощью совсем простого кода на Python.

Для тех кому интересно, продолжение под катом.

Читать далее