Обновить
256K+

Python *

Высокоуровневый язык программирования

296,37
Рейтинг
Сначала показывать
Порог рейтинга

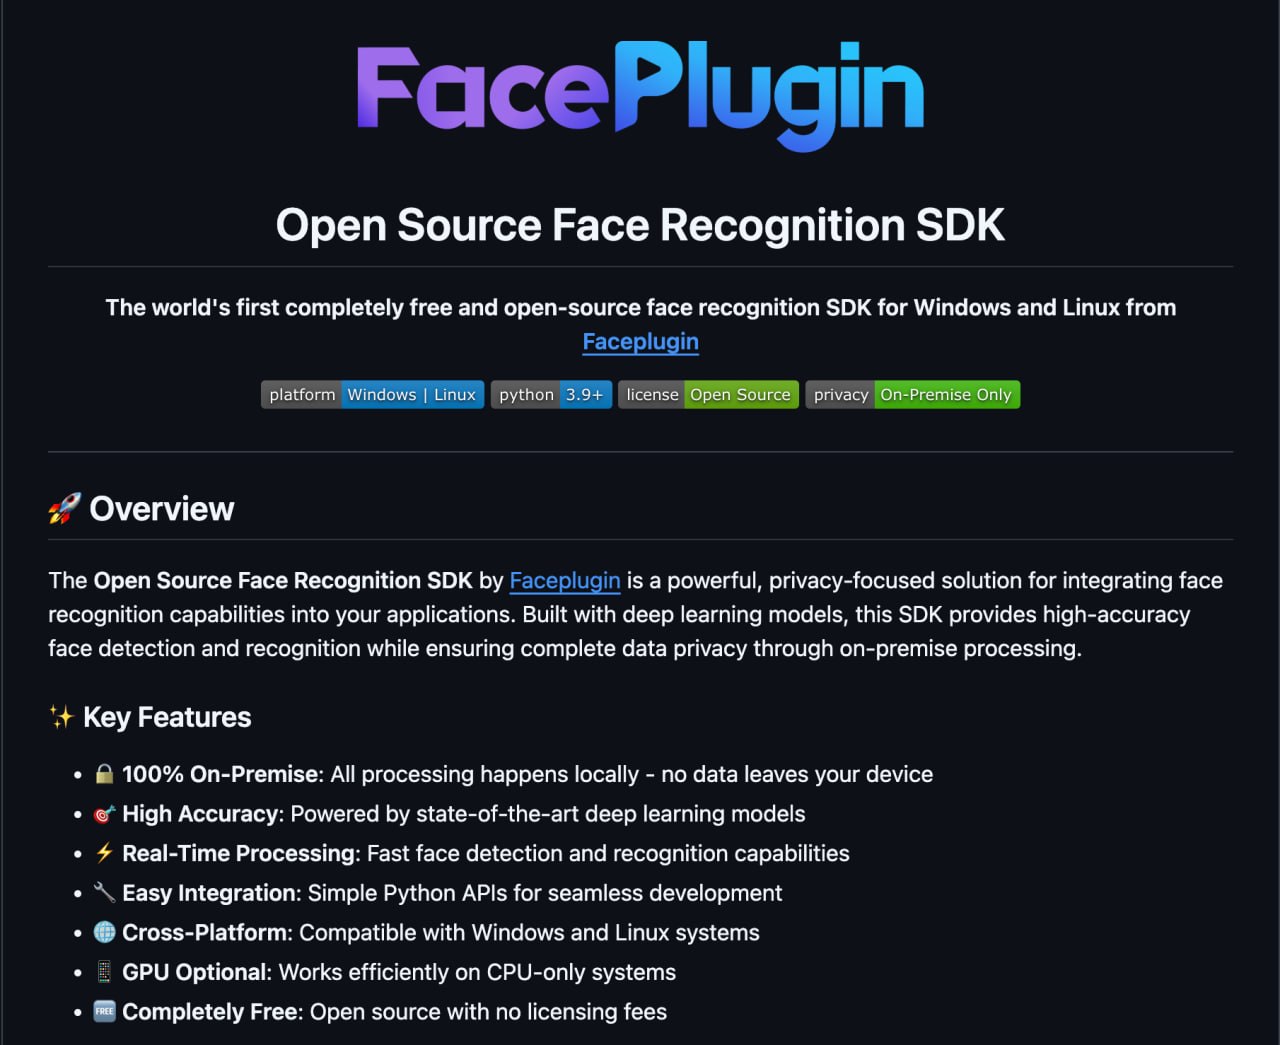
Представлен открытый проект FacePlugin (Open Source Face Recognition SDK). который позволяет создать собственный Face ID и ставить систему распознавания лиц в своих проектах и приложениях:

  • можете создать пропуск в приложение, для умного дома или Face ID для ПК;

  • сервис будет находить лицо по фото или через камеру в режиме реального времени;

  • система работает локально.

Теги:
+1
Комментарии0

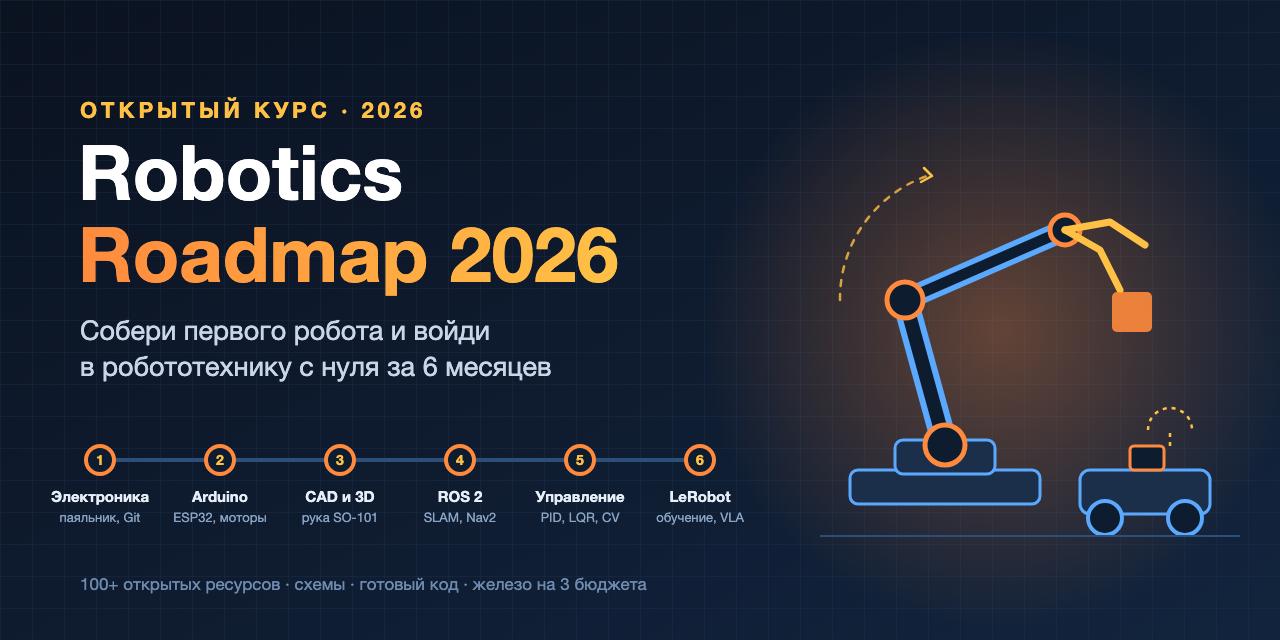
От первого мотора до робота, который учится по демонстрациям: открытая дорожная карта по робототехнике на русском.

Robotics Roadmap 2026 предлагает план на 24 недели при занятиях по 2–3 часа в день. Обучение начинается с электроники и постепенно переходит к управлению и машинному обучению.

Внутри шесть модулей:

- Электроника, Python и Git - базовые схемы и инструменты.

- Arduino и ESP32 — моторы, датчики, линейный робот и балансир.

- CAD и 3D-печать — сборка робота-манипулятора.

- ROS 2 — симуляция, построение карты и автономная навигация.

- Управление и компьютерное зрение — регуляторы, кинематика, работа с камерой.

- LeRobot — сбор демонстраций и обучение робота.

Есть схемы подключения, примеры кода, списки компонентов, справочник по отладке и 30 идей проектов.

Начать можно без покупки железа — в симуляторах. Дальше предлагается оформлять проекты в портфолио: видео, схема, код и разбор того, что сломалось и как удалось исправить.

Полезная отправная точка для программиста, который хочет заставить свой код двигаться в физическом мире.

https://github.com/justxor/robotics-roadmap-2026/

Теги:
+3
Комментарии0

LiteLLM 1.107.0 со стилером ключей: как проверить себя и что менять

21 октября 2026 на PyPI вышел litellm==1.107.0 со стилером учётных данных во всех бинарных wheel-файлах. Образы Docker с тегом v1.107.0 тоже заражены, а теги latest, main-latest и main-stable около трёх часов указывали на заражённый образ. Чистыми названы 1.106.x и ниже.

Инцидент развивается: данные из разбора StepSecurity, сверьтесь с заявлением BerriAI. Релиз загрузили в 11:39 UTC, с PyPI убрали к 13:23.

Чем опасно

В site-packages попадают cook.pth, cook.py и sitecustomize.py. Стилер запускается при каждом старте Python в этом окружении, import litellm не нужен. Уходят SSH- и облачные ключи, .env, переменные окружения, токены AI-инструментов. Если задан DATABASE_URL, дампится база прокси с API-ключами вендоров. Архив зашифрован и отправляется на litellm.dev.

Как проверить

Не запускайте Python на подозрительном хосте: это снова запустит стилер, поэтому pip show не подходит.

grep -rn "litellm.*1\.107\.0" --include="requirements*.txt" --include="*.lock" --include="pyproject.toml" .
find / \( -name cook.pth -o -name cook.py \) 2>/dev/null
ls -l /tmp/remote_code_loader.lock 2>/dev/null
docker images --digests | grep -i litellm

Скомпрометирован любой хост, раннер или контейнер, где ставился 1.107.0 или был образ v1.107.0/latest из того окна. Признак в сети: запросы к litellm.dev.

Что делать

  1. Убить процесс, держащий /tmp/remote_code_loader.lock, и заблокировать litellm.dev на выходе.

  2. Пересобрать контейнеры и переустановить окружения, а не чистить.

  3. Запинить litellm==1.106.2 или образ по дайджесту, удалить 1.107.0 из зеркал.

  4. Сменить всё, до чего хост мог дотянуться: облачные, SSH- и CI-ключи, токены. Для прокси с базой ещё и все ключи вендоров, master key и salt key. Архив зашифрован, поэтому считайте, что данные ушли.

  5. Поискать в логах litellm.dev и проверить расход у вендоров.

Для любого шлюза

Шлюз хранит ключи ко всем вендорам. Пиньте версии и дайджесты, не деплойте latest, ставьте с хэшами и ограничьте исходящий трафик шлюза.

Для LiteLLM это второй случай: в марте 2026 были скомпрометированы 1.82.7 и 1.82.8. Зависимости можно отравить в любой экосистеме, не только в Python.

Теги:
+2
Комментарии0

ChatGPT теперь можно подключить прямо к Blender — представлен открытый проект loopcut, который помогает встроить ИИ‑агента в 3D‑редактор, чтобы управлять сценами обычными текстовыми запросами. Нейросеть может настраивать освещение, редактировать объекты, работать с материалами и писать код на Python.

Теги:
+1
Комментарии1

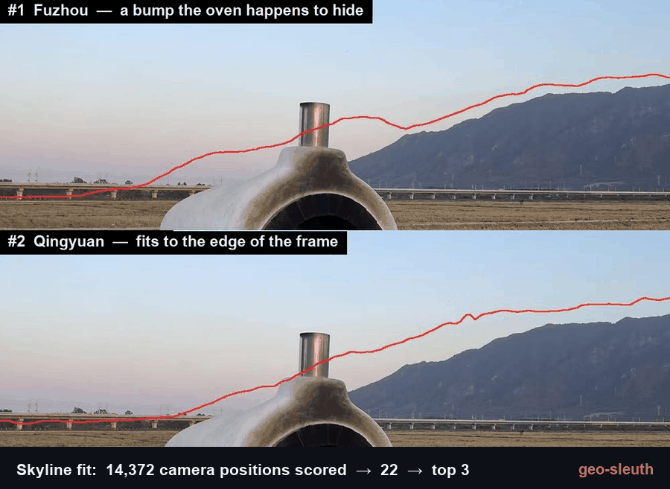
Находим локацию на фото с помощью нейросетей и открытого скилла geo-sleuth. Проект предоставляет ИИ-агентам доступ к спутниковым картам, панорамам местности и данным о рельефе. Нейросеть в итоге выдаёт точные координаты с места съёмки любого фото. А затем рассказывает, как пришла к такому выводу. Решение работает с точностью до одного метра и подойдёт для Claude Code, Codex, Cursor и Gemini CLI.

Теги:
+4
Комментарии0

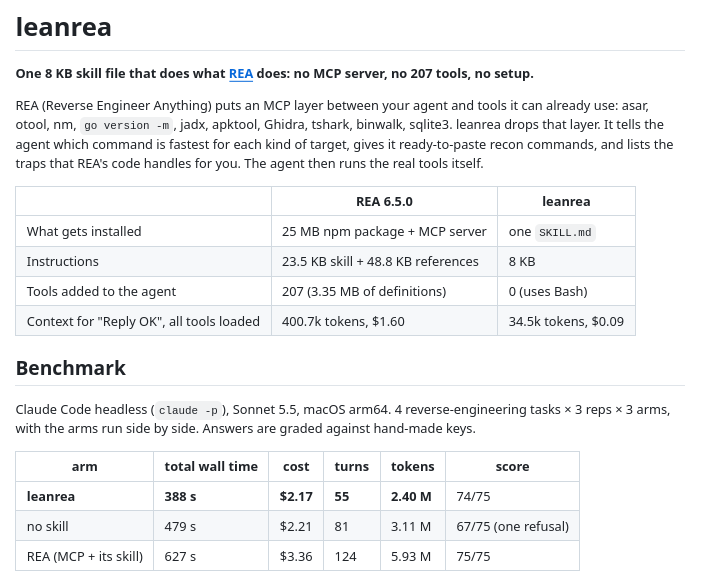
Представлен ИИ-скилл leanrea размером 8 КБ, который помогает Codex, Claude Code, Cursor, Gemini CLI и OpenCode достаточно быстро клонировать сайты и приложения.

Скилл leanrea подсказывает нейросетям, как нужно анализировать сайты, приложения Electron, бинарные файлы, Android APK и прошивки. Для веб-приложений инструмент отдельно учитывает минифицированные сборки и карты исходников.

Теги:
+3
Комментарии0

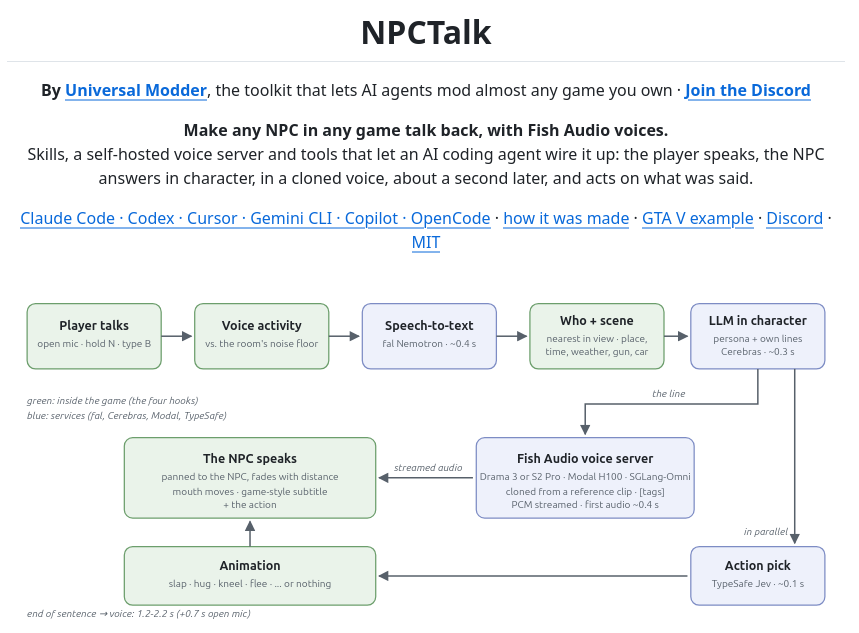
Представлен открытый плагин NPCTalk, который позволяет создавать «живых» (разговаривающих) NPC, реагирующих на игровые события и фразы в игре при контакте с живым игроком. Например, персонажи могут отвечать грубостью или даже начать драку, если им что-то не понравится. Также к плагину можно подключить всех популярных ИИ-агентов: Claude, Codex, Gemini и Cursor.

Теги:
0
Комментарии1

🏦 Портфель альткоины/золото с автоматической балансировкой

Идея следующая: когда растет Bitcoin, растут альты. Золото растет независимо от Bitcoin.

Исходя от дней роста Bitcoin подряд, смещать распределение портфеля из золота в криптовалюты. Криптовалюты покупать в равной доле независимо от объема торгов, так как все коррелируют с биткоином. При этом не держать в USDT ничего совсем, чтобы избежать инфляции

Закрытие кассы и ребалансировку делаем раз в неделю

import {
  addLauncherSchema,
  addStrategySchema,
  Cache,
  getCandles,
  listenDoneBacktest,
  Position,
  setConfig,
} from "backtest-kit";

setConfig({
  CC_MAX_STOPLOSS_DISTANCE_PERCENT: 100, // иначе валидатор не пропустит технический стоп -50%
});

// Депозит делится поровну между тикерами корзины; доля депозита вне корзины паркуется в золото
const DEPOSIT_USD = 1000;
const PARKING_SYMBOL = "PAXGUSDT";

// Позиция живёт ровно неделю и закрывается по времени; перезаход на первом тике после закрытия
const HOLD_MINUTES = 7 * 24 * 60;

// Трендовый гейт по BTC: доля окон 20..45 дней с положительной доходностью BTC. Это экспозиция
// корзины от 0 до 1; остаток уходит в PARKING_SYMBOL. Ансамбль окон вместо одного N: одиночные
// окна за пределами 25..45 дней заметно хуже, внутри плато результат от выбора N не зависит.
const GATE_SYMBOL = "BTCUSDT";
const GATE_WINDOWS_DAYS = [20, 25, 30, 35, 40, 45];

// Технические уровни: за неделю на споте без плеча недостижимы, штатный выход только по времени
const STOP_LOSS_PERCENT = 50;
const TAKE_PROFIT_PERCENT = 500;

// BASKET:BEGIN
// Сентябрь 2020: топ-20 USDT-пар спота Binance по обороту за август 2020 (известен до начала месяца),
// листинг не моложе 90 дней, без стейблкоинов, плечевых токенов и обёрток BTC/ETH.
const BASKET = [
  "BTCUSDT",
  "ETHUSDT",
  "LINKUSDT",
  "XRPUSDT",
  "BNBUSDT",
  "EOSUSDT",
  "LTCUSDT",
  "TRXUSDT",
  "BCHUSDT",
  "BANDUSDT",
  "OMGUSDT",
  "XTZUSDT",
  "ADAUSDT",
  "ATOMUSDT",
  "VETUSDT",
  "LENDUSDT",
  "ZECUSDT",
  "WAVESUSDT",
  "QTUMUSDT",
  "NEOUSDT",
];
// BASKET:END

const SYMBOL_LIST = [...BASKET, PARKING_SYMBOL];
const PER_SYMBOL_USD = DEPOSIT_USD / BASKET.length;

// getCandles внутри getSignal обрезан по времени движка: последняя дневная свеча - последний
// закрытый день, заглядывания вперёд нет. Cache.fn с интервалом 1d считает гейт один раз
// в день на все тикеры и сам инвалидируется при переходе движка на следующий день.
const getGate = Cache.fn(async (): Promise<number> => {
  const candles = await getCandles(GATE_SYMBOL, "1d", Math.max(...GATE_WINDOWS_DAYS) + 1);
  const closes = candles.map(({ close }) => close);
  const last = closes[closes.length - 1];
  const up = GATE_WINDOWS_DAYS.filter((days) => last > closes[closes.length - 1 - days]).length;
  return up / GATE_WINDOWS_DAYS.length;
}, { interval: "1d" });

addStrategySchema({
  strategyName: "index_fund",
  interval: "1h",
  getSignal: async (symbol, when, currentPrice) => {

    const gate = await getGate();

    const cost = symbol === PARKING_SYMBOL
      ? DEPOSIT_USD * (1 - gate)
      : PER_SYMBOL_USD * gate;

    // cost: 0 движок молча заменяет на CC_POSITION_ENTRY_COST, поэтому нулевая доля - это отсутствие сигнала
    if (cost < 1) {
      return null;
    }

    return {
      id: `${symbol.toLowerCase()}-${when.toISOString().slice(0, 10)}`,
      symbol,
      ...Position.bracket({
        position: "long",
        currentPrice,
        percentStopLoss: STOP_LOSS_PERCENT,
        percentTakeProfit: TAKE_PROFIT_PERCENT,
      }),
      cost: Math.round(cost * 100) / 100,
      minuteEstimatedTime: HOLD_MINUTES,
      payload: { gate, weight: cost / DEPOSIT_USD, basketSize: BASKET.length },
      note: `${symbol} gate=${gate.toFixed(2)} cost=$${cost.toFixed(2)}`,
    };
  },
});

addLauncherSchema({
  launcherName: "main_launcher",
  backtest: true,
  symbolList: SYMBOL_LIST,
  cache: false,
})
Теги:
+3
Комментарии3

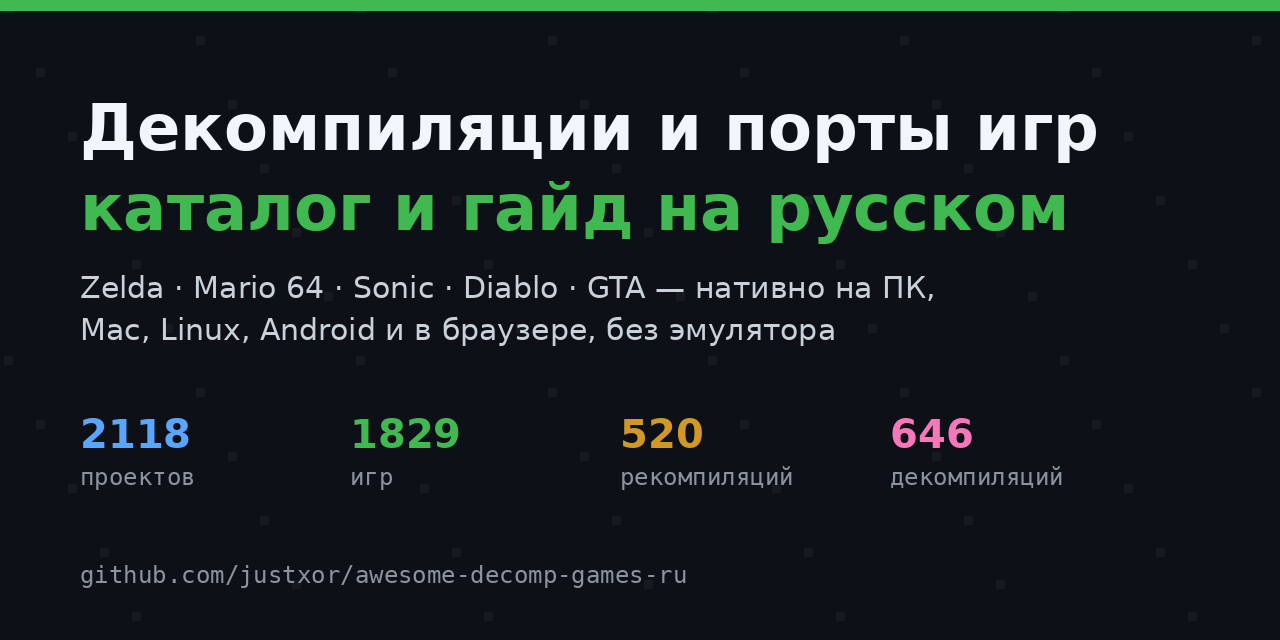
Русскоязычный каталог из 2118 проектов по декомпиляции игр: от Ocarina of Time до Xbox 360

На GitHub появился awesome-список, собранный на русском: проекты, которые восстанавливают игры из машинного кода. Это декомпиляции, статические рекомпиляции, порты на исходниках и ремейки движков. Задача простая: помочь найти проект под нужную игру и платформу и объяснить, как всё это устроено.

Масштаб впечатляет. В каталоге около 2118 проектов для примерно 1829 игр, из них 1771 активных. По типам: 786 декомпиляций, 525 статических рекомпиляций, 269 портов на исходниках, 238 ремейков движков, 234 дизассемблирования, 57 браузерных портов и 9 инструментов.

По платформам лидирует ПК с 295 проектами, дальше Nintendo 64 (190), Xbox 360 и PlayStation 1 (по 161). Следом идут DOS, GameCube, PS2, Game Boy Advance и Wii. Среди примеров Zelda (Ocarina of Time, Majora’s Mask, Twilight Princess), Mario 64, Sonic, Diablo, Morrowind, OpenRA и OpenRCT2.

Внутри не просто список. В README есть топ-25, отдельный список браузерных портов, каталоги по типам и платформам, раздел о том, как начать декомпилировать самому, FAQ и глоссарий. Из инструментов упоминаются N64Recomp, XenonRecomp, RT64, splat, decomp.me, objdiff и m2c. Каталог обновляется автоматически через GitHub Actions.

Важная оговорка: сами проекты работают с данными из легально купленных копий игр, а в репозитории лежат только ссылки.

Репозиторий: https://github.com/justxor/awesome-decomp-games-ru

Теги:
+2
Комментарии1

Вайбкодите? Бог вам судья, конечно. Но если переживаете за разжижение серого вещества в черепной коробке, вот отличный инструмент, чтобы повысить, и укрепить свои компетенции.

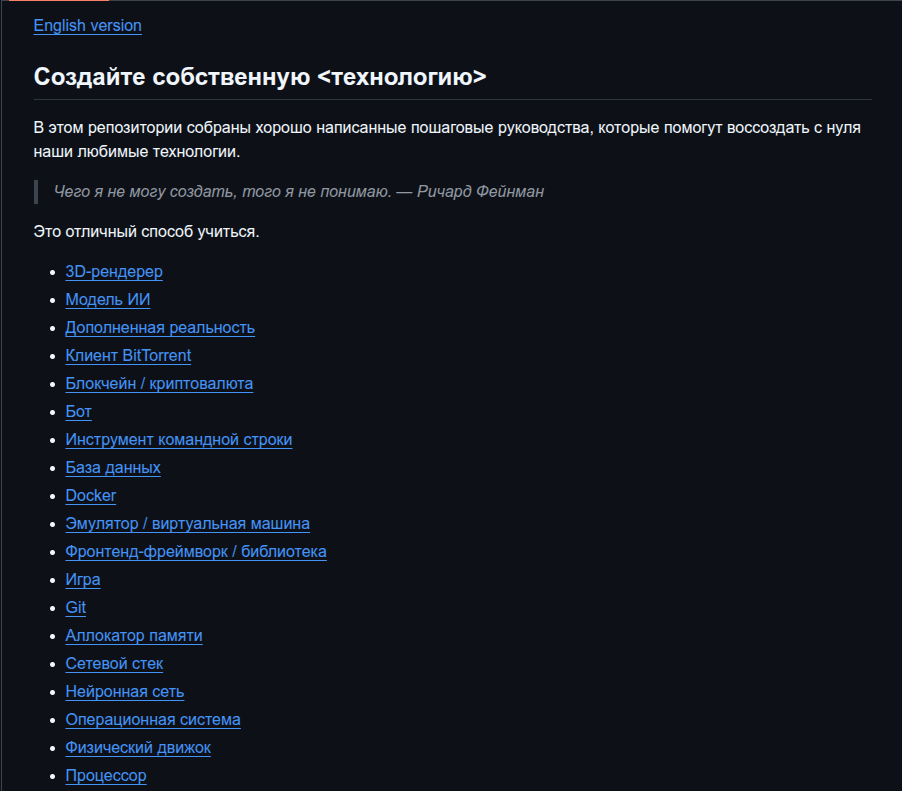
Один из самых популярных репозиториев на GitHub, в котором собраны хорошо написанные пошаговые инструкции, как самому собрать браузер, базу данных, нейросеть и другие популярные технологии.

Лучший способ понять, как всё устроено.

💾 Ссылка: https://github.com/Bednyakov/build-your-own-x

Теги:
+5
Комментарии0

Полный гайд по локальному запуску DeepSeek на русском: от домашнего ПК до сервера с 8 GPU

В открытом доступе руководство из 18 частей о том, как запустить DeepSeek V4, R1 и дистилляты у себя, без облака и интернета. Бесплатно, приватно и офлайн.

Внутри весь путь: выбор модели и расчёт железа, установка и настройка Ollama, llama.cpp, LM Studio, Open WebUI, vLLM и SGLang, работа через API и Python, подключение к IDE. Дальше промптинг, ускорение, RAG, агенты и fine-tuning, а в конце топ-30 приёмов, разбор ошибок, FAQ и готовые конфиги.

Для домашнего ПК основной вариант это R1-дистилляты от 1.5B до 70B. Запуск одной командой: ollama run deepseek-r1:8b. По таблицам гайда в кванте Q4 модель на 8B занимает 5-6 ГБ памяти, на 14B около 9-10 ГБ, на 32B около 20 ГБ, на 70B около 43 ГБ.

Старшие модели уже про серверное железо. DeepSeek-V4-Flash на 284B параметров, из них 13B активных, с контекстом 1M требует около 103 ГБ в 3-битном кванте. DeepSeek-V4-Pro на 1.6T параметров с 49B активными нужны 800 ГБ и больше, то есть сервер с 8 GPU.

Несколько практичных советов из гайда. Для русского языка брать модели от 14B, на меньших дистиллятах качество заметно проседает. Квант Q4_K_M считается стандартным выбором, а большая модель в низком кванте обычно лучше маленькой в высоком. Температура около 0.6 для R1 и 1.0 для V4. Проверять через ollama ps, что модель целиком на GPU. И не открывать порт Ollama 11434 в интернет: у API нет пароля.

Репозиторий: https://github.com/justxor/deepseek-local-guide-ru

Теги:
+1
Комментарии0

Запись пред-ивента «Почему агенты не работают — и с чего начать» — уже на видео:

🔗 https://youtu.be/yYYH0P4gmXc

Час живого разбора: где агенты ломаются на практике — уверенно выдумывают, теряют контекст на длинной задаче, делают не то, о чём просили.

А где ломается у вас? Напишите в комментариях.

Эти места разбираем и лечим на курсе «AI-агенты, которые работают»: старт 21.10, занятие 1 из 7, среды 19:00–21:00 МСК.

Доступ — по подписке «Мастер»: https://boosty.to/polnyistek/purchase/3939761

Теги:
-1
Комментарии0

Последний пинг: tower defense про защиту дата-центров

Сделал браузерную игру, в которой нужно защищать дата-центры от дронов, ракет и тяжёлых машин. В обороне участвуют роверы и условные зенитные установки. Всё аркадное: никаких реальных характеристик вооружения.

Главный ресурс — энергия. Нужно балансировать между обороной, ремонтом и развитием. Серии перехватов заряжают способности, после волн можно выбирать улучшения, а следующую волну — вызвать досрочно ради бонуса. Если уверен в своей расстановке.

Сейчас доступны четыре карты. На Севере приходится распределять обогрев, в Порту — перевозить батареи между секторами, на Крышах — защищать сразу три дата-центра. Есть три сложности и боссы с несколькими фазами.

Разработку вёл с AI-агентами: отдельно реализация, отдельно ревью и проверки. Игровая логика покрыта 79 тестами, включая прохождение всех сочетаний карты и сложности. Проверки в браузере дополняют тесты, но не заменяют живых игроков: интересный баланс одними зелёными галочками не доказать.

Поиграть без установки и регистрации: td.kosarevsky.dev

Интересно, какую тактику вы найдёте и на какой волне игра впервые заставит её пересмотреть.

tg

Теги:
+1
Комментарии2

Ближайшие события

decision-cascade: открытый движок машинных решений против проприетарных System One-моделей

На GitHub появился decision-cascade — локальный движок принятия решений, который возвращает типизированные, калиброванные ответы вместо генерации текста. Автор позиционирует его как открытую альтернативу проприетарным System One-моделям вроде Jev от TypeSafe AI, но с полным контролем над данными и инфраструктурой.

Что это. Вместо авторегрессионной генерации движок превращает состояние (строку-описание ситуации) в признаки через энкодер, а головы решений возвращают строго типизированные вероятностные ответы трёх типов: Noul (да/нет с вероятностью), Choice (выбор из опций) и Score (оценка на шкале). Каждый ответ — датакласс с полем confidence, валидируемым распределением и версией схемы. В режиме cascade локальные головы отвечают сами, а внешняя модель подключается только при уверенности ниже порога (по умолчанию 0.6).

Индивидуальность. Рынок System One-моделей оживился: Cloudflare Clef, Perplexity pplx-decider, ConvAI Laya. decision-cascade отличается тремя вещами. Во-первых, это полный цикл в одном репозитории: обучение голов через SFT, RLCD-калибровка с гейтом «не навреди», метрики ECE/Brier, latency-профилирование и деплой через systemd. Во-вторых, совместимость с протоколом SystemOne (POST /v1/systemone) без облачной зависимости и умение проксировать запросы к Jev/Clef/Laya через DECISION_BACKEND=http — свои данные можно обрабатывать локально, а сложные случаи эскалировать. В-третьих, честная мультимодальность: сервис объявляет поддерживаемые модальности и отклоняет остальные типизированной ошибкой, а не тихо деградирует.

Плюсы. Приватность: данные не покидают машину. Калибруемость: вероятности измеряются на ECE и Brier — на AG News заявлен рост accuracy с 0.425 до 0.884 и снижение ECE с 0.725 до 0.151. Детерминированная задержка: на 8 vCPU без GPU первый запрос ~9 секунд, повторные — миллисекунды за счёт кэша. Гибкость: от hash-энкодера офлайн до gemma на GPU. Экономия: в бенчмарке каскад обратился к внешнему сервису лишь за 1.25% решений (0.913 против 0.915 у local).

Минусы. Нужна своя разметка — головы «из коробки» случайны. Нет SaaS с UI — это открытая beta для контроля, а не «кнопка под ключ». Порог входа: нужно понимать обучение голов и метрики калибровки. Ограниченная мультимодальность: видео требует отдельного декодирования, изображения по умолчанию выключены.

Где использовать. Триаж обращений в поддержку (шесть вопросов одним запросом, пример в examples/quickstart/http_client.py). Маршрутизация в агентных системах через api/sdk/agent.py. Модерация контента: Noul для бинарных проверок, Choice для категоризации, Score для серьёзности. Guardrails перед дорогой LLM: 99% запросов закрываются локально. Оценка рисков в реальном времени.

Проект под Apache-2.0. Готовые паки весов в релизе v0.2.0: шесть наборов с честными метриками. Запуск: scripts/bootstrap-user.sh, затем uvicorn — hash-энкодер работает офлайн.

Теги:
+1
Комментарии0

155 000 вакансий: полный анализ IT‑рынка России. Как описание вакансии влияет на зарплату

Как описание вакансии влияет на зарплату

Каждая вакансия - это маленькое письмо от работодателя. В нём есть «дружная семья», «стрессоустойчивость», «опыт от 3 лет», ДМС, печеньки и иногда даже зарплата. Мы читаем такие письма каждый день, листаем, вздыхаем и жмём «Откликнуться». А что, если прочитать их все сразу, и тысячами…, сконвертировать стоимость каждой фразы в рубль? Сколько работодатель готов платить, если он пишет, что мы «дружная семья». Чего рынок ждёт от джуна. За что сегодня доплачивают, а что стало просто гигиеной. Где торговаться, а где бесполезно. И когда вообще лучше откликаться, чтобы тебя хотя бы заметили. Об этом у меня вышла большая статья.

Более 15 графиков, показывающих то куда двигается Российский IT-рынок и что при этом всём делать.

Так что если кто-то ещё не успел прочитать, очень рекомендую...

Теги:
+3
Комментарии0

Открытый проект DigUp помогает искать файлы на macOS по смыслу — поисковику достаточно описать нужный файл:

  • можно написать:

    • «собака на пляже» — получить все такие фото;

    • «где обсуждают сон» — выдаст нужный момент подкаста;

    • «пункт про животных в договоре» сразу страницу PDF;

    • функцию в коде можно найти по описанию её работы.

Под капотом проекта ИИ‑модель EmbeddingGemma 2 от Google. При этом всё работает локально, без подписок и аккаунтов.

Теги:
0
Комментарии0

Пять уровней форматирования - и aiogram перестаёт отвечать

Наткнулся на issue #1925 в aiogram: после получения сообщения с rich_message бот перестал отвечать. Внутри JSON была цепочка форматирования:

spoiler → subscript → bold → italic → underline

На aiogram 3.31.0 вызов Update.model_validate(...) загружал одно ядро на 100% и блокировал event loop. Автор issue пишет, что бот простоял так около часа.

Захотелось разобраться, как несколько уровней форматирования вообще могли положить обработку обновлений.

Что происходило при валидации

За вложенный текст отвечает RichTextUnion - рекурсивный union из строк, списков и 26 моделей форматирования. У каждой модели есть поле text, которое снова может содержать RichTextUnion.

RichTextUnion = (    str    | list["RichTextUnion"]    | RichTextBold    | RichTextItalic    # ... ещё 24 модели
)

Поле type у моделей было, но для выбора ветки union оно не использовалось. Поэтому Pydantic пробовал разные варианты. При проверке неподходящей модели он мог снова перейти к вложенному text, а там - очередной union с теми же вариантами.

То есть проблема не в огромном размере JSON. Валидатор многократно проходил по вложенной структуре, и с каждым новым уровнем количество проверок быстро росло.

Что исправили

В PR #1934 добавили callable discriminator. Он выбирает ветку сразу: строку по "str", список по "list", модель - по её полю type.

Обычного Field(discriminator="type") здесь недостаточно: строки и списки поля type не имеют.

По замерам автора PR, валидация проблемного обновления сократилась с 5,4 секунды до 0,3 мс. Исправление влили 11 октября.

Проверил отдельно от aiogram

Собрал небольшой стенд: 26 упрощённых рекурсивных моделей, два варианта union — обычный и с дискриминатором.

На Python 3.14.8 и Pydantic 2.12.5 для глубины 4 получил:

  • Обычный union - 195,061 мс

  • С дискриминатором - 0,004 мс

Разница почти в 49 тысяч раз. Для варианта с дискриминатором проверил и глубину 100: 0,073 мс. Медленный вариант ограничил глубиной 4 - дальше выполнение становилось слишком долгим.

Бенчмарк использует прогрев и медиану пяти запусков. Есть четыре теста на вложенность и выбор моделей; в CI они запускаются на Python 3.10–3.13.

git clone https://github.com/sairex53/aiogram-rich-text-validation-lab
cd aiogram-rich-text-validation-lab
python -m pip install -r requirements.txt
python -m unittest -v
python benchmark.py

Это не воспроизведение исходного update: стенд не импортирует aiogram и не использует JSON из issue. Я сравнивал именно поведение Pydantic на похожей структуре типов.

Похожую проблему с RichBlockUnion в aiogram уже исправляли в PR #1845. А рекурсивный RichTextUnion тогда остался без дискриминатора.

Теги:
0
Комментарии0

Представлен открытый проект Doory (бесплатная альтернатива Canva). Это полноценный графический редактор, работающий прямо в браузере.

«Создавайте плакаты, публикации для соцсетей, сторис, слайды, приглашения, резюме, миниатюры и визитки: начинайте с шаблона или чистого листа, редактируйте любые элементы и экспортируйте результат в форматах PNG, JPG, SVG, PDF, MP4 или GIF. Все функции бесплатны, для начала работы не требуется регистрация, а сам сервис можно развернуть на собственном сервере.

Doory против Canva: Canva — отличный продукт. Doory создан для тех, кому нужен аналогичный инструмент, но бесплатный, с открытым исходным кодом и возможностью полного контроля над ним», — пояснили в команде проекта.

Теги:
+3
Комментарии0

Оказывается у callback_data надо считать байты, а не символы

В Telegram ограничение для callback_data - 1–64 байта. В Python len() считает символы. Для ASCII разницы нет, но для emoji и других многобайтных символов она быстро становится заметной:

prefix = "🐍" * 10
len(prefix)                 # 10
len(prefix.encode("utf-8")) # 40

В aiogram-tool 1.2.3 я нашёл расчёт длины служебного идентификатора для LongCallbackData. Он вычитал len(prefix) из лимита 64, то есть при emoji оставлял себе лишнее место. Дальше библиотека генерировала ID, который уже вместе с префиксами не помещался в лимит aiogram.

Минимальное воспроизведение — класс с prefix="🐍" * 10. В регрессионном тесте _UniqueIDCallbackData.build(Data).pack() на исходном коде падает с ValueError: Resulted callback data is too long. То есть длинный payload библиотека умеет убирать в storage, но даже короткая ссылка на него может не поместиться, если пользовательский prefix не ASCII.

Исправление — считать UTF-8 байты для каждого поля, участвующего в расчёте:

separators_len = len(cls.__separator__.encode("utf-8")) * len(cls.model_fields)
unique_id_len = (    64    - len(UNIQUE_PREFIX.encode("utf-8"))    - len(callback_data.__prefix__.encode("utf-8"))    - separators_len
) // 2

Проверка не ограничивается сравнением длины: тест строит длинный callback, проверяет, что результат укладывается в 64 байта, а затем прогоняет его через LongCallbackQueryFilter и проверяет восстановленные данные.

На исходной версии новый тест падает на сборке служебного ID. После патча два теста файла test_unique_id.py проходят (2 passed). Тест, патч и инструкция по воспроизведению лежат в репозитории: тест, патч, инструкция. PR в upstream пока не открывал.

Проверял на Linux, Python 3.12, aiogram 3.29.1. Это unit-тесты упаковки и распаковки; реальный callback в Telegram не отправлял.

Теги:
+3
Комментарии0

Ошибка в on_error может остановить очередь сообщений бота

В очереди исходящих сообщений ошибка Telegram API - обычная ситуация: пользователь заблокировал бота, запрос оборвался, Telegram вернул временную ошибку. А что будет, если обработчик этой ошибки тоже выбросит исключение?

Я проверил этот сценарий в aiogram-dialog-yaml.

В очередь кладутся два сообщения. Первое падает при отправке. MessageQueue вызывает on_error, а тот, например, пишет в базу и сам падает из-за недоступной базы. Исключение выходит из worker-корутины. Второе сообщение остаётся в очереди, а queue.join() ждёт его бесконечно: рабочего, который мог бы его забрать, уже нет.

Это воспроизводится без токена и запросов к Telegram. Тест подменяет бота объектом, у которого отправка первого сообщения выбрасывает RuntimeError, и проверяет оба варианта on_error: обычную и async-функцию. На исходном коммите оба теста завершились TimeoutError на queue.join().

Исправление небольшое: ошибку самого callback логируем и продолжаем цикл очереди

try:    result = self._on_error(task, exc)    if inspect.isawaitable(result):        await result
except Exception:    log.exception(        "on_error callback failed for %s(chat_id=%s)",        task.method,        task.chat_id,    )

Здесь важно ловить Exception, а не BaseException: отмена worker-задачи через asyncio.CancelledError должна по-прежнему доходить до asyncio. И это не retry: неудачное сообщение не отправляется повторно. Изменение только не даёт сбою в обработчике ошибок уронить единственного worker’а и оставить остальные сообщения без обработки.

После патча регрессионный тест проходит, полный набор тестов проекта на Python 3.12 — 21 passed. Тест, патч и инструкция по воспроизведению лежат в репозитории: тест, патч, инструкция. Pull request автору проекта пока не отправлял.

Проверить можно на том же коммите: добавить test_error_handler_failure.py в tests/, применить queue.patch и запустить PYTHONPATH=src python -m pytest -q.

Это локальная проверка очереди с fake bot, не интеграционный тест Telegram API. Для production retry, backoff и dead-letter очередь всё равно надо проектировать отдельно.

Теги:
0
Комментарии0
1
23 ...