Обновить
512K+

Python *

Высокоуровневый язык программирования

541,67
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Решаем мини-игру про взлом протокола в Cyberpunk 2077 за 50 строк на Python

Время на прочтение6 мин
Охват и читатели10K
image

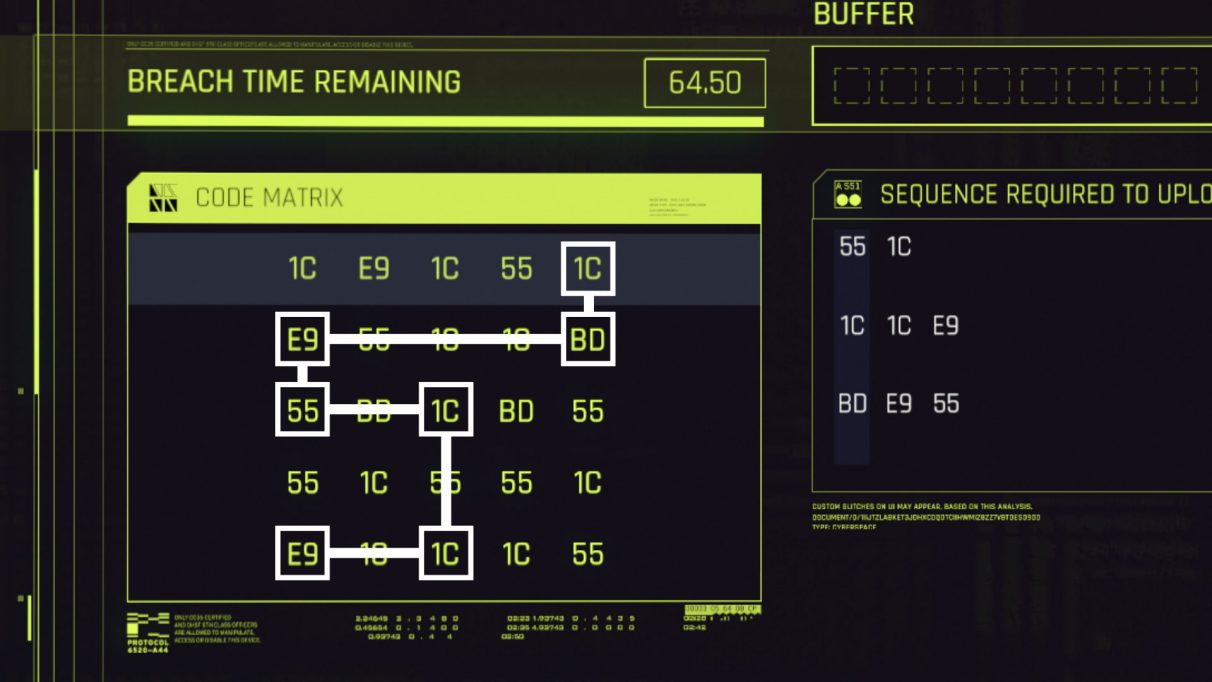
Если вы хотя бы отдалённо интересуетесь играми и не прожили последнюю пару лет в тайге, то, вероятно, слышали что-нибудь о Cyberpunk 2077. После долгого ожидания она наконец вышла! И в ней есть мини-игра про взлом! И чем больше получишь в ней очков, тем ценнее приз! Может ли магия Python дать нам преимущество в этом жестоком Нете? Разумеется.

Краткое описание мини-игры: игроку даётся квадратная матрица и одна или несколько последовательностей шестнадцатеричных чисел, а также буфер определённой длины. Цель игрока — завершить наибольшее количество последовательностей, выбирая столько узлов, сколько позволяет буфер. Каждая последовательность заполняется значением, если выбранный узел является следующим узлом последовательности. В начале игры можно выбрать любое из значений в первой строке матрицы. После этого в каждом ходе можно попеременно выбирать N-ный столбец/строку, где N — индекс последнего выбранного значения. Если это ужасное описание вам не помогло, то более подробное можно прочитать здесь.
Читать дальше →

Хватит злоупотреблять *args и **kwargs в Python

Время на прочтение3 мин
Охват и читатели8.8K

Мощные инструменты опасны. Вы могли облегчить свою жизнь, но запомните мои слова, они вскоре вернутся, чтобы преследовать вас.

Но почему?

Как джуниор Python-разработчику стать мидлом за год

Время на прочтение12 мин
Охват и читатели35K
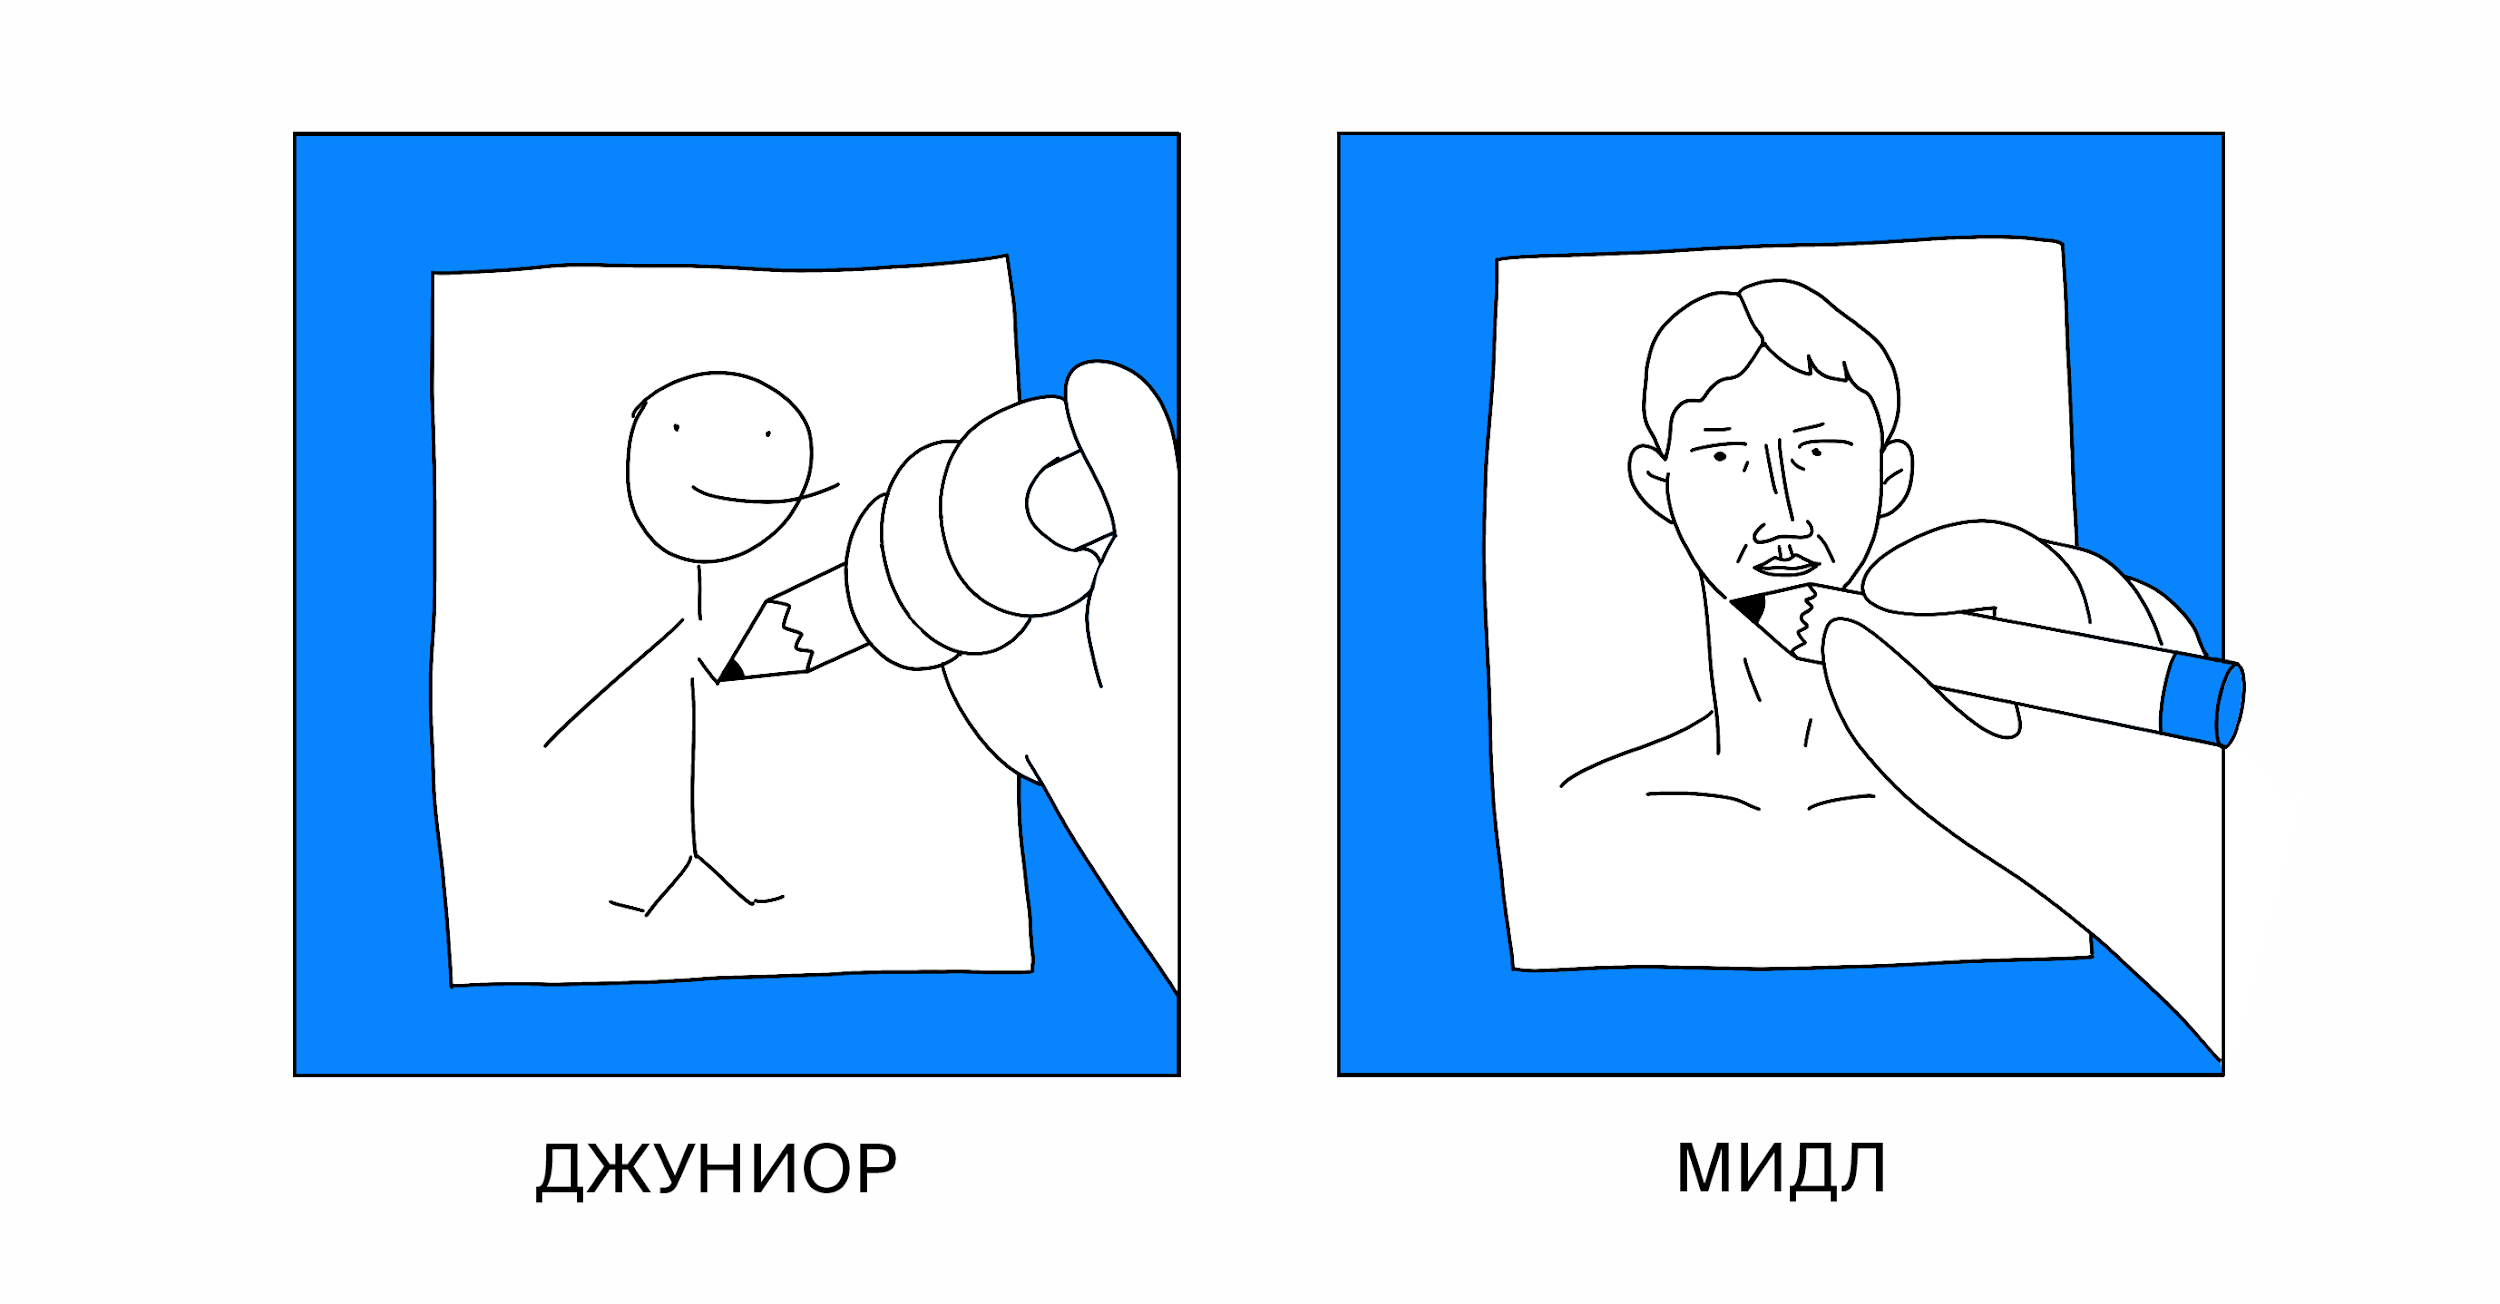
Привет! Я Рома, менеджер продукта в Яндекс.Практикуме, где развиваю курс «Мидл Python-разработчик». Мы делаем из начинающих разработчиков крепких мидлов с инженерным мышлением. Сегодня хочу поделиться небольшими заметками о том, над чем стоит работать, если вы джуниор, который хочет стать мидлом.

Я не разработчик, поэтому эта статья во многом отражает взгляд со стороны. Ответить на вопрос «Как джуниор Python-разработчику стать мидлом за год?» — не такая простая задача, как может показаться на первый взгляд. Здесь спряталось сразу несколько челленджей:

  1. Ответить на вопрос, кто такой джуниор: определить отправную точку, базу навыков, с которой мы будем рассматривать рост.
  2. Ответить на вопрос, кто такой мидл — финальная точка нашего путешествия. Конечно же, во всех компаниях мидлы разные, а нам нужно какое-то взвешенное среднее, не оторванное от реальности.
  3. Ответить на вопрос, почему рассматриваем рост именно за год. Не ради красивой круглой цифры же, верно?

Ну и это довольно холиварная тема. Не знаю, сколько копий было сломано на этом ристалище, но уж точно не одно.
Читать дальше →

Ещё раз о производительности фреймворков Python для веб разработки

Время на прочтение2 мин
Охват и читатели13K
Недавно мне пришлось начинать проект нового веб сервиса, и я решил протестировать максимальную нагрузочную способность Django, а заодно сравнить её с Flask’ом и AIOHTTP. Результат показался мне неожиданным, поэтому я «просто оставлю» его тут.
Читать дальше →

Не баян: ищем дубликаты изображений на основе Milvus с индексом FAISS внутри

Время на прочтение6 мин
Охват и читатели9.7K


В user-generated проектах часто приходится бороться с дубликатами, а для нас это особенно актуально, так как основной контент мобильного приложения, которое я разрабатываю, — это изображения, которые постятся десятками тысяч ежедневно. Для поиска повторов мы написали отдельную систему, чтобы облегчить процесс и сэкономить море времени.

Под катом рассмотрим используемые инструменты, а потом перейдём к примеру реализации.
Читать дальше →

Обучение на табличных данных. TABNet. Часть 2. Реализация

Время на прочтение16 мин
Охват и читатели4.7K

Продолжение перевода про архитектуру TABNet. Первая часть здесь

Мы предложили TabNet, новую архитектуру глубокого обучения для табличного обучения. TabNet использует механизм последовательного улучшения выбора подмножества семантически значимых функций для обработки на каждом этапе принятия решения. Выбор функций на основе экземпляров обеспечивает эффективное обучение, поскольку возможности модели полностью используются для наиболее важных (предсказательных) функций, а также дает возможность принимать более интерпретируемые решения с помощью визуализации масок выбора. Мы демонстрируем, что TabNet превосходит предыдущую работу с табличными наборами данных из разных доменов. Наконец, мы демонстрируем значительные преимущества предварительной тренировки без учителя для быстрой адаптации и повышения производительности.

Читать далее

Конструктор Lego и объектно-ориентированное программирование в Tcl. Разбор сертификата x509.v3

Время на прочтение31 мин
Охват и читатели3.4K
imageЧасто приходится слышать, что скриптовому языку Tcl не хватает поддержки объектно-ориентированного стиля программирования. Сам я до последнего времени мало прибегал к объектно-ориентированному программированию (ООП), тем более в среде Tcl. Но за Tcl стало обидно. Я решил разобраться. И оказалось, что практически с момента появления Tcl, появилась и возможность объектно-ориентированного программирования в его среде. Всё «неудобство» заключалось в необходимости подключить пакет с поддержкой ООП. А таких пакетом было и есть несколько, как говорится на любой вкус. Это и Incr Tcl, Snit и XoTcl.

Программисты, привыкшие к языку C++, чувствуют себя как дома, программируя в среде Incr Tcl. Это было одним из первых широко используемых расширений для OOП на основе Tcl.

Пакет Snit в основном используется при построении Tk-виджетов, а XoTcl и его преемник nx предназначались для исследования динамического объектно-ориентированного программирования.

Обобщение опыта, полученного при использовании этих систем, позволило внедрить ООП в ядро Tcl начиная с версии 8.6. Так появился TclOO — Tcl Object Oriented.

Сразу отметим, что Tcl не просто поддерживает объектно-ориентированное программирование, а в полном смысле динамическое объектно-ориентированное программирование.
Читать дальше →

HDB++ TANGO Archiving System

Время на прочтение4 мин
Охват и читатели1.7K
main

Что такое HDB++?


Это система архивирования TANGO, позволяет сохранять данные полученные с устройств в системе TANGO.


Здесь будет описана работа с Linux (TangoBox 9.3 на основе Ubuntu 18.04), это уже готовая система где все настроено.


О чем статья?


  • Архитектура системы.
  • Как настроить архивирование.

У меня ушло ~ 2 недели чтобы разобраться в архитектуре и написать свои скрипты для python под это дело.


Для чего это нужно?


Позволяет хранить историю показаний Вашего оборудования.


  • Вам не нужно думать о том как хранить данные в БД.
  • Нужно только указать какие атрибуты с какого оборудования архивировать.
Читать дальше →

Sibur Challenge 2020 или «как мы фичи придумывали»

Время на прочтение4 мин
Охват и читатели1.5K

Всем привет! В этом году компания Sibur Digital вновь проводила крупный (по сравнению с другими российскими) чемпионат по анализу данных. Мы с другом в нём участвовали и хотели бы поделиться с читателями Хабра своим решением и опытом, полученным от участия. Конечно вряд ли мы Америку откроем этой статьей, но какой-нибудь новичок в соревнованиях по АД точно сможет почерпнуть для себя что-то полезное.

Читать далее

Как прогнозировать результаты спортивных матчей с помощью проекта ML на Python Pandas, Keras, Flask, Docker и Heroku

Время на прочтение7 мин
Охват и читатели13K
Во время Чемпионата мира по регби в 2019 году я сделал небольшой научный проект Data Science, чтобы попытаться спрогнозировать результаты матчей, написав о нем здесь. Я развил проект до примера от начала до конца, чтобы продемонстрировать, как развернуть модель машинного обучения в виде интерактивного веб-приложения.

Приятного чтения

Обучение на табличных данных. TABNet. Часть 1

Время на прочтение18 мин
Охват и читатели12K

TabNet – новая высокопроизводительная каноническая архитектура глубокого обучения на основе табличных данных. TabNet использует последовательные оценки выбора функций, которые следует использовать на каждом этапе принятия решения. Это обеспечивает интерпретируемость и эффективность процесса обучения, поскольку способность к обучению определяется более релевантными функциями (наиболее адекватными, согласно рассматриваемым оценкам выбора решения). Показано, что TabNet превосходит другие варианты архитектуры нейронной сети и дерева решений по широкому диапазону табличных наборов скалярных данных при интерпретации атрибутов их влияния на производительность, что ведет к пониманию поведения общей модели.

Читать далее

Rust глазами Python-разработчика

Время на прочтение14 мин
Охват и читатели29K


Привет! Мы – часть команды разработки «Рамблер/Медиа» (портал «Рамблер»). На протяжении трех лет мы поддерживаем и развиваем несколько больших python-приложений. Чуть больше года назад перед нами встала задача написать еще одно большое приложение – API к основному хранилищу новостей, и мы сделали это на Rust.


В статье мы расскажем о том, что заставило нас отойти от привычного стека технологий, и покажем, какие плюсы по сравнению с Python есть у Rust.


Мы не ответим на вопрос, почему выбор пал именно на Rust, а не Go, например, или на какой-либо другой язык. Также мы не будем сравнивать производительность Python- и Rust-приложений – эти темы достойны отдельного обсуждения.

HackTheBox. Прохождение Laser. Jetdirect, RPC и кража SSH

Время на прочтение5 мин
Охват и читатели5K

Продолжаю публикацию решений, отправленных на дорешивание машин с площадки HackTheBox.

В данной статье мы работаем с принтером и получаем документ, который даст нам вектор захвата хоста, найдем в памяти ключ шифрования и расшифруем найденный документ. Далее работаем с gRPC и даже получаем RCE. Как вектор LPE, пробуем найти уязвимость в скиптах, использующих SSH.

Организационная информация
Чтобы вы могли узнавать о новых статьях, программном обеспечении и другой информации, я создал канал в Telegram и группу для обсуждения любых вопросов в области ИиКБ. Также ваши личные просьбы, вопросы, предложения и рекомендации рассмотрю лично и отвечу всем.
Читать дальше →

Ближайшие события

Классические задачи Computer Science на языке Python. Обзор книги

Время на прочтение7 мин
Охват и читатели13K
Привет, Хабр!

Одной из самых интересных наших книг по Python в течение уходящего года оставались "Классические задачи Computer Science на языке Python" от Дэвида Копеца.


Для тех, кто еще не успел ознакомиться с этой книгой, предлагаем ее обзор, написанный по оригинальному изданию в октябре 2019 года. Также можно ознакомиться с небольшим обсуждением на Reddit. Также все желающие могут высказаться по поводу допечатки — для этого в конце статьи поставлена голосовалка.
Читать дальше →

3D ML. Часть 5: Свертки на графах

Время на прочтение13 мин
Охват и читатели9.6K


В предыдущих заметках данной серии мы уже успели поговорить о датасетах и инструментах, функциях потерь и примерах прикладных задач, а сейчас пора перейти к “ядру” любой подобласти глубокого обучения — к их архитектурам. Но, прежде чем разбираться с тем как устроены целые архитектуры, стоит разобраться в их составных частях, делающих их пригодными для применения к неевклидовым данным.


Наверное вы уже догадались, что речь сегодня пойдет о сверточных операторах на графах.

Читать дальше →

Ящики, усы и скрипки

Время на прочтение4 мин
Охват и читатели10K


Очень часто данные необходимо сравнивать. Например, у нас есть несколько рядов данных из какой-то области деятельности человека (промышленности, медицины, государственного управления, …), и мы хотим сравнить, насколько они похожи или, наоборот, чем одни показатели выделяются по сравнению с другими. Для простоты восприятия возьмем данные более простые, универсальные и нейтральные — высоту в холке и вес нескольких пород собак по сведениям Американского клуба собаководства (American Kennel Club). Данные по размерам пород в среднем можно найти здесь. Прибавим к ним функцию random.uniform из Python-библиотеки numpy, переведем дюймы в сантиметры, а фунты в килограммы, и вот мы получаем реалистично выглядящий набор данных по размерам собак нескольких пород, с которым можно работать. В нашем примере это чихуахуа, бигли, ротвейлеры и английские сеттеры.
Читать дальше →

Мы скачали 10 миллионов Jupyter-ноутбуков с Github — и вот что мы выяснили

Время на прочтение4 мин
Охват и читатели14K

Привет, Хабр! 

На связи команда Datalore by JetBrains. Хотим поделиться с вами результатами анализа нескольких миллионов публично доступных репозиториев Github с Jupyter-ноутбуками. Мы скачали ноутбуки, чтобы немного больше узнать в цифрах о текущем статусе, пожалуй, самого популярного инструмента для data science.

Читать далее

Как пропускать и одновременно присутствовать на лекции или «за меня учится Python бот»

Время на прочтение7 мин
Охват и читатели22K

Я имею самый обычный рабочий график: 5/2, 8ч/день. В настоящий момент удаленно учусь в аспирантуре (коронавирус, все дела) и единственный день, когда я могу вдоволь почувствовать себя человеком-соседом и поделать что-то по дому, – это суббота. Как вы понимаете, здесь что-то пошло не так и вместо обещанных будничных пар, которые должны были проходить по вечерам после работы, нам утрамбовали всю субботу. Но дела ведь себя не переделают, поэтому решено было написать на python простого бота-кликера, который мог бы заходить на пару, стартовать запись экрана со звуком, ожидать окончания пары, выключать записть и выходить с пары.

Читать далее

Неблокирующие ошибки метода assert в Pytest-check

Время на прочтение6 мин
Охват и читатели13K

В сообществе тестировщиков много спорят о том, сколько assert-ов должно быть в одном автоматизированном тесте пользовательского интерфейса. Некоторые считают, что на один тест должен приходиться один assert, то есть каждый тест должен проверять только один элемент. Другие же вполне довольны тем, что их тест проверяет сразу несколько элементов. 

Какой бы подход вы ни выбрали, я думаю, можно с уверенностью сказать, что тесты должны оставаться ясными, краткими, читаемыми и, конечно же, их должно быть просто поддерживать. Лично у меня не возникает проблем с несколькими assert-ами в одном тесте, поскольку я фокусируюсь на одной функциональной области.

Например, возьмем форму регистрации:

Читать далее

Как я анализировал свои поездки на такси

Время на прочтение4 мин
Охват и читатели9.4K

Всякий раз, как я езжу на такси мне на почту приходит отчет о поездке с разной информацией. В частности они содержат дату, время поездки, модель автомобиля и ФИО водителя. Меня посетила идея - проанализировить отчеты от яндекс такси и вытащить из них максимум интересной информации. Вам наверняка тоже всегда было интересно сколько раз вы ездили на одной и той же машине ил сколько раз вас возил один и тот же водитель?

Задача, которая здесь описана может быть хорошим упражнением для начинающих аналитиков. Тут будет всё: и python c pandas и парсинг HTML и регулярные выражегия и базы данных c SQL.

Читать далее