


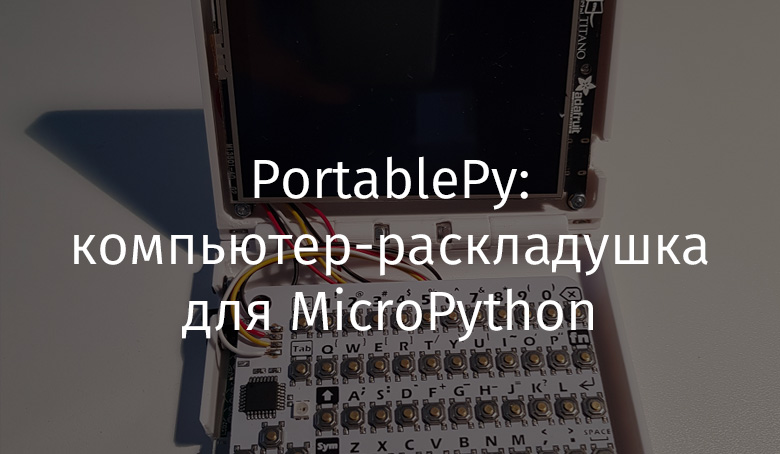
PortablePy: компьютер-раскладушка для MicroPython

Я сделаю свою «умную» колонку… «with blackjack and hookers!»

Я сделаю свою «умную» колонку… «with blackjack and hookers!»
Привет всем. В данной статье я расскажу историю как мы с двоюродным братом сделали свою «умную» колонку-голову робота Бендера из Футурамы.

Как сделать Data Science приложение для Windows (и не только) с графическим интерфейсом с помощью PySimpleGUI
- Модель ML тестируется на различных наборах данных. Вы можете перетащить файлы CSV в модель и отрисовать кривую AUS/ROC. Здесь GUI проявит себя прекрасно, правда?
- Построить случайную переменную или статистическое распределение в заданном диапазоне и динамически управлять параметрами с помощью графического интерфейса.
- Быстро запустить некоторые задачи обработки или предварительной обработки данных в наборе с помощью GUI вместо того, чтобы писать кучу кода.
В этой статье мы покажем, как создать такой графический интерфейс, потратив минимум усилий на изучение библиотеки Python.

Трассировка Python GIL
Есть много статей, объясняющих, для чего нужен Python GIL (The Global Interpreter Lock) (я подразумеваю CPython). Если вкратце, то GIL не даёт многопоточному чистому коду на Python использовать несколько ядер процессора.
Однако мы в Vaex исполняем большинство задач с интенсивными вычислениями на С++ с отключением GIL. Это нормальная практика для высокопроизводительных Python—библиотек, в которых Python всего лишь выступает в роли высокоуровневого связующего звена.
GIL нужно отключать явно, и это ответственность программиста, о которой он может забыть, что приведёт к неэффективному использованию мощностей. Недавно я сам побывал в роли забывшего, и нашёл подобную проблему в Apache Arrow (это зависимость Vaex, так что когда GIL не отключается в Arrow, мы (и все остальные) сталкиваемся с падением производительности).
Кроме того, при исполнении на 64 ядрах производительность Vaex иногда далека от идеала. Возможно, он использует 4000 % процессора вместо 6400 %, что меня не устраивает. Вместо того, чтобы наугад вставлять выключатели для изучения этого эффекта, я хочу разобраться в происходящем, и если проблема в GIL, то хочу понять, почему и как он тормозит Vaex.
Разрабатываем и развёртываем собственную платформу ИИ с Python и Django
Но не бойтесь всей этой инфраструктуры; чтобы понять эту статью, достаточно минимума знаний языка Python и фреймворка Django. Специально к старту нового потока курса по машинному обучению в этом посте покажем, как быстро создать собственную платформу ML, способную запускать самые популярные алгоритмы на лету.
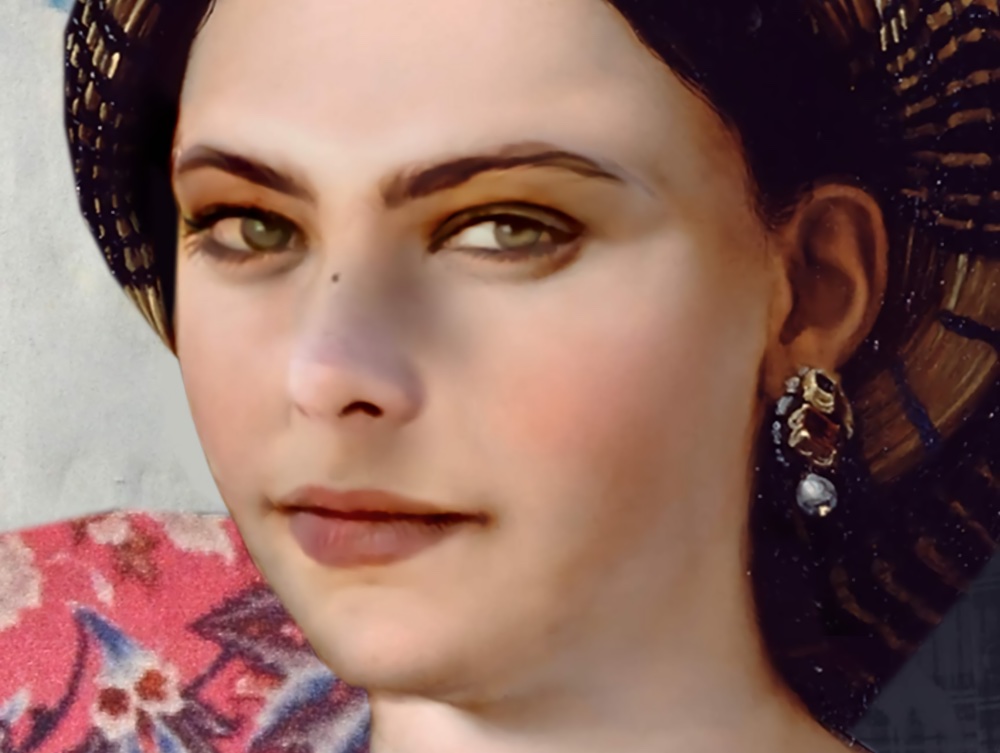
Портрет Орнеллы Мути Джозефа Айерле (фрагмент), рассчитанный с помощью технологии искусственного интеллекта.

CodeSys на RaspberryPi 3 model B для реальных целей+MS SQL. Расчет метража продукции, произведенной на гофроагрегате

Особо углубляться в описание малинового продукта нет необходимости. Глобальная сеть пестрит статьями с описанием как самого микрокомпьютера, так и проектов на нем.
Не буду лукавить и приводить кучу доказательств и обоснований того почему сделано так как сделано (а с учетом ценников на пром автоматику, система получилась копеечная, <150$ против самой дешевой дельты с ограниченным функционалом за 300$), так как давным-давно меня заинтересовал симбиоз RasberyPi и программного комплекса промышленной автоматизации Codesys и хотелось проверить на реально необходимом проекте. И только поэтому был выбран данный «Hardware», хоть и сомнение в стабильной работе не покидали до последнего момента.

Решаем natural language processing-задачу – классификация текстов по темам
В предыдущей статье я рассказал, как подготовить датасет, содержащий тексты блога habr.com с информацией об их принадлежности к определенной категории. Теперь на базе этого датасета я расскажу о подходах, позволяющих создать классификатор, автоматически относящий текст к той или иной категории.
Сегодня нам предстоит описать решение задачи по созданию классификатора текстовых документов. Шаг за шагом мы будем пытаться улучшить нашу модель. Давайте посмотрим, что же из этого получится.
Для решения нашей задачи снова используем язык программирования python и среду разработки Jupyter notebook на платформе Google Colab.
В работе понадобятся следующие библиотеки:

Вызываем код на Java, C, NodeJS, C#, Python из InterSystems IRIS
Введение
Одно из ключевых направлений развития платформы данных InterSystems IRIS — открытость. Открытость во взаимодействии с языками программирования, технологиями и протоколами. Поддержка языков программирования двусторонняя — возможен как вызов кода из InterSystems IRIS, так и предоставляется API для работы с InterSystems IRIS извне. В этой статье речь пойдёт о первом варианте — вызове кода из InterSystems IRIS. Целью этого небольшого повествования является демонстрация того, как просто и удобно можно это сделать. Я не буду сравнивать различные языки программирования (хотя в конце есть таблица по скорости работы различных имплементаций), всё зависит от решаемых вами задач и требований, предъявляемых к результату разработки. В этой статье я продемонстрирую несколько различных подходов к вызовам сторонних библиотек, а реализовывать мы будем одну и ту же функциональность — вызов функции DELFATE из библиотеки zlib.

Обход Incapsula c помощью selenium

Обратился заказчик, с проблемой что его сборщик не может справиться с защитой "incapsula".
В двух словах, вместо кода страницы возвращается javascript код, при выполнении которого, идет запрос на сервера инкапсулы, проверяются какие-то параметры браузера и в случае если браузер признан валидным, отдается страница и некоторые cookie.
Подробное описание есть на сайте разработчика (www.imperva.com)

Как изменился Datalore за 2020 год: мощная онлайн-среда для Jupyter-ноутбуков
Привет, Хабр!
Datalore — это мощная онлайн-среда для Jupyter-ноутбуков, разработанная в JetBrains. Здесь мы собрали описание самых важных обновлений Datalore за прошедший год.
Собираем данные для тренировки в решении NLP-задач

Выбор источника и инструментов реализации
В качестве источника информации я решил использовать habr.com – коллективный блог с элементами новостного сайта (публикуются новости, аналитические статьи, статьи по информационным технологиям, бизнесу, интернету и др.). На этом ресурсе все материалы делятся на категории (хабы), из которых только основных – 416 штук. Каждый материал может принадлежать к одной или нескольким категориям.
Код для сбора информации (парсинга) написан на языке python. Среда разработки – Jupyter notebook на платформе Google Colab. Основные библиотеки:

Как найти email пользователя GitHub и написать Telegram бота для решения этой задачи?
Этот пост будет полезен двум категориям людей: IT-рекрутерам и начинающим разработчикам, которые хотят научиться писать простенькие программы для решения практических задач.
Задача: известен профиль пользователя на GitHub, необходимо найти email этого пользователя
Решение: один запрос к API GitHub и телеграм-бот, которого мы напишем в этом посте
Идея написать бота пришла ко мне после того, как коллега поделилась со мной этим способом...
Ближайшие события

Миллион домашних фотографий: лица, лица, лица
Итак, все фотографии разложены по папкам и находить фотографии Новых годов или дней рождения стало быстро и удобно. Фотографии из отпусков тоже можно найти относительно быстро, но хотелось большего. А именно, искать по людям и не просто по людям, а по набору людей, например, найти все совместные фотографии детей или фотографии с бабушкой и т.д.
Поэтому я решил немного углубиться в так называемый Face Recognition.

Вот вообще этим не занимался, и тут раз, и Data Science

Машинное обучение. Все о нём говорят. Много кто. Большая тема – но покрытая этой жуткой мистикой. Как магия – есть дар, сможешь что угодно сделать. Если нет... вообще не понятно, как подступиться. Постоянно фигурируют какие-то numpy, pandas, scikit-learn. На каждую из них фигурирует по двухтомному учебнику и куче доков.
Хочу в этой статье развеять мистику. Давайте чего-нибудь обучим, и найдём закономерности в большом наборе данных. Может и предскажем что-нибудь, даже. На простом, добром питоне – без всякой библиотеки в два гигабайта, и с минимальным входным порогом знаний.
Интересно? Прошу под кат.

Глубокие нейронные деревья принятия решений
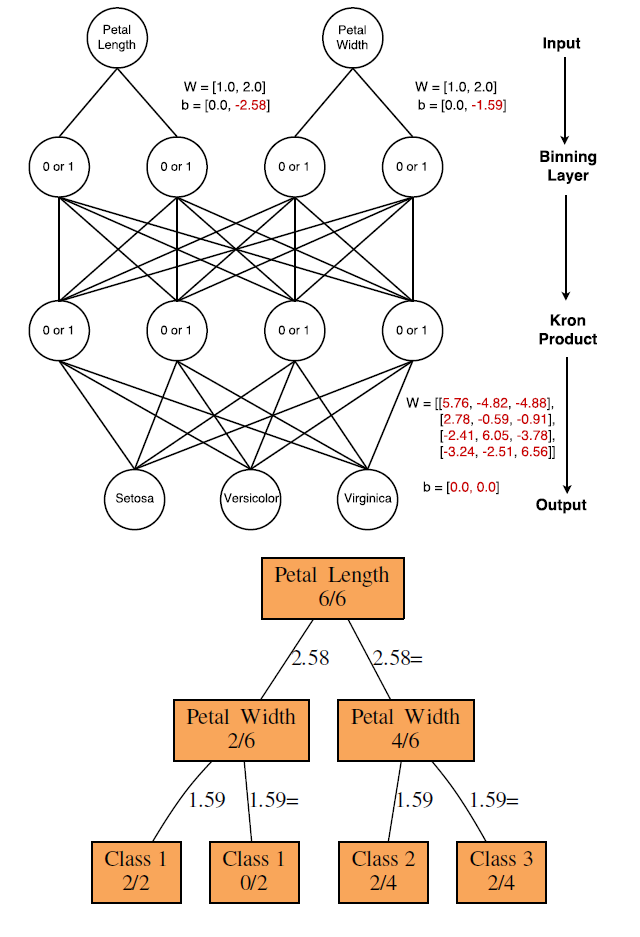
Глубокие нейронные сети доказали свою эффективность при обработке данных таких, как изображения и аудио. Однако для табличных данных более популярны древовидные модели. Хорошим свойством древовидных моделей является их естественная интерпретируемость. В этой работе мы представляем Deep Neural Decision Trees (DNDT) –древовидные модели, реализованные нейронными сетями. DNDT внутренне интерпретируем. Тем не менее, поскольку это также нейронная сеть (NN), ее можно легко реализовать с помощью инструментария NN и обучить по алгоритму градиентного спуска, а не по «жадному» алгоритму. Мы проводим оценку DNDT на нескольких табличных наборах данных, проверяем его эффективность и исследуем сходства и различия между DNDT и обычными деревьями решений. Интересно, что DNDT самообучается как на разделенном, так и на функциональном уровне.

Есть ли жизнь без Nvidia? Запускаем TensorFlow на Radeon RX 580
На новом рабочем месте меня посадили за ПК, оборудованный процессором Ryzen 2600 и видеокартой Radeon RX 580. Попробовав обучать нейронные сети на процессоре, я понял, что это не дело: уж слишком медленным был процесс. После недолгих поисков я узнал, что существует как минимум 2 способа запуска современных библиотек машинного обучения на видеокартах Radeon: PlaidML и ROCm. Я попробовал оба и хочу поделиться результатами.

ML в реальном мире: Складская система распознавания деталей
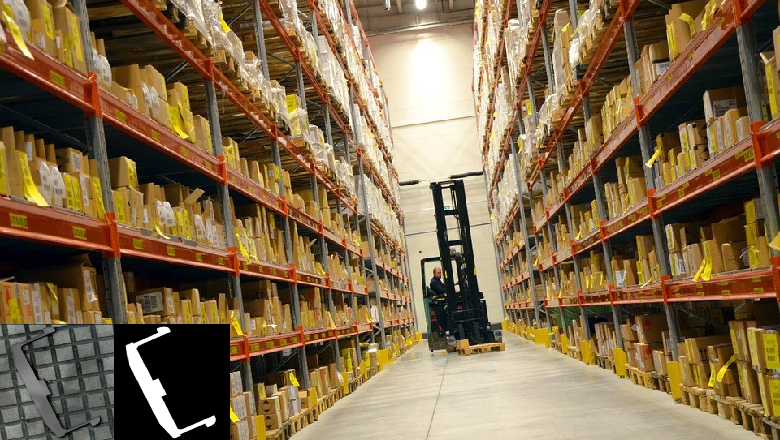
Одним из проектов над которыми мне пришлось недавно поработать, стало создание складской системы для распознавания складируемых деталей. Проблема достаточно простая для понимания: на промышленном складе кладовщики, особенно новые, при поступлении новой партии, зачастую не могут с ходу понять что за детали поступили, и куда их нужно отнести.

Настройка аутентификации JWT в новом проекте Django
Данная статья является сборкой-компиляцией нескольких (основано на первой) статей, как результат моих изучений по теме jwt аутентификации в джанге со всем вытекающим. Так и не удалось (по крайней мере в рунете) найти нормальную статью, в которой рассказывается от этапа создания проекта, startproject, прикручивание jwt аутентификации.
Миллион домашних фотографий: наводим порядок
После покупки цифрового фотоаппарата и рождения детей стало появляться большое количество фотографий, а учитывая, что жена с фотоаппаратом почти не расставалась и старалась запечатлеть все «важные» детские моменты, фотографий стало появляться ОЧЕНЬ много.