

Как Живаго ставит диагноз всей эпохе
6 мин
Аналитика
С помощью Python проверяю диагнозы доктора Живаго и пытаюсь понять, был ли Юрий Андреевич просто хороший диагност или он проверял патологию всей эпохи.
С помощью Python проверяю диагнозы доктора Живаго и пытаюсь понять, был ли Юрий Андреевич просто хороший диагност или он проверял патологию всей эпохи.

Под прошлой статьёй предложили не спрашивать модель, уверена ли она, а отдельным запросом просить перепроверить и исправить код. Я проверил одну формулировку такой просьбы и ещё пять приёмов — «ты сеньор», «думай пошагово», «меня уволят», «сначала тесты», «только код» — одинаково: 30 задач по Python, скрытые тесты, три модели, по три прогона. Ни один приём не дал обнаружимой разницы в доле прошедших тестов. Переспрос исправил 3 решения из 5 неверных — мало, чтобы делать выводы. «Сначала тесты» дало в 2,6–4,4 раза больше выходных токенов, «только код» — на 10–46 % меньше. Некоторые ошибки повторялись при разных фразах: Haiku отвергал «1h30m» в пяти вариантах из семи. Внутри таблица, тексты фраз дословно и границы того, что из этого следует.

Я делаю сайты и телеграм-ботов на заказ. Заказчики пишут «ищу, кто сделает лендинг» в профильные чаты и в ленты соцсетей, и кто ответит первым, тот обычно и получает разговор. Читать все чаты глазами я не могу, поэтому собрал робота: он читает чаты и ленты, отсеивает мусор, оценивает каждую находку нейросетью и присылает мне в личку карточку с баллом и черновиком первого ответа. Отвечаю я сам, руками. Робот никому, кроме меня, ничего не отправляет, и это правило закреплено в коде, а не в договорённости с самим собой.
Статья про устройство «трубы», по которой идёт сообщение, про учёт расходов с потолком, про три места, где было больно (зависший event loop, невалидный JSON от модели, пачка находок, которую сервер не успевал принять), и про то, что в итоге получилось по живым цифрам. Код ниже взят из рабочего проекта, лишнее я выкинул, промпты классификатора не привожу: у них своя история, к архитектуре она не относится.

15 октября Tesla показала летающий Roadster, а мы разберём не менее важное: вышел AG-UI 1.0 - мажорный релиз протокола между агентом и интерфейсом. Что в нём нового и как это выглядит на связке AG2 + CopilotKit

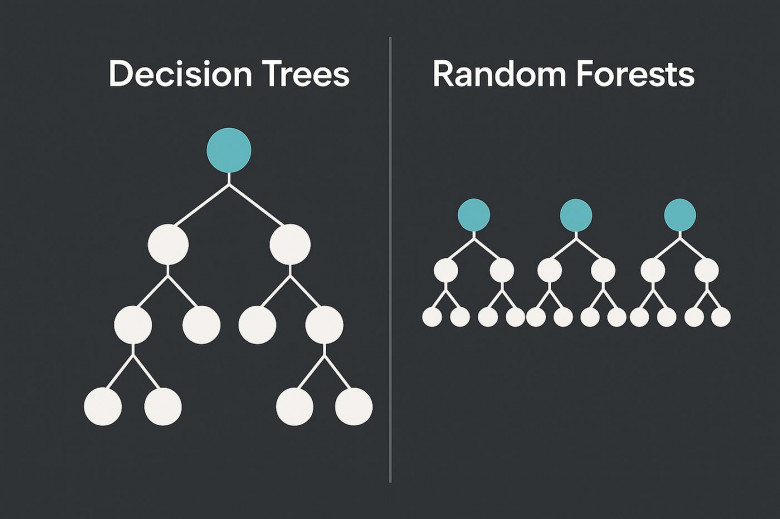
Представим обычную ситуацию: мы обучили несколько моделей, сравнили их на тестовой выборке и получили довольно странный результат. Простейшее дерево решений показывает Accuracy почти 97%, а Random Forest из 300 деревьев — всего 91,5%.

Чаще всего для ручного тестирования интеграций с RabbitMQ используют UI-клиент. Но не всегда это удобно и позволяет тестировать быстро, особенно когда очередей к функционалу привязано несколько и в каждой нужно отдельно просматривать данные об отправленных сообщениях.
В этой статье я покажу как с помощью python-скрипта можно получать все нужные сообщения из одного/нескольких exchange в отдельную тестовую очередь и просматривать данные из нее в удобном формате в консоли IDE.

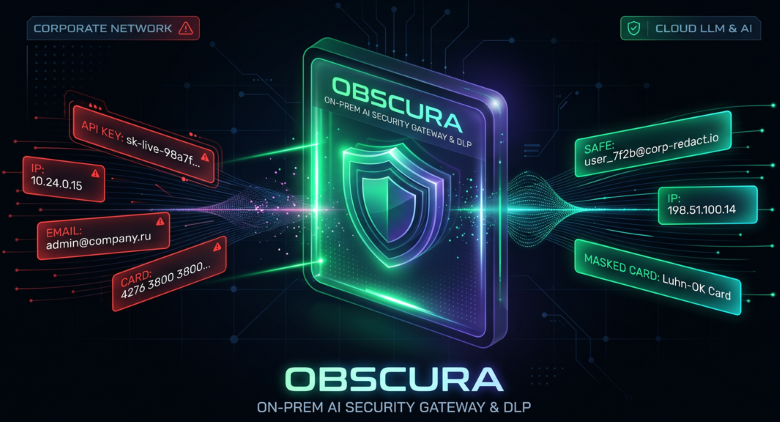
Летом я писал, что будет, если сливать рабочие данные в ChatGPT: логи SOC, конфиги Cisco и FortiGate, внутренние IP, почты сотрудников. Тогда я сделал офлайн-инструмент, который чистит конфиг руками инженера до отправки. Он решает проблему для того, кто помнит им воспользоваться. Но компания не может полагаться на то, что все всегда вспомнят.
Поэтому я сделал следующий шаг: шлюз, который стоит между человеком и нейросетью, проверяет каждый запрос и решает, что с ним делать. Называется Obscura. Он работает on-prem, данные остаются внутри сети.

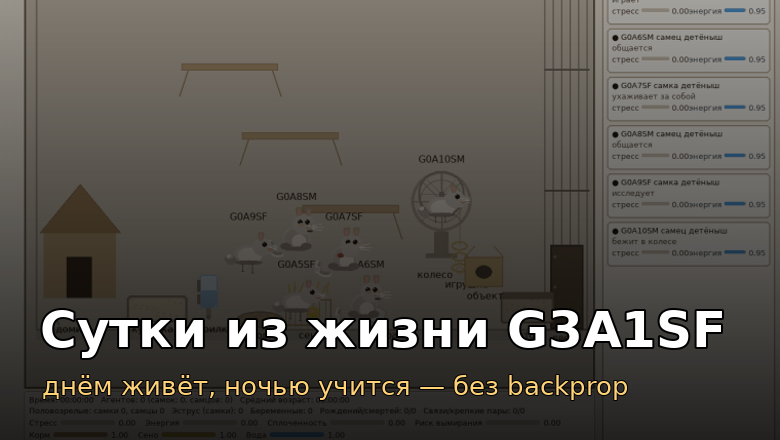
Что происходит с агентом, который не решает одну задачу, а живёт — долго, в мире, который всё время меняется? Я собрал NOWA-Cognitive, когнитивную архитектуру без backprop, без глобальной функции потерь и без языковой модели в контуре решений: днём агент записывает опыт быстро и «начерно», а долговременную память переписывает ночью, во сне. Рассказываю, как это устроено, на примере одних суток одной шиншиллы из колонии — G3A1SF.

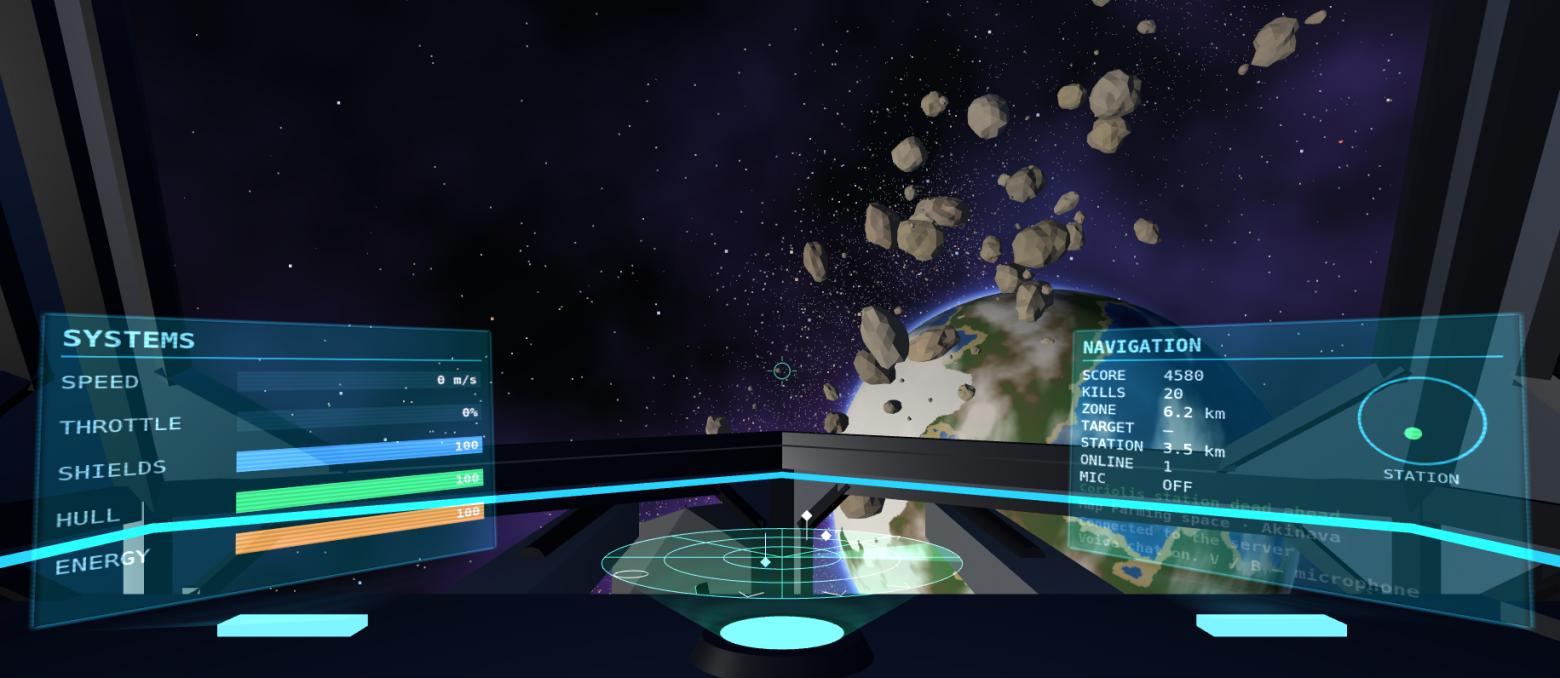
Я помню свои первые впечатления от лобби когда я впервые включил Oculus Quest. Космическая станция на орбите. За окном — вселенная. Солнечный свет отражается от стен каюты. За пределами атмосферы солнце кажется необычайно ярким. Вентиляция тихо гудит. Хотелось запрыгнуть в челнок и помчаться по просторам космоса. Но тогда я не знал о существовании подходящей игры. А может, её просто не было. Безумно хотелось летать.
Шесть лет назад появилась идея игры, которая со временем превратилась в Орбиту.

Предыстория
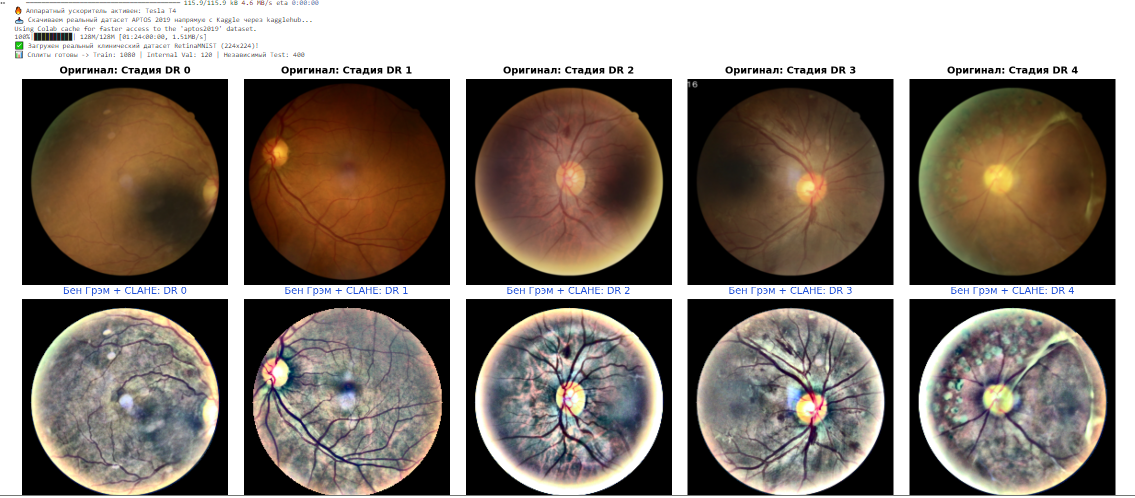
Я собрал двухпоточную модель: она смотрит на снимок глазного дна и одновременно получает клинические показатели пациента. На отложенном тесте первый запуск дал QWK 0.834. Потом я стал разбираться, за счёт чего, и оказалось, что клинические признаки в моих данных содержат ответ. Я поставил три контрольных эксперимента, в том числе обучил отдельную модель только по снимкам. У неё QWK 0.713. Ниже весь пайплайн и способы, которыми такая утечка находится.

Добрый день, дорогие читатели!
Мы с Вами просканировали основные типы активов. Можно выпустить гайды по сканированию сетевого оборудования и виртуализации, но здесь мне нечего добавить поверх официальной документации. Так что, мы переходим к большому пласту автоматизации через API, да еще и с примерами!
Все примеры кода будут на Python. Я уже давно не пишу на С++/С#. Любителей Go прошу понять и простить, за то что я не настолько модный.
Разговор про API начнем с авторизации, получения Bearer-токена и headers, которые будем использовать для каждого API-запроса.

Если вы следите, ссылается ли нейросеть на ваш сайт, полезно знать, сколько ссылка держится в ответе на один и тот же вопрос. Недолго: через полтора месяца в ответах Алисы AI и Perplexity осталось от четверти до трети прежних ссылок (27,5% у Perplexity, 35,5% у Алисы AI), а больше половины ссылок оказались новыми.
Я задал обеим нейросетям 20 вопросов одной ниши (как попасть в ответы нейросетей, сколько это стоит, где заказать). На каждый вопрос каждая нейросеть ответила пять раз: три повтора подряд за час, ещё один через 5 дней и ещё один через полтора месяца. Отчёт о том, что вы в ответе, стареет быстрее, чем кажется.

TL;DR. Мы перестали маскировать агентов под людей. Теперь они предъявляют криптографический паспорт: подпись Ed25519 по стандарту IETF RFC 9421. Холодный старт — 5 мс вместо 1744 мс. Запрос — 15,8 мс вместо 86,8 мс. Память — 0,76 МБ вместо 500 МБ. Прокси не нужны. Ниже разбираю архитектуру, канонизацию, проверку на WAF, код и методику замеров. Ограничения замеров тоже описаны честно.
Пролог: 40 гигабайт RAM ради того, чтобы притвориться бабушкой
Типичная ферма агентов в 2026 году выглядит так. Есть кластер нод, на каждой крутятся десятки Camoufox, Playwright или AdsPower. Каждый процесс съедает от 500 МБ до 1,5 ГБ памяти. Есть пул резидентских IP, за который платят по гигабайту трафика. Есть отдельный модуль, который рисует кривые Безье, чтобы курсор двигался «по-человечески». И есть дежурный инженер, который в 3 часа ночи разбирается, почему после обновления fingerprint-эвристик у WAF отвалилось 30% сессий.
Посмотрите на это как архитектор. Мы строим систему, вся ценность которой в том, чтобы лгать о своей природе. Противоположная сторона строит систему, вся ценность которой в том, чтобы ловить эту ложь. Это гонка вооружений с нулевой суммой. Обе стороны платят за железо, никто не выигрывает, а цена растёт каждый квартал.
Антидетект — не инженерное решение, а костыль, который пытается решить задачу идентификации средствами мимикрии.
Задача идентификации в распределённых системах давно решена, и решается она криптографией.

Pro-сборка была важным этапом в развитии GigaIDE: она позволила быстрее развивать профессиональные инструменты, собирать обратную связь от корпоративных пользователей и проверять сценарии, которые выходят за рамки Community-версии. Но у отдельного дистрибутива есть и обратная сторона: пользователю нужно выбирать сборку, командам — отдельно управлять установками, а продукту — поддерживать лишнюю развилку там, где её уже можно убрать.

Redis у сервиса прогнозов не было восемь недель: контейнер упал с кодом 255 и больше не поднялся. Всё это время каждый запрос считался заново, 1,9 секунды вместо 11 миллисекунд. При этом авария не была тихой. В обработчике ошибки стоит self.redis_client = None с комментарием про заглушку, но заглушки там нет, поэтому каждый вызов get и set падал с AttributeError, ловился своим же except и писал ERROR в лог. Две строки на каждый запрос, восемь недель подряд. Разбираю, почему я этого не видел, почему health сервиса всё это время отдавал вписанное в код «ok» с таймстампом из мая 2025 года, и чем аккуратно обработанный отказ отличается от обычной поломки.

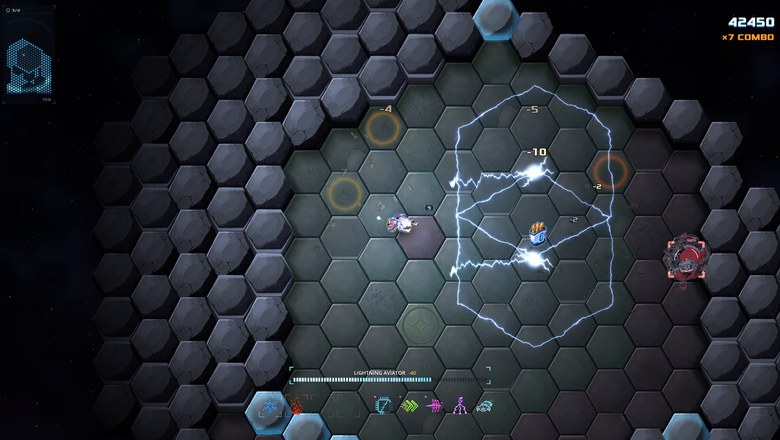
Корпус дрона игрока и боссов в нашем рогалике AsterMaster — не меш, а облако из ~6000 гауссиан, выученное по рендерам из Blender и упакованное в полмегабайта. Поэтому его можно мять, дырявить, рвать на куски и собирать обратно — целиком в вершинном шейдере Godot.
В статье: зачем Gaussian Splatting в игре, где персонаж занимает сотню пикселей; пайплайн «Blender → gsplat → свой бинарный формат → Godot Compatibility» с тренировкой за 21 секунду; запечённые каналы, энтропийная бинаризация и чистка флоатеров; деструкция — кратеры, «луковица», граф опоры и куски по материалам; и честные пост-мортемы того, что не взлетело — с цифрами.

Следуя принципу: “Работает - не трогай” и привыкнув к mypy еще очень много лет назад, я в какой-то момент собрал свой собственный конфиг линтеров и форматтеров и таскал его, то выкидывая, то добавляя что-то новое: там были flake8, isort, black, yapf, pylint, pyflakes… Но потом пришел Ruff, и всех их не стало. И только mypy пережил их всех. Надолго ли?
Посмотрев недавно на время прогона mypy в Gitlab CI, я решил обратить внимание на ty и Pyrefly как на возможную замену mypy: хотелось сократить время проверки и при этом не потерять в её качестве. Для сравнения взял два своих бэкенда, на которых mypy уже используется. Проверил время запуска с нуля и повторной проверки, а затем разобрал расхождения в диагностике.

Хотел купить звезды Telegram подешевле - в итоге разобрался, как самому их продавать.
Открыл поиск, а там звёздами торгуют все подряд. Даже МТС. Покупка одна и та же, цены разные - стало интересно, сколько можно сэкономить и что вообще делает продавец после того, как получает деньги.
Так обычный поиск дешёвых Stars превратился в разбор всей цепочки: от ввода имени получателя до платежа и подтверждения покупки. В приложенном коде можно увидеть, как эти действия автоматизированы.
Начну с цен: сравню МТС, SMMESE и ещё один сервис на одинаковом количестве звёзд, чтобы определить самый дешёвый вариант среди них. Затем покажу механику покупки через Fragment и разберу код. Если захочется пойти дальше покупки для себя - этот механизм можно взять за основу собственного сайта по продаже звёзд Telegram.
Задача была такая: есть папка с конспектами созвонов и расшифровками встреч, и искать в ней по слову неудобно: я помню, что обсуждали найм, а в файле написано «собеседование» и «кандидат». Обычный поиск по тексту такой файл не найдёт. Отправлять заметки во внешний сервис ради эмбеддингов мне не хотелось, поэтому я собрал маленький MCP-сервер, который ищет по смыслу прямо на моей машине, и подключил его к Claude Code. Всё работает без платных API, а заметки не покидают компьютер.
В статье разберу, как устроен движок и сервер, и три места, на которых легко споткнуться: молчаливое обрезание текста моделью, лишний вывод в стандартный поток, из-за которого ломается протокол, и проверка пути в инструменте чтения. Отдельно покажу кэш, который сам понимает, что устарел. Код ниже взят из рабочих файлов, лишнее я убрал.


В предыдущей части статьи были рассмотрены принципы и механизмы работы PHY-уровня радиолюбительского OFDM-протокола, а также алгоритмы кодирования и декодирования данных. В этой статье рассматриваются принципы построения уровней управления доступом к среде (MAC) и управления логическим каналом (LLC), реализующих полудуплексное сетевое соединение между двумя трансиверами, а также анализируются возникшие при реализации и методы их решения.