Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

105,45
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Книга «SQL: быстрое погружение»

Время на прочтение6 мин
Охват и читатели30K
image Привет, Хаброжители! Что общего между самыми востребованными профессиями и стремительным увеличением количества информации в мире? Ответ: язык структурированных запросов (SQL). SQL – рабочая лошадка среди языков программирования, основа основ для современного анализа и управления данными. Книга «SQL: быстрое погружение» идеальна для всех, кто ищет новые перспективы карьерного роста; для разработчиков, которые хотят расширить свои навыки и знания в программировании; для любого человека, даже без опыта, кто хочет воспользоваться возможностями будущего, в котором будут править данные.
Читать дальше →

Введение в dbt шаг за шагом

Время на прочтение11 мин
Охват и читатели42K

Привет, Хабр!

Меня зовут Марк Порошин, в DV Group я занимаюсь Data Science. Мы работаем с большим количеством данных, на данный момент приближаемся к 10тб данных на нашем кластере Greenplum. Источники данных постоянно дополняются, а их структура меняется, поэтому в качестве методологии построения хранилища мы выбрали DataVault. Для автоматизации трансформации данных решили использовать dbt, о котором я хочу рассказать в данной статье.

Читать далее

Как мы мигрировали критичную БД с Oracle в CockroachDB

Время на прочтение6 мин
Охват и читатели11K

… простите, мигрировали куда? Туда!


CockroachDB — PostgreSQL-совместимая (по SQL-синтаксису DML) распределенная СУБД с открытым кодом (ну, почти). Ее название символизирует, что она, как таракан, выживает в любых экстремальных ситуациях. Лично мне крайне импонирует такая СУБД с привычным SQL-интерфейсом, настройка которой занимает 5 минут, которая хранит данные — как Kafka — на нескольких узлах в нескольких ЦОДах сразу, имеет настраиваемый replication factor на уровне конкретных таблиц, легко переживает потерю как одного узла, так и целого ЦОДа, использует для этого механизм распределенного консенсуса Raft и при этом еще и имеет строгую консистентность и уровень изоляции serializable. Разработчики CockroachDB — выходцы из компании Google, которые решили коммерциализировать архитектуру распределенной СУБД Spanner.


Недостатки тоже есть, не переживайте, но про них лучше в другой раз :)

Почему именно CockroachDB?


Среди распределенных SQL-СУБД есть альтернативы в виде Yugabyte и TiDB, и с прошлого месяца YDB. Вопрос «Почему?» связан в первую очередь с тем, зачем вообще нужна БД. Как мне кажется, БД нужна для того, чтобы надежно хранить данные и доставать их через стандартный язык SQL, а удобство ее использования — приятный, но вторичный фактор. Тут надо заметить, что я почти 9 лет проработал в техподдержке Oracle, и видел достаточно случаев порчи БД, как из-за дисковых сбоев и ошибок администраторов, так и из-за багов в приложении и даже в коде самой СУБД.

Ключевыми критериями выбора были:
Читать дальше →

.NET 6 и провайдеры баз данных

Время на прочтение18 мин
Охват и читатели15K

Все материалы, которые будут показываться в ходе данной статьи будут доступны по данной ссылке https://github.com/vliashko/CommunicationWithDB. Вполне возможно, что со временем данный репозиторий будет обновляться, или, некоторые захотят сами принять участие в его развитии.

Можно ли сегодня представить разработку, будь то десктопы или веб, без использования баз?

Ну, чисто в теории можно, есть еще старенькие проекты, использующие файловую систему, идею которых можно еще увидеть в университетских лабораторных по сей день.

В чем же так плоха файловая система? Ну на самом деле, говоря на своем опыте, можно выделить следующие пункты:

1. Блокировка файла, в который идет запись

2. Отсутствие специализированных программ для работы с файлами (аналог СУБД)

Да, в какой-то мере можно выделить еще минусы, или попытаться закрыть уже названные мной. Но в целом главная идея базы данных – это удобство для чтения данных, а также наличие огромного числа инструментов для работы с данными (возможность быстрого поиска по полям таблицы, соединение таблиц, группировка записей, индексирование и т.д.)

Будем считать, что я смог в какой-то мере убедить, или хотя бы заинтриговать тем, что базы – это крутой механизм, который надо знать и уметь использовать.

Тогда давайте рассмотрим как пользоваться базами данных на платформе .NET с использованием языка C#.

Читать полностью

MS SQL 2022 killer feature

Время на прочтение2 мин
Охват и читатели8.7K

В совсем раннем превью MS SQL мне вежливо отказали. И вот, наконец вышел публичный evaluation релиз! Давайте посмотрим, как MS SQL отнесется к самому неприятному - values with irregular selectivity. У меня про это даже была статья.

Читать далее

Построение DWH на основе Greenplum

Время на прочтение11 мин
Охват и читатели25K

DBA в Southbridge Иван Чувашов подготовил статью о построении DWH на основе Greenplum. Слово Ивану.  

Привет, Хабр! Я администратор баз данных с 15-летним опытом. Сегодня хочу рассказать про Data Warehouse на основе Greenplum — как они устроены, как их поднимать и с какими проблемами и нюансами я лично сталкивался в своей практике.

Читать про Greenplum

«Ленивый сахар» PostgreSQL

Время на прочтение7 мин
Охват и читатели72K

SQL - декларативный язык - то есть вы описываете "что" хотите получить, а СУБД сама решает, "как" именно она будет это делать. Некоторые из них при этом позволяют им "подсказывать", как именно лучше выполнять запрос, но PostgreSQL - нет.

Тем не менее, "синтаксический сахар" некоторых языковых конструкций позволяет не только писать меньше кода (учите матчасть!), но и добиться, что ваша база будет делать часть вычислений "лениво", только при фактической необходимости.

Читать далее

ORM — отвратительный анти-паттерн

Время на прочтение10 мин
Охват и читатели121K

От автора перевода: Написанный далее текст может не совпадать с мнением автора перевода. Все высказывания идут от лица оригинального автора, просьба воздержаться от неоправданных минусов. Оригинальная статья выпущена в 2014 году, поэтому некоторые фрагменты кода могут быть устаревшими или "нежелаемыми".

Содержание статьи:

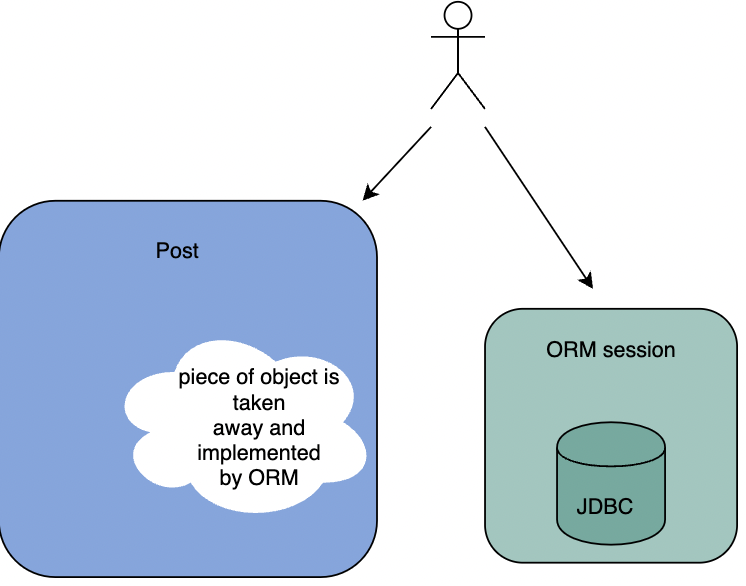
В статье приведены доводы, которые ставят под вопрос правильность присутствия ORM в рамках ООП.

Читать далее

Do it yourself: JIT компиляция SQL в Tarantool

Время на прочтение6 мин
Охват и читатели3.3K

Привет, Хабр! Меня зовут Георгий Лебедев, я работаю в команде разработки ядра Tarantool. В 2021 году мы впервые участвовали в Google Summer of Code (GSoC): одним из предложенных студентам проектов была миграция SQL с VDBE на JIT-платформу — с неё и начался мой путь в Tarantool.

Имея за плечами год учебных проектов по разработке различных компонент toolchain’а и вооружившись поддержкой менторов (Никиты Петтика, Тимура Сафина и Игоря Мункина), я взялся за этот проект. Создавая летом, фактически с нуля, платформу для JIT- компиляции SQL- запросов в Tarantool, я наступил на некоторые грабли и приобрёл, на мой взгляд, интересный опыт и знания, которыми хочу поделиться. Статья будет, в первую очередь, интересна тем, кто захочет дальше развивать этот проект, а также тем, кто рассматривает возможность внедрения JIT-компиляции в свой собственный SQL.

Читать далее

Автоматическое масштабирование БД в Kubernetes для MongoDB, MySQL и PostgreSQL

Время на прочтение7 мин
Охват и читатели6.9K

Стремясь к повышению производительности базы данных, вы можете столкнуться с ситуацией, когда оптимизации и настройки уже недостаточно. Если вы не можете заменить движок БД, а для настройки параметры рабочей нагрузки больше нет возможностей — базу данных придется масштабировать. Делать это руками долго и нецелесообразно, но и у автоматизации процессов масштабирования есть свои подводные камни.

Это перевод статьи Дмитрия Костика и Миколы Моржан из Percona. С их помощью посмотрим, в какой степени можно автоматизировать горизонтальное масштабирование баз данных MongoDB, MySQL и PostgreSQL в Kubernetes и как это сделать?

Читать далее

Ускоряем dplyr: бекенды dtplyr, multidplyr и dbplyr (видео урок + конспект)

Время на прочтение6 мин
Охват и читатели1.4K

dplyr один из наиболее популярных пакетов для языка R, основным преимуществом которого является удобочитаемый и понятный синтаксис. Из недостатков данного пакета можно отметить, что при работе с данными большого объёма он значительно уступает в скорости вычислений например data.table.

В этом видео уроке мы разберёмся с тем, как можно ускорить вычисления на dplyr, за счёт бекендов dtplyr и multidplyr, а так же узнаем о том, как и зачем можно использовать бекенд dbplyr, предназначенный для работы с базами данных.

Читать далее

Oracle. Ещё один способ партиционирования больших и нагруженных таблиц

Время на прочтение7 мин
Охват и читатели30K

Всем привет! Меня зовут Ольга и я разработчик в Ингосстрахе. В этой статье-туториале хочу поделиться способом партиционирования оооочень большой таблицы в Oracle 12c. Итак, погнали.

В жизни любой давно функционирующей системы наступает момент, когда уже невозможно хранить все исторические данные без разбору и пора думать, что это надо как-то поделить. Старое отправить на архивный или отчетный сервер, а оперативный слой существенно проредить. И самый очевидный и распространенный путь – партиционировать таблицу, а старые секции перенести на другое хранилище.

Читать далее

Геймификация обучения в IT

Время на прочтение2 мин
Охват и читатели12K

Геймификация — это процесс использования игровых элементов в неигровом контексте. Он имеет много преимуществ по сравнению с традиционными подходами к обучению, в том числе:

Читать далее

Ближайшие события

PostgreSQL Antipatterns: когда мешает внешний ключ

Время на прочтение4 мин
Охват и читатели24K

Внешние ключи (foreign keys) - мощный и удобный механизм контроля логической целостности данных в базе. Но он бывает не только лишь полезен, и может неплохо пригрузить вашу БД.

Внимательный взгляд на план запроса поможет избежать многих проблем - как при чтении из базы, так и при вставке в нее.

Читать далее

Оптимизация высоконагруженных конфигураций: от “всё пропало, мы все умрем” до комфортной работы без страха за жизнь

Время на прочтение5 мин
Охват и читатели3.5K

Оптимизация высоконагруженных конфигураций: от “всё пропало, мы все умрем” до комфортной работы без страха за жизнь

Оптимизация высоконагруженных конфигураций

Как рисовать с помощью SQL?

Время на прочтение4 мин
Охват и читатели28K

Видимо я сделала какое-то очень плохое зло, поэтому живу во время перемен. Справиться с эмоциями и повысить конкурентоспособность на рынке Data Enigneer’ов мне помогает сайт Hackerrank. На пути к решению вообще всех задач по SQL с этого сайта мне попалась задачка на нетривиальные запросы.

В задачке требовалось звёздочками нарисовать прямоугольный треугольник...

Порисуем с помощью SQL

Как изучить SQL за ночь или шпаргалка для системного аналитика

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели224K

Помните, как вы были студентами, и готовились к экзаменам по ночам?

Предлагаю вашему вниманию простую шпаргалку по SQL с теорией и практикой, которой вы сможете воспользоваться в любое время.

Изучите теорию на примерах и закрепите на 13 практических задачах по SQL.

Читать далее

PostgreSQL Antipatterns: в этом плане кто-то лишний

Время на прочтение3 мин
Охват и читатели8.1K

Сегодня будет рассказ про избыточные группировки и сортировки в SQL-запросах - как они возникают, по каким признакам их можно потом вычислить и как избавиться от них.

Читать далее

Оконные функции SQL простым языком с примерами

Время на прочтение4 мин
Охват и читатели928K

Привет всем!

Сразу хочется отметить, что данная статья написана исключительно для людей, начинающих свое путь в изучении SQL и оконных функций. Здесь могут быть не разобраны сложные применения функций и могут не использоваться сложные формулировки определений - все написано максимально простым языком для базового понимания. 

P.S. Если автор что-то не разобрал и не написал, значит он посчитал это не обязательным в рамках этой статьи))) 

Для примеров будем использовать небольшую таблицу, которая показывает оценки учеников по разным предметам. В БД табличка выглядит следующим образом

Читать далее

Любопытные и неочевидные особенности при работе со Snowflake

Время на прочтение5 мин
Охват и читатели6.4K

Без долгих вступлений, сразу к делу.

Знаете ли вы, что в Snowflake можно создавать объекты с пустыми именами? Например: CREATE DATABASE ""; CREATE SCHEMA ""."";

Это работает на момент публикации и потенциально создаёт массу проблем для внешних систем, которые не ожидают такого поворота. Также это обычно приводит в восторг админов DWH.

Более интересные и практичные советы под катом.

Читать далее