Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

106,35
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Self-hosted EXPLAIN: наглядно и безопасно

Время на прочтение2 мин
Охват и читатели9.6K

С момента первой же хабрапубликации о возможностях нашего сервиса визуализации планов запросов PostgreSQL explain.tensor.ru (а было это уже больше 2 лет назад) пользователи задавали резонный вопрос: "Все у вас круто, но у нас в запросах и планах есть коммерческая инфа, которую отправлять куда-то наружу низзя... Можно как-то ваш сервис развернуть на своей площадке?"

Ну, а почему бы и нет, подумали мы - тем более, некоторые пользователи уже интересовались возможностью интеграции нашего сервиса в свои системы.

Читать далее

Перенос данных с Oracle на PostgreSQL: основные этапы, несовпадающие типы и форматы данных

Время на прочтение10 мин
Охват и читатели38K

В настоящее время тема миграции с СУБД Oracle на СУБД PostgreSQL (и разработанную на её основе СУБД Postgres Pro) является очень актуальной. В этой области у команды Postgres Professional накоплен многолетний опыт, которым мы решили поделиться. На основе наших материалов для внутреннего обучения мы подготовили серию статей для Хабра о миграции данных в PostgreSQL из «оракловой» базы.

Также на близкие темы можно посмотреть следующие доклады и мастер-классы.

Читать далее

Пишем на Rust расширение для SQLite, чтобы научить его работать с файлами Excel

Время на прочтение11 мин
Охват и читатели8.2K

В этой статье я расскажу как на Rust написать расширение для SQLite. В частности мы поговорим о том, что такое виртуальные таблицы, и как мы можем их реализовать на Rust.

К концу статьи у нас должно получиться расширение, которое можно динамически загрузить в SQLite. И хотя, данная статья не претендует на звание полного руководства по написанию плагинов для SQLite, автор надеется, что у читателя появится общее понимание принципов работы расширений.

Исходный код на GitHub

Читать далее

SQL HowTo: наперегонки со временем

Время на прочтение2 мин
Охват и читатели13K

В PostgreSQL несложно написать запрос, который уйдет в глубокую рекурсию или просто будет выполняться гораздо дольше, чем нам хотелось бы. Как от этого защититься?

А чтобы еще и полезную работу сделать? Например, набрать следующий сегмент данных при постраничной навигации со сложным условием фильтрации.

Читать далее

Вакцинирование продом

Время на прочтение18 мин
Охват и читатели10K

Всякий джун в процессе своего становления кладет прод. Выглядит это по-разному: от полной остановки работы компании, заканчивая аномальным всплеском на дашбордах мониторинга.

В статье покажу ряд простых и очевидных подходов разработчиков Oracle, помогающих уменьшить цену ошибки на проде. Проверено на себе :-)

Читать далее

Синхронизируем приложения с помощью Advisory Locks (postgresql). Что это, зачем, и нюансы работы с pgBouncer

Время на прочтение4 мин
Охват и читатели29K


В современном мире у одного бекенд-приложения обычно запущено больше одного экземпляра, хотя бы из соображений надёжности. А это значит, что для синхронизации их действий надо что-то придумывать, какое-то внешнее решение: мьютексов или, к примеру, гошных каналов внутри приложения уже недостаточно.


К счастью, во многих случаях в проекте уже есть какая-нибудь база данных, которую можно использовать для этих целей. СУБД сама управляет блокировками, и многие проблемы решаются сами, "под капотом". Например, если два инстанса попытаются обновить одну и ту же строку в таблице, то эта строка не превратится в кашу. СУБД автоматически возьмет нужный лок, и тот, кто пришёл вторым, просто будет ждать, пока этот лок не будет снят.


Проблема в том, что такая автоматика с принудительными локами подходит не для всех случаев. Например, вы массово обрабатываете файлы, предполагая, что никакой файл не будет обрабатываться одновременно двумя приложениями сразу, но при этом не хотите создавать для синхронизации полноценную таблицу в БД. В проектах Каруны такие задачи возникают довольно регулярно.


Для решения подобных проблем в PostgreSQL есть так называемые необязательные блокировки (advisory locks), т.е. локи, которые берутся, исходя из логики приложения, а не автоматики хранения/выдачи данных в БД.

Читать дальше →

Как сделать таск-трекер под себя на low-code конструкторе

Время на прочтение22 мин
Охват и читатели15K

Типовые таск-менеджеры отлично подходят для конкретных ситуаций, но чаще всего их не получится настроить под свои нужды. Джира медленная, дорогая и часто слишком сложная, trello слишком простой, а персональные таск менеджеры не дают нужного взаимодействия с командой.

Читать далее

PostgreSQL Antipatterns: куда крутить NULLS

Время на прочтение2 мин
Охват и читатели7.9K

Периодически приходится разбирать случаи внезапного промаха запроса мимо "вроде бы подходящего" индекса - а все дело оказывается в чуть-чуть не той сортировке.

Читать далее

Пейджинг страниц в соцсетях

Время на прочтение4 мин
Охват и читатели9K

Для пагинации страниц используют смещение (OFFSET) и курсорную пагинацию (по ID), как более быструю. Тем не менее есть ещё один малоизвестный вид пагинации по меткам страниц (MARKS). Она является разновидностью курсорной пагинации, но использует не идентификатор, а ряд полей перечисленных в ORDER BY SQL-запроса.

Читать далее

Decorrelating Subqueries

Время на прочтение5 мин
Охват и читатели2.5K

По материалам статьи Craig Freedman: Decorrelating Subqueries

В статье про скалярные подзапросы было несколько примеров, в которых оптимизатор мог переписать запрос с коррелированным подзапросом как запрос с соединением. Например, можно было видеть, как представленный ниже простой подзапрос с «in»:

Читать далее

SQL HowTo: обход дерева иерархии «по курсору» через двойную рекурсию

Время на прочтение3 мин
Охват и читатели12K

В предыдущих статьях "PostgreSQL Antipatterns: навигация по реестру", "PostgreSQL 13: happy pagination WITH TIES" и "SQL HowTo: курсорный пейджинг с неподходящей сортировкой" я уже рассматривал проблемы навигации по данным, представленных в виде плоского реестра.

Но что если мы хотим выводить данные не простым "бесконечным списком", а в виде иерархической структуры с быстрой навигацией по узлам - например, обширный каталог товаров или меню ресторана, как это делает Presto - наш продукт для автоматизации заведений питания? Вот тут нам и придется что-то поизобретать...

Читать далее

Альтернативные методы организации и создания файловых информационных ресурсов

Время на прочтение8 мин
Охват и читатели7.4K

Ранее разработки в данном направлении уже велись, и в результате проделанной работы был создан продукт в виде десктопного приложения. К сожалению, он не получил широкого применения, так как использовался узким кругом сотрудников в довольно ограниченной сфере деятельности.

Приложение было разработано на языке программирования Visual Basic 6.0. Для описания содержимого файлов использовалось хранилище, реализованное на SQL server с типом данных varbinary(max).

Читать далее

Технология SQL-файл, препроцессор для T-SQL, “бок-о-бок” файлы и др

Время на прочтение20 мин
Охват и читатели5.9K

Завершив в недавнем прошлом очередную доработку своей легковесной технологии SQL-файл, применяемой для эффективной трансляции файлового SQL-кода в базу данных, автор данной статьи решил в очередной раз представить (в этой заметке теперь, на популярном ресурсе) свои реализованные, хотя бы отчасти, идеи касательно программирования MSSQL, а также некоторые соображения относительно применения SQL вообще. Автор полагает, что несмотря на форму предлагаемой им частной реализации SQL-файл (для MSSQL), лежащая в основе подхода концепция имеет определённую силу и смысл.

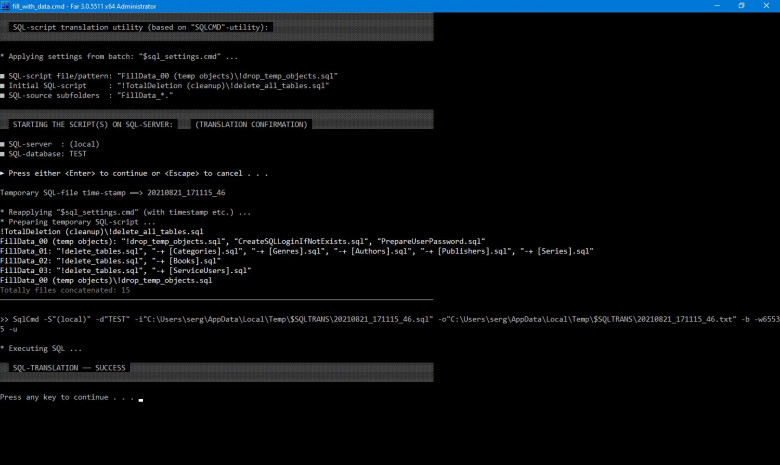
Выше на картинке: SQL-трансляция исходных файлов из нескольких директорий (скрипты *.sql), запуск fill_with_data.cmd

Читать далее

Ближайшие события

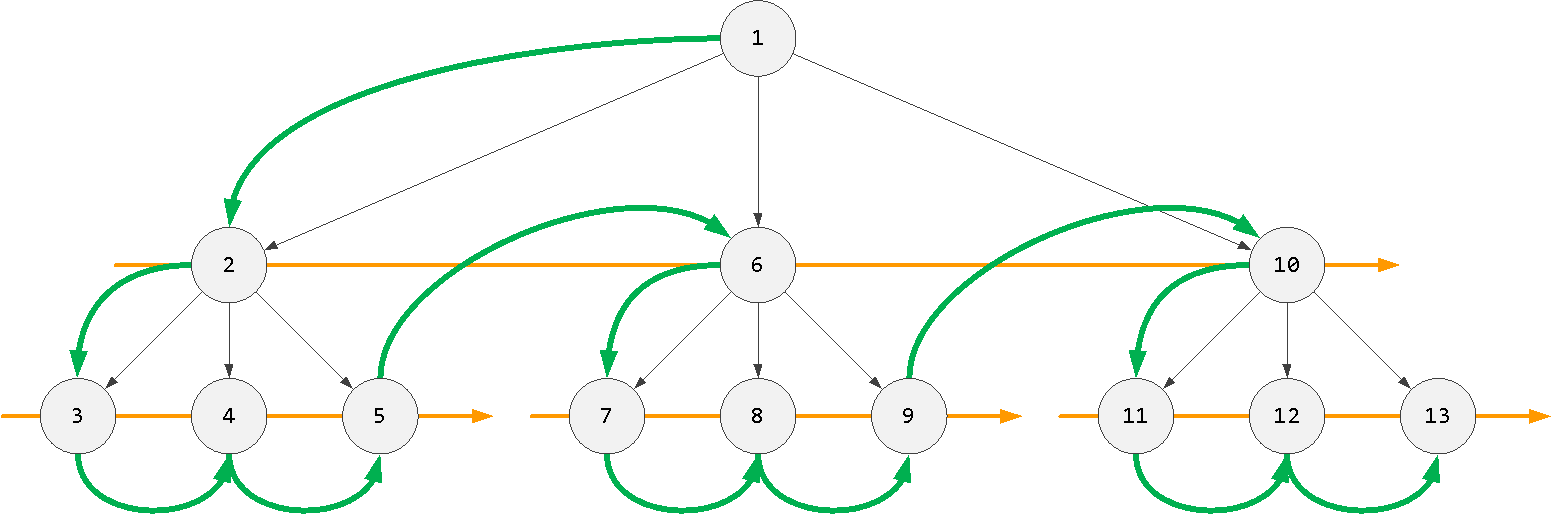
Обзор паттернов хранения деревьев в реляционных БД

Время на прочтение4 мин
Охват и читатели18K

Всем привет! Меня зовут Пантелеев Александр и я бекенд разработчик в компании Bimeister. Постараюсь описать исчерпывающе, кратко и понятно суть основных паттернов хранения деревьев в реляционных базах данных. Надеюсь, что статья будет полезна тем, кто до сего момента не сталкивался с такими паттернами, и станет отправной точкой в их понимании.

Читать далее

DataVault на Greenplum с помощью DBT

Время на прочтение12 мин
Охват и читатели16K

Привет, Хабр!

Меня зовут Марк Порошин, я занимаюсь DataScience в DV Group. Недавно я уже рассказывал про то, как начать трансформировать данные с помощью dbt. Сегодня я решил поделиться, как мы в DV Group поженили dbt, Greenplum и DataVault, собрали все грабли, что могли; немного поконтрибьютили в open-source, но по итогу остались очень довольны результатом.

Расскажу сначала пару слов о том, что такое DataVault. DataVault - методология построения хранилища, предполагающая высокую нормализацию данных (3ая нормальная форма). Основными ее компонентами являются:

Читать далее

Автогенерация ETL-кода

Время на прочтение16 мин
Охват и читатели4.1K

С развитием информационных технологий у их пользователей все сильнее и сильнее появляется желание автоматизации рутинных операций, в том числе и автоматической генерации кода. Где это уже возможно?

Я расскажу об автоматической генерации ETL-кода, которая реализована в Сбере на примере одной из использующихся платформ. Поток трансформаций данных в нашем решении называется графом. Этот граф является ориентированным ациклическим графом (DAG, directed acyclic graph). Автоматическую генерацию графов оказалось возможно реализовать благодаря наличию специального инструмента spec-to-graph, который как раз для этого и предназначен. Он позволяет формировать трансформации графа согласно написанному коду, служащему шаблоном. В этом шаблоне указывается, какие трансформации с какими параметрами следует использовать и в каком порядке нужно их соединить. Мы используем подход по генерации графов из базовых субграфов (стандартизированных маленьких графов). Т.е. мы разбиваем ETL-процесс на элементарные операции, каждую из которых реализует некоторый базовый субграф. А из субграфов формируется итоговый граф, осуществляющий загрузку данных. Данные мы грузим из Hive в Hive, дополнительно используя промежуточные индексные структуры в HBase.

Читать далее

Книга «SQL: быстрое погружение»

Время на прочтение6 мин
Охват и читатели30K
image Привет, Хаброжители! Что общего между самыми востребованными профессиями и стремительным увеличением количества информации в мире? Ответ: язык структурированных запросов (SQL). SQL – рабочая лошадка среди языков программирования, основа основ для современного анализа и управления данными. Книга «SQL: быстрое погружение» идеальна для всех, кто ищет новые перспективы карьерного роста; для разработчиков, которые хотят расширить свои навыки и знания в программировании; для любого человека, даже без опыта, кто хочет воспользоваться возможностями будущего, в котором будут править данные.
Читать дальше →

Введение в dbt шаг за шагом

Время на прочтение11 мин
Охват и читатели42K

Привет, Хабр!

Меня зовут Марк Порошин, в DV Group я занимаюсь Data Science. Мы работаем с большим количеством данных, на данный момент приближаемся к 10тб данных на нашем кластере Greenplum. Источники данных постоянно дополняются, а их структура меняется, поэтому в качестве методологии построения хранилища мы выбрали DataVault. Для автоматизации трансформации данных решили использовать dbt, о котором я хочу рассказать в данной статье.

Читать далее

Как мы мигрировали критичную БД с Oracle в CockroachDB

Время на прочтение6 мин
Охват и читатели11K

… простите, мигрировали куда? Туда!


CockroachDB — PostgreSQL-совместимая (по SQL-синтаксису DML) распределенная СУБД с открытым кодом (ну, почти). Ее название символизирует, что она, как таракан, выживает в любых экстремальных ситуациях. Лично мне крайне импонирует такая СУБД с привычным SQL-интерфейсом, настройка которой занимает 5 минут, которая хранит данные — как Kafka — на нескольких узлах в нескольких ЦОДах сразу, имеет настраиваемый replication factor на уровне конкретных таблиц, легко переживает потерю как одного узла, так и целого ЦОДа, использует для этого механизм распределенного консенсуса Raft и при этом еще и имеет строгую консистентность и уровень изоляции serializable. Разработчики CockroachDB — выходцы из компании Google, которые решили коммерциализировать архитектуру распределенной СУБД Spanner.


Недостатки тоже есть, не переживайте, но про них лучше в другой раз :)

Почему именно CockroachDB?


Среди распределенных SQL-СУБД есть альтернативы в виде Yugabyte и TiDB, и с прошлого месяца YDB. Вопрос «Почему?» связан в первую очередь с тем, зачем вообще нужна БД. Как мне кажется, БД нужна для того, чтобы надежно хранить данные и доставать их через стандартный язык SQL, а удобство ее использования — приятный, но вторичный фактор. Тут надо заметить, что я почти 9 лет проработал в техподдержке Oracle, и видел достаточно случаев порчи БД, как из-за дисковых сбоев и ошибок администраторов, так и из-за багов в приложении и даже в коде самой СУБД.

Ключевыми критериями выбора были:
Читать дальше →

.NET 6 и провайдеры баз данных

Время на прочтение18 мин
Охват и читатели15K

Все материалы, которые будут показываться в ходе данной статьи будут доступны по данной ссылке https://github.com/vliashko/CommunicationWithDB. Вполне возможно, что со временем данный репозиторий будет обновляться, или, некоторые захотят сами принять участие в его развитии.

Можно ли сегодня представить разработку, будь то десктопы или веб, без использования баз?

Ну, чисто в теории можно, есть еще старенькие проекты, использующие файловую систему, идею которых можно еще увидеть в университетских лабораторных по сей день.

В чем же так плоха файловая система? Ну на самом деле, говоря на своем опыте, можно выделить следующие пункты:

1. Блокировка файла, в который идет запись

2. Отсутствие специализированных программ для работы с файлами (аналог СУБД)

Да, в какой-то мере можно выделить еще минусы, или попытаться закрыть уже названные мной. Но в целом главная идея базы данных – это удобство для чтения данных, а также наличие огромного числа инструментов для работы с данными (возможность быстрого поиска по полям таблицы, соединение таблиц, группировка записей, индексирование и т.д.)

Будем считать, что я смог в какой-то мере убедить, или хотя бы заинтриговать тем, что базы – это крутой механизм, который надо знать и уметь использовать.

Тогда давайте рассмотрим как пользоваться базами данных на платформе .NET с использованием языка C#.

Читать полностью