Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

106,8
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как устроена виртуальная машина SQLite

Время на прочтение10 мин
Охват и читатели19K

SQL — концептуально странный язык. Вы пишете ваше приложение на одном языке, скажем, на JavaScript, а затем направляете базе данных команды, написанные на совершенно другом языке — SQL. После этого база данных компилирует и оптимизирует эту команду на SQL, выполняет её и возвращает вам данные. Такой метод кажется ужасно неэффективным, но, всё-таки, ваше приложение может проделывать сотни таких операций в секунду. Просто безумие!

Но на самом деле всё ещё страннее.

Читать далее

Введение в базы данных

Время на прочтение7 мин
Охват и читатели78K

Я решила написать эту статью, потому что именно такой статьи мне очень не хватало несколько лет назад, когда я только начала карьеру в аналитике данных. Тогда я часто слышала слова «база данных», «реляционная база», «primary key», примерно понимала, что они означают, но единую картину в голове у меня сложить не получалось.

Читать далее

Поваренная книга миграции данных между БД или как перенести данные из одной БД в другую с минимальной болью V1.1

Время на прочтение12 мин
Охват и читатели36K

Одно я могу сказать точно: миграция данных между двумя БД - это одна из, если не самая сложная часть при смене СУБД или схемы базы данных. И что-то мне подсказывает, что Вы не фанат громоздких, чрезвычайно трудно отлаживаемых, SQL конструкций.

Читать далее

Магия квантового превосходства

Время на прочтение2 мин
Охват и читатели1.8K

По белой книге Адаптация Алексеев Денис делается последнее поколение приставок RyBox. С Романом Душкиным мы работаем над тем, что мы обретём Сильное Бессмертие благодаря внедрению Метода тотального контроля (МТК -8) отличающийся от МТК 6 и 7 наличием показателя УЦД(уникальность цифрового двойника).
Метод тотального контроля (МТК6):

I. Наблюдение как система выполняет операции

II. Тестирование и постоянное обновление

III.Определение тенденций развития

IV.Детальный анализ данных на выходе

V. Написание отчёта о результатах

VI.Завершающий диалог с системой

VII. Тестирование

(МТК ЭиО)

Анализ теста Сотрудника

Обновление ИОТ/(база знаний)

Определение тенденций развития Руководителем

Детальный анализ Ментором работы Сотрудника

Написание отчёта о результатах

Завершающий диалог с Сотрудником

Тестирование подготовки Сотрудника Отделом Качества

Э- эксперт
О- обучающийся
ИОТ - индивидуальная образовательная траектория

И так резюмируем какие МТК кого контролируют
Метод Тотального Контроля 6 - Роботы
Метод Тотального Контроля 7 - Люди
Метод Тотального Контроля 8 - Цифровые Двойники
Метод Тотального Контроля 9 - Клоны
Благодаря Клонам мы приближаемся к Сильному бессмертию

МТК Х - волшебники.

Читать дальше

Миграция кода с Oracle на PostgreSQL: особенности и пути обхода, средства конвертации, вспомогательные модули

Время на прочтение17 мин
Охват и читатели22K

Эта статья завершает цикл о миграции с СУБД Oracle на СУБД PostgreSQL. В первых двух статьях рассматривались проблемы и устоявшиеся способы переноса данных из одной СУБД в другую (часть 1, часть 2). В третьей статье была представлена часть особенностей, которые нужно учесть при переводе хранимого кода с PL/SQL на PL/pgSQL. В сегодняшнем материале рассматривается оставшаяся часть особенностей, адаптация и конвертация кода, включая выбор средств для конвертации.

Глобальные структуры данных уровня пакета

Для таких структур рекомендуется использовать модуль pg_variables. Он позволяет сохранять как скалярные значения, так и множество записей, массивы

При этом нужно понимать, требуется ли собирать статистику для планировщика. Если да, то придётся пользоваться временными таблицами. По возможности, их лучше не использовать слишком интенсивно. Создание и удаление временных таблиц ведёт к изменениям в системном каталоге и сообщениям об инвалидации. Может возникнуть ситуация, когда серверным процессам для своей работы придётся многократно перечитывать системный каталог.

Пример: у одного клиента процессы Postgres тратили большое количество времени на планирование запросов, поскольку они многократно пытались прочитать данные pg_statistic и pg_class и при этом взять соответствующие блокировки на самые распространённые объекты. Соответственно, от создания и удаления временных таблиц на каждую транзакцию пришлось отказаться.

pg_variables можно использовать на реплике – работа с модулем не приводит к изменениям в системном каталоге. Временные таблицы использовать не получится, поскольку реплика не позволяет делать изменения в словаре данных.

Читать далее

Работа с хранимым кодом приложения при миграции с Oracle на PostgreSQL: особенности, сложности и способы их преодоления

Время на прочтение13 мин
Охват и читатели9.4K

В предыдущих статьях о миграции с Oracle на Postgres мы рассматривали перенос данных из одной системы управления базами данных в другую (часть 1, часть 2). Сегодня разговор пойдёт об особенностях работы с кодом приложения при необходимости смены СУБД. В частности, будут рассмотрены следующие вопросы:

Читать далее

Materialized Path – создаём своё первое дерево

Время на прочтение18 мин
Охват и читатели11K

Всем привет! Меня зовут Хусрав, я бэкенд разработчик в компании Bimeister.

В этой статье я бы хотел бы поговорить о способе поиска родительских и дочерних элементов структуры посредством PostgreSQL Materialized Path.

Статья является вводной и рассчитана на людей, незнакомых с темой.

Читать далее

Введение в DbChange JUnit расширение

Время на прочтение18 мин
Охват и читатели5.9K

Простой и декларативный способ выполнять SQL запросы в JUnit тестах.

Читать далее

О бедненьком NULLе замолвите слово

Время на прочтение5 мин
Охват и читатели12K

Есть вещи, которые не нравятся, есть вещи, которые бесят, есть вызывающие жгучий гнев, и есть ситуация с NULL в SQL.

Давайте немножко похоливарим по этому поводу.

Читать далее

Использование Python в SQL Server Machine Learning Services

Время на прочтение4 мин
Охват и читатели5.1K

В продолжение статей Приключения при настройке сервисов машинного обучения в MS SQL Server 2019 и Используем R lang в SQL Server разбираемся как работать с Python в сервисам машинного обучения. С Python ситуация несколько лучше, чем с R, так как достаточно много предустановленных библиотек и версия Python не так сильно отстает от актуальной, как в случае с R.

Для работы с Python крайне важно писать код без отступов, что достаточно нетривиально, так как код вы пишите в SQL строке.

Для разбора примеров используется созданная в статье про R база данных с датасетом из соревнования Kaggle Титаник.

Читать далее

PostgreSQL 16: Часть 1 или Коммитфест 2022-07

Время на прочтение8 мин
Охват и читатели9.1K

Август в релизном цикле PostgreSQL месяц особенный. Еще не вышла официально 15-я версия, но уже закончился первый коммитфест 16-й версии. И мы можем посмотреть на самые интересные изменения.


Собираем сервер из исходного кода и вперед!


\dconfig server_version

List of configuration parameters
   Parameter    |  Value  
----------------+---------
 server_version | 16devel
Читать дальше →

Перенос данных из Oracle в PostgreSQL: секционирование, временные таблицы и инструменты

Время на прочтение14 мин
Охват и читатели14K

Поскольку тема «переезда» c СУБД Oracle на СУБД Postgres не теряет актуальности, продолжаем наш цикл о миграции. Это вторая статья о переносе данных из Oracle в Postgres (первая доступна по ссылке). На этот раз мы подробнее остановимся на секционировании и временных таблицах, а такжe рассмотрим существующий инструментарий для конвертации данных и сокращения времени простоя.

IOT-таблицы в Oracle

В СУБД Oracle есть так называемые IOT-таблицы, Index-Organized Tables. В обычных таблицах данные хранятся в любом порядке. IOT-таблицы хранят данные в структуре B-tree, которая логически отсортирована в порядке, указанном в полях первичного ключа. Данные лежат в листьях индекса и при его обходе и извлечении данных последние будут упорядочены. Стоит отметить, что этот порядок сохраняется. После добавления, обновления или удаления записей данные всё равно будут упорядочены.

Читать далее

Пять советов по исправлению перекошенных соединений в Apache Spark

Время на прочтение9 мин
Охват и читатели6K

Соединения (Joins) являются одними из наиболее фундаментальных преобразований в типичной процедуре обработки данных. Оператор Join позволяет коррелировать, обогащать и фильтровать два входных набора (пакета / блока) данных (Datasets).
Обычно два входных набора данных классифицируются как левый и правый на основе их расположения по отношению к пункту/оператору Join.
По сути, соединение работает на основе условного оператора, который включает логическое выражение, основанное на сравнении между левым ключом, полученным из записи левого блока данных, и правым ключом, полученным из записи правого комплекса данных. Левый и правый ключи обычно называются соединительными ключами (Join Keys). Логическое выражение оценивается для каждой пары записей из двух входных наборов данных. На основе логического вывода, полученного в результате оценки выражения, условный оператор включает условие выбора — для отбора либо одной из записей (из пары), либо комбинированной записи (из записей, образующих пару).
Читать дальше →

Ближайшие события

Как реализовать магию Sqoop для загрузки данных через Spark

Время на прочтение29 мин
Охват и читатели4.3K

Очень часто приходится слышать, что Sqoop — это серебряная пуля для загрузки данных большого объёма с реляционных БД в Hadoop, особенно с Oracle, и Spark-ом невозможно достигнуть такой производительности. При этом приводят аргументы, что sqoop — это инструмент, заточенный под загрузку, а Spark предназначен для обработки данных.

Меня зовут Максим Петров, я руководитель департамента "Чаптер инженеров данных и разработчиков", и я решил написать инструкцию о том, как правильно и быстро загружать данные Spark, основываясь на принципах загрузки Sqoop.

Первичное сравнение технологий

В нашем примере будем рассматривать загрузку данных из таблиц OracleDB.

Рассмотрим случай, когда нам необходимо полностью перегрузить таблицу/партицию на кластер Hadoop c созданием метаданных hive.

Читать далее

PostgreSQL Antipatterns: где скаляру в GiST место?

Время на прочтение3 мин
Охват и читатели3.8K

В PostgreSQL есть "волшебный" тип индекса GiST, который позволяет быстро искать разные сложные вещи - от интервалов до массивов и даже реализовывать полнотекстовый поиск.

Про его внутреннее устройство и возможности подробно рассказывал Егор Рогов, а я в статье "PostgreSQL Antipatterns: работаем с отрезками в «кровавом энтерпрайзе»" показал, как с помощью расширения btree_gist он позволяет решать типовые бизнес-задачи.

Одной из таких задач является поиск отрезков внутри сегмента со скалярным идентификатором. И если для btree очевидно, что поле с меньшей кардинальностью должно стоять в индексе раньше - индекс от этого и меньше и быстрее (см. "DBA: находим бесполезные индексы"), то так ли это однозначно для btree_gist?

Читать далее

Языковая модель GPT-3 умеет объяснять код — рассказываем, как это можно использовать

Время на прочтение8 мин
Охват и читатели12K

За два года с момента релиза GPT-3 эту языковую модель использовали в множестве интересных задач — например, для сочинения поэзии, написания футурологических эссе и подготовки научных статей. Но как алгоритм обработки естественного языка может быть полезен программистам?

На этот вопрос в своей новой статье отвечает британский разработчик Саймон Уиллисон* — директор по архитектуре Eventbrite и один из создателей веб-фреймворка Django. Среди различных вариантов применения языковой модели GPT-3 Уиллисон особенно подчеркивает ее способность объяснять, что делает код. По словам специалиста, в этом GPT-3 поразительно эффективна, поскольку явно обучалась на огромном количестве исходного кода.

Под катом — наш перевод материала, в котором автор демонстрирует недавние примеры из своей практики: объяснение кода на Python, JavaScript, SQL, а также работу в рамках GPT-3 с математическими формулами.

*Обращаем ваше внимание, что позиция автора не всегда может совпадать с мнением МойОфис.

Читать далее

PostgreSQL 15: Часть 5 или Коммитфест 2022-03

Время на прочтение38 мин
Охват и читатели12K
Эта статья о мартовском коммитфесте завершает серию о принятых изменениях в PostgreSQL 15.

Предыдущие статьи посвящены первым четырем коммитфестам: 2021-07, 2021-09, 2021-11, 2022-01.

На момент публикации уже доступна вторая бета-версия PostgreSQL 15. Все приведенные ниже примеры легко попробовать самостоятельно.
Читать дальше →

Разбор тестового задания в Тиньков [SQL]

Время на прочтение3 мин
Охват и читатели44K

Недавно нам прилетело большое тестовое задание от Тиньков-Банка на должность аналитика данных. Там очень много задач, но сегодня мы разберем несколько — остановимся на мелочах и обратим внимание на тонкие моменты.

И, конечно, попишем SQL-запросы!

Читать далее

Быстрая выгрузка результатов опроса из 1С-Битрикс и как передать в Excel произвольное количество столбцов SQL-запросом

Время на прочтение7 мин
Охват и читатели4K

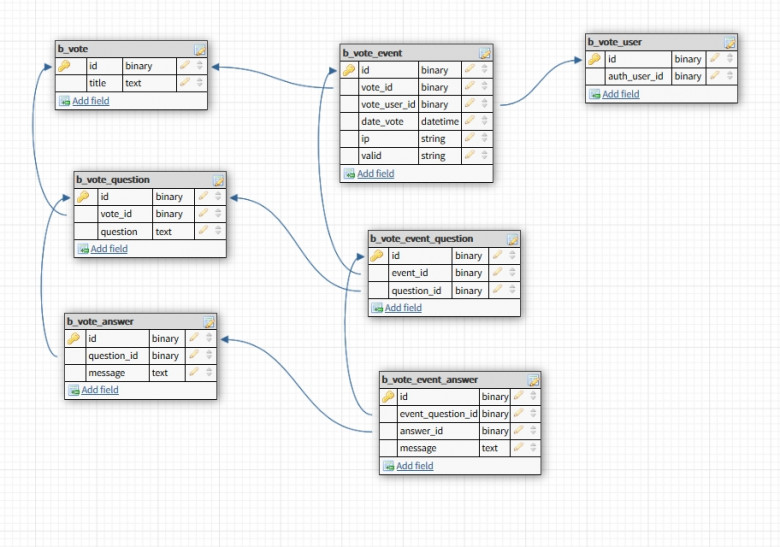
Статья направлена на решение проблемы "зависания" выгрузки результатов опросов при использовании модуля Vote 1С-Битрикс в случае, если в опросе много вопросов или ответов. Так-же в статье реализована выгрузка в Excel SQL-запроса при заранее неизвестном количестве полей, т.е. каждое поле формируется динамически.

Читать далее

Создание и наполнение PostGIS при использовании Docker

Время на прочтение5 мин
Охват и читатели11K

Пошаговая инструкция о том, как установить и использовать расширение PostGIS для PostgreSQL в Docker.

Включает в себя: установка и настройка Docker-контейнера, загрузка данных в базу данных, извлечение и визуализация данных, анализ геоданных с помощью PostGIS функционала.

Читать далее