Обновить
16K+

SQLite *

Компактная встраиваемая реляционная база данных

14,47
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Применение SQLiteOpenHelper и Database Inspector в Android-разработке

Время на прочтение6 мин
Охват и читатели19K
Автор статьи, перевод которой мы публикуем сегодня, хочет рассказать об использовании баз данных SQLite в Android-разработке. В частности — он коснётся тут двух вопросов. Во-первых — речь пойдёт о классе SQLiteOpenHelper, который применяется для работы с базами данных в коде приложений. Во-вторых — он уделит определённое внимание инструменту Database Inspector, инспектору баз данных, встроенному в Android Studio.


Читать дальше →

Подключаем Sqlite3 к Telegram боту

Время на прочтение4 мин
Охват и читатели142K

Для многих новичков в разработке ботов для Telegram возникает проблема - как подключить базу данных? Я сам столкнулся с такой проблемой в начале разработки. Тема оказалось довольно простой, но в интернете есть множество гайдов, которые могут запутать. В этом туториале я расскажу о том, как просто интегрировать базу данных Sqlite3.

Читать далее

Kotlite и Kotgres: генераторы SQL и JDBC кода на Kotlin для Sqlite и Postgresql

Время на прочтение12 мин
Охват и читатели6.9K

Нравится Kotlin? Считаешь SQL мощным инструментом? Подташнивает от слов ORM, JPA, Hibernate?

Есть выход! Автоматическая генерация SQL + JDBC без бойлер-плейта.

Читать далее

SQLite — не игрушка

Время на прочтение7 мин
Охват и читатели92K

Рассказываю, почему SQLite отлично подойдет вам в повседневной работе. И неважно, разработчик вы, аналитик, тестировщик, админ или продакт-менеджер.

Читать далее

PySpark. Решаем задачу на поиск сессий

Время на прочтение6 мин
Охват и читатели9.2K

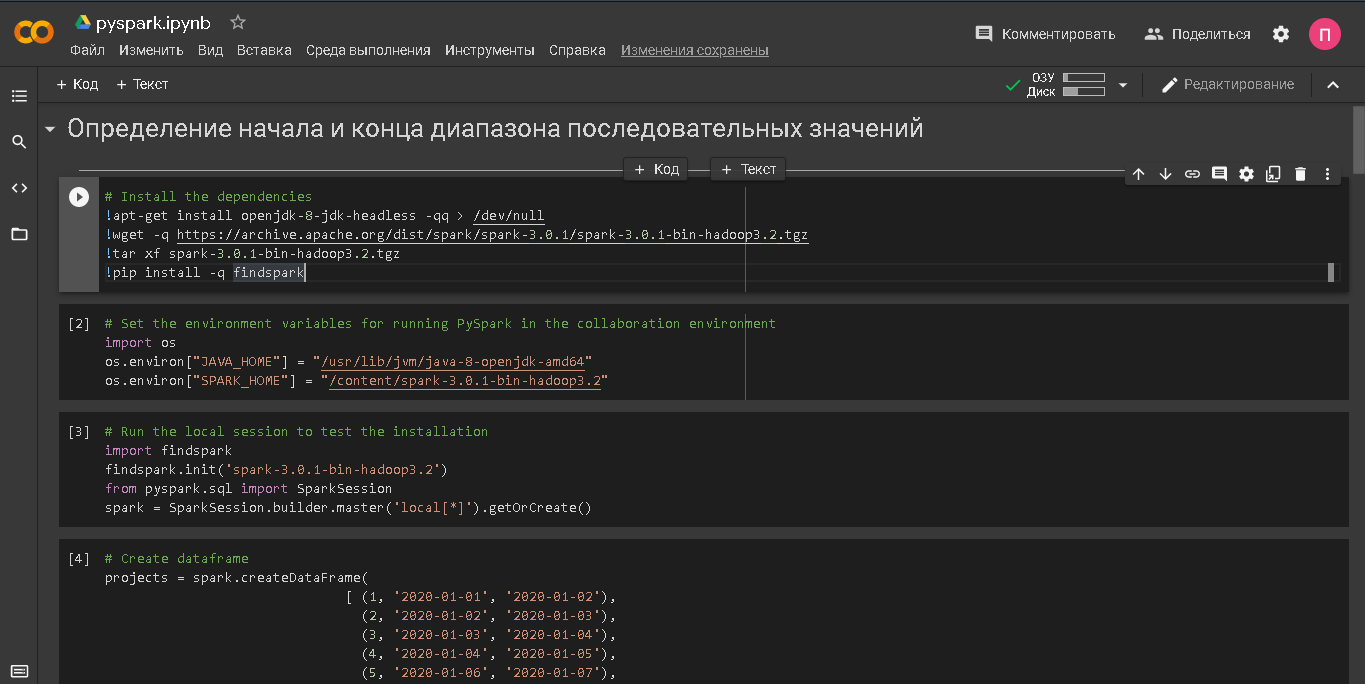
Добрый день уважаемые читатели! Несколько дней назад перечитывая книгу Энтони Молинаро “SQL. Сборник рецептов”, в одной из глав я наткнулся на тему, которая была посвящена определению начала и конца диапазона последовательных значений. Бегло ознакомившись с материалом, я сразу вспомнил, что уже сталкивался с данным вопросом в качестве одного из тестовых заданий, но тогда тема была заявлена как “Задача на поиск сессий”. Фишкой технического собеседования был не разбор выполненной работы, а один из вопросов интервьюера о том, как получить аналогичные значения с помощью Spark. Готовясь к собеседованию, я не знал, что в компании применяется (а может и не применяется…) Apache Spark, и поэтому не собрал информацию по новому на тот момент для меня инструменту. Оставалось лишь выдвинуть гипотезу, что искомое решение может быть подобно скрипту, который можно написать c помощью библиотеки Pandas. Хотя очень отдалено я все-таки попал в цель, однако поработать в данной организации не получилось.

Справедливости ради хочу заметить, что за прошедшие годы я несильно продвинулся в изучении Apache Spark. Но я все равно хочу поделиться с читателями наработками, так как многие аналитики вообще не сталкивались с этим инструментом, а другим возможно предстоит подобное собеседование. Если вы являетесь профессионалом Spark, то всегда можно предложить более оптимальный код в комментариях к публикации.

Читать далее

Видеомонтаж, машинное обучение и взломанный xml — все в одной программе

Время на прочтение5 мин
Охват и читатели4.4K

По профессии я режиссер монтажа, а прикладное программирование как увлечение в свободное время.

В какой то момент пришла идея совместить работу с хобби, прочитал статью на хабре о распознавании объектов на картинках с помощью Core ML, с этого собственно все и началось. Поделюсь скромным опытом и проблемами с которыми можно столкнуться при разработке приложений работающих с Core ML.

Дело в том что почти треть работы видеомонтажера  заключается  в рутинном поиске видеоряда из исходников, которые надо каждый раз шерстить в поиске контекстного плана под закадровый текст, по моему это не несет никакой творческой составляющей, особенно когда ты занимаешься этим 15 лет). Ну и подумал я, а что если написать софтину, которая будет проходится по папке с исходниками, распознавать объекты, аккуратненько «складывать» их в БД. Далее, в момент поиска видео фрагментов для так называемой «джинсы», вводится поисковое слово, например «Солнце», и все что находится каким то образом передается в монтажную систему.

Идея зрела, собирался стёк, писать решил на Swift, обученные модели собственно Core ML, база данных SQLite. На первый взгляд идея казалась легко реализуемой, вроде ничего сложного.  

Очень быстро накидал основной код, который вытаскивает кадры из видео, распознает обьекты с помощью модели Resnet50, которую рекомендовали яблочники у себя на сайте, она очень шустро работала и позволяла настраивать процент при котором считать объект распознанным. Сам код спокойно раздается на том же apple.com  для всех желающих. Подключил библиотеку SQLite.swift, обернул ее функции в свои методы, все работает! 

Потом еще пришлось неплохо повозиться с алгоритмами создания очереди обработки списка файлов и в этот момент я обратил внимание что программа то разрослась! 

Читать далее

Полнотекстовый поиск FTS3, FTS4 и FTS5 в Android

Время на прочтение10 мин
Охват и читатели12K
Полнотекстовый поиск необходим в приложениях для того, чтобы быстро находить совпадения в большом объеме данных. Такая возможность удобна, например, для поиска товаров, фильмов, рецептов, научных статей, а также фрагментов текста в электронных книгах. Хотя зачастую поиск реализуют на сервере, иногда бывает необходимо работать в оффлайне, повысить отзывчивость мобильного приложения, избежав задержек при взаимодействии с сервером. В таких случаях используют полнотекстовый поиск — Full-Text Search.

В этой статье рассмотрим особенности полнотекстового поиска в Android с использованием FTS3, FTS4 и FTS5. Статья будет наиболее полезна для читателей, знакомых с Android и SQLite.

Читать дальше →

Возможности SQLite, которые вы могли пропустить

Время на прочтение8 мин
Охват и читатели49K
Если вы используете SQLite, но не следите за его развитием, то возможно некоторые вещи, позволяющие сделать код проще, а запросы быстрее, прошли незамеченными. Под катом я постарался перечислить наиболее важные из них.
Читать дальше →

Визуализация sqlite в node.js

Время на прочтение3 мин
Охват и читатели17K


Довольно часто на этапе прототипирования (и всегда — в пет-проектах) я не запариваюсь с бэкэндом и поднимаю апи на express с sqlite3. Это легко и довольно удобно для несложной логики, а для сложной есть бэкэндеры с их отдельным миром. Единственный геморрой, который долгое время меня преследовал на этапе написания апи — невозможность быстро заглянуть в базу и отследить изменения. Можно дебажить по памяти, конечно, но это как-то странно, когда можно просто вытащить содержимое по запросу и отобразить его на какой-нибудь страничке. Вот только каждый раз заново парсить json и распихивать его в таблицы по лучшим практикам очередного фреймворка мне не хотелось, поэтому я после недолгих поисков нашёл sqljs и набросал на нём простейший визуализатор.
Читать дальше →

Внедряем оплату BTC куда угодно (Python)

Время на прочтение7 мин
Охват и читатели52K

Внедряем оплату BTC куда угодно (Python)

- генерация кошелька на основе seed фразы

- проверка баланса и транзакций

- отправка BTC на другие кошельки

- создаем телеграм бота для выполнения операций с BTC

- исходники бота (github)

Читать далее

Папа может в си, или Простая и аккуратная кодогенерация для SQLite

Время на прочтение4 мин
Охват и читатели3.4K
image

Совсем скоро, 4 и 5 ноября, у нас стартуют новые потоки курсов SQL для анализа данных и C++ разработчик, специально к их старту мы подготовили этот перевод из блога Facebook Engineering с обзором полезного инструмента.

SQLite используется широко, но написание хорошо протестированных и поддерживаемых уровней доступа к данным в лучшем случае может стать сложной задачей. Многие команды применяют некую генерацию кода, чтобы избежать необходимости менять десятки порядковых номеров каждый раз, когда добавляется столбец, но такой подход приводит к ошибкам. Компилятор CQL в CG/SQL позволяет создавать сложные хранимые процедуры с большими запросами, а с помощью комбинаций синтаксических хелперов и сильной типизации эти процедуры гораздо проще получить и сохранить. Сочетание сильной типизации в языке и средства для хорошего юнит-тестирования может дать уверенность в том, что даже очень сложная логика корректна.
Приятного чтения!

Сбор статистики viber

Время на прочтение5 мин
Охват и читатели12K
Возник интерес как получить статистику по чату в вайбере. По информации на сайте viber.com статистика предоставляется только для сообществ, в которых не менее 1000 участников.
Далее опишу инструкцию как я получал статистику для чата viber используя файл резервной копии.
Читать дальше →

Как проанализировать рынок фотостудий с помощью Python (2/3). База данных

Время на прочтение12 мин
Охват и читатели4.9K
В предыдущей статье в рамках коммерческого проекта по анализу рынка фотостудий рассмотрел создание парсинга: выгрузка списка фотостудий, списка залов, данных по бронированию с момента открытия зала до последней брони.

Полученную информацию в кэше хранить нецелесообразно, необходимо использовать базу данных.

В статье рассмотрю:

  • создание простой SQLite базы данных;
  • запись информации с помощь Python;
  • чтение данных и перевод в формат DataFrame;
  • обновление парсинга с учетом данных БД.


Читать дальше →

Ближайшие события

Сколько данных может обработать Raspberry Pi быстро

Время на прочтение3 мин
Охват и читатели8.1K
Время обработки данных в одном знакомом мне проекте энтерпрайз-хранилища данных с реляционной моделью составляет почти 2,5 часа. Много это или мало?

Заметка описывает эксперимент по созданию маленькой копии энтерпрайз-хранилища данных с сильно ограниченными техническими условиями. А именно, на базе одноплатного компьютера Raspberry Pi.

Модель и архитектура будут упрощёнными, но похожими на энтерпрайз-хранилище. Результатом является оценка возможности использования Raspberry Pi в области обработки и анализа данных.


Читать дальше →

Yet Another Производственный Календарь на MS SQL. ПО->ША->ГО->ВО

Время на прочтение5 мин
Охват и читатели10K
Написать свое решение меня подтолкнул пост на Хабре на аналогичную тему, в котором эта задача была решена «в лоб» — простым перечислением дней и флагом рабочий/выходной за весь диапазон жизнедеятельности системы, в которой этот календарь используется. В аналогичной ситуации я решил поступить немного хитрее, что в итоге оказывается и гораздо проще в поддержке. Если интересно, как это было сделано — welcome под кат:
Читать дальше →

Дополняя SQL. Часть 3. Жизнь расширений для Visual Studio. Работа с IO. Необычное использование SQL

Время на прочтение10 мин
Охват и читатели3.6K
Публикую на Хабр оригинал статьи, перевод которой размещен в блоге Codingsight.

Что будет в этой статье?


Это третья статья в цикле о жизни разработчиков IDE для баз данных. Ее структура будет похожа на первую и вторую, но здесь я уже не буду рассказывать о парсинге текста. В этой статье речь пойдет о некоторых трюках по работе с файлами и просто различными проблемами при создании большого настольного приложения на платформе .NET. Для понимания этой статьи не обязательно читать первую и вторую части полностью, но в первой статье цикла есть несколько параграфов, которые отлично погружают в контекст разработки. Мне кажется, эта часть цикла получилась интересна даже для большего круга людей, чем предыдущие. Их было бы полезно глянуть перед прочтением статьи, а если на это нет времени или желания, то вот несколько тезисов из прошлых статей:

  • Мы делаем линейку IDE для СУБД MySQL, SQL Server, Oracle, PostgreSQL
  • Это настольное приложение на .NET стеке со всеми вытекающими
  • Много функций завязаны на анализ SQL кода. Используем для этого сильно доработанный ANTLR
  • Парсинг SQL это сложная задача в плане производительности и памяти. Постоянно приходится применять разные трюки для оптимизации

По мере публикации буду добавлять ссылки на следующие части:

Часть 1. Сложности парсинга. Истории о доработке ANTLR напильником
Часть 2. Оптимизация работы со строками и открытия файлов
Часть 3. Жизнь расширений для Visual Studio. Работа с IO. Необычное использование SQL
Часть 4. Работа с исключениями, влияние данных на процесс разработки. Использование ML.NET


Читать дальше →

Python: Работа с базой данных, часть 2/2: Используем ORM

Время на прочтение14 мин
Охват и читатели129K
часть 1/2: Используем DB-API часть 2/2: Используем ORM
Это вторая часть моей статьи по работе с базой данных в Python. В первой части мы рассмотрели основные принципы коммуникации с SQL базой данных, а в этой познакомимся с инструментарием, позволяющим облегчить нам это взаимодействие и сократить количество нашего кода в типовых задачах.

Статья ориентирована в первую очередь на начинающих, она не претендует на исчерпывающе глубокое изложение, а скорее дает краткую вводную в тему, объясняет самые востребованные подходы для старта и иллюстрирует это простыми примерами базовых операций.


Требуемый уровень подготовки: базовое понимание SQL и Python (код статьи проверялся под Python 3.6). Желательно ознакомится с первой частью, так как к ней будут неоднократные отсылки и сравнения. В конце статьи есть весь код примеров под спойлером в едином файле и список ссылок для более углубленного изучения материала.
Читать дальше →

FAQ.Net — бесплатная программа для заметок под Windows с обновленным дизайном

Время на прочтение3 мин
Охват и читатели9.3K

Введение


За 3 месяца приложение FAQ.Net скачали более 800 раз. Все кто пользуется блокнотами и ищет готовое решение для хранения важной информации, заметок или документов (в виде текста, изображений, таблиц) в единой БД скачивайте FAQ.Net. Приложение портативное, бесплатное, без рекламы и не нужен доступ в Интернет. Исходный код выложен на github.

В сообществе ВК размещаются видео-инструкции и новости приложения. Все желающие могут присоединиться к сообществу, поучаствовать в опросах и задать свои вопросы по работе приложения FAQ.Net.


Возможности приложения FAQ.Net


  • Все заметки (RTF-документы) хранятся в единой БД SQLite
  • Имеется «Словарь подсказок» (см. подробности) — это всплывающие подсказки, которые создаются пользователем и их можно использовать:
    • для навигации по другим заметкам внутри приложения
    • в качестве переводчика, что очень помогает при изучении новых иностранных слов
    • для хранения ссылок Интернета в одном месте
    • для хранения описания предмета, события, слова и др.
  • Автодополнение слов по «Словарю подсказок» (IntelliSense) сочетанием клавиш «Ctrl+Space»
  • Гибкая настройка интерфейса (шрифты, цвета, иконки)
  • Добавление картинок. Если картинка вставлена из редактора Paint через буфер (т.е. комбинацией клавиш Ctrl+C — Ctrl+V), то такие картинки можно редактировать двойным нажатием мышки
  • Создание таблиц
  • Создание резервной копии БД
  • Предварительный просмотр и печать документов
  • Быстрый поиск по всем заметкам
  • На вкладке «Избранное» содержится список заметок, помеченных пользователем
  • На вкладке «Журнал» отображается 50 последних измененных заметок
Читать дальше →

Python, введение в БД

Время на прочтение3 мин
Охват и читатели104K

Базы данных


Здравствуйте, здесь и сейчас я хочу рассказать, что такое базы данных, зачем они нужны, и т.д.; для работы с ними мы будем использовать python и его библиотеку sqlite3.


База данных - совокупность данных, хранимых в соответствии со схемой данных, манипулирование которыми выполняют в соответствии с правилами средств моделирования данных


Так нам говорит Яндекс, но если сказать простыми словами, не углубляясь во все эти понятия, то:


Базы данных (БД) - библиотека, хранящая данные в том или ином виде.


То есть как в библиотеку мы можем прийти и взять книгу «Война и мир», зная что она будет лежать в разделе романов, на букву «В», так и из БД мы можем взять запись по определённому аргументу, в данном случае жанру.


И тут возникает вопрос.


Как это сделать?

И что бы ответить на этот вопрос, мы должны кое-что узнать.

Читать дальше →

SQL запросы быстро. Часть 1

Время на прочтение5 мин
Охват и читатели1.9M
Подписаться в telegram: t.me/korocheproduct

Введение


Язык SQL очень прочно влился в жизнь бизнес-аналитиков и требования к кандидатам благодаря простоте, удобству и распространенности. Из собственного опыта могу сказать, что наиболее часто SQL используется для формирования выгрузок, витрин (с последующим построением отчетов на основе этих витрин) и администрирования баз данных. И поскольку повседневная работа аналитика неизбежно связана с выгрузками данных и витринами, навык написания SQL запросов может стать фактором, из-за которого кандидат или получит преимущество, или будет отсеян. Печальная новость в том, что не каждый может рассчитывать получить его на студенческой скамье. Хорошая новость в том, что в изучении SQL нет ничего сложного, это быстро, а синтаксис запросов прост и понятен. Особенно это касается тех, кому уже доводилось сталкиваться с более сложными языками.

Обучение SQL запросам я разделил на три части. Эта часть посвящена базовому синтаксису, который используется в 80-90% случаев. Следующие две части будут посвящены подзапросам, Join'ам и специальным операторам. Цель гайдов: быстро и на практике отработать синтаксис SQL, чтобы добавить его к арсеналу навыков.

Практика


Введение в синтаксис будет рассмотрено на примере открытой базы данных, предназначенной специально для практики SQL. Чтобы твое обучение прошло максимально эффективно, открой ссылку ниже в новой вкладке и сразу запускай приведенные примеры, это позволит тебе лучше закрепить материал и самостоятельно поработать с синтаксисом.
Читать дальше →