Обновить
25
Programmer@Programmer

Пользователь

3
Подписчики
Отправить сообщение

Symfony2 двухфакторная авторизация с помощью сертификата

Время на прочтение3 мин
Охват и читатели8.2K
Речь пойдет о Symfony2-CertAuthBundle — бандле для популярного фрейморка Symfony2, который позволяет легко внедрить двухфакторную аутентификацию на основе x509 сертификатов клиентов.

Иногда стандартной аутентификации в виде формы логина недостаточно чтобы надежно защитить проект.

Кто-то может подсмотреть, проснифить, любым другим способом выудить логин пароль, ну или просто взломать сайт и получить доступ ко всем учеткам.

Для тех, кто считает, что его проекту нужен более надежный метод защиты добро пожаловать под кат.
Читать дальше →

Заставляем сервис php-fpm 5.6, запущенный через systemd, читать глобальные переменные окружения

Время на прочтение6 мин
Охват и читатели14K
Это короткий how-to для реализации конфигурации php-сервиса, зависимого от окружения, в котором он запущен. Я буду рад, если кто-то подскажет более изящное решение или поправит в мелочах.

Основная идея


Запускать сервис, микросервисы и зависимые приложения в рамках одной экосистемы, конфигурируемой с помощью переменных окружения.

Проблема

В этой статье слишком много раз повторяется «переменные окружения».
Из коробки php-fpm игнорирует глобальные переменные окружения (getenv function), в то время как php cli их может получать.
Читать дальше →

Заставляем совместно работать open_basedir + realpath_cache

Время на прочтение2 мин
Охват и читатели7K
Заметив некоторое замедление работы PHP на постоянных проверках lstat всех путей открываемых файлов и директорий, решил поднастроить производительность, увеличив realpath_cache_size. Был немного удивлён, когда получил из
var_dump(realpath_cache_size(),realpath_cache_get());

int(0); array(0) {}


Ещё больше удивило, что этот баг до сих пор не решён в последних версиях PHP 5.6, а в документации про него ни слова (один комментарий пользователя месяц назад).

Некоторым гуглением было найдено решение: расширение, совмещающее в себе open_basedir и работающее через кеш путей php. Turbo_realpath.

В Pecl его нет, поэтому скачиваем архив с офсайта (для версий 5.4+, ниже смотрите на офсайте).
Читать дальше →

Балансировка 70 тысяч запросов в секунду на HighLoad++

Время на прочтение5 мин
Охват и читатели40K

Библиотека докладов


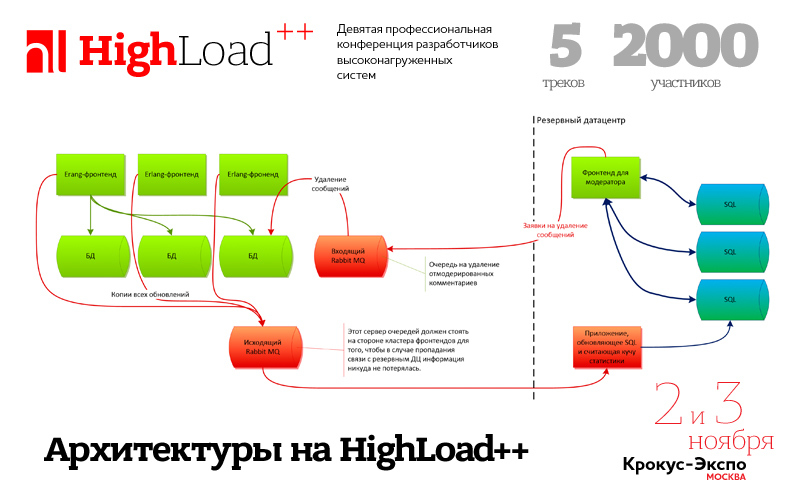
Это не просто статья — это целая библиотека докладов про внутреннее устройство тех или иных крупных и высоконагруженных проектов. Все эти доклады звучали на конференциях HighLoad++ и РИТ++ за последние несколько лет.


Читать дальше →

Rust попал в индекс TIOBE

Время на прочтение1 мин
Охват и читатели19K
Октябрьский индекс TIOBE обновил положение Rust в «пищевой цепочке». Язык занял почётное 49-е место войдя в 50-ку популярных языков потеснив Closure. Для сравнения в 50-ку не попадают весьма интересные: Common Lisp, Julia, Go.
Читать дальше →

Rust в деталях: пишем масштабируемый чат с нуля, часть 1

Время на прочтение31 мин
Охват и читатели71K

Часть 1: Реализуем WebSocket. Введение.


В этом цикле статей мы рассмотрим процесс создания масштабируемого чата, который будет работать в реальном времени.
Целью данного обзора является пошаговое изучение основ быстро набирающего популярность языка программирования Rust на практике, с попутным охватом системных интерфейсов.

В первой части мы рассмотрим начальную настройку окружения и реализацию простейшего WebSocket-сервера. Чтобы понять технические детали статьи вам не потребуется опыта работы с языком Rust, хотя знание основ системных API (POSIX) и C/C++ лишним не будет. Прежде чем начинать чтение, заготовьте немного времени (и кофе) — статья описывает все максимально подробно и поэтому довольно длинная.

Читать дальше →

PostgreSQL и задачи, с ней связанные, на HighLoad++

Время на прочтение6 мин
Охват и читатели31K


Наблюдать за развитием разных баз данных — увлекательное занятие, особенно — если понимаешь подводные течения. Одно из самых сильных сообществ вокруг СУБД в России — это PostgreSQL-сообщество. Две тематические конференции в год, консалтинговая компания и даже компания-разработчик модулей к PostgreSQL.

Руководитель и идеолог международного сообщества, Брюс Момжан, вот уже какой год приезжает к нам на HighLoad++. Этот год не исключение, Брюс будет рассказывать про «Upcoming PostgreSQL Features» — кому рассказывать про будущее этой СУБД, как не Брюсу?

Почему же, несмотря на такую активность, это база данных по-прежнему далеко не так распространена, как, например «базулька» MySQL. В чем подвох? Эту тему мы активно обсуждали на конференции PGDay'15, которую организовал один из докладчиков HighLoad++ Илья Космодемьянский.

Для начала небольшое исследование:
  1. Крупнейшие платные CMS в России (Битрикс, Netcat, UMI) не поддерживают PostgreSQL;
  2. Самые популярные бесплатные CMS (Wordpress, Drupal, Joomla) тоже (или поддерживают с трудом или поддерживают недавно);
  3. Только каждый третий хостинг провайдер предлагает поддержку PostgreSQL.

Читать дальше →

Сетевые системные вызовы. Часть 3

Время на прочтение11 мин
Охват и читатели23K
Предыдущую часть обсуждения мы завершили на такой вот оптимистической ноте: «Подобным образом мы можем изменить поведение любого системного вызова Linux». И тут я слукавил — любого… да не любого. Исключение составляют (могут составлять) группа сетевых системных вызовов, работающих с BSD сокетами. Когда сталкиваешься с этим артефактом в первый раз — это изрядно озадачивает.
Читать дальше →

Создаём REST-сервис на PostgreSQL и Rust. Часть 1: прототип

Время на прочтение6 мин
Охват и читатели40K
Всем привет.

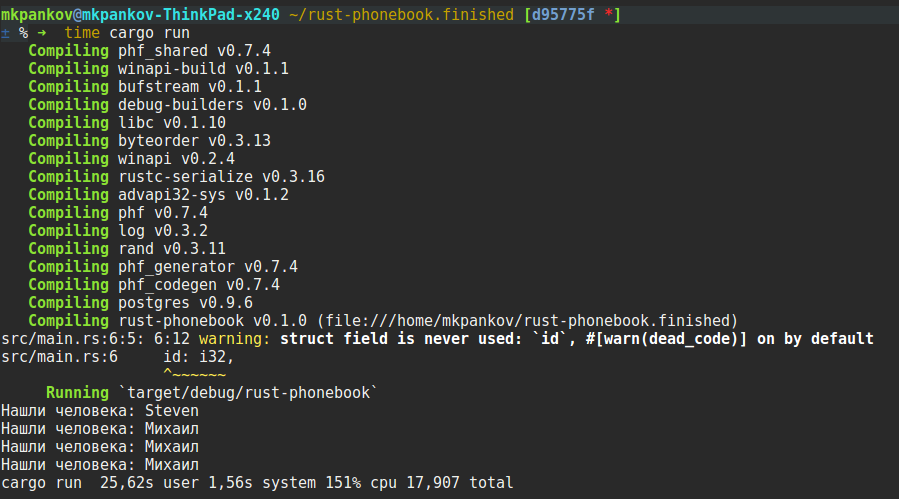
Какое-то время назад я видел в небезызвестном блоге пост о том, как реализовать на Go простую программу, работающую с БД, а затем сделать на её базе целый REST-сервис. Я решил проверить, насколько сложно сделать аналогичную программу на Rust и поделиться результатами.


Мы начнём с работы с БД и создадим обычное консольное приложение, а затем добавим, так сказать, REST-фронтенд.
Читать дальше →

Заимствование и время существования в Rust

Время на прочтение10 мин
Охват и читатели15K
Представляю вашему вниманию перевод статьи «Rust Borrow and Lifetimes» из блога Артура Ляо (Arthur Liao), инженера Yahoo!

Rust — это новый язык программирования, находящийся в активной разработке с версии 1.0. Я могу написать другой блог о Rust и том, почему он крут, но сегодня я сфокусируюсь на его системе заимствования и времени существования, которая запутывает многих новичков, в том числе и меня самого. Данный пост предполагает, что у вас есть базовое понимание Rust. Если же нет, вы можете сперва прочитать само Руководство и Руководство по указателям.
Читать дальше →

Как исправить ошибку в Node.js и нечаянно поднять производительность в 2 раза

Время на прочтение8 мин
Охват и читатели45K
Началось все с того, что я оптимизировал отдачу ошибки HTTP 408 Request Timeout в сервере приложений Impress, работающем на Node.js. Как известно, у нодовского http.Server есть событие timeout, которое должно вызываться для каждого открытого сокета, если тот не закрылся за указанное время. Хочу уточнить, что не для каждого запроса т.е. не для каждого события request, функция которого имеет два аргумента (req, res), а именно для каждого сокета. Через один сокет может последовательно поступить много запросов в режиме keep-alive. Если мы задаем это событие, через server.setTimeout(2 * 60 * 1000, function(socket) {...}) то должны сами уничтожать сокет socket.destroy(). Но если не установить свой обработчик, то http.Server имеет встроенный, который уничтожит сокет через 2 минуты автоматически. На этом самом таймауте можно отдать ошибку 408 и считать инцидент исчерпанным. Если бы не одно но… С удивлением я обнаружил, что событие timeout вызывается и для тех сокетов, которые подвисли и для уже получивших ответ и для закрытых клиентской стороной, вообще для всех, находящихся в режиме keep-alive. Это странное поведение оказалось достаточно сложным, и я расскажу об этом ниже. Можно было бы вставить одну проверку в событие timeout, но со своим идеализмом я не удержался и полез исправлять баг на уровень глубже. Оказалось, что в http.Server режим keep-alive реализован не то что не по RFC, а откровенно не дописан. Вместо отдельного timeout для соединения и отдельного keep-alive timeout, там все на одном таймауте, который реализован на быстрых псевдо-таймерах (enroll/unenroll), но задан по умолчанию в 2 минуты. Это было бы не так страшно, если бы браузеры хорошо работали с keep-alive и переиспользовали его эффективно или закрывали бы неиспользуемые соединения.
Читать дальше →

Свой облачный хостинг за 5 минут. Часть 2: Service Discovery

Время на прочтение7 мин
Охват и читатели44K
Cloud hosting

Привет Хабр! В предыдущей статье я рассказал как построить свой облачный хостинг за 5 минут, используя Ansible, Docker и Docker Swarm. В этой части я расскажу о том, как сервисы, запущенные в облаке, находят друг друга, как происходит балансировка нагрузки между ними и обеспечивается их отказоустойчивость.

Это вводная статья, здесь мы сосредоточимся на обзоре инструментов, которые будут решать проблему «обнаружения сервисов» в нашем облаке. В следующей части мы приступим к практике, поэтому я решил дать вам время поближе ознакомиться с ними.
Читать дальше →

TIS-100 — паззл про многопоточный ассемблер, который никто не ждал

Время на прочтение3 мин
Охват и читатели98K
image

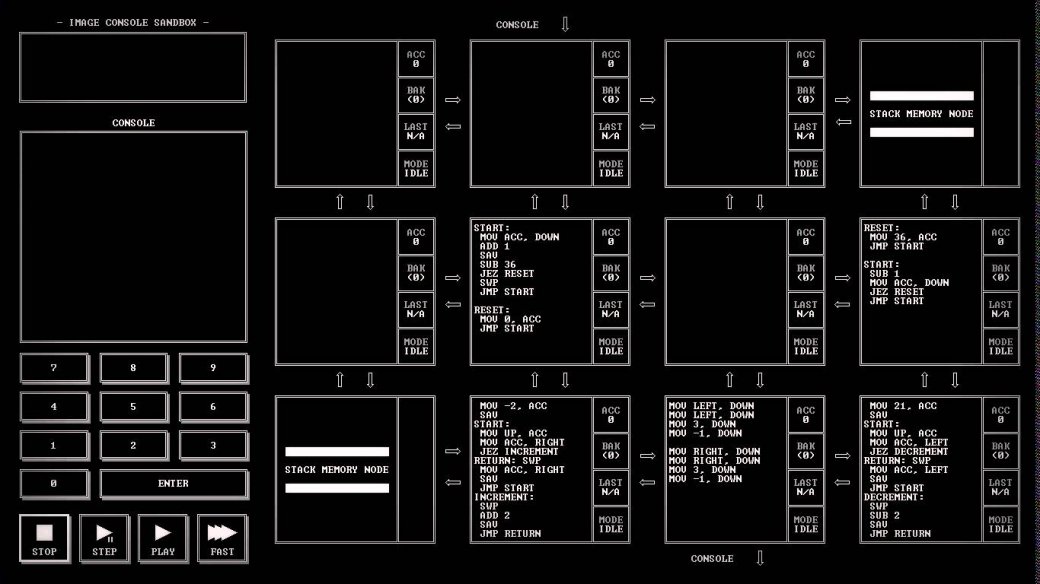
Удивительно, но никто не написал ничего про игрушку «TIS-100», которая недавно появилась в Steam (стоит всего 150 рублей, уже 460 положительных отзывов против 6 отрицательных).

Сразу оговорюсь, что к авторам игры я отношения не имею, а вот сама эта игра — отличный инструмент для всех программистов, которые хотят сразиться друг с другом в оптимизации кода на выдуманном хитром ассемблере.

Итак, о чем игра?
Читать дальше →

HA-Cluster на основе Pacemaker под контейнерную виртуализацию LXC и Docker

Время на прочтение24 мин
Охват и читатели64K
В этой статье я опишу установку и настройку Active/Active кластера на основе Pacemaker, Corosync 2.x и CLVM с использованием разделяемого хранилища. Покажу, как приспособить этот кластер для работы с контейнерами LXC и Docker. Опишу команды для работы с кластером. И припомню те грабли, в которые вляпался, что, надеюсь, облегчит судьбу следующим проходимцам.

В качестве серверных дистрибутивов буду использовать CentOS 7 + epel и актуальные версии пакетов в них. Основной инструмент для работы с Pacemaker-ом будет PCS (pacemaker/corosync configuration system).


Читать дальше →

Основы Kubernetes

Время на прочтение13 мин
Охват и читатели1M
В этой публикации я хотел рассказать об интересной, но незаслуженно мало описанной на Хабре, системе управления контейнерами Kubernetes.

image

Что такое Kubernetes?


Kubernetes является проектом с открытым исходным кодом, предназначенным для управления кластером контейнеров Linux как единой системой. Kubernetes управляет и запускает контейнеры Docker на большом количестве хостов, а так же обеспечивает совместное размещение и репликацию большого количества контейнеров. Проект был начат Google и теперь поддерживается многими компаниями, среди которых Microsoft, RedHat, IBM и Docker.
Читать дальше →

Brubeck — быстрый, statsd-совместимый агрегатор метрик от GitHub

Время на прочтение3 мин
Охват и читатели21K


История появления


Одной из главных целей команды разработчиков GitHub всегда была высокая производительность. У них даже существует поговорка: «it's not fully shipped until it's fast» (продукт считается готовым только тогда, когда он работает быстро). А как понять, что что-то работает быстро или медленно? Нужно мерять. Измерять правильно, измерять надёжно, измерять всегда. Нужно следить за измерениями, визуализировать всевозможные метрики, держать руку на пульсе, особенно, когда дело имеешь с высоконагруженными онлайн системами, такими как GitHub. Поэтому метрики — это инструмент, позволяющий команде предоставлять столь быстрые и доступные сервисы, почти без даунтаймов.

В своё время GitHub одними из первых внедрили у себя инструмент под названием statsd от разработчиков из Etsy. statsd — это агрегатор метрик, написанный на Node.js. Его суть состояла в том, чтобы собирать всевозможные метрики и агрегировать их в сервере, для последующего сохранения в любом формате, например, в Graphite в виде данных на графике. statsd — это хороший инструмент, построенный на UDP сокетах, удобный в использовании как на основном Rails приложении, так и для сбора простейших метрик, наподобие вызова nc -u. Проблема с ним начала проявляться позже, по мере роста количества серверов и метрик, отправляемых в statsd.
Читать дальше →

Сбор и визуализация метрик приложения в Graphite и Graph-Explorer

Время на прочтение9 мин
Охват и читатели77K
Зачастую возникает необходимость отслеживать различные параметры работы приложения/сервиса. Например, интерес представляет количество запросов в секунду, среднее время ответа сервера, количество ответов сервера с различным HTTP-статусом (технические метрики), количество регистраций пользователей в час, количество платежных транзакций в минуту (бизнес-метрики) и пр. Без системы сбора метрик разработка и сопровождение продукта происходит практически вслепую.


Данная статья является руководством по настройке системы сбора и анализа метрик приложения на базе Graphite и vimeo/graph-explorer.
Читать дальше →

Как считается Load Average

Время на прочтение7 мин
Охват и читатели111K

Постановка вопроса


Недавно, во время собеседования в одну крупную компанию мне задали простой вопрос, что такое Load Average. Не знаю, на сколько правильно я ответил, но лично для себя пришло осознание, что точного ответа я на самом деле и не знаю.

Большинство людей наверняка знают, что Load Average — это среднее значение загрузки системы за некоторый период времени (1, 5 и 15 минут). Так же можно узнать некоторые подробности из данной статьи, про то, как этим пользоваться. В большинстве случаев этих знаний достаточно для того, что бы по значению LA оценивать загрузку системы, но я по специальности физик, и когда я вижу «среднее за промежуток времени» мне сразу становится интересна частота дискретизации на данном промежутке. А когда я вижу термин «ожидающие ресурсов», становится интересно, каких именно и сколько времени надо ждать, а так же сколько тривиальных процессов надо запустить, что бы получить за короткий промежуток времени высокий LA. И главное, почему ответы на эти вопросы не дает 5 минут работы с гуглом? Если вам данные тонкости так же интересны, добро пожаловать под кат.
Читать дальше →

PHP-Дайджест № 64 – интересные новости, материалы и инструменты (1 – 14 июня 2015)

Время на прочтение4 мин
Охват и читатели19K


Предлагаем вашему вниманию очередную подборку со ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Реализация Single Sign On в Symfony2 приложении

Время на прочтение7 мин
Охват и читатели30K

Что такое Single Sign On?


Single Sign On — это технология, с помощью которой пользователь, будучи аутентифицированным на удостоверяющем центре (далее Identity Provider, IdP), будет автоматически аутентифицирован на другом сервисе (далее Service Provider, SP или Consumer[1-N]) этой компании.

Механизм Single Sign On используют такие сайты, как ХабраХабр, Yandex, Google. Приемущества такого подхода к аутентификации пользователей очевидны:

  • Пользователь вводит пароль только 1 раз
  • Или вовсе не вводит пароль на IdP, если там был использован вход через социальную сеть или с использованием OpenID
  • Автоматически аутентифицируется на всех проектах компании
  • Данные пользователя могут плавать между сервисами от IdP до SP прозрачно для пользователя

Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Киев, Киевская обл., Украина
Дата рождения
Зарегистрирован
Активность