Обновить
3

Пользователь

Отправить сообщение

Как ELK помогает инженерам по ИБ бороться с атаками на сайты и спать спокойно

Время чтения6 мин
Охват и читатели8.9K
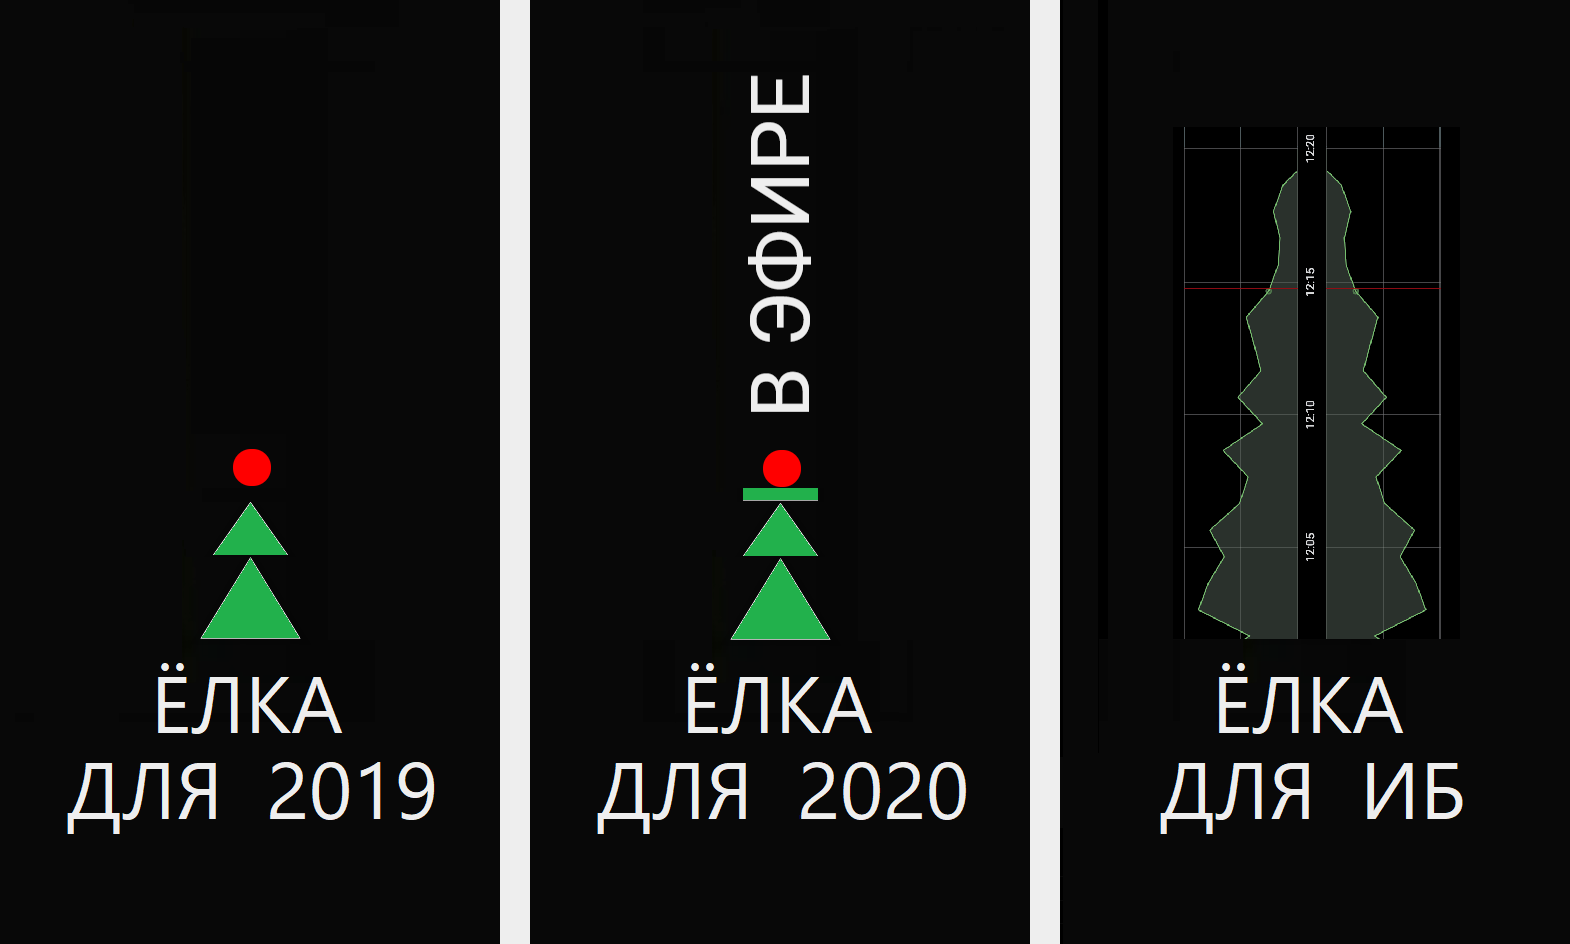
Наш центр киберзащиты отвечает за безопасность веб-инфраструктуры клиентов и отбивает атаки на клиентские сайты. Для защиты от атак мы используем файрволы веб-приложений FortiWeb (WAF). Но даже самый крутой WAF – не панацея и не защищает «из коробки» от целевых атак. 

Поэтому в дополнение к WAF мы используем ELK. Он помогает собирать все события в одном месте, копит статистику, визуализирует ее и позволяет нам вовремя видеть направленную атаку.

Сегодня расскажу подробнее, как мы скрестили «ёлку» с WAF и что из этого получилось.

Читать дальше →

Наш путь к нулевым простоям при непрерывном обновлении с помощью Ambassador

Время чтения5 мин
Охват и читатели3K


Мы в Lifion строим распределенную платформу и портфель продуктов для клиентов по всему миру. С учетом этого важно, чтобы мы могли выпускать обновления нашей платформы непрерывно прямо во время ее работы, прозрачно для наших пользователей, которым важна доступность системы, при этом они находятся в разных регионах и часовых поясах. В этой статье мы поделимся с вами путем, которым мы шли, чтобы получить нулевые простои при непрерывном обновлении с помощью Kubernetes. Мы запускаем наши нагрузки с помощью управляемого сервиса Kubernetes — AWS EKS. В качестве шлюза API мы применяем Ambassador, сборку Envoy с открытым исходным кодом, специально разработанную для Kubernetes. Наша платформа состоит из более чем 150 микросервисов, большинство из них написаны на Node.js, запускаются в многих подах поверх многочисленных рабочих узлов.

Читать дальше →

«Цель SRE — надёжная система». Обзор основных метрик SRE

Время чтения10 мин
Охват и читатели72K

Site Reliability Engineering (SRE) — это одна из форм реализации DevOps. SRE-подход возник в Google и стал популярен в среде продуктовых IT-компаний после выхода одноимённой книги в 2016 году.


В статье опишем, как SRE-подход соотносится с DevOps, какие задачи решает инженер по SRE и о каких показателях заботится.


Читать дальше →

Kubernetes: мониторинг c помощью Prometheus

Время чтения14 мин
Охват и читатели54K


Привет, Хабр!
Меня зовут Радик, Head of DevOps of AGIMA!


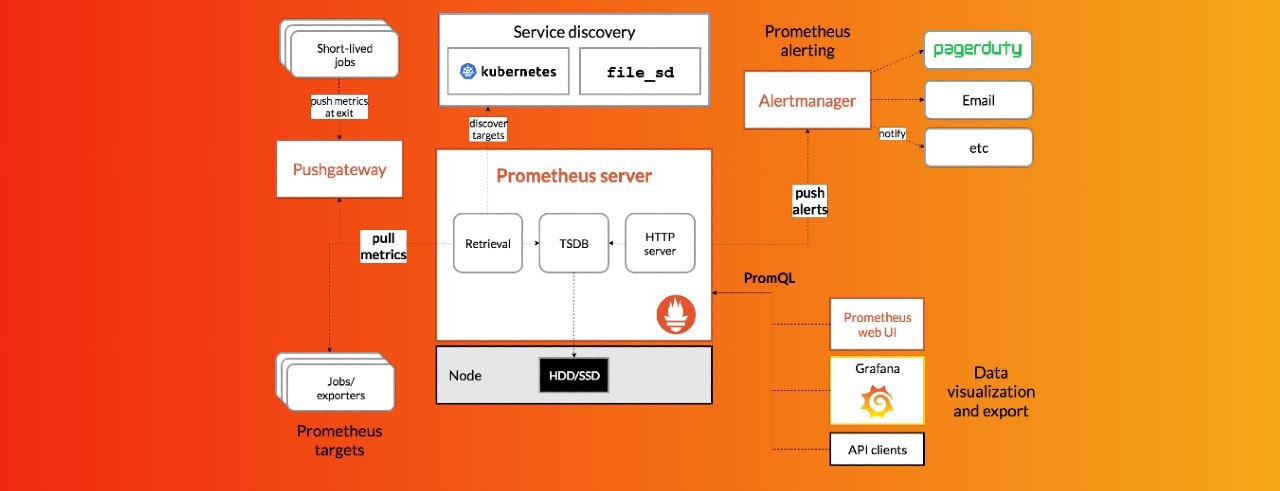
В этой статье я постарался показать, как можно использовать Prometheus в качестве системы мониторинга для микросервисной архитектуры. Подробно рассмотрел архитектуру Prometheus и взаимодействие его компонентов. Обозначил ключевые характеристики благодаря чему эта система получила такое широкое распространение в средах использующих контейнеризацию. Предупреждаю сразу: статья получилась довольно объемной. Эта статься будет полезна для начинающих DevOps специалистов, которые планируют или уже используют в своей работе Docker, Kubernetes. Итак, начнем!

Читать дальше →

Istio — это просто: Sidecar

Время чтения4 мин
Охват и читатели20K


Легко и непринужденно настраиваем Istio для уменьшения нагрузки и влияния как на control, так и на data plane, используя ресурс Sidecar.

Читать дальше →

Назад к микросервисам вместе с Istio. Часть 1

Время чтения13 мин
Охват и читатели186K


Прим. перев.: Service mesh'и определённо стали актуальным решением в современной инфраструктуре для приложений, следующих микросервисной архитектуре. Хотя Istio может быть на слуху у многих DevOps-инженеров, это довольно новый продукт, который, будучи комплексным в смысле предоставляемых возможностей, может потребовать значительного времени для знакомства. Немецкий инженер Rinor Maloku, отвечающий за облачные вычисления для крупных клиентов в телекоммуникационной компании Orange Networks, написал замечательный цикл материалов, что позволяют достаточно быстро и глубоко погрузиться в Istio. Начинает же он свой рассказ с того, что вообще умеет Istio и как на это можно быстро посмотреть собственными глазами.

Istio — Open Source-проект, разработанный при сотрудничестве команд из Google, IBM и Lyft. Он решает сложности, возникающие в приложениях, основанных на микросервисах, например, такие как:
Читать дальше →

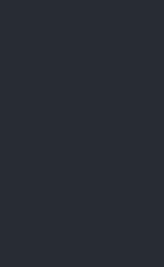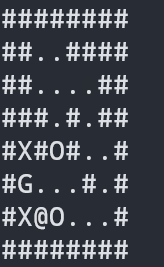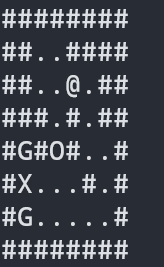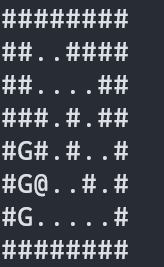
AI на минималках: пишем свой Сокобан и учим компьютер его решать

Время чтения13 мин
Охват и читатели15K

Компьютер играет в Сокобан


В этой статье я расскажу как написать свою реализацию известной игрушки Сокобан, а также алгоритм для её решения с нуля. Заодно применю на практике некоторые шаблоны проектирования и принципы SOLID.


Весь код расположен по адресу

Читать дальше →

5 приемов и хитростей для работы с SSH и кое-что ещё

Время чтения8 мин
Охват и читатели28K
image

В этой статье мы поговорим о полезных приемах и командах при работе с SSH. А именно:

  • Как использовать двухфакторную аутентификацию для SSH-подключений.
  • Безопасное использование «проброса ключа» (agent forwarding).
  • Завершение зависшей сессии.
  • Оставляем терминал открытым при выходе или разрыве связи.
  • Расшариваем удаленный терминал с другом (без Zoom!).
Читать дальше →

Мой маленький Kubernetes: настраиваем тестовый кластер в VirtualBox

Время чтения13 мин
Охват и читатели48K

За последние пару лет мне довольно часто приходилось сталкиваться с Kubernetes, однако обычно это всегда происходило с позиции разработчика. Посмотреть список подов, их статусы, логи и т.п. В общем, ничего сложного.

Недавно я решил заняться изучением Kubernetes чуть глубже, чтобы лучше понимать, как он работает и что умет. Но тут возникла очевидная проблема: нужна какая-то песочница, в которой можно было бы экспериментировать, не боясь при этом что-то сломать, а ещё лучше иметь возможность в любой момент откатиться назад.

Обычно изучение Kubernetes стоит начинать с minikube - консольной утилиты, которая умеет быстро создавать кластер из одного узла с использованием VirtualBox. Это самый лучший вариант для быстрого старта.

Но есть и другой вариант. Можно взять VirtualBox, создать несколько виртуальных машин, например, с Ubuntu Server и настроить небольшой кластер Kubernetes прямо на своём домашнем компьютере.

Я решил пойти по второму пути, но по ходу настройки начал сталкиваться с различными проблемами, решение которых было для меня не так очевидно, как хотелось бы. Вообще в интернете можно найти достаточно много статей на английском языке, где описан процесс настройки, но, к сожалению, ни одна из них не была для меня достаточно полной. Пришлось собирать информацию по кусочкам из разных источников.

Здесь я решил собрать всё вместе и описать процесс настройки небольшого кластера Kubernetes с использованием VirtualBox настолько подробно, насколько мне самому хотелось бы его видеть. Надеюсь, что эта информация сможет помочь другим разработчикам в их экспериментах.

Осторожно, трафик! В статье очень много скриншотов.

Читать далее

Новые ограничения в использовании Docker Hub и как GitLab реагировал на их ввод

Время чтения5 мин
Охват и читатели12K

Ни для кого уже не новость, что начиная с 2 ноября 2020 года Docker Hub ввел ограничения на скачивание образов: для анонимных пользователей он будет равен одной сотне за шесть часов, а для авторизованных пользователей будет зависеть от уровня подписки.

В компании GitLab мы очень внимательно следили за этими изменениями, так как они затрагивали практически наших пользователей и клиентов. Сегодня я хотел бы рассказать о том, какие изменения мы внесли и как адаптировались к новым правилам.

Читать далее

Продвинутая Helm-шаблонизация: выжимаем максимум

Время чтения10 мин
Охват и читатели51K


Стандартной Helm-библиотеки и привычных подходов к написанию Helm-чартов обычно хватает для автоматизации несложных приложений. Но когда количество и сложность Helm-чартов растут, то минималистичных Go-шаблонов и неоднозначной стандартной Helm-библиотеки быстро перестаёт хватать. В этой статье речь пойдет о том, как сделать ваши Helm-шаблоны гораздо более гибкими и динамичными, реализуя свои собственные «функции» в Helm, а также эксплуатируя tpl.

NB. Всё описанное было проверено с werf, но так как шаблоны в этой утилите практически идентичны Helm-шаблонам, то и всё нижеприведенное будет полностью или почти полностью совместимо с обычным Helm обеих версий (v2 и v3).

А теперь разберем, как получить от Helm-шаблонов всё, что можно… и даже всё, что нельзя!
Читать дальше →

Terraform: новый подход к Infrastructure as code

Время чтения9 мин
Охват и читатели232K
Привет, коллеги! Пока блистательный Илон Маск вынашивает амбициозные планы терраформирования Марса, мы интересуемся новыми возможностями, связанными с парадигмой "Infrastructure as Code" и хотим предложить вам перевод статьи об одном из представителей «великолепной семерки» — Terraform. Книга Евгения Брикмана по теме неплохая, но ей скоро год, так что просим высказаться — хотите ли увидеть ее на русском языке

Слово Камалу Мархуби (Kamal Marhubi) из компании Heap.
Читать дальше →

Как импортировать существующие виртуальные машины VMWare в Terraform

Время чтения6 мин
Охват и читатели11K

Terraform — это потрясающее средство для автоматизации управления инфраструктурой. Все параметры вашей инфраструктуры можно записать в виде кода, который будет обслуживаться соответствующей группой. Это означает, что ваша инфраструктура будет прозрачной и не будет подвержена неожиданным изменениям.

Возможно, вы уже знаете, что в Terraform можно импортировать существующую инфраструктуру, после чего дальнейшее управление этой инфраструктурой осуществляется уже в Terraform. В целом это вполне обыкновенный процесс для облачной инфраструктуры, однако я заметил, что некоторые инженеры сталкиваются с трудностями при импорте имеющихся у них виртуальных машин VMWare. Поэтому я написал это краткое руководство о том, как импортировать существующие виртуальные машины VMWare в Terraform. Продемонстрировано это будет на примере импорта одной виртуальной машины.

Читать далее

Использование journalctl для просмотра и анализа логов: подробный гайд

Время чтения6 мин
Охват и читатели398K


Journalctl — отличный инструмент для анализа логов, обычно один из первых с которым знакомятся начинающие администраторы linux систем. Встроенные возможности ротации, богатые возможности фильтрации и возможность просматривать логи всех systemd unit-сервисов одним инструментом очень удобны и заметно облегчают работу системным администраторам.

Эта статья рассматривает основные возможности утилиты journalctl и различные варианты ее применения. С помощью journalctl можно просматривать логи системы, чтобы решить возникшие проблемы на рабочей станции или сервере использующие дистрибутив linux с демоном инициализации systemd, де-факто уже ставшим стандартом в современных Linux-системах, например: RHEL, CentOS, Fedora, Debian и многих других.

Существует мнение, что systemd не так уж и хорош — он нагружает систему и это все еще предмет для споров на сегодняшний день, но нельзя отрицать, что он предоставляет прекрасный набор инструментов для управления системой и поиска проблем. Представьте, что вам приходится иметь дело с проблемным сервером, который даже не загружается — в таком случае можно загрузиться с live-дистрибутива, смонтировать системный раздел и просмотреть логи systemd, чтобы понять, в чем проблема.
Читать дальше →

Шпаргалка полезных команд GDB

Время чтения3 мин
Охват и читатели90K

Для кого она нужна?


1) начинающих реверсеров, знающих особенности обратного проектирования, и желающих изучить такой отладчик как GDB


2) как подсказка тем кто постоянно работает с IDA, Ghidra или любым другим мощным и надежным инструментом, но в силу тех или иных обстоятельств решить задачу проще и быстрее с помощью GDB, и не очень хочется залезать в официальную документацию и снова все вспоминать

Читать дальше →

Xудшие практики для Ansible. Георгий Шуклин

Время чтения20 мин
Охват и читатели27K


Приветствую всех! Меня зовут Георгий. Я работаю в компании servers.com. Я пришел рассказать про Ansible: про хороший Ansible и про плохой Ansible в основном, т. е. про то, как люди могут плохо делать на Ansible.

Достать до звезд: Осваиваем операторы Ansible для управления приложениями в Kubernetes

Время чтения9 мин
Охват и читатели17K
Посмотрим, как использовать опубликованные в Ansible Galaxy роли (Role) в качестве операторов (Operator), управляющих приложениями в Kubernetes, и разберем это на примере создания оператора, который просто устанавливает приложение, гибко настраивая свое поведение в зависимости от среды.


Мы будем использовать Ansible Operator и модуль k8s, чтобы показать, как применять Ansible для создания Kubernetes-приложений.
Читать дальше: Осваиваем операторы Ansible для управления приложениями в Kubernetes

Как я сдавал Certified Kubernetes Security

Время чтения8 мин
Охват и читатели11K

Всем привет.

Хочу поделиться своим опытом успешной сдачи экзамена Certified Kubernetes Security (CKS) от Linux Foundation. Данный экзамен, как нетрудно догадаться, проверяет наши способности настраивать различные аспекты безопасности кластера Kubernetes и приложений, работающих в нем. Экзамен мне понравился, он рассматривает безопасность с различных точек зрения, а также использует очень полезные внешние инструменты, такие как Falco, Trivy, kube-bench, Open Policy Agent, gVisor и др. Сам экзамен мне показался умеренно сложным, в отличие от CKA, который больше ориентирован на новичков в Kubernetes.

Вначале я расскажу в целом об экзамене и подготовке к нему, а затем перейду к темам, затрагиваемым на экзамене.

На текущий момент существует всего два экзамена по безопасности Kubernetes - это, собственно, сам CKS, а также Red Hat Certified Specialist in Security: Containers and OpenShift, имеющий дело с безопасностью OpenShift. Эти два экзамена во многом пересекаются, однако по Опеншифту я считаю экзамен все же сложнее (его я благополучно завалил).

Экзамен отдельно стоит стоит 300$, официальный курс Kubernetes Security Fundamentals (LFS260) стоит 299$, можно купить курс и экзамен вместе за 499$. Я купил курс и экзамен вместе за 200$ на традиционной предновогодней распродаже от Linux Foundation.

Необходимым условием для сдачи CKS является наличие действующего сертификата CKA (Certified Kubernetes Administrator). Вы можете купить CKS, но не сможете назначить экзамен, пока не получите CKA. Звучит логично, поскольку экзамен CKS является гораздо более сложным чем CKA.

Но ближе к делу. Для подготовки я использовал два курса:

Читать далее

Настройка отказоустойчивого кластера Kubernetes на серверах с публичной и приватной сетью с помощью Kubeadm

Время чтения27 мин
Охват и читатели29K

У меня возникла задача настроить отказоустойчивый Bare Metal кластер для комплексного приложения, в связи с чем и возникла данная статья. Сразу хочу сказать, что не являюсь экспертом в K8S, однако имею опыт развертывания продуктовых кластеров DC/OS (экосистемы, основанной на Apache Mesos).

Долгое время K8S меня отпугивал тем, что, при попытке его изучения, тебя закидывают кучей концепций и терминов, отчего мозг взрывается.

Читать далее

Kubernetes Ingress глазами новичка

Время чтения3 мин
Охват и читатели137K

Что такое ingress?


Ingress это базовый тип ресурса в кубертенесе. Если просто объявить объект типа Ingress в кубернетисе то ничего не произойдет.


Что бы этот ресурс начал работу в кластере кубернетиса должен быть установлен Ingress Controller, который настроит реверсивный прокси в соответствии с Ingress объектом.


Ingress Controller состоит из 2х компонентов — реверсивного прокси и контроллера который общается с API сервером кубернетеса. Реверсивный прокси слушает входящий трафик на портах которые указаны в настройках (обычно в настройках по умолчанию указан только порт 80). Контроллер может быть как отдельным демоном (как в nginx), так и встроенным в прокси (как в traefik).


Не все клауд провайдеры кубернетеса предустанавливают Ingress Controller по умолчанию.


Контроллеры могут запускаться либо как DaemonSet либо как Deployment. DaemonSet идеально использовать как единственный Ingress Controller, что бы реверсивное прокси слушало на всех IP адресах воркеров. Deployment отлично подходит если перед Ingress контроллером стоит балансировщик — от провайдера кубернетиса (GKE, AKS), MetalLB если онпремис или обычный haproxy/nginx установленный на сервере (требутеся ручная настройка). При этой установке возможно установить несколько Ingress Controller.

Читать дальше →

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность

Специализация

Системный администратор, DevOps-инженер
Linux
Python
Docker
Git
MongoDB
Bash