Обновить
3

Пользователь

Отправить сообщение

Чистка GitLab Registry для Kubernetes админов

Время чтения4 мин
Охват и читатели14K

В наше время в каждом доме по кластеру kubernetes, выкатка приложений в кластер осуществляется по тегу. Образ выкатываемого приложения отправляется c тегом в репозиторий проекта Registry GitLab, которое постепенно распухает до невероятных размеров.

Но все побеждаемо

Что такое модули Terraform и как они работают?

Время чтения5 мин
Охват и читатели36K

Многие новички пропускают настройку модулей Terraform, чтобы облегчить процесс настройки. По крайней мере, они так думают, что облегчили себе задачу. Рассмотрим что такое модули Terraform и как они работают.

Читать дальше →

werf vs. Helm: корректно ли их вообще сравнивать?

Время чтения9 мин
Охват и читатели12K

Эта статья — развернутый ответ на вопрос, который нам периодически задают: чем werf отличается от Helm? На первый взгляд можно предположить, что задача у них примерно одинаковая: автоматизировать деплой приложений в Kubernetes. Но всё, конечно, немного сложнее…

Читать далее

Как Asana использует Kubernetes

Время чтения5 мин
Охват и читатели3.3K

image


В Asana мы используем Kubernetes для развертывания сервисов и управления ими независимо от монолитной инфраструктуры. Поначалу у нас были некоторые проблемы, и чтобы стандартизировать создание и обслуживание приложений Kubernetes, мы создали фреймворк с незамысловатым названием KubeApps. В последние два года наша команда по инфраструктурной платформе вносила улучшения в KubeApps, чтобы упростить развертывание сервисов в Asana. Здесь мы расскажем, какие проблемы мы хотели решить в Kubernetes и как мы это сделали с помощью фреймворка KubeApp.

Читать дальше →

Тестирование ansible роли для RabbitMQ кластера с помощью molecule

Время чтения10 мин
Охват и читатели5.6K

Molecule — это фреймворк, предназначенный для тестирования ролей в Ansible. На хабре довольно много статей про тестирование с помощью molecule и почти во всех статьях говорится о неких "сложных сценариях тестирования для ansible", и далее в примерах обычно идут какие-то простенькие роли и тесты. Мне стало интересно протестировать более сложную роль, например роль для создания RabbitMQ кластера.

Используемые версии программ на момент написания статьи. Не гарантируется корректная работа для molecule версии ниже 3.3

debian 10 Buster

ansible-3.4.0

molecule-3.3.0

docker-ce-20.10.6

yamllint-1.26.1

ansible-lint-5.0.8

Устанавливаем ansible и molecule.

pip3 install --user ansible (как именно устанавливать не столь важно, в приведенном примере установка идет в хоумдир пользователя).

pip3 install --user molecule[docker] (мы будем использовать драйвер докера)

Устанавливаем линтеры

pip3 install --user ansible-lint yamllint

Установка докера выходит за рамки этой статьи, стоит отметить только что докер вы можете установить на эту же машину, где будете запускать molecule или же установить докер на любую другую машину в сети (например если мощности локальной машины не хватает) или же использовать уже существующий докер сервер.

Во втором случае на локальную машину нужно установить только докер клиент и выставить переменную DOCKER_HOST="ssh://ansible@адрес_вашего_докер_сервера", где ansible - аккаунт, который имеет ssh доступ на сервер и под которым будут создаваться докер контейнеры. Аккаунт также должен состоять в группе docker на докер сервере.

Читать далее

Highly Available кластер RabbitMQ

Время чтения6 мин
Охват и читатели81K
Знакомимся с RabbitMQ

Переводы на хабре:
RabbitMQ tutorial 1 — Hello World
RabbitMQ tutorial 2 — Очередь задач
RabbitMQ tutorial 3 — Публикация/Подписка

Сразу дополню некоторые недочеты. И кратко повторю основные термины.

Принцип работы архитектуры использующей rabbitMq

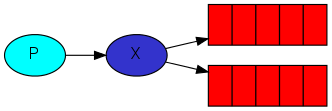
image

Читать дальше →

Антипаттерны деплоя в Kubernetes. Часть 1

Время чтения8 мин
Охват и читатели11K

В предыдущей статье 10 Docker anti-patterns мы рассказали о популярных ошибках при создании образов контейнеров. Однако создание образов для вашего приложения - это только половина дела. Вам нужен способ развёртывания этих контейнеров в производственной среде. Использование кластеров Kubernetes для решения этой задачи уже стало стандартом.

Представляем аналогичное руководство для Kubernetes. Теперь вы сможете составить полную картину того, как создать образ контейнера и как правильно его развернуть (при этом избежав некоторых распространенных ошибок).

Обратите внимание, что это руководство посвящено развёртыванию приложений в Kubernetes, но не затрагивает настройку самих кластеров Kubernetes. Предполагается, что кластер Kubernetes уже развёрнут, правильно настроен и вы просто хотите развернуть в нём ваше приложение.

В этой статье не просто перечислены известные антипаттерны деплоя в Kubernetes, но и предлагаются соответствующие решения. Вы можете проверить ваши процессы развёртывания и исправить существующие проблемы без поиска дополнительной информации.

Читать далее

Мышление миллиардера из Кремниевой долины: как принимать решения, связанные с риском

Время чтения4 мин
Охват и читатели9.5K

Пол Букхайт — создатель Gmail и FriendFeed, партнер Y Combinator. 12.09.2009 г.

Наши жизни полны решений, которые заставляют нас балансировать между риском и возможностью: должны ли вы согласиться на на эту новую работу, купить этот дом, инвестировать в эту компанию, проглотить эту таблетку, прыгнуть с обрыва и т.д. Как мы решаем, какой риск оправдан, а какой является идиотизмом? Готовы ли мы, сделав выбор, принять его последствия?

Я думаю, наиболее распространенный способ — спросить себя «Каков наиболее вероятный исход?» Если наиболее вероятный исход нам нравится, мы делаем это (если считать, что люди склонны размышлять, принимая решения). Такой подход отлично работает с большинством решений. К примеру, вы можете верить, что наиболее вероятный исход решения «учиться в школе» — это то, что позже вы получите лучшую работу, потому вы выбираете этот вариант. Так рассуждает большинство людей,  когда решают учиться в школе, искать работу, покупать дом или принимают много других «нормальных» решений. Смещая фокус на «ожидаемый» результат, люди, использующий этот подход, часто игнорируют возможный неприятный исход. И когда происходит что-то неприятное, они чувствуют горечь и обман: «Я отучился в универе, где моя работа?!» Например, большинство людей, купивших дом пару лет назад, не предполагали, что их новый дом потеряет 20% его стоимости, и в итоге они будут должны больше, чем стоит их дом.
Читать дальше →

6 занимательных системных багов при эксплуатации Kubernetes [и их решение]

Время чтения10 мин
Охват и читатели18K


За годы эксплуатации Kubernetes в production у нас накопилось немало занимательных историй, как баги в различных системных компонентах приводили к неприятным и/или непонятным последствиям, влияющим на работу контейнеров и pod'ов. В этой статье мы сделали подборку некоторых наиболее частых или интересных из них. Даже если вам никогда не повезёт столкнуться с такими ситуациями, читать о подобных кратких детективах — тем более, «из первых рук» — всегда занятно, разве не так?..
Читать дальше →

Как мы собираем общие сведения о парке из Kubernetes-кластеров

Время чтения8 мин
Охват и читатели5.7K

Имея в обслуживании большой (более 150) парк Kubernetes-кластеров, всегда хотелось иметь удобное представление их общего состояния, в том числе и для того, чтобы поддерживать их гомогенными. В статье я поделюсь нашим опытом: с чего начали и к чему пришли в реализации данной задачи.

Читать далее

Как я познавал ci/cd, Гитхаб экшены

Время чтения5 мин
Охват и читатели35K

Гитхаб экшены, как я познавал ci/cd

   Всем Алоха. Все слышали про ci/cd, про то что он должен быть в каждой компании и то что он упрощает нам жизнь. У всех свой ci/cd. 

   Кто-то предпочитает Jenkins. Особенно если у вас куча микросервисов, команд и процессов, то при помощи Дженкинса можно достаточно гибко настроить ci/cd в компании. Кто-то использует GitLab actions и для каждого репозитория настраивает свои пайплайны и процессы. Достаточно удобно и просто настраиваемый механизм сборки и доставки артефактов на стенды. Не чуть не хуже GitHub actions. Это было открытием для меня что в GitHub появился такой функционал, о котором мы поговорим позже. Ну и конечно всеми «любимый» скриптовый ci/cd. Пачка скриптов, которые нужно выполнить в определенной последовательности чтобы собрать и задеплоить артефакты. Есть ещё так сказать хэнд мэнуал ci/cd. Но это особый вид извращения, с которым не пожелаю столкнуться никому. В котором нужно собрать артефакты у себя на машине и по какому нить ридми выполнять команды в терминале, лазить по ssh смотреть, что все копировалось, перезапускать сервисы и другие развлечения. 

    Передо мной стояла задача спроектировать и написать новый сервер для проекта. Изначально я закидывал джарники на сервак руками, чтобы проверить работоспособность и настроить сервер. Хэнд мэнуал деплой. В какой то момент меня это начало бесить и я задумался об автоматизации этого процесса. Как вы понимаете девопса или того кто шарит в этом у меня под рукой в компании не оказалось. Очень круто, если у вас есть такой человек. У меня был выбор сделать скрипт деплой, чего я искренне не хотел, потому что в целом не любитель копаться в терминале и скриптах, когда этого можно избежать. Поднять дженкинс и настроить там джобы и пайплайны. Вариант оч классный для большой компании, а мне нужен деплой лишь одного сервера, а не тысячи микросервисов. Да и чего таить, знаний как настраивать дженкинс с нуля у меня было чуть меньше чем ноль. 

Read more about GitHub Actions

Разбираем в деталях: Технология единого входа (SSO) в Kubernetes с использованием OpenID Connection через G Suite

Время чтения7 мин
Охват и читатели9.5K

В настоящее время Kubernetes де-факто является стандартом для оркестрации контейнеров, и лично я использую Kubernetes в production уже более двух лет.


Будучи DevOps инженерами, мы тесно сотрудничаем с разработчиками и используем одни и те же инструменты такие, как: CI-CD, VCS, laC, мониторинг, логирование, оркестрацию контейнеров и т.д. Kubernetes также является одним из таких инструментов, который тоже используется во время разработки, развёртывания и отладки, устранения неполадок и мониторинга приложений. Как все знают, это требование DevOps культуры.


Читать дальше →

Эволюция распределённых систем в Kubernetes

Время чтения16 мин
Охват и читатели11K

image
Фото Cenk Batuhan Özaltun, Unsplash.com


Обзор


  • Облачные платформы должны предоставлять современным распределённым приложениям возможности, связанные с управлением жизненным циклом, взаимодействием, привязками и состояниями.
  • Kubernetes хорошо поддерживает управление жизненным циклом, но для остального использует другие платформы с помощью концепции sidecar-контейнеров и операторов.
  • В будущем распределённые системы на базе Kubernetes будут состоять из нескольких сред выполнения, где бизнес-логика будет ядром приложения, и «меха»-компоненты (прим. переводчика: «меха» — сокращение от mechanics) в виде сайдкаров будут предлагать большие возможности в виде распределённых примитивов «из коробки».
  • Такая разделённая меха-архитекура связывает элементы бизнес-логики и улучшает операции второго дня, вроде патчинга, апгрейдов и долгосрочной поддержки.

На конференции QCon в марте я рассказывал об эволюции распределённых систем в Kubernetes. Главный вопрос: что будет после микросервисов? У вас наверняка есть мнение на этот счет. У меня оно тоже есть. В конце вы узнаете, что я думаю. Но для начала давайте обсудим потребности распределённых систем. Как эти потребности развиваются с годами, начиная с монолитных приложений до Kubernetes и таких новых проектов, как Dapr, Istio, Knative, и как они меняют наши методы работы с распределёнными системами. Попробуем сделать несколько прогнозов на будущее.

Читать дальше →

werf vs Docker. Чем лучше собирать образы

Время чтения13 мин
Охват и читатели15K

Продолжаем серию публикаций «werf vs...», которая вдохновлена часто задаваемыми вопросами. В первой статье мы объяснили, чем werf отличается от Helm. Теперь черед сравнения с еще более базовой утилитой — Docker.

Нас нередко спрашивают: зачем собирать образы с werf, если уже есть Docker с Dockerfile? Обычно мы отвечаем, что werf — не только про сборку. Утилита участвует в полном цикле CI/CD для доставки приложения в Kubernetes, а Docker при этом тоже используется, но как вспомогательный инструмент. Понятно, что такого объяснения недостаточно, нужны подробности.

Этот материал главным образом для тех, кто мало или совсем не знаком с werf, но знает Docker и хотя бы немного работал с ним. Для начала, как и в случае с Helm, попробуем разобраться, есть ли смысл в противопоставлении двух решений.

Читать далее

Бесплатный персональный OpenVPN-сервер на базе Oracle Cloud

Время чтения6 мин
Охват и читатели115K

На этот раз статья будет короткой и во многом самоочевидной. Потому что большинство потенциальных пользователей просто не знают о такой возможности, а сама настройка проста, как апельсин.

Oracle, придя на рынок облачных сервисов, активно привлекает новых клиентов. И одним из инструментов такого привлечения являются Always Free сервисы - зарегистрировавшийся клиент может пользоваться каким-то достаточно ограниченным набором ресурсов, как это следует из названия, бесплатно и неограниченно во времени. В список этих ресурсов входит два compute инстанса (каждый 2 ядра, 1GB RAM, 45GB HDD), которые можно использовать подо что угодно, но в нашем случае мы можем построить на них полностью бесплатный OpenVPN-сервер, буквально не умея практически ничего, кроме тыкания в кнопку Next. Чем мы и займемся.

Читать далее

Наглядно о том, как работает NumPy

Время чтения8 мин
Охват и читатели57K

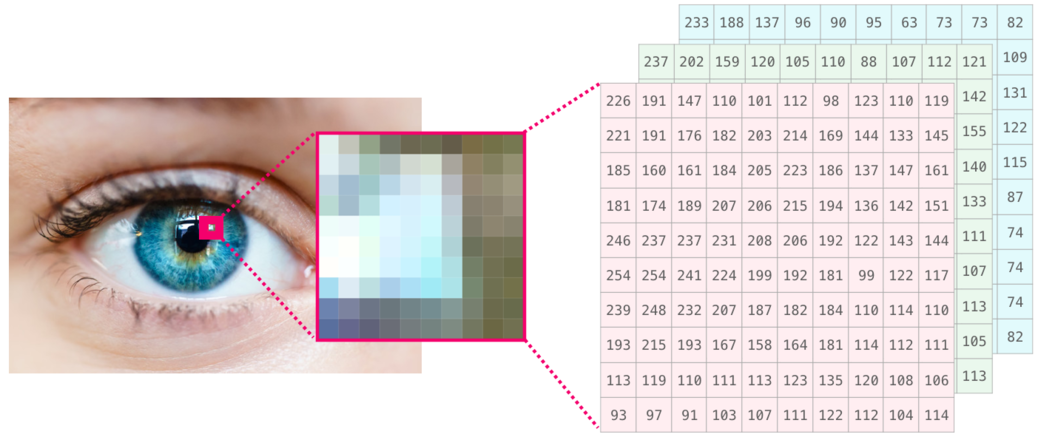
Есть тексты, похожие на вино или динамит: с годами они не стареют, а напротив приобретают вес и значимость. Сегодня, к старту флагманского курса о Data Science, мы решили поделиться переводом визуального учебного руководства о NumPy 2019 года, прочитав которое даже не слишком близкий к математике человек поймёт, как работает эта библиотека Python. Если вы не хотите долго объяснять NumPy, но делать это всё равно приходится, положите статью в закладки и она сэкономит ваше время.

Читать далее

Передатчик для FMCW георадара

Время чтения7 мин
Охват и читатели12K

Всем привет! Хочу поделиться своей историей разработки передатчика для ЛЧМ радара непрерывного излучения с полосой сигнала 1000МГц и величиной нелинейности изменения частоты 10-4%. Такой передатчик в дальнейшем будет применен в FMCW георадаре (Frequency-Modulated Continuous Wave — радиолокатор непрерывного излучения с частотной модуляцией).

Читать далее

Хорошо подумайте, прежде чем использовать Docker-in-Docker для CI или тестовой среды

Время чтения6 мин
Охват и читатели65K


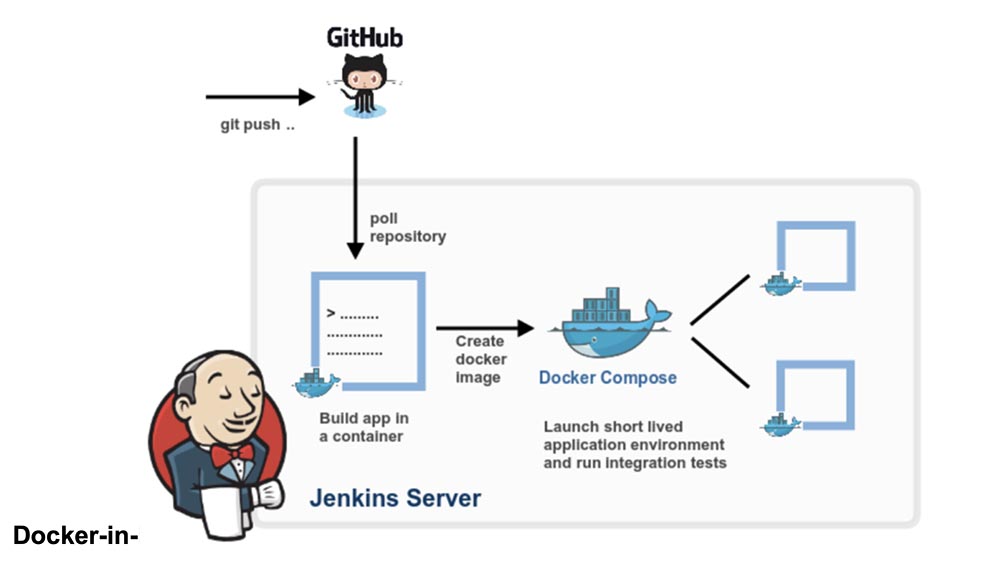
Docker-in-Docker представляет собой виртуализированную среду Docker-демон, запущенную в самом контейнере для сборки образов контейнера. Основной целью создания Docker-in-Docker была помощь в разработке самого Docker. Многие люди используют его для запуска Jenkins CI. Поначалу это кажется нормальным, но затем возникают проблемы, которых можно избежать, установив Docker в контейнер Jenkins CI. В этой статье рассказывается, как это сделать. Если вас интересует итоговое решение без подробностей, просто прочитайте последний раздел статьи «Решение проблемы».

Читать дальше →

Понимание итераторов в Python

Время чтения8 мин
Охват и читатели183K

Python — особенный язык в плане итераций и их реализации, в этой статье мы подробно разберём устройство итерируемых объектов и пресловутого цикла for.


Особенности, с которыми вы часто можете столкнуться в повседневной деятельности


1. Использование генератора дважды


>>> numbers = [1,2,3,4,5]

>>> squared_numbers = (number**2 for number in numbers)

>>> list(squared_numbers)
[1, 4, 9, 16, 25]

>>> list(squared_numbers)
[]

Как мы видим в этом примере, использование переменной squared_numbers дважды, дало ожидаемый результат в первом случае, и, для людей незнакомых с Python в достаточной мере, неожиданный результат во втором.


2. Проверка вхождения элемента в генератор


Возьмём всё те же переменные:


>>> numbers = [1,2,3,4,5]
>>> squared_numbers = (number**2 for number in numbers)

А теперь, дважды проверим, входит ли элемент в последовательность:


>>> 4 in squared_numbers
True
>>> 4 in squared_numbers
False
Читать дальше →

10 лет on-call. Чему мы научились? (обзор и видео доклада)

Время чтения12 мин
Охват и читатели12K
Осенью прошлого года на конференции DevOops 2019 прозвучал доклад «10 лет on-call. Чему мы научились?». В нём рассказывается о том, почему мы отказались от внутреннего «акселератора» по развитию дежурных до DevOps-инженеров, как эволюционировала наша служба технической поддержки и система обработки инцидентов в целом.


Представляем видео с докладом (~63 минуты, гораздо информативнее статьи) и основную выжимку из него в текстовом виде. Поехали!

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность

Специализация

Системный администратор, DevOps-инженер
Linux
Python
Docker
Git
MongoDB
Bash