Обновить
2

Software engineer

1
Подписчики
Отправить сообщение

AI-агент в проде для тех, кто вкатывается: инструменты, RAG, надёжность и проверки

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели13K

Агент застрял и сделал 100 ходов вместо 30. Ходов в 3,3 раза больше, а денег в 5,3 раза: каждый ход заново читает всю историю. А если процесс упал на 25-м ходе и задачу запустили с нуля, она дорожает на 81%, и все уже сделанные действия повторятся. Письмо клиенту уйдёт дважды.

Собрал практики, которые отделяют агента из демо от агента в проде. Какие инструменты давать модели и как держать контекст коротким. Когда RAG не нужен вовсе, а когда поиск по словам и переранжирование сокращают провалы с 5,7% до 1,9%. Как ограничить цикл и бюджет, какие ошибки повторять, как сделать инструмент идемпотентным, зачем Temporal и как спрашивать подтверждение у человека. Плюс наблюдаемость, проверки, защита от prompt injection и чек-лист из 13 пунктов.

Почему письмо уйдёт дважды

Может ли ИИ писать автотесты за QA-инженера? Проверили на реальных задачах

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели9.7K

Привет, Хабр! Меня зовут Евгения Мясникова, я QA-инженер SpaceWeb. Передавать искусственному интеллекту рутинные задачи тестирования — подготовку черновиков тест-кейсов, первичное покрытие, оценку трудозатрат и другие — уже стало привычной практикой. Однако при таком разнообразии инструментов важно понять, как эффективно встроить ИИ-агентов в рабочие процессы и распределить задачи между специалистом и нейросетью.

В этой статье расскажу, как мы совместно с руководителем отдела исследований и разработки SpaceWeb Виталием Киреевым разработали первоначальную модель взаимодействия QA-специалиста с LLM. Для работы с чувствительными данными мы интегрировали агента с локальной моделью Qwen3.8-27B. На реальных примерах покажу, в каких задачах ИИ действительно нам помог, а где его применение пока вызывает вопросы.

Читать далее

Lighthouse CI: автоматизируем проверку производительности сайта

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6K

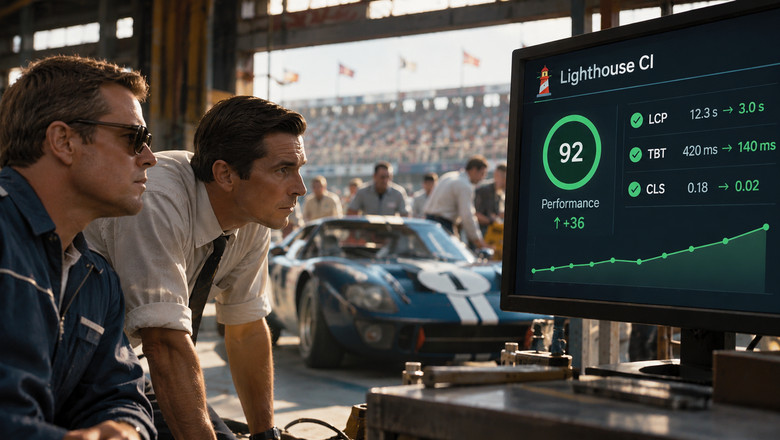
Проверить производительность веб-приложения через Lighthouse несложно. Но после очередного изменения в коде показатели могут ухудшиться, и если запускать аудит только вручную, такие изменения легко пропустить.

В своём проекте я решил автоматизировать проверки с помощью Lighthouse CI и GitHub Actions, чтобы регулярно отслеживать метрики производительности и замечать регрессии.

В статье покажу, как настроить такие проверки, какие метрики стоит контролировать и как анализировать результаты. Также поделюсь практическим примером из своего проекта, где после оптимизации удалось снизить LCP с 12,3 до 3,0 секунды.

Читать далее

Бот уже отвечает. А продукт где? История разработки сервиса с ИИ

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели37K

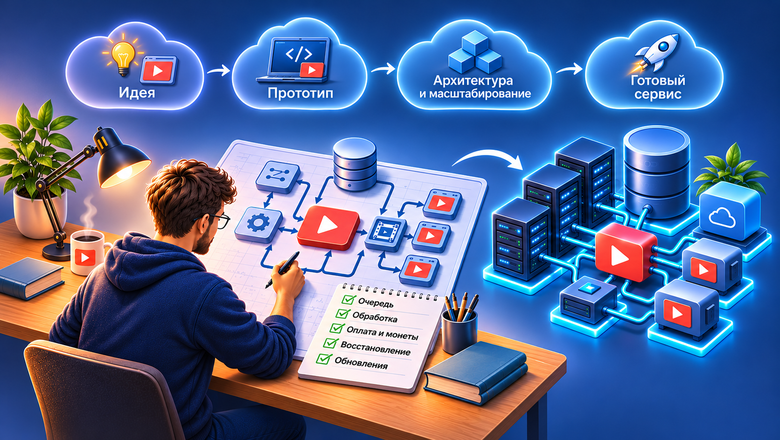
Друг принёс Telegram-бота, собранного с помощью ИИ: видео обрабатываются, кнопки работают, осталось арендовать сервер. Потом выяснилось, что параллельное приложение умеет параллельно ждать одну блокировку, а двенадцать обработчиков иногда медленнее пяти. Рассказываю, как мы превращали вайбкод в сервис: от SQLite до PostgreSQL, очередей, общего хранилища и деплоя по кнопке. И почему промпт «сделай хорошо» всё ещё не заменяет инженерные знания.

От вайбкода к продакшену

Как разработчику из РФ начать принимать платежи через App Store без ВНЖ

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели6.2K

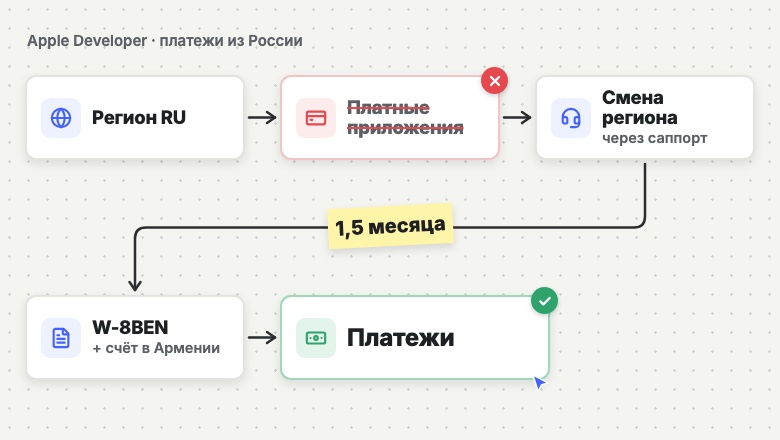
Всем привет! Хочу поделиться личным опытом того, как после переезда из России мне удалось начать принимать оплату в своих iOS приложениях, будучи гражданином РФ без ВНЖ. Расскажу, как менял регион аккаунта с России на Армению через саппорт Apple, как заполнял W-8BEN и что нужно, чтобы зарегистрировать аккаунт на юрлицо.

Читать далее

Я устал от VLESS-клиентов и написал свой. Rust, EvertyUI, Mihomo и немного экспериментов с ИИ

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели112K

Привет, Хабр!

Меня зовут Артур Валиев и в какой-то момент я поймал себя на мысли, что для подключения к VPN мне приходится открывать приложение, в котором настроек едва ли не больше, чем в самом Windows.

Читать далее

Своя CRM для инженерной компании: как мы вдвое сократили цикл сделки

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели8K

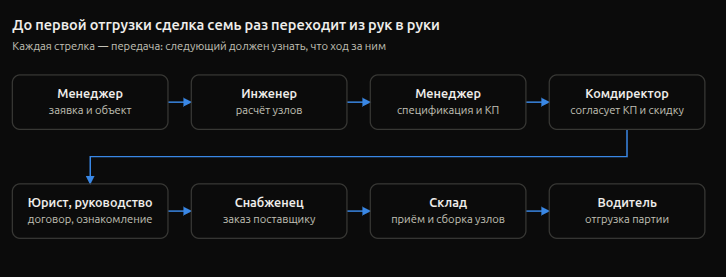
Мы продаём инженерные узлы для отопления и водоснабжения многоэтажек. Каждая сделка — расчёт под конкретный дом, коммерческое предложение, договор, закуп, сборка и отгрузки партиями по графику стройки. Ещё недавно эта цепочка жила в Битрикс24, отдельном калькуляторе, 1С и рабочих чатах.

Мы написали свою CRM. Раньше от заявки до подписанного договора проходило около двух месяцев, теперь — около месяца: сделки закрываются примерно вдвое быстрее. Сильнее всего сократился первый отрезок: раньше КП уходило заказчику через 3–4 дня после заявки, теперь — на следующий день. Ниже — где на самом деле терялось время, что мы для этого сделали и на какие грабли наступили.

Читать далее

Встроенная виртуальная файловая система node:vfs вошла в состав Node.js

Время на прочтение3 мин
Охват и читатели5.3K

В состав среды выполнения Node.js вошел экспериментальный модуль node:vfs, позволяющий организовывать данные в виртуальные файлы и каталоги без их прямого размещения на физическом диске. Первая версия функциональности появилась в версии Node.js 26.4.0, после чего инструмент получил интеграцию с загрузчиком модулей и поддержку архивов. Для работы с виртуальной файловой системой требуется передать флаг --experimental-vfs.

Модуль объединяет провайдер хранения данных с интерфейсом, аналогичным стандартному модулю node:fs. Вызов метода mount() резервирует изолированное пространство имен, путь к которому выбирается автоматически средой исполнения. На системах POSIX используется путь вида /dev/null/vfs/0, а в Windows применяется соответствующее пространство имен null-устройства. Запрошенный путь внутри смонтированной системы принадлежит исключительно этой виртуальной файловой системе, поэтому при отсутствии файла поиск на физическом диске не выполняется.

Читать далее

Комнатный RAG: бесплатный ИИ-помощник-консультант по содержимому сайта

Уровень сложностиСредний
Время на прочтение20 мин
Охват и читатели10K

Можно ли превратить обычный сайт небольшой компании в ИИ-консультанта и уложиться в бесплатные квоты хостинга? На примере показываем, как собрали такого помощника с агентом на платформе Cloudflare.

Внутри — семь этапов: от подготовки базы и сравнения моделей до проверки темы, ограничений расхода и ссылок на разделы сайта. Разбираем реальные ошибки: выдуманные кейсы, пустые ответы и “сортировку на Python” вместо консультации по услугам сайта. Скриншоты, пошаговая инструкция для воссоздания и ссылка на работающий чат.

Как мы это собрали

Оптимизация сайта под нейросети

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели9.8K

«Спросил у ChatGPT про вашу компанию — он назвал трех конкурентов». Если вы работаете с сайтами, такую фразу вы слышали уже не раз. При этом сайт в топе, трафик из поиска идет, конверсии в порядке. А нейросеть либо не знает о вас, либо рассказывает о компании по данным двухлетней давности.

Первая реакция — переписать тексты, добавить экспертизы, оформить FAQ. Мы проходили этот путь: гипотеза про «мало контента» выглядит логично, но почти никогда не подтверждается. Отвечает нейросеть не по вашему тексту, а по тому, что до нее дошло. И вот тут начинается самое интересное.

Когда мы прогнали свой сайт через запросы к разным моделям и посмотрели, что именно получает их инфраструктура, картина оказалась прозаичной. Часть ИИ-краулеров не исполняет JavaScript. Для сайта, который собирается в браузере, это означает одно: до модели вместо статьи доезжает пустой каркас. Пользователь видит прекрасную страницу, а нейросеть — пустой файл.

В этой статье разберем, как устроено чтение сайтов системами ИИ, где контент теряется на пути от сервера к ответу модели и что из этого можно проверить и починить.

Читать далее

Моя CRM в Obsidian на плагине Operon

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели14K

В начале сентября я провёл вканале интерактив: предложил подписчикам написать в комментариях свою профессию и пообещал каждому прислать эскиз системы в Obsidian под его работу. Эскиз — это буклет на 3 страницы: какие разделы нужны хранилищу юриста, психолога или инженера, как между ними ходит информация и какими плагинами это собирается. Профессию назвали 20 человек. Каждому ушёл буклет в личку, дальше пошли переписки и записи на консультации. Через неделю я уже не помнил, кому что отправил и кому обещал ответить. До этого лидов я не вёл никак, их было мало и все помещались в голове. Отдельный сервис заводить не хотелось: задачи, клиентские проекты и заметки по встречам у меня и так в Obsidian. В этой статье расскажу, как я собрал CRM на плагине Operon и что в нём допилил. Следующие раунды интерактива буду объявлять в канале.

Читать далее

Что мы на самом деле открываем?

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели9.7K

Начну со своего проекта.

Я буквально чудом поднял для EvertyDesk крутой автотестовый стенд, на котором сейчас гоняю кучу разных сценариев. Иногда у меня уходят недели просто на то, чтобы воспроизвести какую-то маленькую аномалию, понять, существует ли она вообще, поймать нужное состояние и наконец разобраться, что именно происходит.

И в какой-то момент я поймал себя на довольно неприятной мысли.

Есть люди с деньгами, большими лимитами и доступом к невероятным современным моделям ии. Есть сами модели, которые уже умеют разбирать большие кодовые базы, искать связи, читать тесты, объяснять архитектуру. И я не знаю, будет ли это в десять раз быстрее или в сто — да это, наверное, и неважно.

Важно другое.

Я трачу недели на то, чтобы получить ответ. А если потом просто открою весь репозиторий, кто-то другой начнёт уже с этого ответа.

Он получит не только код. Он увидит, что я тестирую, какие состояния считаю важными, где ставлю проверки, какие ошибки вообще допускаю возможными, как воспроизвожу редкие случаи и почему какие-то части системы выглядят именно так.

Читать далее

Делаем RAG‑систему с нуля

Время на прочтение19 мин
Охват и читатели15K

У меня с давних времен сохранилась куча всяких заметок, в основном в виде простых текстовых файлов.
Самых разных: от скриптов и конфигов до всяких рецептов, всё что когда-то пригодилось или могло пригодиться.

Хранение в виде файлов - это на самом деле очень удобно: их практически всегда можно прочитать, их легко создавать и редактировать, они не требуют установки каких-то специальных особых редакторов и информационных систем, при этом их легко копировать, добавлять в архивы и т.д.
И даже полнотекстовый поиск по ним организуется элементарно.

Единственный минус, когда их много - для того чтобы что-то найти нужно пройтись по каталогам где они лежат и увидеть глазами.
Особенно - если их никто не пытался строго структурировать, и они лежат где-то так:
"Документы/старое/1/1/разобрать/старый диск/Документы/Работа/...".
Ну, это конечно запущенный случай, и надо бы разобрать, когда-нибудь, может быть - ну, собственно говоря, там так и написано...

Что если попробовать прикрутить к этому поиск?

Читать далее

Мы искали, куда coding agents тратят токены. Дело оказалось не в промптах

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.3K

Мы много разрабатываем с помощью coding agents: веб-приложения, MCP-серверы, пайплайны обработки данных, системы из нескольких агентов. И чем лучше становилась инфраструктура вокруг агентов, тем больше в ней появлялось инструкций, проверок, субагентов и автоматики. По идее, разработка должна была становиться дешевле. А расход контекста рос.

Первое подозрение было очевидным: слишком раздутые промпты. Мы искали не там.

Читать далее

Что умеет и где ломается Jev: большое тестирование

Уровень сложностиСредний
Время на прочтение26 мин
Охват и читатели6.8K

В работе с моделями важно не только знать их точность, скорость и цену, но и понимать, где им можно доверять, а где нужна дополнительная проверка. Многие ограничения обнаруживаются уже в процессе интеграции — и о них хотелось бы знать заранее.

Тестирование Jev я проводил прежде всего для себя и команды, но объём данных получился масштабным, и я решил поделиться результатами с сообществом. С 19 по 30 сентября 2026 года было проведено 22 эксперимента и отправлено около 160 тысяч запросов к jev-1.13.0 и контрольным моделям OpenAI. Все тесты запускались через API раннего доступа и суммарно обошлись примерно в $18.

Мне было интересно не столько проверить заявленные скорость и цену, сколько найти границы её практического применения. Насколько она точна по сравнению с небольшими GPT-моделями? Можно ли доверять её confidence и строить на нём автоматический роутинг? Что произойдёт при расширении списка классов, появлении длинного контекста, грязного входа или текста на другом языке? У LLM уже известны свои особенности — например, lost in the middle и склонность уверенно ошибаться. Логично было проверить, есть ли собственный набор таких эффектов у System One модели на примере Jev.

Читать далее

От бизнес‑метрики до дежурного: как построить алертинг, от которого не страдают

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели8.9K

Эта статья - о шаге, который предшествует настройке маршрутов: как выбрать сигнал, связать его с влиянием на бизнес, определить срочность и проверить, что вызов дежурного действительно оправдан. В качестве сквозного примера возьмём оформление заказа, а в конце свяжем правила детектирования с обработкой в nxs-anomaly.

Читать далее

Вечер на код и месяц на всё остальное: свой MCP‑сервер

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели14K

Я сделала для своего продукта MCP-сервер. Написание и проверка кода заняла один вечер — писал конечно агент.

А вот «остальное» оказалось решениями о составе и видимости инструментов и вещами, которые невозможно было запланировать заранее — только узнать постфактум, и почти всегда по итогам чьей-то реакции снаружи.

Читать далее

Продвинутый статический анализ в TypeScript-проектах: выходим за рамки tsc и ESLint

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели5.8K

👋 Привет! Меня зовут Александр, я работаю фронтенд-разработчиком в компании «МегаФон». Сегодня хочу поговорить о статическом анализе TypeScript-проектов за пределами привычной связки tsc и ESLint.

Читать далее

Как писать стили в 2026: CSS Modules, CSS‑in‑JS, Tailwind и zero‑runtime

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели8.1K

Всем привет! Меня зовут Даниил Николаев и я frontend-разработчик в компании "Исходный Код"

На каждом kickoff нового проекта всплывает один и тот же сценарий: один разработчик топит за утилиты Tailwind, второй отстаивает чистоту и надежность CSS Modules, третий по привычке тянет проверенный CSS-in-JS, а кто-то просто молча открывает .scss и выходит из созвона.

В этой статье мы опустим споры о «красивом синтаксисе» и разберем инженерную сторону вопроса: кто на самом деле платит за динамику — сборка или браузер клиента.

Заглянем под капот ключевым подходам в мире React (для уровня middle и middle+): разберем классические CSS Modules, ушедший в maintenance mode styled-components, Emotion, современный Tailwind v4 на движке Oxide и перспективный zero-runtime (Linaria, Vanilla Extract). Посмотрим, что реально происходит с CSSOM, reflow и рендером в браузере, а в конце — соберем практическую матрицу выбора без фанатизма и хайпа месяца.

Читать далее

Пусть агент сам докажет, что написанные им тесты можно не пройти

Время на прочтение8 мин
Охват и читатели4.9K

Агент пишет патч, пишет для него тесты, выполняет их и сообщает об успехе. Дифф выглядит здраво. Итак, у нас есть реализация, файл с тестом, и проверка пройдена (зелёная).

Реализация может согласовываться с тестами, поскольку там содержатся одинаковые ошибки. Если агент недопонял требования, когда писал код, то такое непонимание может сохраниться и на этапе чтения кода в стремлении получить ожидаемый результат. Чем больше тестовый набор, тем сложнее будет устранить такую ошибку. Позже вы исправите реализацию, и тесты начнут ругаться.

Читать далее
1
23 ...

Информация

В рейтинге
Не участвует
Откуда
Нальчик, Кабардино-Балкария, Россия
Дата рождения
Зарегистрирован
Активность

Специализация

Бэкенд разработчик, Фронтенд разработчик
Средний
От 2 600 $
JavaScript
Next.js
React
Redux
TypeScript
Webpack
Sass
Node.js