Обновить
64K+

PostgreSQL *

Свободная объектно-реляционная СУБД

124,36
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

630 тем и ноль в топе: что я понял из SEO‑аудита

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели7.5K

У меня на сайте 630 тем по 39 предметам. SSR, sitemap на 1636 адресов, канонические ссылки, HSTS, 261 тест. Домену 35 дней. По технической части аудит не нашёл ничего: robots, sitemap, canonical, title, SSL — всё чисто.

А по двенадцати коммерческим запросам сайта нет в топ-20. Вообще ни одной страницы. По бренду «edutrainer» — второе место, ниже пустой заглушки edutrainer.com.

Это неприятно, но полезно. Потому что техническая чистота не объясняет, почему человек, который ищет «сложение дробей тренажер», попадает не ко мне.

Читать далее

От секунд до миллисекунд: как мы ускоряли динамические списки 1С в Tantor Postgres

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели9.4K

Что общего у сортировки с LIMIT, среза последних и поиска по части номера документа? Все эти операции встречаются в динамических списках 1С — и каждая может замедлить работу пользователя. В статье разберем новые возможности, реализованные в Tantor Postgres, включая несколько продвинутых техник, как у планировщика MS SQL Server.

Читать далее

Мой линтер миграций Django выдал 407 критичных тревог на шести больших проектах. 405 оказались ложными

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели7K

Я делаю orm-lens, статический анализатор моделей и миграций Django. Одна из его проверок, migration-risk, читает каждый файл миграции и ищет операции, которые сломаются на таблице с данными: NOT NULL-колонку без значения по умолчанию, UNIQUE-колонку, которую нарушат уже существующие дубли, создание индекса с блокировкой таблицы.

Я запустил её на шести больших открытых проектах: NetBox, PostHog, authentik, Healthchecks, Plane и paperless-ngx. Итого 407 критичных находок. Я прочитал каждую. Настоящих оказалось две. Ниже девять причин ложных тревог, и каждая про то, как Django на самом деле мигрирует заполненную таблицу.

Читать далее

Как мы собираем и склеиваем объявления из 200+ Telegram-каналов Ташкента

Время чтения7 мин
Охват и читатели5.8K

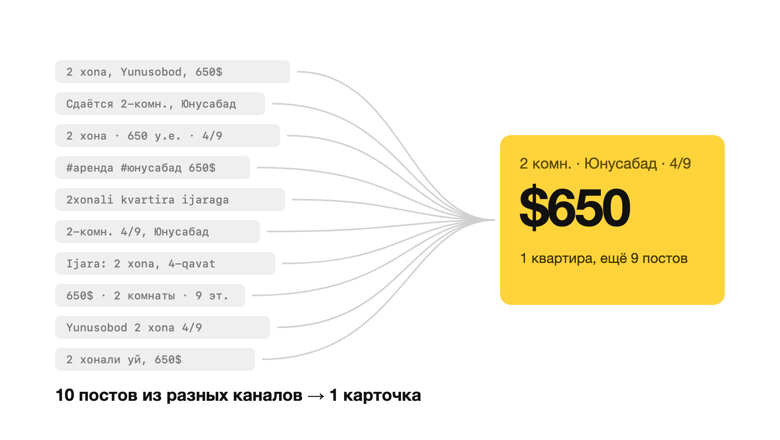
В Ташкенте квартиру в аренду ищут не на большом сайте объявлений, а в Telegram. Каналов с объявлениями — сотни: у каждого агентства свой, плюс районные, студенческие, «без посредников». Одну и ту же квартиру выкладывают в пяти-десяти из них, с разными фото, ценой в долларах или сумах, на русском, узбекском латиницей и узбекском кириллицей — часто в одном посте.

Мы делаем kvadro² — сервис поиска квартир: сайт kvadro.app, Telegram-бот и приложение внутри Telegram (Mini App). Он собирает объявления из 215 открытых каналов Ташкента, Ташкентской области, Андижана, Намангана, Коканда и Ферганы в одну ленту. Ниже — как это устроено: от чтения каналов до склейки дублей и подсчёта «цены к рынку». Без секретов и без маркетинга, с цифрами из нашей рабочей базы.

Читать далее

Мой блокчейн‑индексатор врал мне, а я не замечал

Время чтения8 мин
Охват и читатели5.6K

Встречали ли вы в базе события из блоков, которых никогда не существовало? Код записи в порядке. Диск тоже в поряде. Но блокчейн просто передумал. Сервис самый обычный: Go, логи смарт‑контрактов по RPC, PostgreSQL, API наружу. Никто не ждет от него сюрпризов.

Первым отстрелились реорганизации. Оказывается, блок, который ты уже отдал клиентам как подтверждённый, цепочка может выкинуть и переписать историю задним числом. Потом дошло до RPC‑провайдера: ему все почему‑то доверяют по умолчанию, и напрасно.

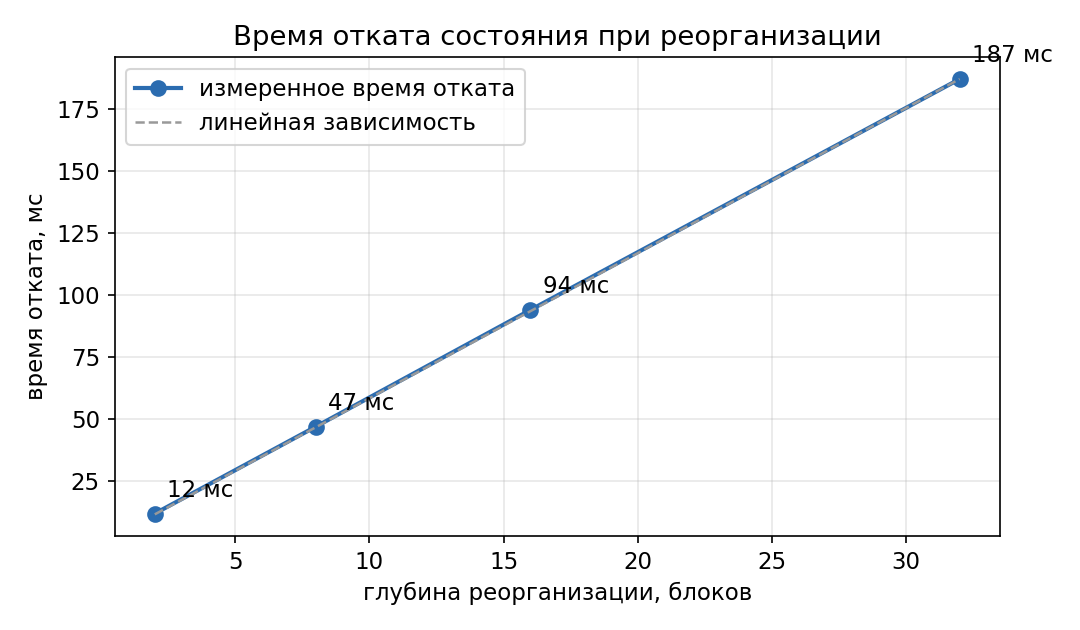
Откат на 32 блока теперь занимает 187 миллисекунд. Ответы провайдера я проверяю криптографически. Аналитика ускорилась в 13 раз. Ниже как я до этого дошел и что показал прогон по миллиону реальных блоков Ethereum.

Читать далее

Релиз PostgreSQL 19

Время чтения7 мин
Охват и читатели10K

19 ноября 2026 года состоялся релиз стабильной версии СУБД PostgreSQL 19. Обновления для новой ветки будут выходить в течение пяти лет до ноября 2031 года. Подготовка к выпуску PostgreSQL 19 проходила в рамках годового цикла разработки проекта. Поддержка PostgreSQL 14.x, самой старой из поддерживаемых веток, была прекращена 12 ноября 2026 года.

Читать далее

Как проверить индексы PostgreSQL после генерации ИИ‑агентом и избежать лишней нагрузки на запись

Уровень сложностиСредний
Время чтения20 мин
Охват и читатели7.5K

ИИ‑агенты умеют создавать сложные индексы PostgreSQL: с GIN и GiST, условиями WHERE и составными ключами. Но когда каждый новый запрос получает собственный индекс, общая нагрузка на базу может заметно вырасти. Разберём, как проверить использование индексов через pg_stat_user_indexes, оценить влияние на WAL, VACUUM и HOT‑обновления и определить, какие индексы действительно оправдывают свои затраты.

Разобрать эксперимент

PostgreSQL 19: меньше рутины, умнее фоновые процессы, чище SQL

Уровень сложностиПростой
Время чтения11 мин
Охват и читатели7.9K

PostgreSQL 19 вышел, и в нём наконец нет «обязательных костылей»: pg_repack, ручной синхронизации секвенций, флагов в Redis против лага реплик и сторонних хинтов планировщика. Мы разобрали релиз целиком, включая то, что из беты убрали и что при обновлении сломается. В статье только то, что пригодится в проде.

Читать далее

Click SHOP API: подпись, Prepare и Complete, и ночная сверка, которая ловит «оплачено, а заказа нет»

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели10K

В первой части был Payme: шесть методов JSON-RPC, четыре состояния и песочница, которая повторяет каждый запрос. У Click всё устроено иначе: два шага вместо шести, подпись MD5 вместо Basic Auth, сумма в сумах вместо тийинов и, что важнее всего, другой ответ на повтор. Если писать обе интеграции по одному шаблону, одна из них сломается.

А в конце — то, что не входит ни в один протокол, но без чего я бы не запускал приём платежей: ночная сверка.

Читать далее

Payme Merchant API: песочница шлёт каждый запрос дважды, и это лучший тест вашей интеграции

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели9.5K

В песочнице Payme есть правило, которое легко пропустить при чтении документации: запросы CreateTransaction, PerformTransaction и CancelTransaction она посылает дважды, и ответ на второй должен совпасть с ответом на первый. Интеграция, написанная «по шагам», на этом и падает. Чаще всего из-за одной строки: perform_time: Date.now(), которая на повторе возвращает уже другое время.

Песочница не придирается. Она проверяет ровно то, что потом случится в бою: ответ потерялся по дороге, Payme Business отправил тот же запрос ещё раз и ждёт, что вы ответите так же, как в первый раз.

Дальше — как я строю обработчик Merchant API, чтобы повтор любого запроса был безопасен. Код на TypeScript и PostgreSQL, но от языка тут почти ничего не зависит.

Читать далее

А они говорили — postgres‑based мультимастер никому не нужен

Время чтения10 мин
Охват и читатели11K

Именно эту фразу я слышал от менеджеров разного уровня лет десять назад, когда предлагал пересмотреть концепцию мультимастера. Разочарование, помнится, наступило, когда люди, принимающие решения, таки увидели, что масштабируемости по записи постгресовый мультимастер на логической репликации не обеспечивает. И даже eventually consistent active-active репликация имеет предел насыщения, поскольку ограничивается ростом количества репликационных воркеров (CPU, диск), скоростью декодинга у walsender'a и скоростью применения транзакций apply worker'ом.

Удивляться тут, впрочем, было нечему - эту тему активно изучали ещё в 90-х. Но что, если пересмотреть саму решаемую проблему - может быть, мы просто делаем не тот продукт? Попробуем порефлексировать.

Читать далее

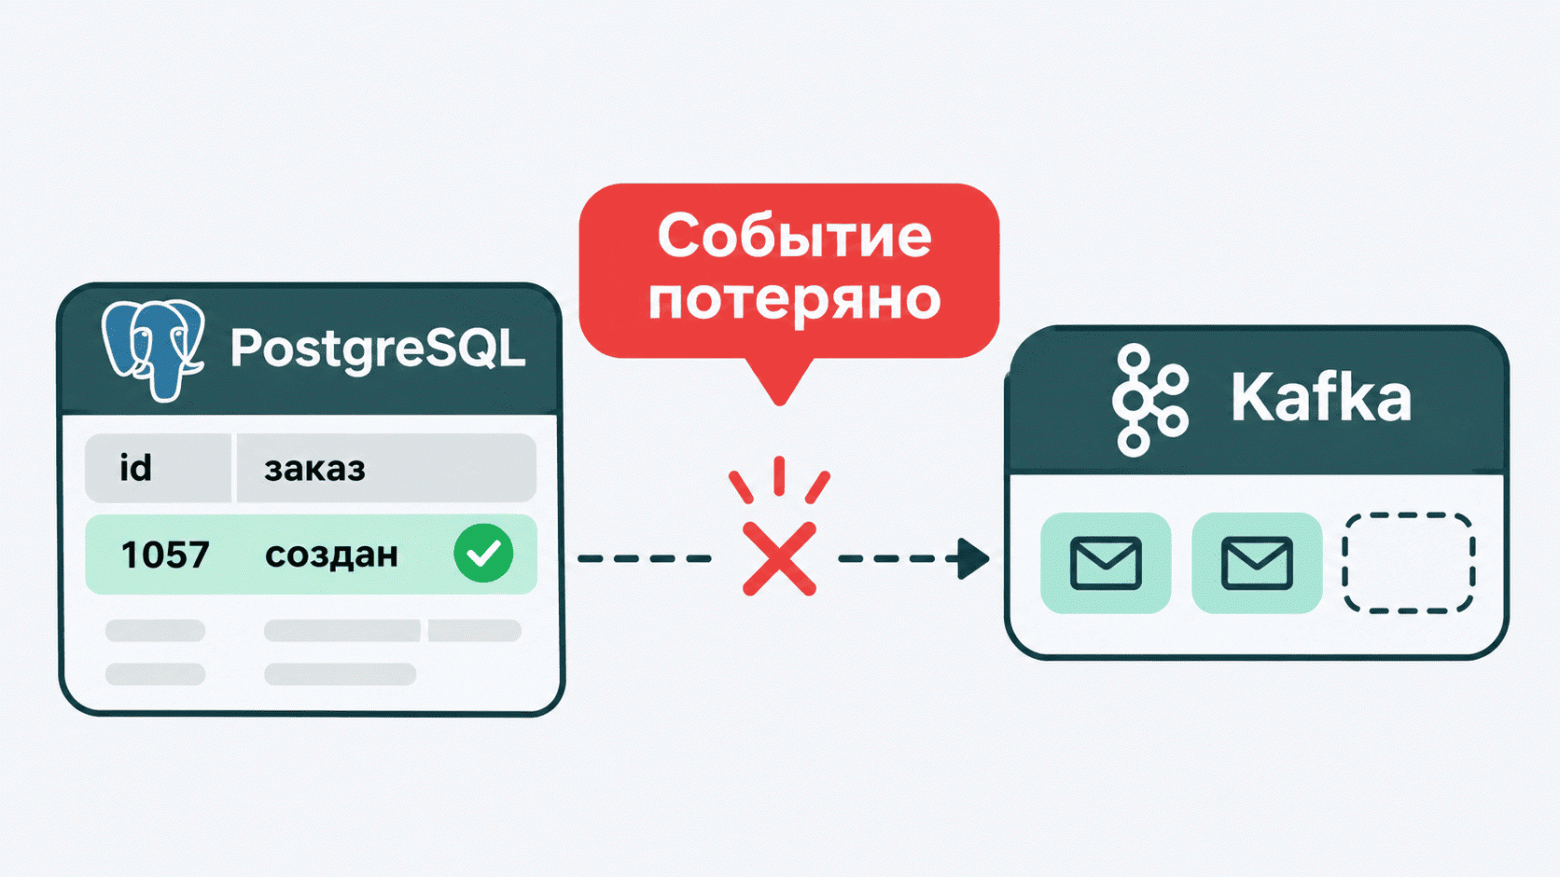
Заказ в базе есть, события в Kafka нет: где теряются сообщения между двумя системами

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели10K

Заказ успешно сохранился в PostgreSQL, но событие о нём так и не дошло до Kafka. Такие сбои могут месяцами оставаться незаметными, а попытка решить проблему через transactional outbox добавляет новые риски: потерю событий и нарушение их порядка. Разбираемся на примерах с SQL и Java, где возникают эти сбои, почему привычные решения не всегда помогают и как обеспечить надёжную доставку сообщений между системами.

Разобраться в Outbox

Генератор школьных задач на Django: что я понял на 603 темах и 1 809 прогонах

Время чтения6 мин
Охват и читатели5.2K

603 темы, 1 809 проверенных заданий и 213 тестов — и 1 547 URL, которые пришлось сократить до 453.

Я делаю EduTrainer — бесплатный тренажёр по школьным предметам для 1–11 классов. Ученик выбирает тему, решает задачу, сразу получает проверку и разбор ошибки.

С точки зрения разработки это не «сайт с текстом», а генератор: задачи собираются на лету, ответы проверяются, а теория и справочники лежат в PostgreSQL. В этой статье — архитектура, код генерации, проверка ответов и грабли, которые вылезли на 1 809 прогонах.

Читать далее

Ближайшие события

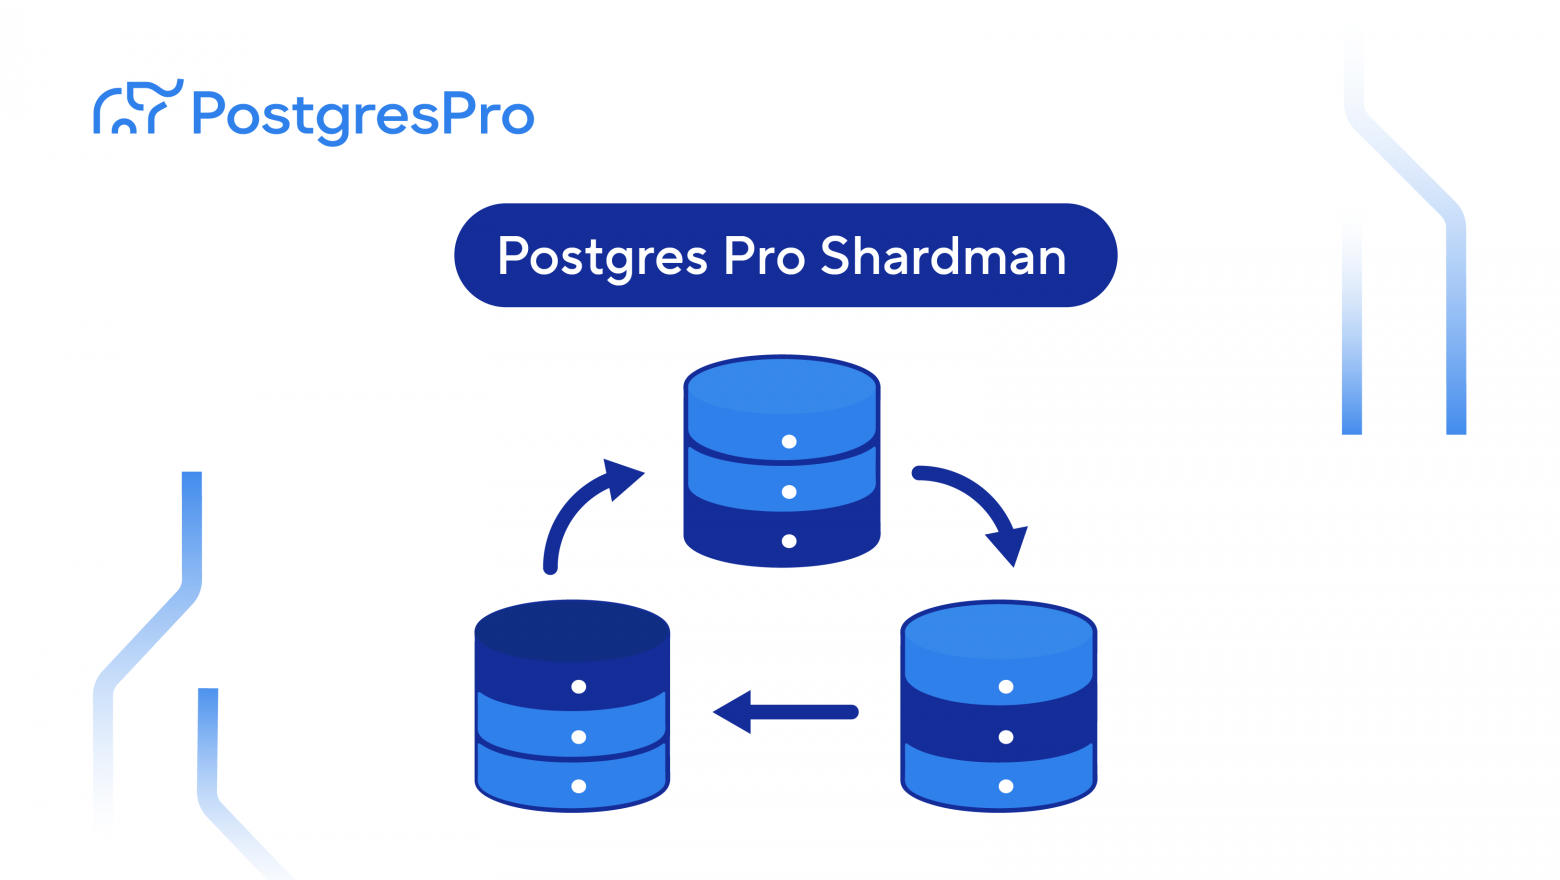
Шардинг PostgreSQL без потери ACID: как мы построили Postgres Pro Shardman

Уровень сложностиПростой
Время чтения18 мин
Охват и читатели9.6K

Добавили реплику, нарезали партиции, поставили пулер. Диск всё равно на пределе, VACUUM не успевает, а бэкап идёт сутками. Показываем, как горизонтальное масштабирование на шардинге снимает эти ограничения. Заодно разбираем цену решения: распределённые транзакции, stale reads, консистентные бэкапы и кроссшардовые join.

Читать далее

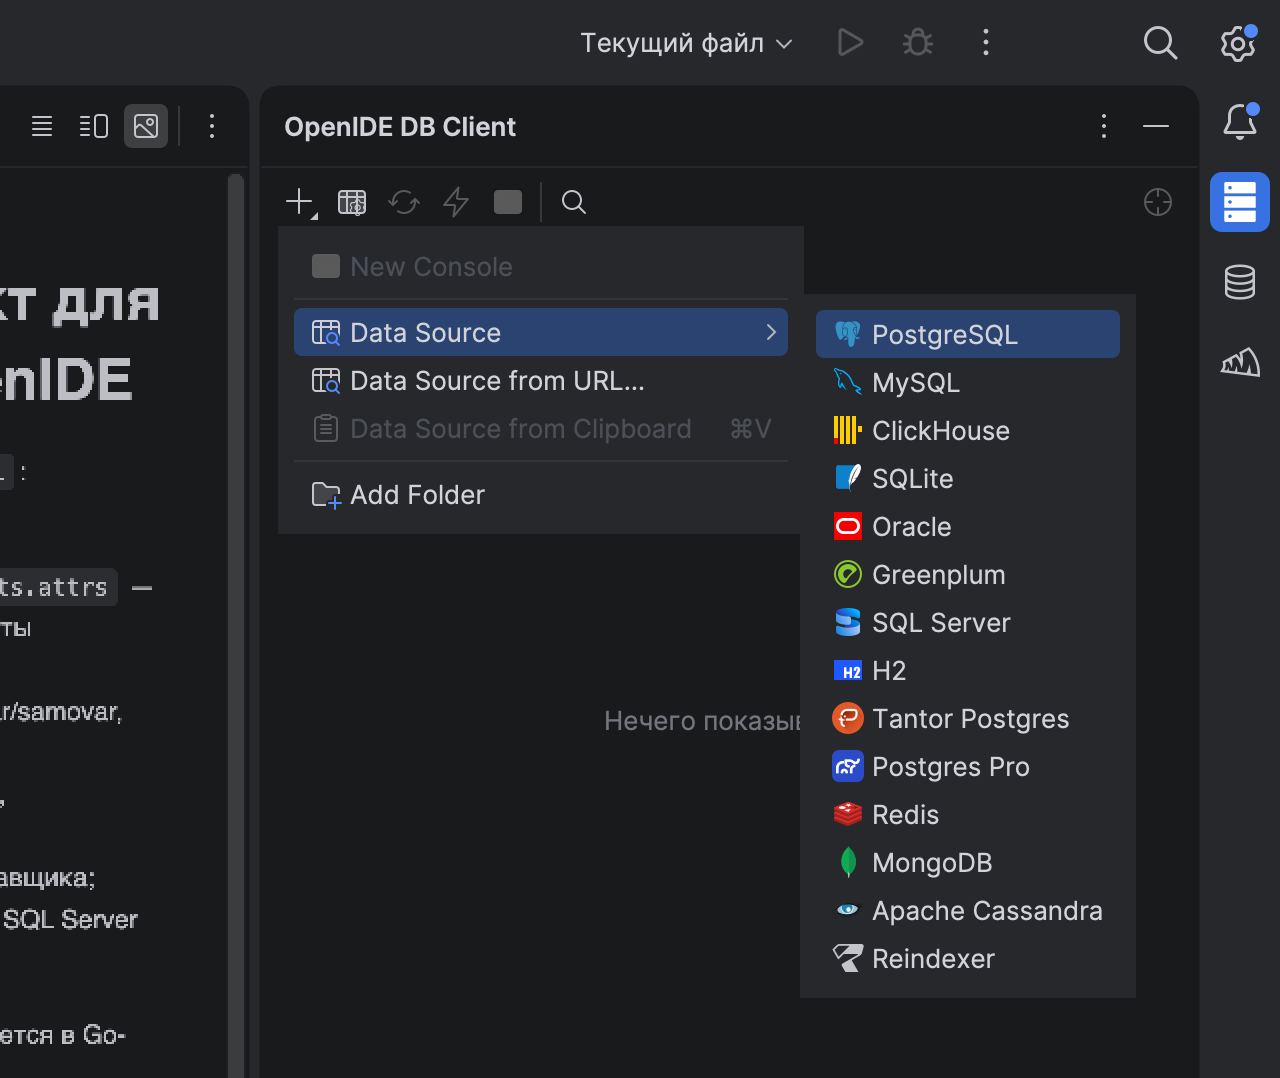
В DB-клиенте OpenIDE появились SQL Server, Cassandra, H2, Tantor Postgres, Postgres Pro и Reindexer

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели10K

Выпустили обновление DB-клиента для OpenIDE. В нём шесть новых баз: Microsoft SQL Server, Apache Cassandra, H2, Tantor Postgres, Postgres Pro и Reindexer. Главная новая возможность — параметризованные запросы с вводом значений и предпросмотром итогового SQL. Ещё добавили копирование данных в пять форматов, подключение из URL с Kerberos и доработали Oracle, Greenplum и SQLite.

Читать далее

Корпоративная база знаний на базе ИИ

Время чтения21 мин
Охват и читатели9.9K

Корпоративная база знаний на базе ИИ отвечает сотрудникам на вопросы по внутренним документам компании и показывает, откуда взят ответ. Строится она по схеме RAG — поиск нужных фрагментов плюс языковая модель. Это руководство для архитектора: из чего состоит стенд и где его разместить, сколько ресурсов нужно каждой модели, как выбрать хранилище и посчитать среду, что проверить до запуска и где обычно совершаются ошибки.

Читать далее

Мой RAG спалил, что я сижу в ролках

Время чтения11 мин
Охват и читатели5.8K

Атрибуция фактов в персональной памяти LLM: гибридный поиск на Postgres + pgvector, эвалы и вопрос «чей это факт»

Я загрузила в RAG свои переписки за несколько лет, чтобы мой ИИ‑агент знал меня и моих друзей. Он действительно узнал меня. А еще Клайда и Крейга из Южного Парка, Афелия из Лиги Легенд и человека, в которого я впервые влюбилась в интернете (это был ролевик за Кайто). А заодно он решил, что я айтишник, не жмот и зожник (конечно, все в мужском роде).

Это статья про то, как устроена персональная память для LLM‑ассистента, и почему самое сложное в ней это не векторы и не реранкинг, а вопрос «чей это вообще факт».

Читать далее

Вебинар «Postgres Pro Shardman: отказоустойчивость распределённой базы данных»

Уровень сложностиПростой
Время чтения2 мин
Охват и читатели7.1K

17 ноября компания Postgres Professional проведёт бесплатный вебинар, посвящённый отказоустойчивости распределённой СУБД Postgres Pro Shardman 18. На встрече рассмотрим управление катастрофоустойчивыми кластерами, в том числе геораспределёнными, обновление с минимальным временем простоя и резервное копирование всей распределённой базы данных.

Читать далее

Потоковая выгрузка из Postgres в CSV часть 2

Время чтения5 мин
Охват и читатели8.4K

Потоковая выгрузка из PostgreSQL в CSV: серверный курсор и COPY

В прошлый раз я разобрал самые такие три жизненных примера работы с выгрузками.

Наивный способ через память, постраничку через OFFSET/LIMIT и через keyset курсор. Но было бы несправедливо остановиться на этом и не протестировать другие оставшиеся варианты. Два способа, которые я хочу рассмотреть - это серверный курсор pg-query-stream и выгрузка напрямую из базы через COPY. В этой статье дальше будут примеры с кодом, но сам по себе код не информативен, самое главное - что я прогоню эти два новых варианта через тот же бенчмарк, чтобы сравнить нагрузку на память и время выполнения.

Читать далее

Road to Highload #1. Наивный checkout и гонка за остатком

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели6.9K

HTTP 200. Ошибок 0%. Магазин продал 300 товаров из 100.

Так выглядит гонка, которую не заметили ни API, ни простая проверка результата. Берём наивный checkout на .NET + PostgreSQL, ломаем его параллельными запросами и проверяем четыре способа вернуть складу способность считать.

Продать 300 из 100
1
23 ...