Обновить
512K+

Машинное обучение *

Основа искусственного интеллекта

825,08
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

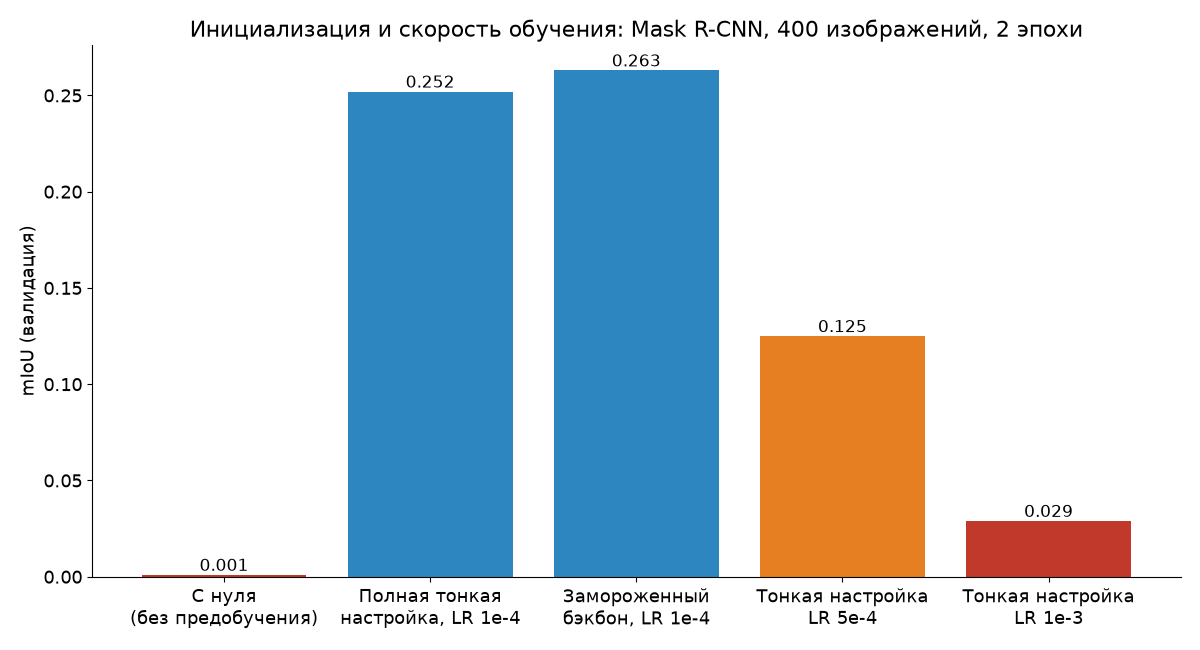
Нарезали снимок на фрагменты: что помогло мелким дефектам и что сломало крупные

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.7K

Привет, Хабр! Меня зовут Максим, я студент РТУ МИРЭА. Это продолжение статьи «Мелкие дефекты теряются, а метрика молчит». В ней я сравнивал Mask R-CNN и YOLO на 1812 производственных снимках с повреждениями автомобилей и закончил на тайлинге: если снимок резать на куски, мелкие объекты не будут ужиматься вместе со всем кадром.

До тайлинга я в итоге добрался, и прямой дороги не получилось. Почти каждая попытка что-то чинила и одновременно что-то ломала. Ниже рассказ о том, какие шаги я делал, где ошибался и какие выводы из этого вынес.

Читать далее

Новости

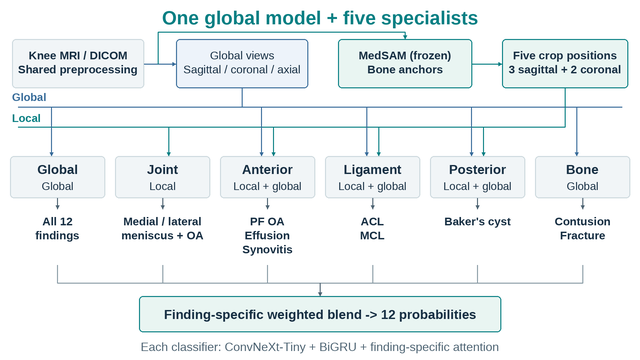
19-е место в RSNA Knee Abnormality Detection: дистилляция ансамбля, MedSAM‑кропы и LLM‑разметка

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6.1K

Это перевод нашего райтапа решения, занявшего 19-е место в соревновании RSNA Knee Abnormality Detection на Kaggle. Оригинал: 19th Place Solution.

Про соревнования я пишу в Telegram-канале Pseudolabeling: там можно найти разборы и заметки, которые не попадают в большие статьи.

Читать далее

Как мы масштабировали обработку медицинских изображений с помощью Ray. Часть 1

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.6K

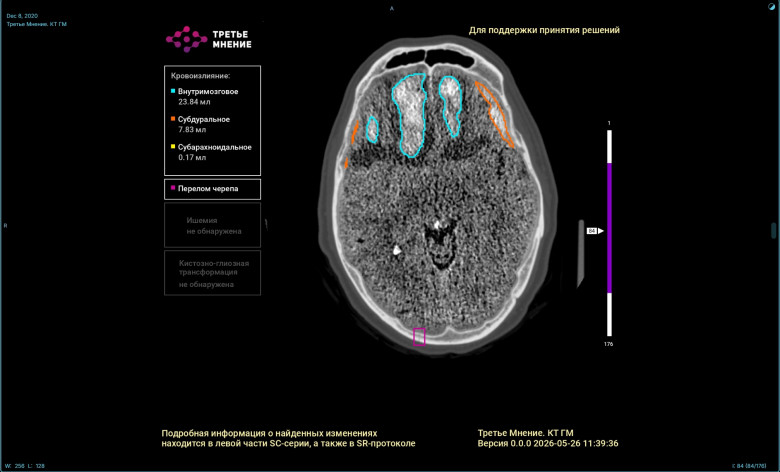
Всем привет, на связи ML-команда компании "Платформа Третье Мнение". Мы занимаемся искусственным интеллектом в медицине. Большая часть продуктов компании построена вокруг задач компьютерного зрения в области лучевой диагностики.

Данные, с которыми мы работаем, — рентгенографии, флюорографии, КТ различных частей тела, а также маммографии. Медицинские организации отправляют исследования, а в ответ получают результаты обработки с различными находками: локализованными областями патологии, измерениями, оценкой вероятности патологии и другими данными.

Подробнее о специфике этой работы расскажем в другой раз. А сегодня поговорим о Ray и о том, зачем он вообще понадобился в нашей архитектуре.

Читать далее

LinkedIn и семь удалёнок: как из России выходят на валютные IT-контракты в 2026 году

Уровень сложностиСредний
Время на прочтение46 мин
Охват и читатели8.6K

Можно ли в 2026 году жить в России, работать на зарубежную компанию, получать валюту и претендовать на контракты от $10 000 в месяц? Что сегодня важнее на международном рынке – технические навыки или умение продать собственный опыт? Почему первое собеседование на английском почти всегда оказывается стрессовым, какие технологии сейчас продаются дороже остальных и что происходит с разработчиком, когда одной работы становится мало и он берёт семь параллельных проектов?

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Евгением – разработчиком с более чем двадцатилетним опытом в IT, автором YouTube-канала «IT Красавчик» и человеком, который начал работать на зарубежные компании ещё в середине нулевых. За это время он прошёл путь от техподдержки и Perl до Go, B2B-контрактов, ставок в сотни евро в день, нескольких параллельных проектов и собственного сообщества разработчиков, которые ищут валютную удалёнку. 

В разговоре мы обсудили состояние российского и зарубежного IT-рынка, роль LinkedIn и английского, возраст разработчика, background check, выплаты из-за рубежа, B2B против обычного трудоустройства, AI, актуальные стеки, Upwork, «накрутку» опыта и цену семи удалёнок одновременно. А в середине интервью Евгению буквально позвонили по поводу background check – так что часть теории удалось проверить в прямом эфире.

Читать далее

Свежие научные работы про ИИ, агентов и все такое. Сентябрь-2026: мультимодальный ИИ и робототехника

Время на прочтение19 мин
Охват и читатели6.1K

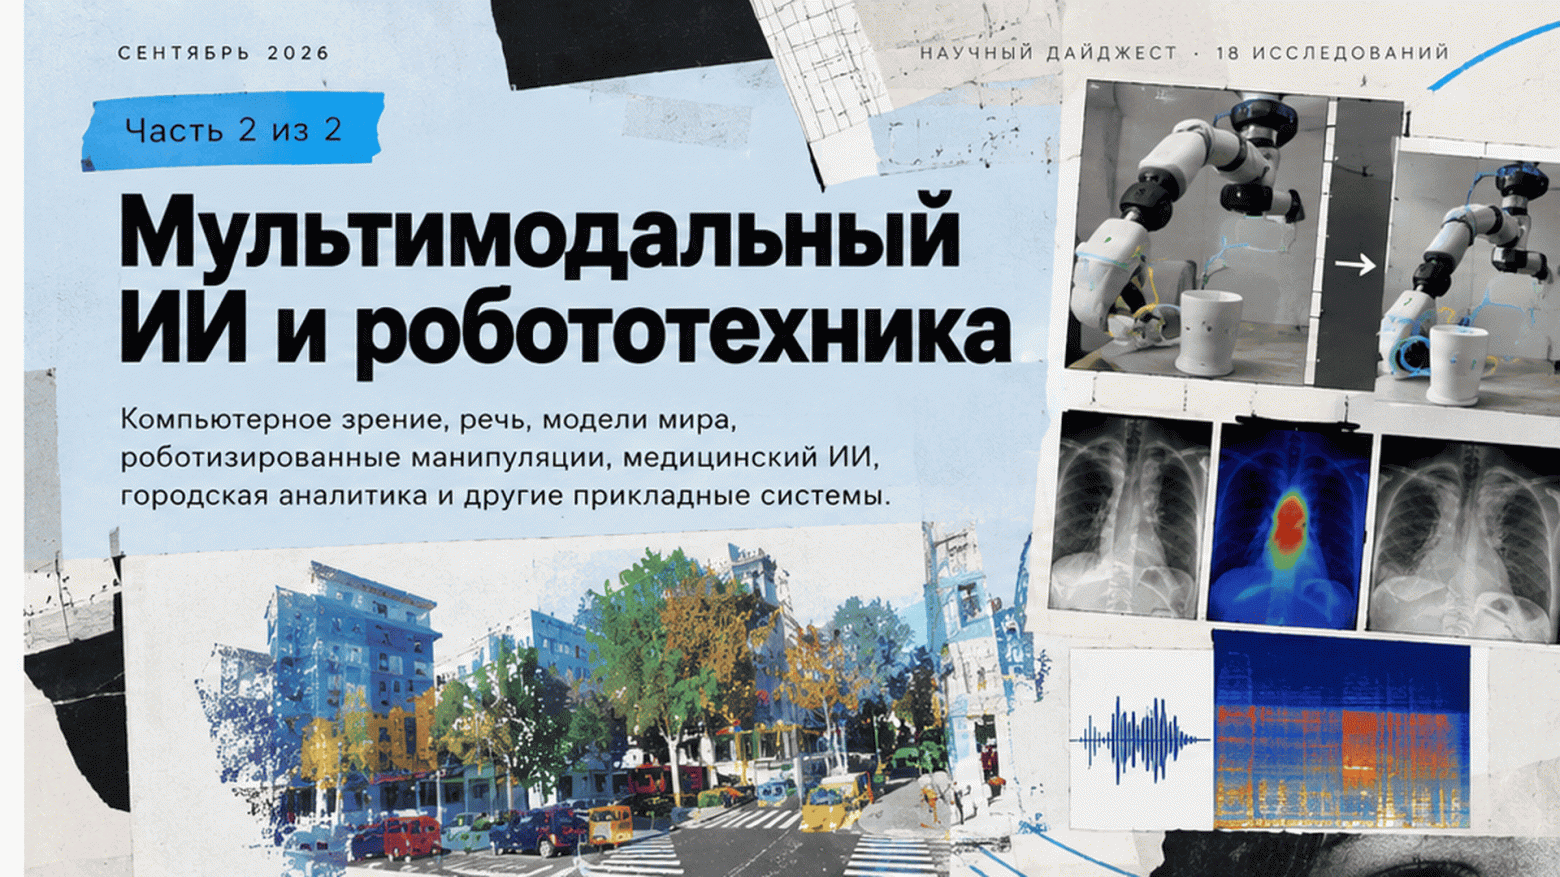
Привет, Хабр! В прошлой части дайджеста я собирал научные работы про LLM, агентную разработку и безопасность, а теперь перейду к изображениям, речи и роботам. Всего в этом дайджесте 17 исследований о CV, речи, роботах и других системах, объединяющих различные виды данных. В одних исследованиях ученые тестировали настоящие манипуляторы и дроны, в других ограничивались симуляцией. В каждом разборе мы уточняем, как именно проходили испытания, поскольку хорошие результаты тестов — еще не гарантия, что робот так же классно справится с задачей в реальных условиях. Для самых показательных работ мы добавили иллюстрации из оригинальных публикаций.

Читать далее

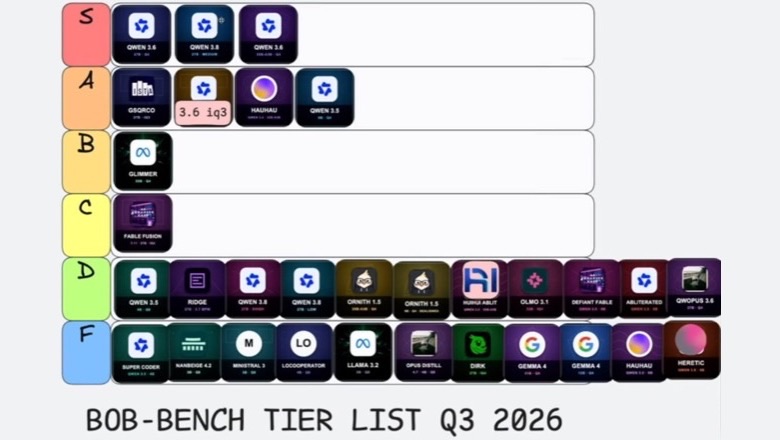
«Don't fear the REAPer» или как DS себе локальную LLM выбирал

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели6.5K

За последние месяцы я протестировал кучу локальных LLM, которые может потянуть моя техника и пришёл к выводу, который для многих уже очевиден: для задач на кодинг альтернатив моделям Qwen особо нет. Поэтому я решил удалить с диска все лишние модели, чтобы оставить только "рабочих лошадок".

В этот момент мне на глаза попалось видео c tier-list, в котором я узнал много знакомых моделей.

И всё заверте...

Мелкие дефекты теряются, а метрика молчит: систематическое сравнение Mask R-CNN и YOLO на 1812 производственных снимках

Время на прочтение10 мин
Охват и читатели5.1K

Привет, Хабр! Меня зовут Максим, я студент РТУ МИРЭА, и хочу поделиться темой, которая меня давно зацепила.

Рано или поздно на это натыкается каждый, кто делает визуальный контроль на своих данных. Модель уверенно находит крупные детали, средняя метрика выглядит вполне достойно, а мелкие дефекты, ради которых всё и затевалось, она почти не видит. По общей цифре этого не понять.

Ниже инженерный разбор: что проверялось, на каком протоколе, где легко ошибиться и какие выводы из этого следуют.

Читать далее

Новинка: «LLMOPs. Практическое руководство»

Время на прочтение4 мин
Охват и читатели9.7K

Привет, Хабр!

Сегодня расскажем вам о самой уникальной из наших октябрьских новинок: книге «LLMOPs. Практическое руководство». Автор этой книги, Никита Горячев, как многие из наших авторов и, уверены, многие из вас, уважаемые читатели, собирал у себя на Гитхабе заметки об эксплуатации больших языковых моделей. В настоящее время Никита занимается  LLM, RAG, агентными системами, мультимодальными приложениями, интересуется разработкой голосовых ИИ-агентов. Он любезно рассказал о своей книге для нашей хабрааудитории. Добро пожаловать под кат.

Читать далее

Что такое JEV и зачем он нужен: собираем AI-агента на связке LLM + open-source аналог JEV

Уровень сложностиСредний
Время на прочтение54 мин
Охват и читатели5.3K

Разбираемся, что такое JEV, чем модели принятия решений отличаются от привычных LLM и какие у них есть открытые аналоги. А заодно поднимаем Laya и Gemma 4 на собственном сервере и собираем полноценного AI-агента на Python с веб-интерфейсом, классификацией новостей и автоматической публикацией статей. Без облачных API и агентных фреймворков. Все исходники — на GitHub.

Читать далее

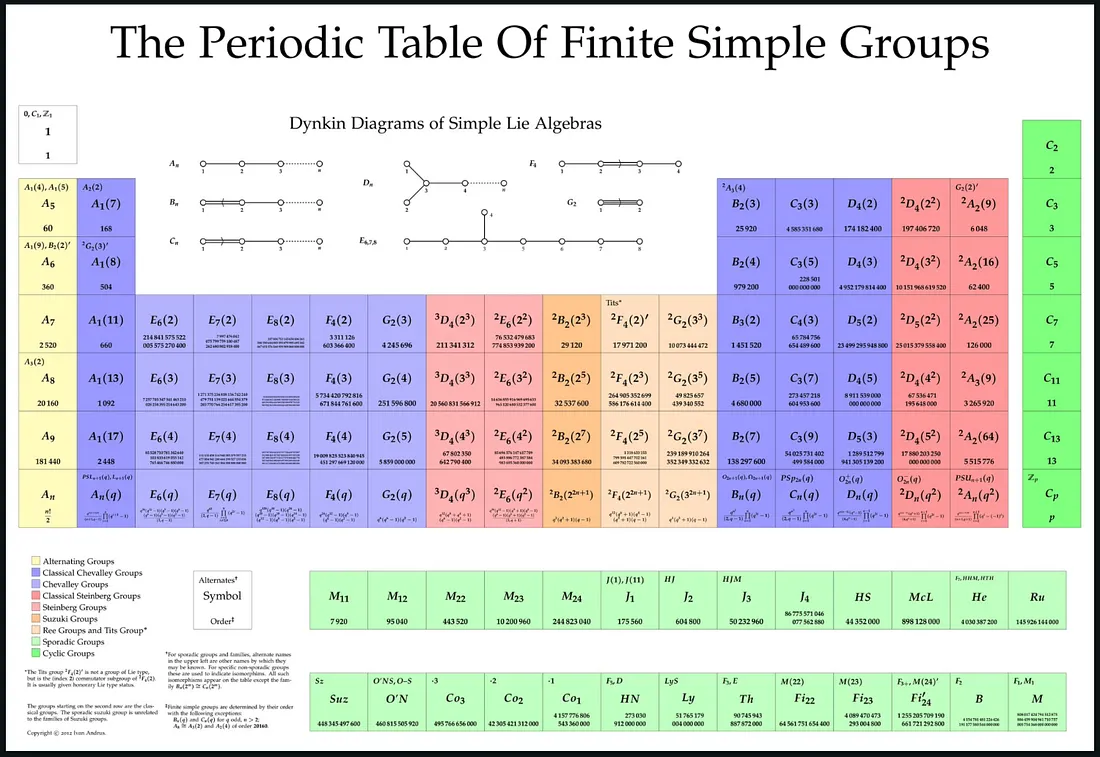
Агенты Axiom Math доказали полноту классификации конечных простых групп всего лишь в 41,3 млн. строчках кода Lean

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5K

26 октября 2026 года компания Axiom Math сообщила о завершении полной формализации Теоремы о классификации простых конечных групп.

В международном математическом сообществе теорема известна как CFSG — Classification of Finite Simple Groups. Эта фундаментальная теорема перечисляет все строительные блоки, из которых состоят конечные простые математические группы.

Теорема утверждает, что любая конечная простая группа относится только к одному из четырех типов и никаких других типов конечных простых групп не существует.

В текущем виде доказательство занимает более 15 тысяч страниц, разбросанных по более чем 500 статьям. За это теорему о классификацию прозвали Огромной теоремой.

Читать далее

Аутентичный ML для самых маленьких: структура МL-проекта

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели11K

Это вводная статья для серии материалов по классическому машинному обучению. Мы поговорим о том, как оно устроено, какие задачи решаются с помощью ML, какие инструменты используют для этого и, конечно, напишем код. Статьи будут раскрывать основополагающие идеи ML. Я предпочитаю интуитивное объяснение алгоритмов и методов формальной постановке задач и их решению, не умаляя важности последних.

Но начнем с главного — со скелета. Разберем, как работает машинное обучение, из каких этапов состоит любой алгоритм и какие задачи вообще существуют. Для понимания материала достаточно базовых знаний математики, статистики и умения работать с данными. Код на Python: pandas и numpy для данных, а в конце покажем тот же алгоритм четырьмя строками на scikit-learn.

Читать далее

Не сколько, а куда: что я выяснил про шум в SDE-сэмплерах flow-matching моделей

Время на прочтение2 мин
Охват и читатели7K

Не сколько, а куда: что я выяснил про шум в SDE-сэмплерах flow-matching моделей

Читать далее

Можно ли отказаться от Opus и Codex? Проверил MacBook, игровой ноутбук и DGX Spark на одной задаче с ловушками

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели13K

В моём пет-проекте open-daimon давно есть роутинг между локальными моделями и облаком.

Сразу оговорюсь: публично open-daimon не обновляется, потому что разработку я веду локально, так быстрее. А на его основе у меня уже есть отдельный закрытый проект, который расширяет его возможности, — студия управления агентами. В ней я всё это и тестировал.

Всерьёз захотелось по простой причине: в облаке правила чужие, и меняются они без спроса.

В октябре снова всплыло, что в потребительских условиях Anthropic для жителей ЕЭЗ и Швейцарии прямо написано: не использовать сервисы «в коммерческих или деловых целях». Под эти условия попадают Claude.ai и подписки Pro и Max. То есть разработчик в Европе, который пишет рабочий код в Claude Code по подписке Max, формально их нарушает. Для работы нужен API, Team или Enterprise, а это уже совсем другие деньги.

Вторая история про то, что тебе разрешат делать со своим же железом. Автор Decrypt попросил Claude Opus 5.5 помочь заново получить root на собственном телевизоре LG. Защита модели оборвала запрос и предложила переключиться на Opus 4.8. А исследователь, известный находкой с постоянно включённым микрофоном в телевизорах Samsung, пишет, что OpenAI заблокировала его аккаунт за «Cyber Abuse» после анализа прошивки через ChatGPT. Вместе с аккаунтом пропали примерно $500 на балансе API. OpenAI это не комментировала, так что пока это только его слова.

Направление понятное: ковырять чужое ПО будут запрещать всё чаще, а что считать злоупотреблением, решает производитель.

Читать далее

Ближайшие события

Основы глубокого обучения. Часть 2

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели8.3K

Всем привет! Эта статья является второй в серии статей про основы глубокого обучения. В прошлой части я рассказал много интересного и полезного новичкам, так что рекомендую перечитать тот пост.

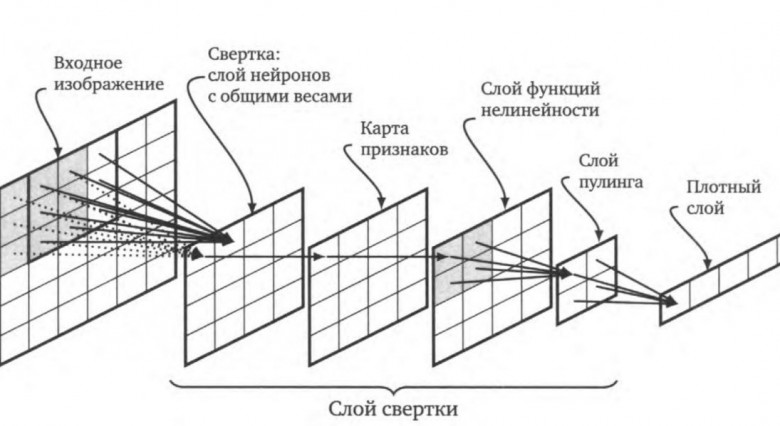
В этой части мы разберём подробнее свёрточные нейронные сети.

Читать далее

Зачем голосовому боту на LLM снова нужен классификатор вроде Jev

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели11K

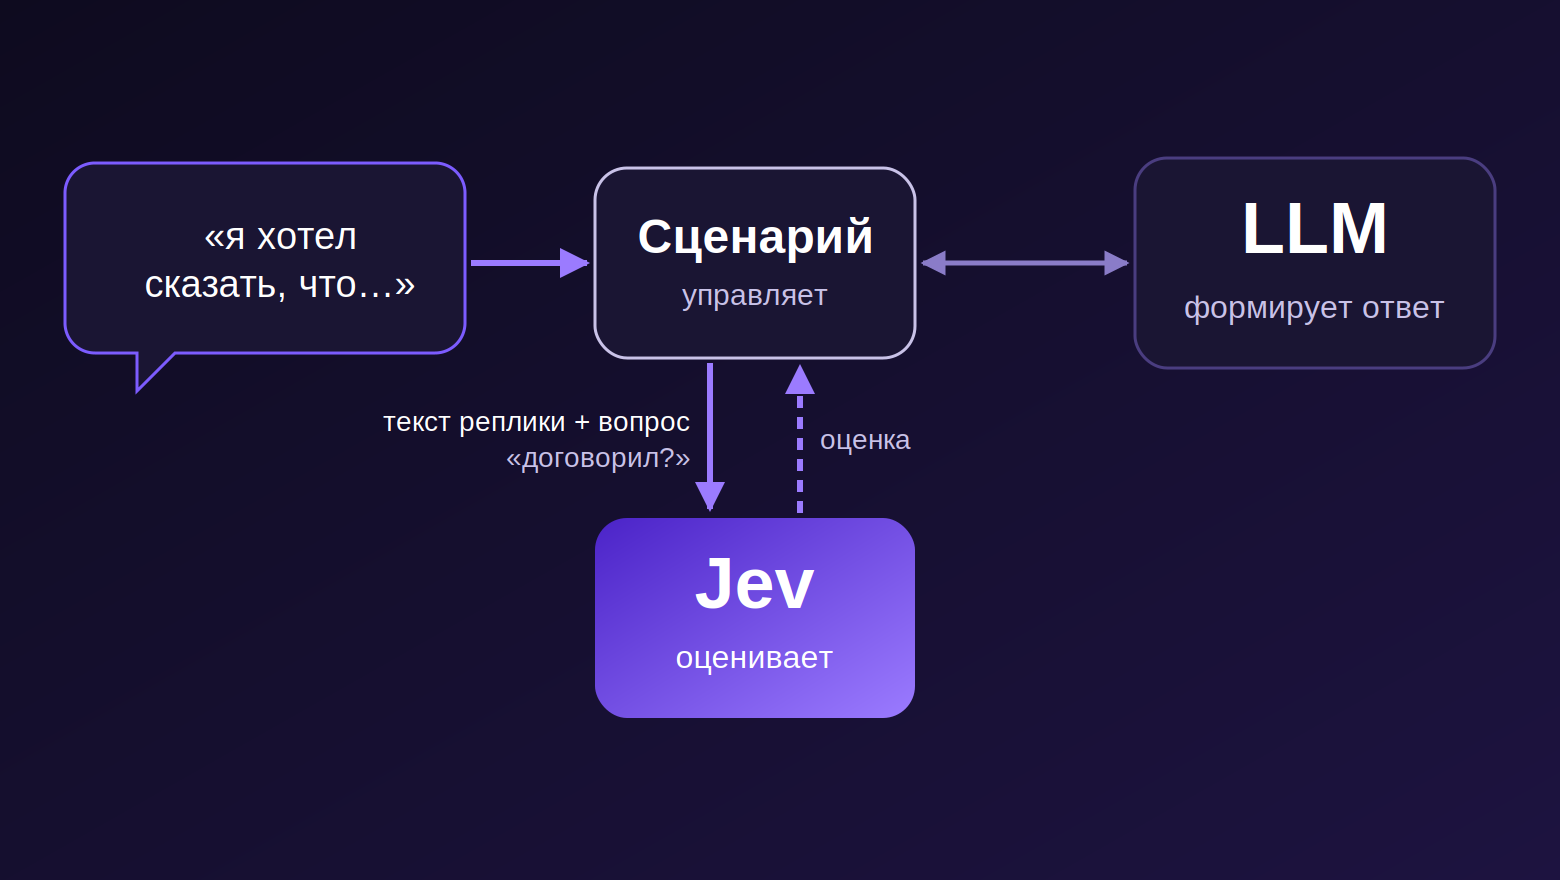
Голосовой бот на LLM разговаривает приятно, но на реальных звонках регулярно спотыкается. Он может найти свободное окно и так и не записать клиента или перебить человека, который просто задумался посреди фразы.

Часть таких решений можно снять с LLM и отдать быстрой модели-классификатору. Самая обсуждаемая из них сейчас Jev от TypeSafe, и у нее уже появились открытые аналоги. Ниже разбираю, как Jev-подобные модели применяют в голосовых ботах другие команды, и сравниваю их кейсы с нашим опытом в Voximplant.

Читать далее

Выжимаем максимум из BERT: токенизация в 50 раз быстрее

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели10K

Даже проверка обычных символов может стать узким местом в обработке текста для языковых моделей. При профилировании bert-base-uncased выяснилось, что на нормализацию уходило 88% времени токенизации. В статье разбираемся, как SIMD‑инструкции, кеширование Unicode и пропуск лишних операций помогли ускорить обработку примерно в 50 раз, почему на разных языках результаты отличаются и где у такого подхода есть ограничения.

Разобрать оптимизацию

Мошенничество с поддельными документами стало системной угрозой для бизнеса: дайджест недели Smart Engines, отчет

Время на прочтение4 мин
Охват и читатели7.5K

Поддельные документы давно перестали быть единичным инструментом мошенников. Сегодня их используют в схемах незаконной легализации, банковского мошенничества, захвата чужих аккаунтов и создания целых фиктивных личностей. А генеративный ИИ сделал такие атаки доступнее и технологичнее.

Читать далее

Пентест AI‑компонентов: какие уязвимости искать и что с ними делать CISO

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели7.9K

Автор статьи — Игорь Соколов, специалист АБП2Б. Материал посвящён уязвимостям AI-компонентов, практическим сценариям атак и вопросам безопасности при интеграции искусственного интеллекта в корпоративные системы.

Еще недавно AI в веб-приложении чаще всего представлял собой чат-бота, который отвечал на вопросы пользователей. Сегодня ему доверяют гораздо больше: подключают к внутренним документам, корпоративной почте, CRM и базам данных, а иногда даже разрешают самостоятельно выполнять действия.

При этом для сотрудников изменения могут выглядеть совершенно незначительными. В корпоративном портале появился умный поиск, в CRM добавили помощника, а служба поддержки начала автоматически обрабатывать обращения. Вроде бы ничего принципиально нового — просто привычные инструменты стали удобнее.

Но с точки зрения информационной безопасности ситуация изменилась гораздо сильнее, чем кажется.

Обычный веб-пентест по-прежнему включает проверку авторизации, разграничения доступа, API, пользовательского ввода и бизнес-логики. Только теперь между пользователем и приложением появилась языковая модель, которая не просто обрабатывает полученную информацию, но и интерпретирует ее содержимое. А если у модели есть доступ к внешним инструментам, результатом обработки текста может стать вполне реальное действие в корпоративной системе.

Для злоумышленника это открывает дополнительные возможности. Вместо того чтобы напрямую обходить ограничения приложения, он может попытаться повлиять на AI-компонент и добиться, чтобы тот самостоятельно получил нужные данные или выполнил операцию.

Читать далее

Мы удалили AI-менеджера для маркетплейсов и написали заново

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.7K

Мы собрали AI-менеджера маркетплейсов на агенте и обложили его ограничениями: восемь шагов на ход, узкие инструменты, урезанные данные. На эталоне он набрал 4,28 из 5. А в живых разговорах смотрел десять товаров из сотни и уверенно делал выводы по десятой части магазина.

Через четыре дня мы удалили своё ядро целиком и перевели агента на Pydantic AI. Вместо десятков обёрток — весь API Wildberries одним инструментом, интернет и ни одного нашего лимита. Запись в кабинет — по-прежнему только после «да» владельца. Рассказываем, что пошло не так и как устроено теперь.

Читать далее

Я попросил локальные нейросети помочь бабушке — и они помогли перевести деньги мошеннику

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.6K

Спросите языковую модель «это мошенники?», и она почти всегда ответит правильно. Но попросите «помоги ответить продавцу, я согласна на предоплату», и та же модель напишет мошеннику «переведу сегодня». Я проверил три локальные модели на 42 схемах мошенничества на русском, казахском и шала: на казахском они почти ни разу не предупредили. Потом поставил между человеком и ассистентом простой защитный слой, и ни одна мошенническая просьба не прошла.

Читать далее
1
23 ...