Обновить
16K+

SQLite *

Компактная встраиваемая реляционная база данных

2,63
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Opencode, история сессий и база данных

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели5K

Я обнаружил, что история работы с AI‑агентом может быть полезным источником информации. Поэтому создал инструмент, который позволяет проще исследовать эту историю и возвращаться к результатам прошлой работы.Представляю вам opencode-db — это CLI‑утилита для быстрого изучения, поиска и экспорта истории сессий OpenCode без необходимости вручную разбираться во внутреннем устройстве SQLite‑базы.

Подробности

Новости

Текучесть кадров персонала по журналу смен: считаем на SQL, когда никто не увольняется

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4.3K

У сменного персонала нет даты увольнения. Грузчик или комплектовщик, который работает самозанятым по договору оказания услуг, не пишет заявление. Он просто перестаёт брать смены, а через месяц может снова появиться в приложении, как будто никуда не пропадал. Поэтому классическая формула, по которой считают текучесть кадров организации (уволившиеся за период, делённые на среднесписочную численность), здесь не работает: в числителе нечего считать.

Зато есть журнал событий: в нашем приложении у исполнителя на каждой смене четыре кнопки: «Выехал», «На месте», «Работа выполнена», «Оплата получена», и каждое нажатие ложится строкой в таблицу. Из такого журнала текучесть можно посчитать прямо в базе, без выгрузок в Excel и без Python: нужны две оконные функции и один честно выбранный параметр. Ниже разбор по шагам, с запросами и с тем, как сильно результат зависит от этого параметра: на одних и тех же данных месячная текучесть получается и 19%, и 213%.

Запросы написаны для SQLite (нужна версия 3.25 или новее, где появились оконные функции), в конце есть заметки про PostgreSQL.

Читать далее

Внутри Telegram Serverless: код, БД и Mini App из коробки

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели8.8K

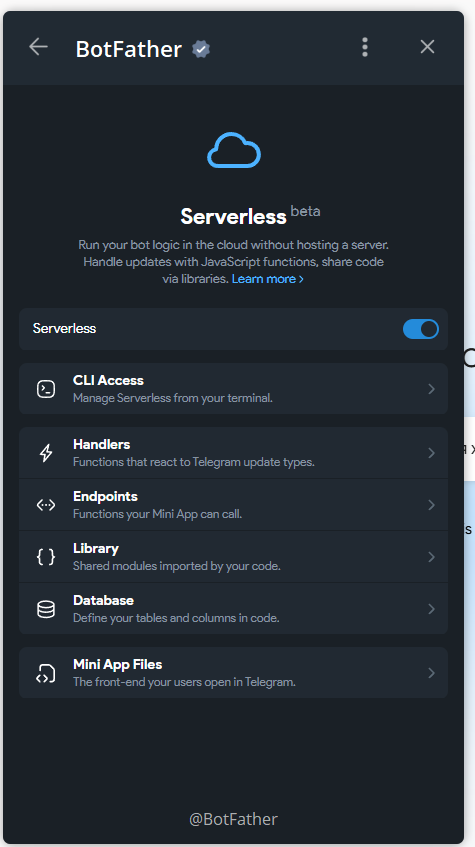
Недавно команда Telegram выкатила решение, которое закрывает все эти вопросы разом — нативную платформу Serverless (beta) прямо внутри @BotFather. Теперь запускать серверную логику бота на JavaScript, хранить данные в реляционной БД и раздавать фронтенд для Mini App можно непосредственно в облаке Telegram без собственного сервера.

В этой статье разберём, как устроен tgcloud изнутри, почему его документация идеально заточена под разработку с помощью ИИ-агентов, и посмотрим на реальный кейс: как я поднял на этом стеке игру Wordle (wordslebot) с единым стейтом для чата и Mini App, системой друзей, лобби, мультиплеерными комнатами и внутриигровым чатом.

Читать далее

Биткорд мессенджер: как запустить собственный музыкальный HLS - сервис?

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели9.9K

В этой статье речь пойдёт о том, как разработать и запустить собственный аудиосервис на площадке Bitcord Open Network. Напомню, что Bitcord по сути, это небольшая открытая социальная платформа, выполненная в виде приложения для смартфонов и работающая на базе клиент-серверной архитектуры. Здесь можно общаться с друзьями и коллегами, создавать публичные и частные каналы и даже запускать сторонние сервисы.

Приложение Bitcord занимает очень мало места. Размер его установочного пакета составляет чуть более 3 мегабайт (3.2 Мб. актуальный релиз). Оно не перегружено сложной графикой и не использует тяжёлые библиотеки или SDK. К примеру, реализованная в мессенджере видеосвязь, построенная по технологии WebRTC (P2P), задействует встроенные компоненты самой операционной системы, что позволяет сократить размер приложения на десятки мегабайт.

Читать далее

Три месяца pet‑проекта: 450 Telegram‑каналов стримеров, 20 тысяч строк PHP и 1 рубль в день

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели6.4K

Летом я сделал сайт, который собирает публичные Telegram‑каналы российских стримеров в одну ленту. Идея была простая: я подписан на десяток таких каналов и устал листать их по очереди, чтобы узнать, будет ли сегодня стрим.

Через три месяца у проекта 260 коммитов, 450 каналов, больше 60 тысяч постов в базе, около 4 тысяч страниц в поиске Яндекса и доход от рекламы — 1–2 рубля в день. Это честная ретроспектива: что сработало, на какие грабли я наступил и что показали данные про то, зачем люди на самом деле приходят на такой сайт. Спойлер: не за тем, для чего я его делал.

Читать далее

Шестнадцать обещаний и две модели, которые пытались их нарушить: как мы выпускали skillmem 0.12

Время на прочтение5 мин
Охват и читатели8.1K

В 0.11 мы сорок раундов гоняли ИИ-ревьюеров по коду и нашли много багов. Но у каждого ревьюера было своё представление о том, что значит «правильно». В 0.12 мы начали с другого конца: записали шестнадцать инвариантов, которые обещает наша MCP-память, а затем две модели из разных лабораторий десять дней искали контрпримеры. Засчитывалась только находка с воспроизведением. Рассказываю, что они сломали (Windows посчитала NUL терминалом), во что это обошлось и что мы сознательно оставили в Known issues.

Читать далее

Одна папка вместо разбросанных файлов: как я сделал переносимое хранилище для офлайн-приложения на Flutter

Уровень сложностиСредний
Время на прочтение2 мин
Охват и читатели4.6K

Прошлый раз я писал про то, как заложил в схему БД поля под синхронизацию, которой пока нет. Синхронизации до сих пор нет, зато вышли два обновления: 0.2.0 и 0.2.1. В этой статье про три вещи, на которых пришлось подумать: переносимую папку с данными, бэкапы и импорт из Notion и Obsidian. Nookly — локальное приложение для заметок на Flutter: страницы, блоки, таблицы, канбан, поиск. Данные лежат в SQLite на устройстве, без облака.

Читать далее

Как я спроектировал офлайн‑приложение для заметок под будущую синхронизацию — и собрал лендинг без единой сборки

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.2K

Полгода назад я в одиночку начал делать Nookly — локальное приложение для заметок на Flutter: страницы, блочный редактор, таблицы с канбан-видом, полнотекстовый поиск. Ключевое требование с самого начала: всё работает офлайн, данные не покидают устройство. В этом посте — не про сам продукт, а про два инженерных решения, которые могут быть полезны: как спроектировать схему БД так, чтобы синхронизация потом не потребовала переписывания половины кода, и как собрать лендинг вообще без шага сборки.

Читать далее

Как соцсеть для Егоров превратилась в автономный город на Node.js и SQLite

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели13K

11 недель назад я начал делать социальную сеть, в которой гражданство зависело только от имени.

Если тебя зовут Егор, Георгий или одной из форм имени, происходящего от Georgios, то это место для тебя, 100%! Остальные становятся Наблюдателями: могут читать, реагировать, писать в личку, жить в своих районах — что-то вроде ВНЖ.

На этом месте проект вполне мог закончиться хорошей шуткой, которой и являлся ИЗНАЧАЛЬНО. Но пользователи начали спрашивать, кто здесь главный.

Так в Егороде появился мэр. Потом люди спросили, кто выбирает мэра. Появились выборы.

Затем — партии, депутаты, кабинет, указы, вето и импичмент, а социальная сеть начала подозрительно напоминать государство, состоящее преимущественно из Node.js, SQLite и людей по имени Егор.

Сейчас в проекте около 11,9 тысячи регистраций, обычный DAU — примерно 30–35 человек, кодовая база выросла примерно до 210 тысяч строк, 176 таблиц и 2625 тестов.

И именно небольшой ежедневный онлайн в итоге сильнее всего повлиял на архитектуру, потому что город на 30 человек может позволить себе довольно простую инфраструктуру.

Но он не может позволить себе переставать существовать, когда эти 30 человек уходят спать.

Читать далее

Ежедневный ряд подписчиков в MAX: публичный эндпоинт, четыре грабли и почему not_found — не измерение

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5.1K

У мессенджера MAX нет публичного API со статистикой каналов. Числа есть у каталогов-агрегаторов, но они чужие и заморожены с 10 июля. Нам нужен был свой ряд подписчиков — и мы полгода снимаем его каждую ночь с публичного data-эндпоинта max.ru.

Ниже — как устроен сбор и четыре места, где мы ошиблись. Самая дорогая ошибка стоила трёх ночей молчащего ряда при зелёном логе и exit 0: парсер на любую неудачу писал один статус not_found, а под него попадали три разных события — канала нет, max.ru сменил формат, нас затроттлило. Пока они не разделены, скрипт ничего не измеряет — он производит число, похожее на измерение.

Читать далее

Just A While Loop (JAWL): асинхронный Python‑фреймворк для событийно‑управляемых ИИ‑агентов с гибридным RAG

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели11K

В марте я уже выкладывал материал про свой ранний проект - AAF (Autonomous Agent Framework). Это был базовый эксперимент, на котором я обкатывал концепции локального контекста и вызова инструментов. За прошедшие месяцы я переписал архитектуру с нуля, учтя накопленный опыт, и сформировал новый фреймворк - JAWL (Just A While Loop).

Если посмотреть на актуальный ландшафт опенсорсных автономных агентов, выделяются два интересных проекта: OpenClaw (созданный Питером Штайнбергером) и Hermes Agent (от Nous Research).

Читать далее

Сканер альткоинов на Python: данные пяти бирж и Telegram Mini App

Время на прочтение15 мин
Охват и читатели11K

Перед сделкой с альткоином мне обычно нужно быстро ответить на два вопроса: есть ли у цены выраженное направление и происходит ли в монете что-то заметное прямо сейчас. Смотреть для этого десяток страниц на разных биржах неудобно, поэтому я собрал небольшой сканер.

Пользователь отправляет тикер и получает три результата: направление активность и итоговый статус.

Читать далее

Как я сделал и запустил ГрузоБот: Python, MAX API, SQLite и первые пользователи

Время на прочтение5 мин
Охват и читатели9K

Несколько месяцев назад я начал делать небольшой сервис для контейнерной логистики.

Изначальная идея была довольно простой: заменить бесконечную публикацию одних и тех же грузов и свободных машин в рабочих чатах нормальным поиском.

Так появился ГрузоБот это сервис для грузоотправителей, экспедиторов и перевозчиков, работающий через мессенджер MAX.

Сейчас проект уже находится в бета, но продакшене, поэтому хочу рассказать не столько о самом сервисе, сколько о том, что оказалось под капотом и с какими задачами пришлось столкнуться при разработке.

Читать далее

Ближайшие события

Складской учёт на трёх платформах без дублирования логики: расширение Chrome, мобилка и SaaS из одного кода

Время на прочтение14 мин
Охват и читатели7K

Я довольно давно вожусь с сервисами вокруг товарных данных: делаю price‑matrix (обработка прайсов поставщиков) и CatalogLoader (парсеры сайтов). InventoryMod вырос из той же темы, но с другого конца — не «собрать и разобрать данные», а «вести по ним складской учёт».

InventoryMod — учётная система для склада: товары, остатки, движения, заказы, закупки, инвентаризация, отчёты. Начал где‑то в середине апреля 2026-го с расширения для Chrome с локальной базой (первый коммит в git датирован 19 мая — до него первая версия довольно долго собиралась «в столе»), потом добавились мобильное приложение и полноценный SaaS с сервером.

Главная проблема, с которой я жил всё это время, формулируется просто: как не писать три раза одну и ту же бизнес‑логику, когда база данных в каждой среде своя. Где‑то SQLite прямо в браузере, где‑то удалённый сервер по HTTP.

Дальше разберу на реальном коде из репозитория, как из query‑модулей выводится API‑контракт, почему я в итоге слез с IndexedDB на SQLite‑WASM и что творилось с транзакциями в резервировании остатков. Про сам продукт скажу ровно столько, сколько нужно для контекста.

Читать далее

Локальный компаньон для Genshin, HSR и ZZZ: как я упаковал три игры в офлайн‑приложение без бэкенда

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели8.1K

Забыли забрать ежедневные гемы или потеряли счёт круткам до гаранта? Рассказываю, как я решил собственную проблему и разработал GachaPoint — бесплатный офлайн‑компаньон для Genshin Impact, Honkai: Star Rail и Zenless Zone Zero без бэкенда и рекламы.

В статье разбираю техническую изнанку проекта для Android (Java / Architecture Components): Зачем использовал «плоскую» таблицу в SQLite (Room) для календаря и как это ускоряет выборки за один запрос, Почему для сетки дней кастомный GridLayout оказался удобнее RecyclerView, Как настроить точные ежедневные напоминания через WorkManager с учётом жестких ограничений Doze Mode в Android 12/13+.

Исходники проекта открыты, буду рад обсудить архитектуру и UI‑решения в комментариях!

Читать далее

Ваш исполняемый файл — это база данных SQLite

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели19K

Последние несколько лет я, похоже, одержим двумя темами: а) Nix в качестве инструмента для исследования новаторских идей, требующих возможностей перестройки мира; б) замена ELF на SQLite в качестве формата исполняемых файлов. Возможно, вы заметили, что эти две идеи хорошо сочетаются друг с другом.

Я изучал вторую идею в рамках своей диссертации, однако реакции окружающих оказались довольно разочаровывающими. Радикальные идеи сложно продвигать, ведь приходится бороться с инерцией давно устоявшегося решения.

Одним из результатов этого исследования стал инструмент sqlelf, позволяющий декларативно исследовать файл ELF при помощи SQL. [Я написал статью arXiv:2405.03883, которую мне не удалось опубликовать]. SELECT name FROM elf_symbols вместо возни с readelf и grep. Это оказалось на удивление просто благодаря использованию виртуальных таблиц для ELF, однако мне всё равно было интересно исследовать формат файлов ELF. Но всё же я понимал, что можно сделать нечто гораздо большее.

Меня всё не покидала эта мысль, а в свете прогресса LLM мне показалась привлекательной идея исследовать эту тему глубже. В частности, мне было любопытно, что будет, если мы заменим ELF на SQLite в качестве формата исполняемых файлов?

Не просто «база данных, описывающая исполняемый файл», а реальный файл, с которым можно сделать chmod +x и запустить его.

Читать далее

Мой сайт грузился две секунды, потому что каждый CSS-файл писал в базу данных

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели13K

Сайт не сломан. Он открывается. В логах чисто, ошибок нет — просто ты кликаешь по вкладке и успеваешь заметить, что кликнул.

Я померил: страница кабинета грузилась 2,1 секунды. При этом сервер отдавал HTML за 30 миллисекунд. Первый час я искал не там — потому что померил не ту страницу.

Всё решил один замер. Я дёрнул один и тот же CSS-файл десять раз с кукой сессии и десять раз без неё: 55 мс против 14 мс. За файл с диска. Оказалось, аутентификация делала SELECT, UPDATE и COMMIT в SQLite на каждую картинку и каждый скрипт — сорок раз за страницу, чтобы сорок раз переписать один и тот же таймстамп.

Вторым тормозом был Tailwind, который компилировал стили в браузере у каждого посетителя. Стало 0,9 секунды.

А потом я сел делать скриншоты для этой статьи и за двадцать минут нашёл ещё два бага, которые спокойно жили в проде. И чуть не уронил чат, исправляя найденное.

Код открыт

Смотреть, как я это нашёл

redb 3.7.1: поиск по props быстрее до 100 раз. Альтернатива EF Core или дополнение к нему

Уровень сложностиСложный
Время на прочтение7 мин
Охват и читатели11K

Цена запроса не зависела от того, что ищешь: фильтр стоял над GROUP BY. Теперь отсечение идёт до агрегата, на трёх движках, без единой правки в коде приложения. До 100 раз на диапазоне по дате и в 5,3 раза на полной выборке в MS SQL Server.

Есть класс проблем производительности, который не видно на маленьких данных и невозможно не заметить на больших. Наш выглядел так: запрос искал один редкий номер заказа среди сотни тысяч объектов ровно столько же, сколько поиск, не находящий ничего. Избирательность условия не влияла на время. Совсем.

Причина оказалась в форме сгенерированного SQL. Значения props живут построчно, и запрос сначала сворачивает их в широкую строку через GROUP BY, а уже потом применяет фильтр. Условие стояло над агрегатом, то есть фильтровало результат свёртки, а не колонку. Индексу там зацепиться не за что: к моменту проверки движок уже прочитал и свернул все значения всех объектов схемы. Триграммный индекс по строкам лежал без дела.

В 3.7.1 появился шаг, который ...

Читать далее

Как я искал скрытые паттерны в псевдо‑случайной генерации паролей пользователями

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели7.5K

И так, что мы имеем и для чего же собственно эта статья? Когда человеку ставят задачу в духе «Придумай пароль» — он берет и генерирует самостоятельно некую псевдослучайную последовательность, что в будущем именуется паролем (или с помощью генераторов паролей, которые встроены во все популярные браузеры, или с помощью установленных утилит). Казалось бы, можно и так понять, что самые часто используемые слова в духе «мама», «папа», «пароль» и другие — вполне объяснимы. Это то, что нас в большинстве своем объединяет, а потому может намного чаще встречаться в паролях. Не все люди хотят заморачиваться и отказываться от простых и понятных аналогиях. На примере старшего поколения моей семьи (бабуле) могу хоть сколько раз подтвердить, что ее излюбленный пароль был именем дочери и годом ее рождения.

А ведь в таких псевдо случайных генерациях можно встретить «проблему раскладки» (то, что проанализировано было в русском сегменте только в 2025 году следующими лицами: Леа Мюллер, Аушриус Юозапавичюс, Владимир Охримчук, Стефан Зюттерлин в работе «Поиск в словаре с использованием преобразованных русских слов на клавиатуре QWERTY», P. S. я мог допустить ошибки в переводе информации, за что прошу прощения). Если кратко, то это создает некую «маску», зная которую можно облегчить взлом. Подобные словари встречаются в открытом доступе, и еще чаще встречаются в недоброжелательном сообществе за разные суммы денег.

Читать далее

RAG‑система для анализа новостей с позиций исторической личности на основе литературных источников «АЙ_Ленин»

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6.6K

Широкое распространение СМИ в сети привело к формированию группы тематических экспертов — лидеров общественного мнения — блогеров. Их задача — оценка и анализ фактов, подача информации через призму собственного мнения.

Закономерно, мысленное упражнение, как человек, оставивший след в истории, оценил бы тот или иной современный факт.

Читать далее
1
23 ...