

Почему сэмплеры 4+ порядка взрываются в диффузии, и как мы это починили: история создания Flow-WLS
Сложный
6 мин
Обзор
Почему сэмплеры 4 и более порядков взрываются в диффузии, и как мы это починили: история создания Flow-WLS
Почему сэмплеры 4 и более порядков взрываются в диффузии, и как мы это починили: история создания Flow-WLS

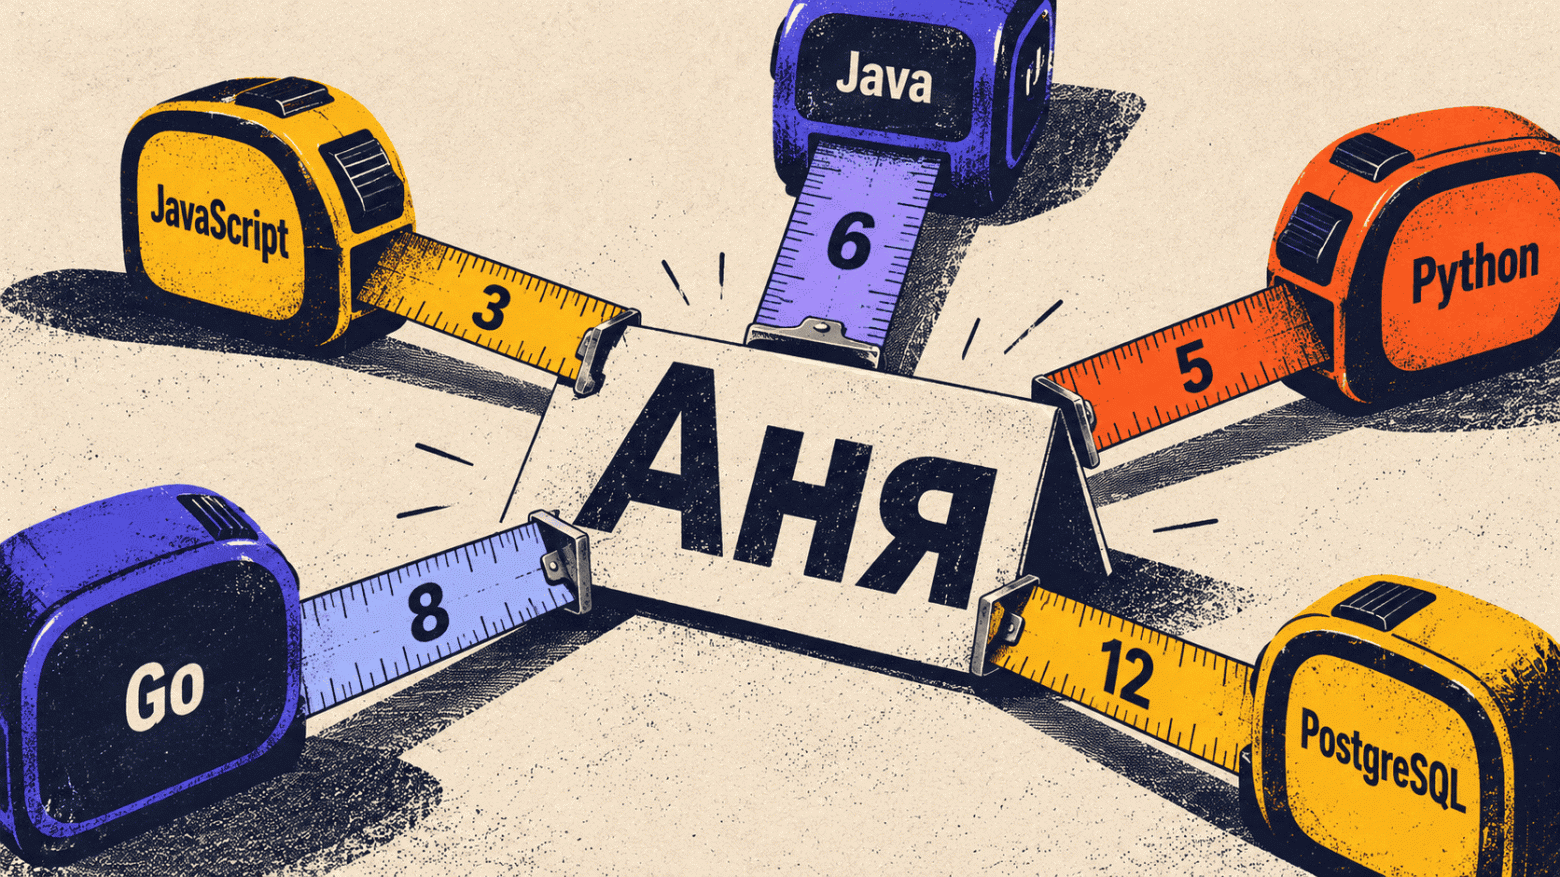
Пять видимых символов в нике могут превратиться в 10, 15 или 32 — смотря какой язык программирования их считает. Из‑за этой разницы пользователь получает ошибку валидации, теряет часть эмодзи или сталкивается с проблемой при сохранении данных. Разбираемся, почему JavaScript, Python, Go и другие языки по‑разному измеряют длину строк и как правильно задавать ограничения, чтобы данные не терялись.

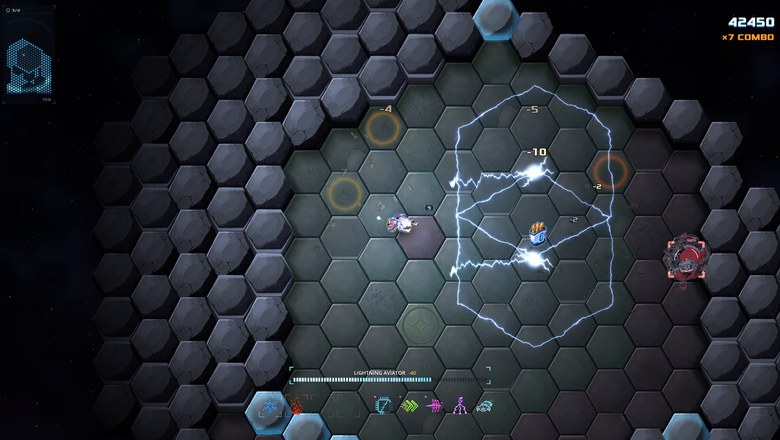
Корпус дрона игрока и боссов в нашем рогалике AsterMaster — не меш, а облако из ~6000 гауссиан, выученное по рендерам из Blender и упакованное в полмегабайта. Поэтому его можно мять, дырявить, рвать на куски и собирать обратно — целиком в вершинном шейдере Godot.
В статье: зачем Gaussian Splatting в игре, где персонаж занимает сотню пикселей; пайплайн «Blender → gsplat → свой бинарный формат → Godot Compatibility» с тренировкой за 21 секунду; запечённые каналы, энтропийная бинаризация и чистка флоатеров; деструкция — кратеры, «луковица», граф опоры и куски по материалам; и честные пост-мортемы того, что не взлетело — с цифрами.


Один из вопросов, который я довольно часто слышу от начинающих разработчиков, звучит примерно так:
«А зачем мне вообще нужны алгоритмы?»
Зачем разбираться с битовыми операциями? Зачем думать об алгоритмической сложности? Зачем на собеседованиях дают все эти странные задачи, если в реальной работе я буду писать API, перекладывать JSON из одного сервиса в другой и подключать очередную библиотеку?
Вопрос, надо сказать, вполне справедливый, особенно когда в очередной раз сидишь перед задачей, в которой предлагается что-нибудь сдвинуть на три бита вправо, наложить маску 0xFE, а потом почему-то ещё радоваться полученному результату.
Вместо абстрактных рассуждений о том, насколько алгоритмы развивают мышление, предлагаю посмотреть на совершенно обычную картинку.


Хотел проверить, как далеко можно зайти, если учить скрытый слой нейросети вообще без backprop, только локальными хеббовскими правилами. Спойлер: правило в итоге свелось к обычному k‑means, а backprop оно не обогнало ни по точности, ни при малом числе меток, ни по забыванию. Рассказываю, как сеть убивала собственные нейроны, как эволюция правил обманывала саму себя и где ошибался я сам.


Хотел разобраться с одним, казалось бы, простым вопросом: за что мы заплатили подрядчику? Платёж был в 1С, заявка была в Bitrix24, а договор и акты приходилось искать среди вложений. С поиска этой связи начался финансовый сервис, а вокруг него постепенно появились ещё четыре продукта. Расскажу, как они складываются в ERP‑контур для стройки, что уже работает и где автоматизация пока может уверенно ошибиться.


Работа (препринт) размещена на zenodo.org по ссылке: https://zenodo.org/records/23240531
Код и списки выложены в публичном репозитории на GitVerse по ссылке: https://gitverse.ru/mshshukin2005/real-schemes-degree8
В этой статье я хочу рассказать об одной из многих нерешённых математических проблем.
Речь пойдёт о Шестнадцатой проблеме Гильберта.
Шестнадцатая проблема Ги́льберта — одна из 23 задач, которые Давид Гильберт предложил 8 августа 1900 года на II Международном конгрессе математиков.
Исходно называлась «Проблема топологии алгебраических кривых и поверхностей». Впоследствии фактически разделилась на две похожие проблемы в разных областях математики:
исследование взаимного расположения овалов вещественных алгебраических кривых степени n (и аналогичный вопрос для алгебраических поверхностей);
получение верхней оценки на число предельных циклов полиномиального векторного поля степени n (и исследование их взаимного расположения).
Источник:https://ru.wikipedia.org/wiki/Шестнадцатая_проблема_Гильберта


Я задал пяти нейросетям с включённым поиском 20 вопросов покупателя услуги продвижения и выписал домены из ссылок под ответами. Вышло 211 сайтов, и на 161 из них сослалась только одна нейросеть. Сайтов, на которые ссылаются три нейросети и больше, всего 17, и они стоят в 79% ответов со ссылками. Два из них, Sostav и vc.ru, — больше чем в половине. Через шесть недель девять сайтов из этих 17 снова оказались общими для трёх нейросетей и больше.


ExtremeCleaner — незаменимый инструмент для контроля занятого места на диске. Он не только чистит кэш, но и показывает, что ещё съедает гигабайты: большие AI-модели (Ollama, LM Studio), старые сохранения игр и миры Minecraft, забытые загрузки и видео, образы виртуальных машин, почтовые базы, записи звонков, кэши Spotify и видеоредакторов, старые версии программ.
Три вкладки: безопасная очистка в корзину, ваши файлы для ручного разбора и системные места (гибернация, WinSxS, точки восстановления, кэш обновлений) с инструкциями, как их подсократить при желании. Каждый пункт объяснён: что это и опасно ли трогать.
Если у вас небольшой SSD, свободное место на котором постоянно стремится к нулю, — этот инструмент решит вашу проблему с очисткой диска: регулярно находит, что можно безопасно убрать, и показывает, куда утекает место. Только для Windows.
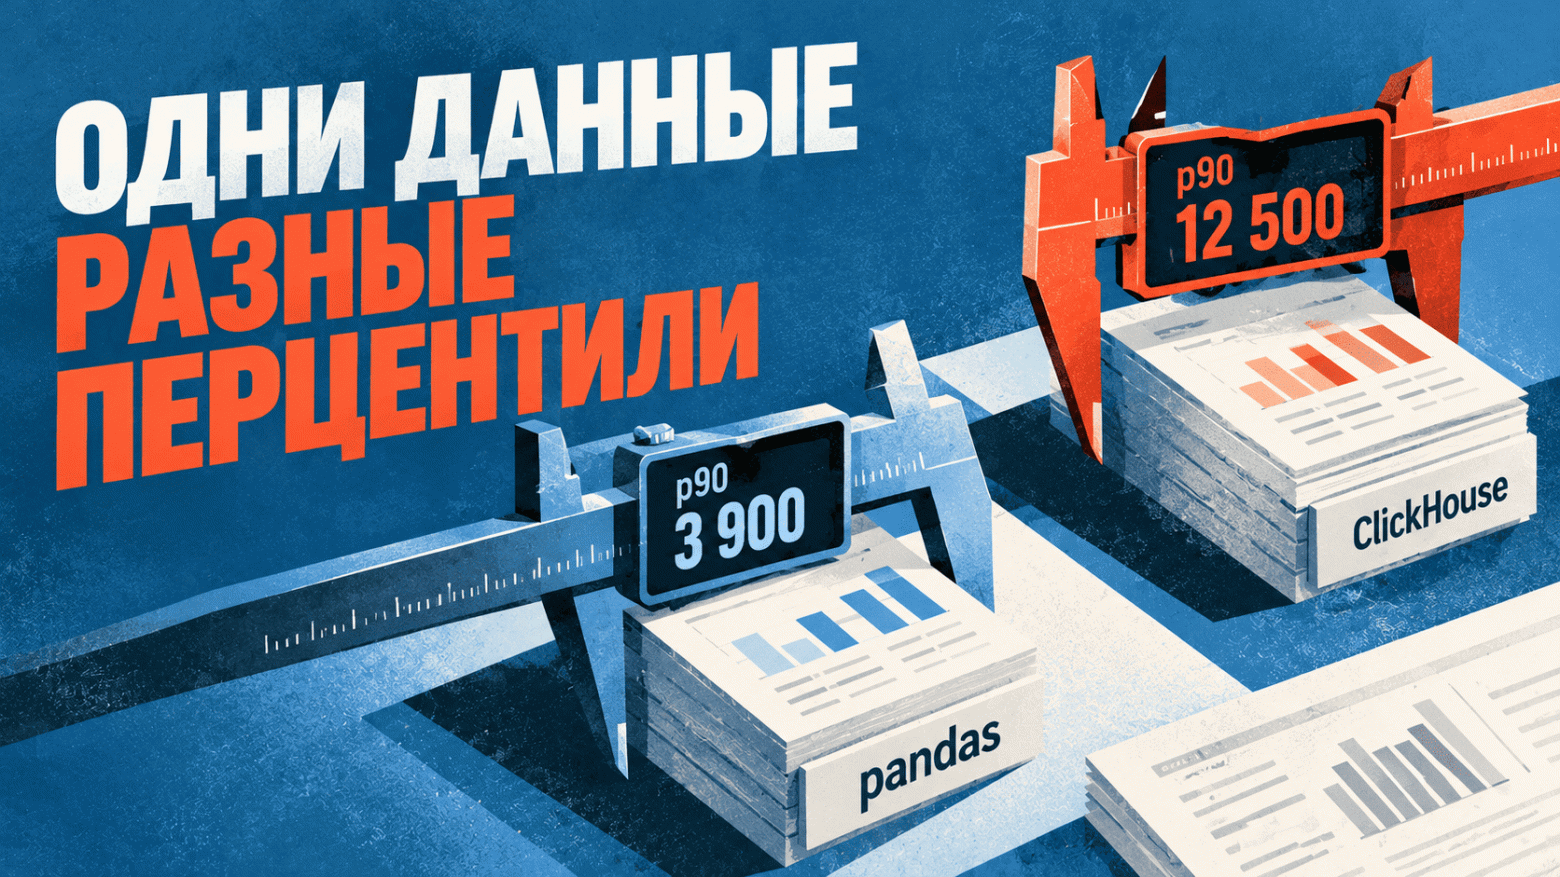
Один и тот же набор из десяти заказов, а p90 получается от 3900 до 12 500 рублей. В ноутбуке аналитика одна цифра, на дашборде другая, и даже повторный запуск запроса иногда меняет результат. Причина может скрываться в самой функции расчёта перцентиля — разберёмся, как разные инструменты выбирают значения и какой метод использовать, чтобы метрики можно было сравнивать.

Работаю в VS Code в Linux-виртуалке UTM на маке, и прокрутка там всегда прыгала по три строки и очень чувствительна к движениям пальца, вместо прокрутки приходилось пользоваться обычными стрелками на клаве. Ранее я уже просил Claude это исправить: поставили замедлитель и imwheel, не помогло, на этом и остановились. В этот раз Claude Opus 5.5 за один чат и пару моих правок разобрался до конца. Выяснилось, что причин три, и одна сидит в самом libinput (уж очень клод акцентирует внимание на этой причине): он придерживает первые пол-щелчка каждого жеста и выдаёт их рывком. Claude написал прогу с интерфейсом и настройками, залил всё на GitHub. До идеала macOS не дотягивает - первое движение нужно делать чуть длиннее, чем на маке. В остальном прокрутка плавная и привычная, результатом доволен. В статье - технический разбор, как это получилось. Картинка, вся работа и статья от клода опус 5.5.

21 октября 2026 года на PyPI вышел litellm==1.107.0 со стилером учётных данных, а образы Docker с тем же тегом оказались заражены. LiteLLM — один из самых популярных open-source LLM-шлюзов: он хранит ключи ко всем вендорам моделей, которыми пользуется команда. Для LiteLLM это второй такой случай за год: в марте 2026 были скомпрометированы версии 1.82.7 и 1.82.8.

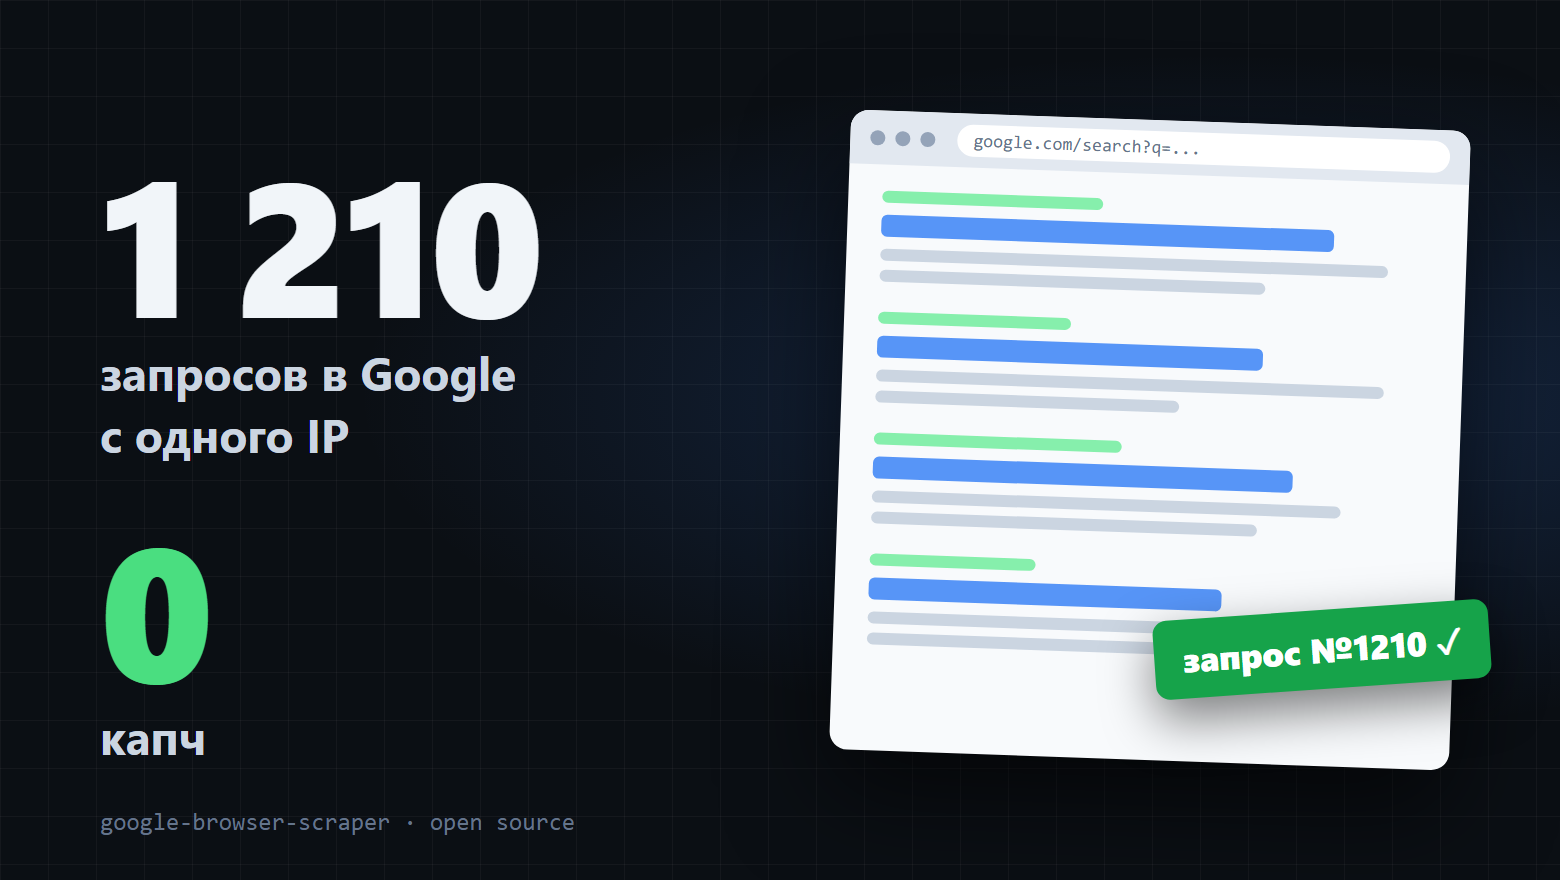
Задача звучала скучно: собирать выдачу Google. Много, регулярно, через обычные резидентные прокси и без платных SERP API.
Первая версия честно открывала Chrome, вбивала запрос и получала капчу. Вторая получала капчу чуть реже. А потом один IP отработал 1210 запросов подряд, и Google ни разу не попросил доказать, что мы не робот. Между этими двумя точками было двадцать экспериментов и вкладка, которая съела 3 гигабайта памяти. И главный вывод: мы всё это время думали о Google неправильно.

Добрый день, всем любителям Oracle и пирогов из картофельных очистков!
Одна из самых часто встречающихся проблем при использовании баз данных - это поиск узких мест: нахождение долго выполняющихся запросов и их исправление.
Как часто вы сталкивались с ситуацией, когда запрос мгновенно отрабатывает в тестовом окружении, но начинает «тормозить» на боевом сервере? Или замедление запросов проявляется не сразу, а по мере роста данных?
Я написал open-source утилиту Optimus Oracle. Она получает тяжёлые SQL-запросы из ASH/AWR, собирает планы и через LLM (локальные или облачные) предлагает оптимизацию: создание индексов или изменение запроса. Дальше - реальные примеры «до/после», цифры, грабли и честный разговор о приватности.

Внедрение AI в программные продукты часто сопровождается необходимостью обогатить контекст LLM специфичными для ваших задач данными. Для обогащения знаний используемой вами модели применяется два подхода:
- fine-tuning — дообучение модели на ваших данных. Тут финансовые затраты идут на обучение модели:
-- ресурсы на fine-tuning в случае on-prem решения,
-- дополнительные средства за дообучение модели по подписке.
- RAG — внешний источник данных, данные из которого передаются в качестве контекста к промпту в LLM. Затраты тут переносятся на размер запроса за счёт увеличения входящего контекста.
Так как я программист, а не Data Scientist, то предпочитаю понятные, переносимые вне зависимости от способа размещения модели, подходы, поэтому мой выбор — RAG.

Redis у сервиса прогнозов не было восемь недель: контейнер упал с кодом 255 и больше не поднялся. Всё это время каждый запрос считался заново, 1,9 секунды вместо 11 миллисекунд. При этом авария не была тихой. В обработчике ошибки стоит self.redis_client = None с комментарием про заглушку, но заглушки там нет, поэтому каждый вызов get и set падал с AttributeError, ловился своим же except и писал ERROR в лог. Две строки на каждый запрос, восемь недель подряд. Разбираю, почему я этого не видел, почему health сервиса всё это время отдавал вписанное в код «ok» с таймстампом из мая 2025 года, и чем аккуратно обработанный отказ отличается от обычной поломки.

Следуя принципу: “Работает - не трогай” и привыкнув к mypy еще очень много лет назад, я в какой-то момент собрал свой собственный конфиг линтеров и форматтеров и таскал его, то выкидывая, то добавляя что-то новое: там были flake8, isort, black, yapf, pylint, pyflakes… Но потом пришел Ruff, и всех их не стало. И только mypy пережил их всех. Надолго ли?
Посмотрев недавно на время прогона mypy в Gitlab CI, я решил обратить внимание на ty и Pyrefly как на возможную замену mypy: хотелось сократить время проверки и при этом не потерять в её качестве. Для сравнения взял два своих бэкенда, на которых mypy уже используется. Проверил время запуска с нуля и повторной проверки, а затем разобрал расхождения в диагностике.


Допустим, вы ведёте документацию или блог и хотите, чтобы куски текста попадали в ответы ChatGPT, Perplexity или Алисы AI. Я проверил на ответах Perplexity простой совет — не начинать абзац с «это», «он» или «поэтому». Такие начала одинаково редки у абзацев, которые нейросеть взяла, и у тех, что пропустила.
Заметно отличается другое: взятые абзацы длиннее. Совет появился потому, что нейросеть с поиском берёт со страницы не всю статью, а один-два абзаца, и они должны быть понятны без соседей. Но если чистить только «это», можно потратить вечер на правку и не изменить ничего.


Остановил Python сервис с моделью машинного обучения, .NET API продолжил работать и вернул HTTP 503. После восстановления Python запрос снова завершился с HTTP 200, без перезапуска основного приложения.
Зачем разделять .NET и Python, как организовать взаимодействие между ними и что нужно предусмотреть, чтобы отказ ИИ оставался проблемой отдельной функции, а не всей платформы.

У TenChat нет публичного API для публикации постов. Отложенная публикация в самом сервисе есть только на платном тарифе (на 28.09.2026 от 990 ₽ в месяц), а мне нужен был простой сценарий: раз в день берём следующую статью из блога, собираем из неё короткий пост с обложкой и выкладываем без участия человека. Я написал для этого скрипт на Python и Playwright, он работает на сервере по cron с конца сентября 2026 года. В статье разберу, как скрипт входит в аккаунт без пароля, как заставить редактор Quill принять готовую вёрстку, чем завершились первые недели и какие грабли попались при переезде с ноутбука на сервер.
Сразу оговорка. Автоматизация через браузер может не нравиться самой площадке, и правила сервиса стоит прочитать до запуска. Я публикую только собственные тексты, один пост в день, в своём аккаунте. Обходить защиту или маскироваться под человека скрипт не пытается, и дальше речь пойдёт только про инженерную сторону.