Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

114,62
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Использование миграций баз данных в Go

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели20K

Недавно мы столкнулись с необходимостью найти библиотеку для удобной работы с базами данных. В проекте было принято решение не использовать ORM, а вместо этого применить миграции. Так как я работал только с ORM, мне, как и автору статьи, было мало знакомо понятие миграций баз данных. В поисках информации о миграциях и популярных решениях, я наткнулся на эту статью. Перевод статьи я оставил ниже. Возможно, она будет вам полезна. Буду признателен, если вы сможете поделиться библиотеками, которые используете.

Читать далее

Искусство ETL. Пишем собственный движок SQL на Spark [часть 6]

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели4K

НЬЮ!


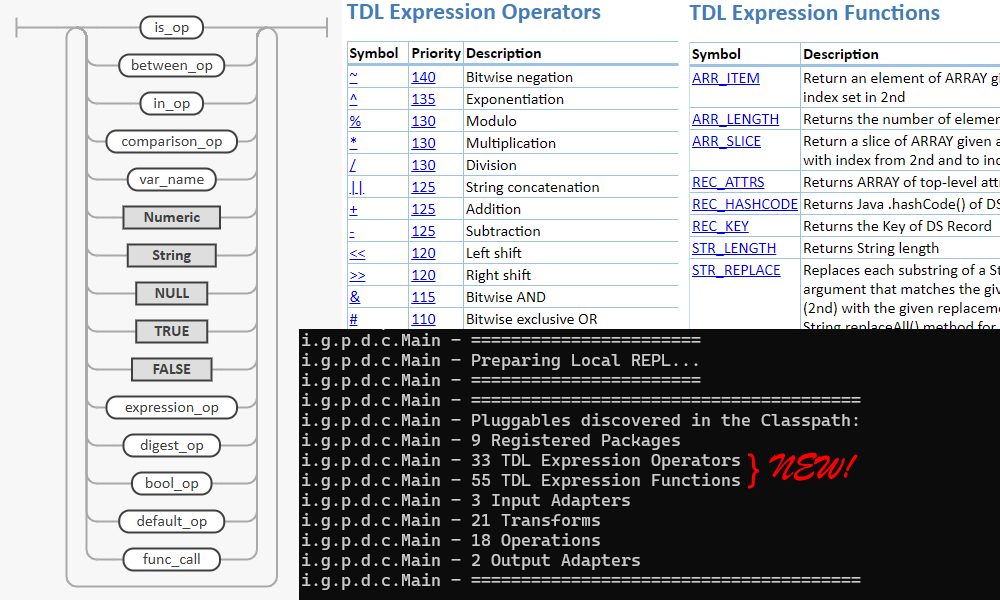
В предыдущих сериях (FAQ 1 2 3 4 5 ) мы весьма подробно рассмотрели, как написать на Java собственный интерпретатор объектно-ориентированного диалекта SQL поверх Spark RDD API, заточенный на задачи подготовки и трансформации наборов данных.

В данной части поговорим о том, как добавить в выражения SQL поддержку функций. Например,


SELECT
    MAX(score1, score2, score3, score4, score5) AS max_score,
    MIN(score1, score2, score3, score4, score5) AS min_score,
    MEDIAN(score1, score2, score3, score4, score5) AS median_score,
    score1 + score2 + score3 + score4 + score5 AS score_sum
FROM raw_scores INTO final_scores
WHERE ABS(score1 + score2 + score3 + score4 + score5) > $score_margin;

— тут у нас функции MAX, MIN и MEDIAN принимают любое количество аргументов типа Double и возвращают Double, а ABS только один такой аргумент.


Вообще, кроме общей математики, в любом уважающем себя диалекте SQL как минимум должны быть функции для манипуляций с датой/временем, работы со строками и массивами. Их мы тоже обязательно добавим. В classpath, чтобы движок мог их оттуда подгружать. До кучи, ещё и операторы типа >= или LIKE, которые у нас уже были реализованы, но хардкодом, сделаем такими же подключаемыми.


Предупреждение о сложности материала

Уровень сложности данной серии статей в целом высокий. Базовые понятия в тексте совсем не объясняются, да и продвинутые далеко не все. Однако, эта часть несколько проще для ознакомления, чем предыдущие. Но всё равно, понимать её будет легче, если вы уже пробежались по остальным хотя бы по диагонали.

Читать дальше →

Проекции в Vertica: что это, как использовать, и почему не стоит создавать их под каждый запрос

Время на прочтение6 мин
Охват и читатели9.4K

Иван Якунин, продуктовый аналитик команды Fintech Marketplace, рассказал про то, как в Авито работают с Vertica, и на примерах объяснил, что такое проекции, и когда их стоит использовать.

Читать далее

Потенциальные проблемы с автоинкрементным ключом. MySQL <8.0, PostgreSQL

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели8.8K

В данной публикации я поделюсь двумя основными причинами, по которым я предпочитаю избегать использования автоинкрементных полей в PostgreSQL и MySQL в будущих проектах. Вместо этого я предпочитаю использовать UUID-поля, за исключением случаев, когда есть очень веские аргументы против этого подхода.

Читать далее

Spark. План запросов на примерах

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели12K

Всем привет!

В этой статье возьмем за основу пару таблиц и пройдемся по планам запросов по нарастающей: от обычного селекта до джойнов, оконок и репартиционирования. Посмотрим, чем отличаются виды планов друг от друга, что в них изменяется от запроса к запросу и разберем каждую строчку на примере партиционированной и непартиционированной таблицы.

Читать далее

Фреймворк DBGridChart и OLAP-приложение Экспресс_обработка.exe для ведения баз данных и анализа данных

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели3.2K

В статье рассматриваются назначение, основные особенности и возможности Фреймворка “DBGridChart”  и OLAP – приложения “Экспресс_обработка.exe” (разработчик – Плещев В.В., http://vipuskniki.usue.ru/Docum.html - DLL, исходные тексты, описание и демонстрационные примеры).

Фреймворк ориентирован на автоматизацию разработки программ на C# по формированию входных табличных и ленточных документов для ведения баз данных c СУБД SQL Server, PostgeSQL, MySQL, Access  в режиме непостоянного соединения ADO .NET и немедленного (без промежуточного накопления изменений) добавления, удаления или изменения записей с соблюдением целостности базы данных, а также для формирования заранее нерегламентированных аналитических таблиц и диаграмм для анализа данных, по унифицированной технологии (с использованием управляющих элементов  dataGridView и Chart в C#) с много функциональным, унифицированным, адаптивным и комфортным для пользователей готовым интерфейсом.

OLAP-приложение  “Экспресс_обработка.exe” позволяет: вынести описания запросов  Select из исходных текстов программ в отдельный текстовый файл, что исключает необходимость в разработке оригинальных программ для ведения баз данных с различными СУБД и формирования аналитических таблиц и диаграмм. Для формирования запросов разработан специальный визуальный конструктор.

Информация о таблицах, запросах Select и их полях берется автоматически конструктором из базы данных. Не выходя из приложения, пользователь может оперативно визуальным конструктором запросов формировать, сохранять и использовать запросы  для анализа данных и ведения базы данных. Само приложение реализовано средствами Фреймворка “DBGridChart”. 

Предлагаемые средства прошли тестирование при работе с базами данных с различными СУБД и используются в учебной и практической деятельности.
Читать далее

Отладка в SQL Developer

Уровень сложностиПростой
Время на прочтение28 мин
Охват и читатели8.2K

Привет! Меня зовут Алексей Маряхин, я разработчик на Oracle. В этой статье продолжим знакомиться с темой отладки PL/SQL-кода.

 В предыдущей статье мы изучили возможности отладки в PL/SQL Developer. В этой предлагаю рассмотреть ещё один инструмент — SQL Developer (версия 21.2.0.187 Build 187.1842). Также обозначим плюсы и минусы этих инструментов в сравнении.

Как оказалось, информации на русском языке на эту тему не так много, а документация по SQL Developer не отвечает на многие вопросы. В статье постараюсь осветить основные моменты касательно использования SQL Developer для отладки. Если тема для вас актуальна, велком!

Читать далее →

Книга «SQL. Pocket guide, 4-е изд.»

Время на прочтение7 мин
Охват и читатели7.8K
image Привет, Хаброжители!

Если вы аналитик или инженер по обработке данных и используете SQL, популярный карманный справочник станет для вас идеальным помощником. Найдите множество примеров, раскрывающих все сложности языка, а также ключевые аспекты SQL при его использовании в Microsoft SQL Server, MySQL, Oracle Database, PostgreSQL и SQLite.

В обновленном издании Элис Жао описывает, как в этих СУБД используется SQL для формирования запросов и внесения изменений в базу. Получите подробную информацию о типах данных и их преобразованиях, синтаксисе регулярных выражений, оконных функциях, операторах PIVOT и UNPIVOT и многом другом.
Читать дальше →

Разработка автоматизированной очереди для сдачи лабораторных работ

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели3.2K

Учеба в политехе заключается в сдаче лабораторных работ. Буквально. Очень редко бывает такое, что на парах мы чему-то учимся, зачастую все завязано на самообучении. Грубо говоря, вот вам методичка, разбирайтесь сами, через неделю дедлайн.

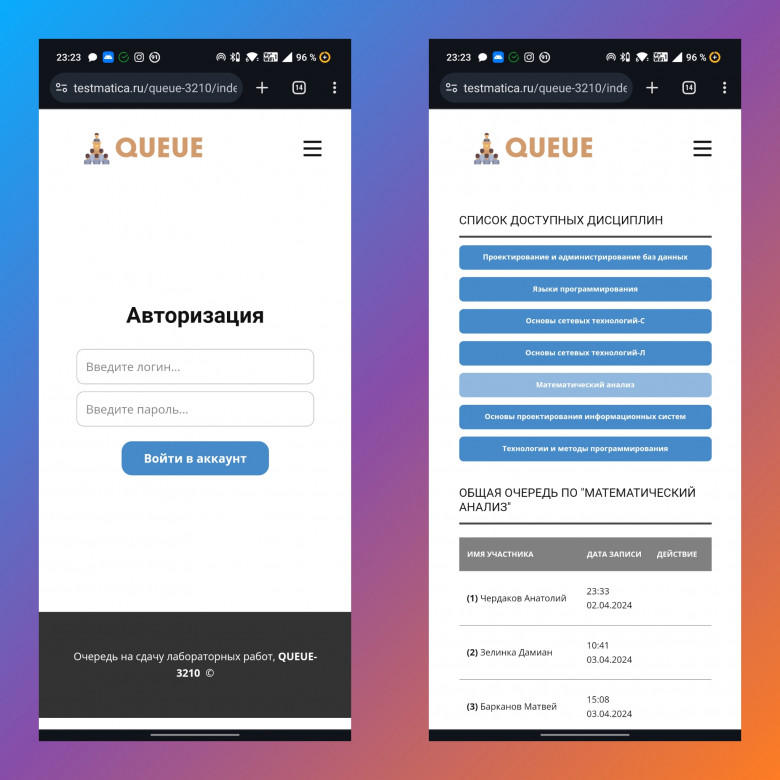
В связи с этим мы столкнулись с очередями на сдачу этих лабораторных. Сначала просто писали в общий чат, кто каким будет в очереди (например, "я первый", "я вторая", "я третий" и т.д.). Далее решили создать расшаренную таблицу в гугле для формирования очередей. Однако долго она тоже не прожила, так как со временем появились "умники", которые стали ставить себя первыми в очереди, сдвигая остальных вниз. Потом общий доступ для таблицы закрыли, и было принято решение для записи на сдачу писать старосте, он, в свою очередь, будет добавлять студентов в список. Но староста группы не может быть постоянно на связи, иными словами, оперативно добавиться в очередь было просто невозможно.

В связи с этим я задумался над созданием автоматизированной очереди. В качестве стека основных технологий выбрал HTML5+CSS3 для фронтенда, PHP для бэкенда. В качестве СУБД был выбран phpMyAdmin (SQL-DB). В первую очередь, конечно, необходимо было продумать структуру базы данных. Предметная область информационной системы уже была сформулирована: "Очередь на сдачу лабораторных работ с возможностью записи по отдельным дисциплинам, удаления своей записи. Учет истории создания записи, удаления записей, включая время записи. Возможность смены пароля, просмотра профиля." Даталогическая модель БД была построена в MySQL Workbench 8.0 CE в нотации IDEF1X.

Читать далее

Дашборд управления бизнесом (P&L) в Metabase за 5 дней

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели11K

Один из важнейших инструментов в моей работе — дашборд с данными о прибылях и убытках компании P&L (он же БДР, он же отчет о финансовых результатах). Он помогает контролировать рентабельность бизнеса, эффективность отделов компании, прогнозировать прибыль и строить гипотезы для развития. В этой статье расскажу, как его настроить и использовать при помощи Open-Source BI-системы Metabase.

Читать далее

Интеграция Grist и Metabase

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.8K

Привет! Меня зовут Александр Ежков, я Backend-разработчик в AGIMA. Занимаюсь созданием и поддержкой внутренних сервисов для компании. А конкретно сейчас — нашей DWH-системой. Мы построили ее из Open-source продуктов. В этой статье расскажу, какие продукты мы используем, какие хитрости придумали для работы с ними как вся система работает вместе.

Читать далее

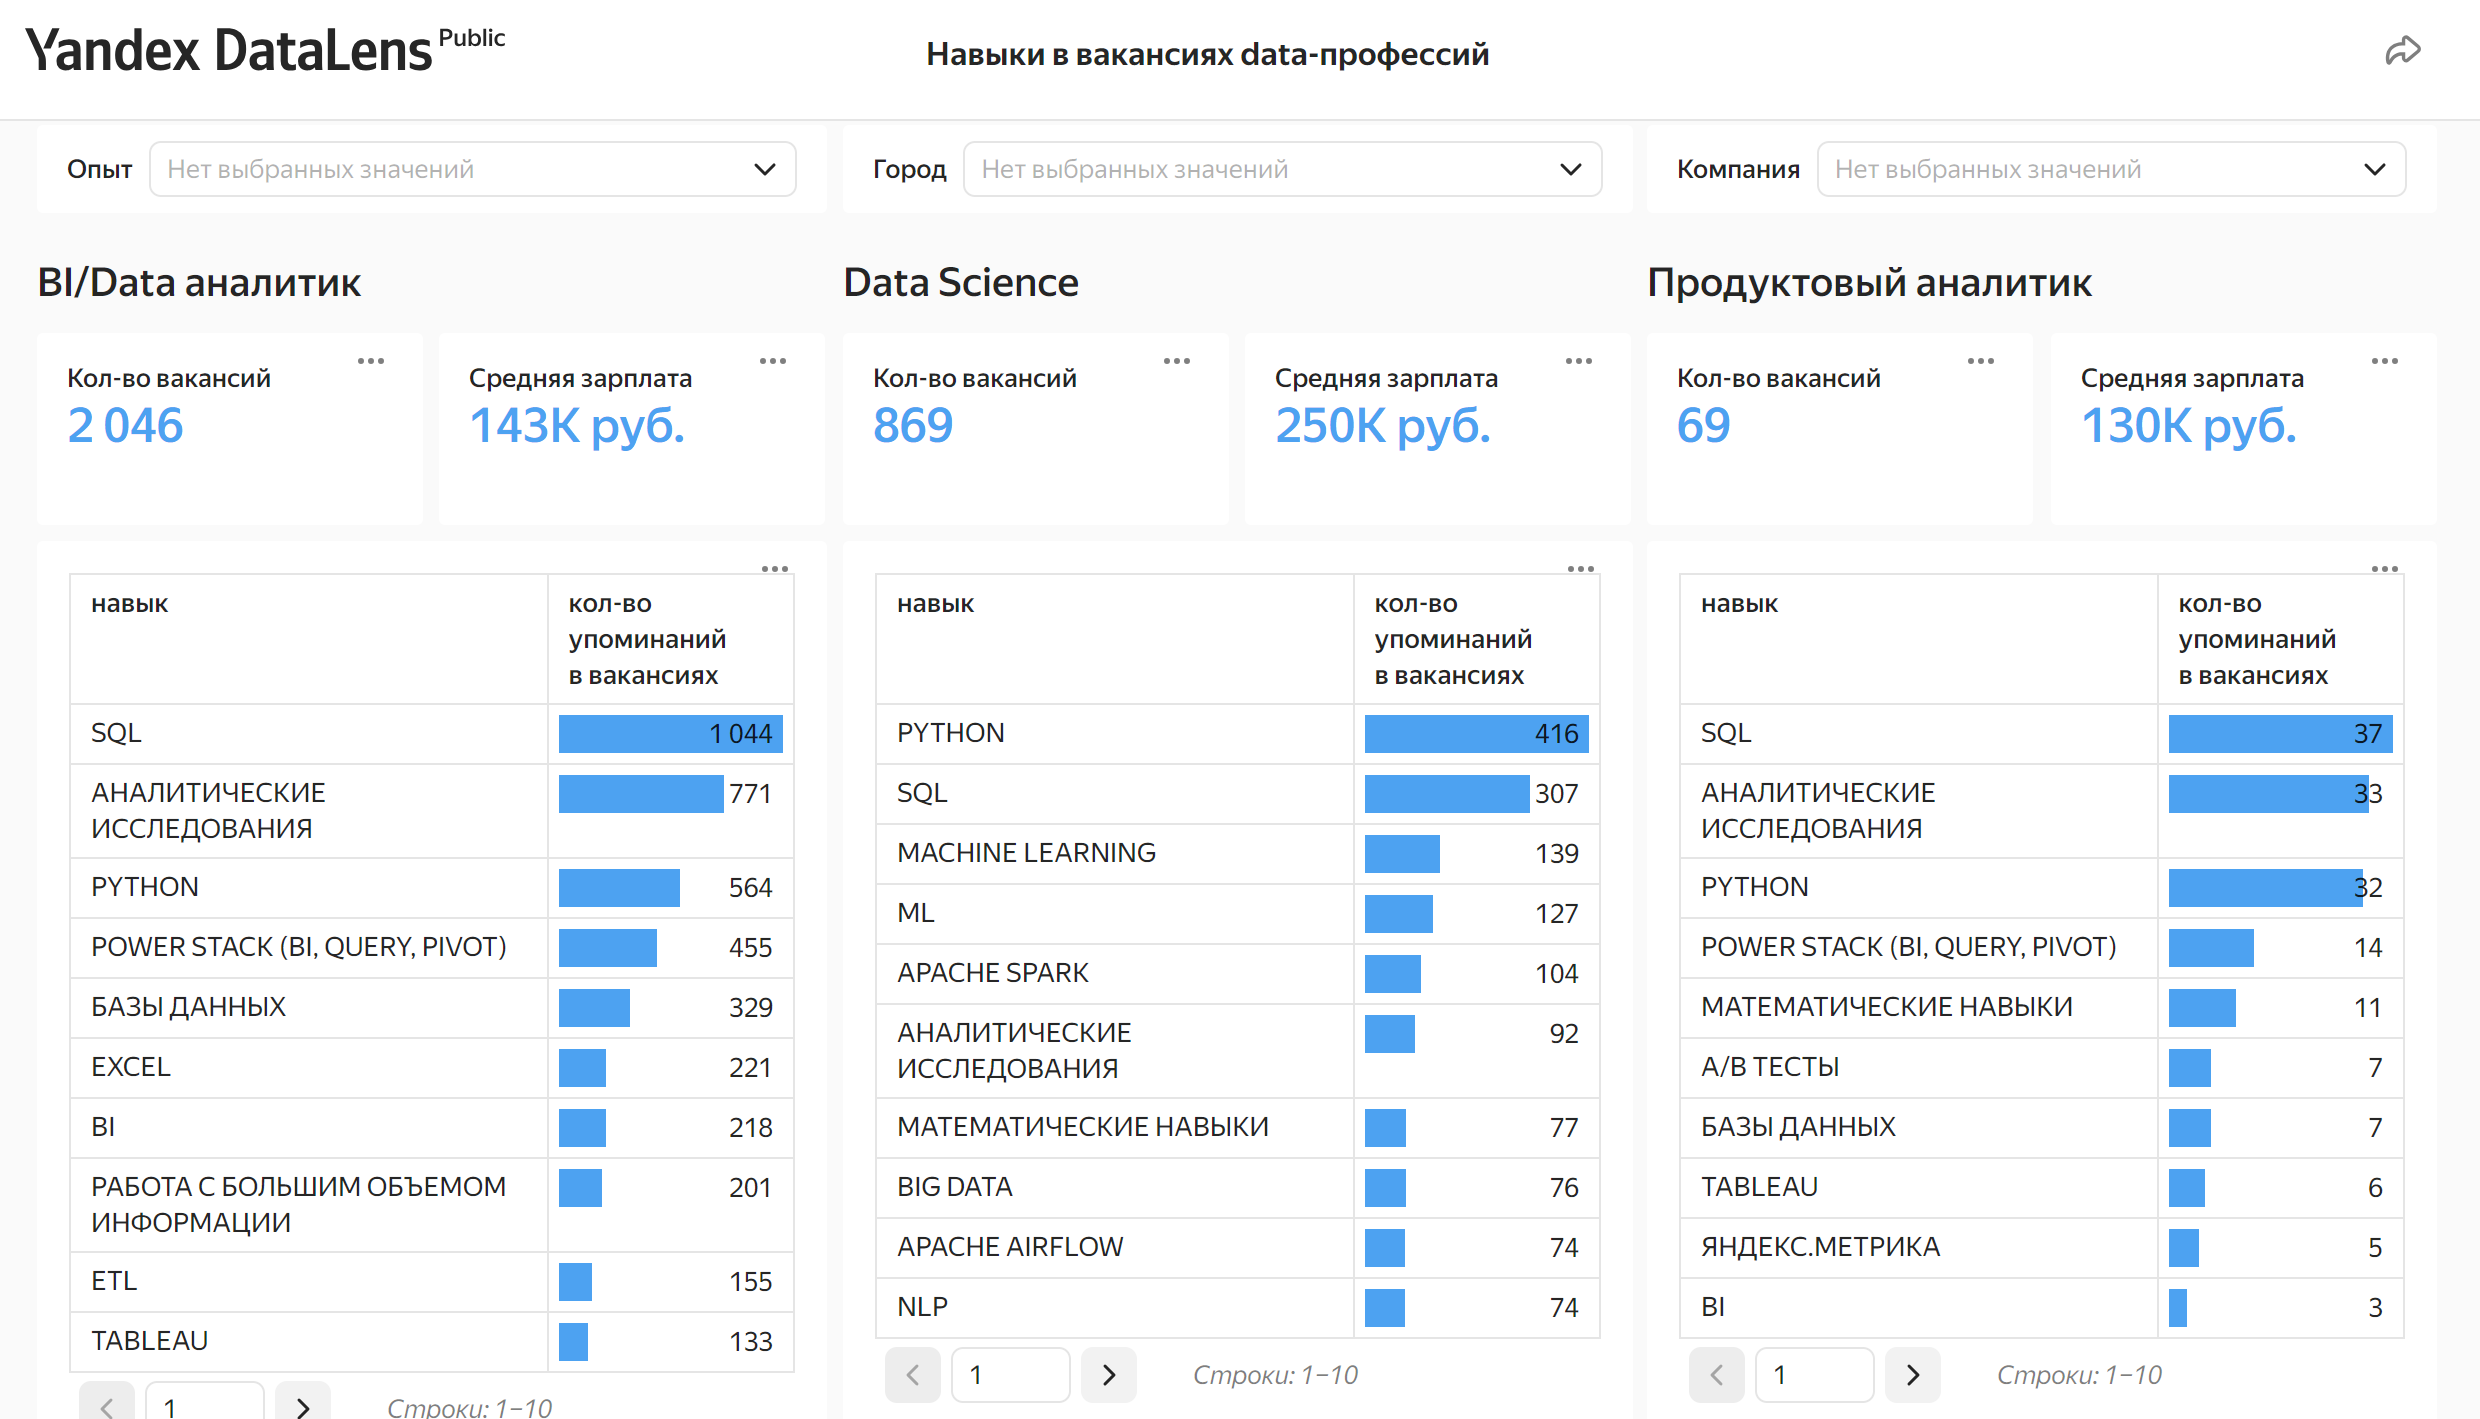
Анализ навыков data-специализаций в вакансиях HH.ru

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели9.1K

Всем привет!

--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------

Читать далее

Статический анализ структуры базы данных (часть 2)

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели6.7K

Продолжим разбор проверок структуры базы данных, на примере PostgeSQL. Данная статья будет посвящена проверкам связанным с ограниением FOREIGN KEY (FK). Часть проверок целесообразно выполнять на регулярной основе, а некоторые позволяют лучше понять структуру проекта при первом знакомстве и применяются только один раз.

Читать далее

Ближайшие события

Курс «PostgreSQL для начинающих»: #4 — Анализ запросов (ч.1 — как и зачем читать планы)

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели85K

Продолжаю публикацию расширенных транскриптов лекционного курса "PostgreSQL для начинающих", подготовленного мной в рамках "Школы backend-разработчика" в "Тензоре".

В этой лекции мы узнаем, что такое план выполнения запроса, как и зачем его читать (и почему это совсем непросто), и о каких проблемах с производительностью базы он может сигнализировать. Разберем, что такое Seq Scan, Bitmap Heap Scan, Index Scan и почему Index Only Scan бывает нехорош, чем отличается Materialize от Memoize, а Gather Merge от "просто" Gather.

Как обычно, для предпочитающих смотреть и слушать, а не читать - доступна видеозапись (часть 1, часть 2) и слайды.

Читать далее

PostgreSQL 17: Часть 4 или Коммитфест 2024-01

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели7.7K


Весна уже в разгаре, а мы вспомним горячие новости самого зимнего, январского коммитфеста. И сразу начнем с козырей.


Предыдущие статьи о 17-й версии: 2023-07, 2023-09, 2023-11.

Читать дальше →

Медленное выполнение команды TRUNCATE: анализ проблемы блокировок спинлока в SQL Server

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели4.3K

Приветствую всех читателей Хабра! Меня зовут Михаил, я администратор DBA в компании «Автомакон». На данный момент работаю на проекте для «ВкусВилл».

Решил затронуть одну из насущных проблем, связанную с работой SQL Server, а именно со спинлоками в нем. Да, даже такой зрелый и стабильный продукт как Microsoft SQL Server иногда подкидывает неожиданные задачи. Этот кейс хорошо демонстрирует, насколько увлекательные и интересные задачи решают администраторы баз данных. 

Читать далее

Развитие баз данных

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели17K

В 60-х годах прошлого века возникла потребность в надежной модели хранения и обработки данных, особенно важной для банков и финансовых организаций. В то время отсутствовали единые стандарты работы с данными и моделями, и вся работа сводилась к ручной упорядоченной организации информации. Банкам удавалось записывать информацию о транзакциях в виде файлов в заранее подготовленную структуру, причем у каждой организации было собственное представление о том, как это должно выглядеть и функционировать. Также отсутствовали понятия консистентности (согласованности данных) и целостности данных. В таких файлах часто встречались дубликаты клиентов и их транзакций, которые приходилось уточнять и приводить в порядок вручную.

Данная статья захватывает ключевые моменты в развитии систем управления базами данных, от первых иерархических моделей до современных реляционных, NoSQL и NewSQL систем.

Читать далее

Автоматизация или как я избегала общения с коллегами. Часть 1

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели14K

Хочу написать небольшую серию постов о том, как я автоматизировала или ставила на конвейер какие‑то процессы, с разной степенью успешности, из личного и рабочего опыта. По функционалу это Python, SQL с привлечением Airflow, гитлаба и других стандартных инструментов.

Не поймите меня не правильно, я люблю людей, и своих коллег тоже (да, они тоже люди). Но когда им резко что‑то надо именно сейчас (ad‑hoc), и таких нуждающихся 30 человек‑ то я люблю их чуть меньше.

«Давай игнорировать ошибки» — бодро предложила я, и моя коллега меня поддержала. «Будет весело» — говорили они.

Я работала в нескольких высоко‑технологичных компаниях и командах, и далеко не все из моих коллег имели такое стремление хотя бы попробовать что‑то из рутины перевести в автоматический или полуавтоматический режим.

Что же я там выдумала

Как развернуть mysql в phpmyadmin с помощью docker

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели24K

Как развернуть базу данных mysql в phpmyadmin с помощью docker.

Так как я не нашёл на русском нормальный материал, то решил написать самостоятельно.

Читать далее

Как пишут SQL-запросы гуманитарии

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели28K

Когда говорят «мы ускорили выполнение нашего запроса в N раз» это значит, что сначала сделали плохо а потом начали думать как улучшить.

Так я думал раньше.

Читать далее