
Как пишут SQL-запросы гуманитарии
Простой
5 мин
Кейс
Когда говорят «мы ускорили выполнение нашего запроса в N раз» это значит, что сначала сделали плохо а потом начали думать как улучшить.
Так я думал раньше.

Формальный непроцедурный язык программирования
Когда говорят «мы ускорили выполнение нашего запроса в N раз» это значит, что сначала сделали плохо а потом начали думать как улучшить.
Так я думал раньше.


Статический анализ структуры базы данных — это процесс выявления ошибок, нерекомендуемых практик и потенциальных проблем в базе данных только на основе структуры, типов данных, свойствах объектов. Статиеский анализ структуры не задействует ни пользовательские данные, ни статистику по таким данным.
Рассмотрим подробнее статический анализ структуры базы данных — что это, какие задачи решает, как интегрировать статический анализ в CI.

Привет! Меня зовут Дима. Я из команды бэкенда Яндекс Телемоста — сервиса для проведения видеовстреч, который входит в Яндекс 360. Перед нами стоит задача не просто предоставить сервис, а предоставить отказоустойчивый и надёжный сервис, который работает 24/7 и обслуживает весь мир.
Телемост создан на основе open source решения Jitsi meet — оно постоянно развивается благодаря вкладу комьюнити, но при этом имеет свои ограничения. В статье расскажу, как мы встретили один редкий, но интересный плавающий баг. И конечно, как его лечили.

Приветствую, current_user()!
Хочется тебе показать, как можно хранить sql-скрипты объектов БД так, чтобы было удобно и разработчику, и ревьюеру, а так-же рассказать о плюсах и минусах такого подхода.
Так-же хотелось-бы узнать твоё мнение о таком подходе и обсудить, возможно стоит что-нибудь добавить в нём.

В последние месяцы в мире FirebirdSQL происходит значительное оживление: помимо релиза Firebird 5 было опубликовано много инструментов, статей и материалов, что я решил подготовить небольшой дайждест для читателей Хабра, которые, вероятно, соскучились по новостям о любимой СУБД.
Во-первых, вышла новая версия Калькулятора Конфигураций для Firebird, с поддержкой Firebird 5. В калькулятор (полностью бесплатный, доступен без регистрации) вводятся характеристики сервера, ...

Всем привет, меня зовут Пётр, я инженер компании Nixys. На современных проектах используется огромное разнообразие баз данных: реляционные, ключ-значение, документоориентированные. Особое место среди них занимают колоночные базы данных, ярким представителем которых является ClickHouse. Это мощный инструмент, который способен обрабатывать миллиарды строк в секунду при минимальном времени ответа. Однако, для максимальной эффективности ClickHouse необходимо понимать ряд фундаментальных моментов для того, чтобы использовать его по назначению. В этой серии статей мы разберем особенности работы ClickHouse, которые помогут в выжимании максимума из этой базы. И сегодня начнём с фундаментальных теоретических моментов, чтобы составить максимально полное общее впечатление, которое поможет нам в дальнейшем.


Упаковка интервалов — это классическая задача SQL, которая подразумевает переупаковку групп пересекающихся интервалов в соответствующие им непрерывные интервалы. В математике интервал — это подмножество всех значений данного типа, например целых чисел, между двумя некоторым разными значениями. В базах данных интервалы могут проявляться в виде интервалов даты и времени, представляющие такие вещи, как сеансы, периоды назначения, периоды госпитализации, расписания или числовых интервалов, представляющие такие вещи, как диапазоны мильных столбов на дороге, диапазоны температур и т.д.

Перевод статьи с Medium
В статье обсуждаются моделирование данных для хранения исторических данных, включая использование временных таблиц и исторических таблиц.
Временные таблицы добавляют две даты к каждой записи для определения периода актуальности данных, в то время как исторические таблицы сохраняют только последние записи в основной таблице, перемещая старые записи в отдельную историческую таблицу.
Это обеспечивает более четкий аудит изменений и улучшает производительность запросов к историческим данным, но требует дополнительного хранения и обслуживания.

OpenAI заложила фундамент для революции в сфере искусственного интеллекта с появлением ChatGPT, открывая новую эру в области AI, которую активно используют как отдельные люди, так и бизнес‑сообщества. OpenAI даже предоставила API для разработки персонализированных AI‑решений, включая чат‑ботов, виртуальных помощников и многого другого. Доступ к этому API можно получить через SDK, которые OpenAI выпустила для разных языков программирования, а также через оболочки, разработанные для удобства создания интерфейсов.
Компания Vercel внесла свой вклад, разработав AI SDK для создания интерактивных пользовательских интерфейсов с использованием TypeScript и JavaScript. Примечательно, что этот SDK является проектом с открытым исходным кодом и поддерживает Vercel Edge runtime.
В рамках данной статьи мы создадим SQL Expert ChatBot, применив API OpenAI и SDK от Vercel. Мы рассмотрим вопросы стриминговых ответов, настройки запросов и многое другое.


Всем привет! Меня зовут Виктор, я работаю в Компании БФТ-Холдинг руководителем группы разработки. В этой статье разберем подходы и рекомендации по выявлению и устранению проблем с производительностью в системе базы данных Greenplum. Материал будет особенно полезен начинающим разработчикам Greenplum, которые пока не имеют достаточного опыта «чтения» плана запроса.
Если проблема затрагивает определенную рабочую нагрузку или запрос, можно сосредоточиться на настройке этой конкретной рабочей нагрузки. Если проблема с производительностью является общесистемной, то причиной могут быть аппаратные проблемы, сбои системы или конкуренция за ресурсы.


В прошлой статье я показал, как условие с парой однотипных неравенств, плохо поддающееся индексации с помощью btree, можно переделать на эффективно gist-индексируемое в PostgreSQL условие относительно диапазонных типов, а наш сервис анализа планов запросов explain.tensor.ru подскажет, как именно это сделать.
Но что делать, если неравенств у нас не два, а целых четыре, да еще и с разными типами участвующих полей? Например, для целей бизнеса это может быть задачей вроде "найди мне все продажи за декабрь на сумму 10-20K", что на SQL будет выглядеть примерно так:
dt >= '2023-12-01'::date AND dt <= '2023-12-31'::date AND
sum >= 10000::numeric AND sum <= 20000::numeric

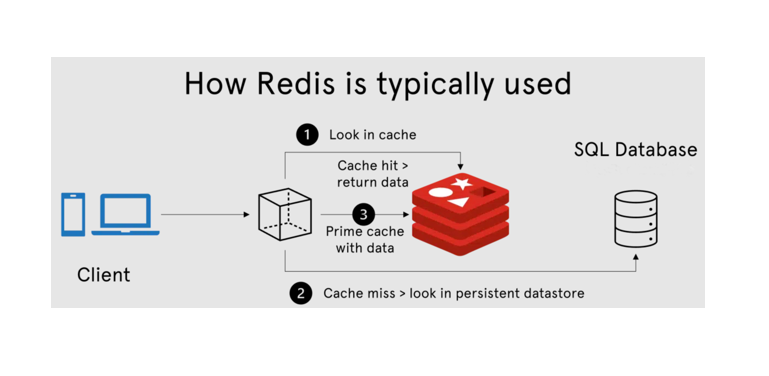
Допустим, мы хотим создать чат и хранить сообщения для него. Вполне возможно, мы можем добавить для этого простую базу данных (БД), такую как MySQL или даже NoSQL БД.
Обычно многие используют Redis как key‑value (dictionary) хранилище. Тем не менее, Redis — это несколько большее, чем key‑value, как многие привыкли думать.

Я уже не раз писал, что условия с несколькими неравенствами (<, <=, >=, >) обычно плохо подходят для индексирования "классическим" btree, вызывают "тормоза", и необходимо придумывать различные нетривиальные подходы в PostgreSQL, чтобы добиться хорошей производительности подобного запроса.
В этой статье мы не только рассмотрим способы решения подобных задач "в общем виде", но и покажем, как нам удалось автоматизировать их решение в рамках функционала рекомендаций индексов нашего сервиса анализа планов explain.tensor.ru и его новых возможностях.



PostgreSQL 16 вносит немало улучшений в планировщик запросов и позволяет выполнять многие SQL-запросы быстрее, чем в предыдущих версиях PostgreSQL.
Если вы посмотрите на PG16 release notes, то увидите некоторые из этих улучшений. Но из-за объема изменений, вносимых в каждом выпуске PostgreSQL, невозможно предоставить достаточно подробную информацию о каждом изменении.
В этом посте вы получите глубокое представление о 10 улучшениях, внесенных в планировщик запросов PostgreSQL 16. Для каждого из улучшений будет сравнения выходных данных планировщика PG15 и PG16, а также примеры того, что изменилось, в виде автономного теста, который вы можете попробовать сами.

Вышел первый коммерческий релиз СУБД реляционного типа — SoQoL версии 3.0.0. В русском варианте название СУБД звучит как СОКОЛ.

Patroni – опенсоурсный инструмент, с которым можно подключить аварийное управление для кластеров Постгресе. Т.е можно автоматически преключать работу на резервный сервер в случае сбоя основного.
Patroni может интегрироваться с различными системами распределенной конфигурации, включая etcd, ZooKeeper, Consul и Kubernetes.
Доброго времени суток. Основываясь на своём опыте хочу представить некоторые рекомендации при разработке кодовой базы на SQL.
Данные рекомендации получены горьким опытом, так что надеюсь, они Вам помогут :)


«Зачем мне SQL и python?» — задают резонный вопрос маркетологи или менеджеры по продукту, особенно в сфере недвижимости, оптовой торговли, услуг для бизнеса: «У нас нет миллионов строк данных, нет логов, мы успешно работаем с несколькими таблицами в excel».
Да действительно, у вас может не быть корпоративного хранилища данных в компании, и основой автоматизации работы с данными является Power query (что сейчас в РФ делать все труднее и труднее). Но у вас точно есть данные, которые вы получаете от смежных отделов, из CRM/CDP, MES, АСУ ТП. Эти данные приходят регулярно в виде файлов, и вы сопоставляете эти данные друг с другом с помощью ВПР, фильтруете воронкой, чистите с помощью «Найти или заменить», делайте сводники с помощью функции Pivot table.