Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

114,27
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как оптимизировать медленные SQL запросы?

Время на прочтение18 мин
Охват и читатели57K

Большинство проблем, связанных с БД, во время разработки остаются незамеченными, потому что мы пишем код и проверяем его правильность только при малой "заполненности" нашей БД. Поэтому, когда приложение выкатывается в продакшн, через некоторое время начинают появляться проблемы с производительностью БД, отдельные части приложения начинают работать всё медленнее и медленнее по мере роста самого БД.

Как выявить и отладить такие проблемы? В этой статье будет показано решение наиболее распространённых проблем с производительностью БД, вызванных неправильной индексацией. Примеры будут приведены для Postgres, MySQL и SQLite.

Читать далее

Вышел Firebird 5.0

Время на прочтение18 мин
Охват и читатели17K

11 января 2024 года, выпущен Firebird 5.0 — восьмой основной выпуск СУБД Firebird, разработка которого началась в мае 2021 года. В Firebird 5.0 команда разработчиков сосредоточила свои усилия на повышении производительности СУБД: параллельное выполнение backup, restore, sweep, создания и перестроение индексов, улучшение масштабирования в многопользовательской среде, ускорение повторной подготовки запросов (кеш компилированных запросов), улучшение оптимизатора, улучшение алгоритма сжатия записей. Кроме того, появились и новые возможности в языке SQL и PSQL.


В версии Firebird 5 также появился встроенный инструмент для профилирования SQL и PSQL, что существенно облегчит поиск узких мест и отладку сложных SQL.


Базы данных, созданные в Firebird 5.0, имеют версию ODS (On-Disk Structure) 13.1. Firebird 5.0 позволяет работать и с базами данных с ODS 13.0 (созданные в Firebird 4.0), но при этом некоторые возможности будут недоступны.


Для того чтобы переход на Firebird 5.0 был проще, в утилиту командной строки gfix был добавлен новый переключатель -upgrade, который позволяет обновлять минорную версию ODS без длительных операций backup и restore.


Также хочется отметить тот факт, что новый релиз Firebird доступен сразу на 11 платформах, включая ARM для Linux и Android. Скачать готовые сборки и дистрибутивы можно по адресу https://firebirdsql.org/en/firebird-5-0/.


Далее я перечислю ключевые улучшения, сделанные в Firebird 5.0, и их краткое описание. Подробное описание всех изменений можно прочитать в Firebird 5.0 Release Notes. Кроме того подробный разбор новых функций Firebird 5.0 вы можете найти в серии статей на ресурсе ibase.ru.


Читать дальше →

Курс «PostgreSQL для начинающих»: #3 — Сложные SELECT

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели81K

Продолжаю публикацию расширенных транскриптов лекционного курса "PostgreSQL для начинающих", подготовленного мной в рамках "Школы backend-разработчика" в "Тензоре".

В этой лекции углубимся в расширенные возможности команды SELECT : как можно "сложить" и "вычесть" выборки (UNION/INTERSECT/EXCEPT), или запомнить и использовать в рекурсивных запросах (CTE), что дают оконные функции (WINDOW) и соединения (JOIN).

Как обычно, для предпочитающих смотреть и слушать, а не читать - доступна видеозапись и слайды.

Читать далее

Агрегатор личных финансов со всех счетов

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели19K

Всем привет!

Примерно год назад мне захотелось проанализировать доходы и расходы со всех своих банковских карт, количество которых начало разрастаться. После ресерча существующих приложений я поняла, что они либо платные, либо нужно ручками вбивать всю информацию. Плюс вопрос сохранения конфиденциальности данных. В этой статье я расскажу про свой мини-проект, как он мне помогает следить за личными финансами и как вы можете покрутить его сами.

Читать далее

Производственный календарь в PostgreSQL

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели16K

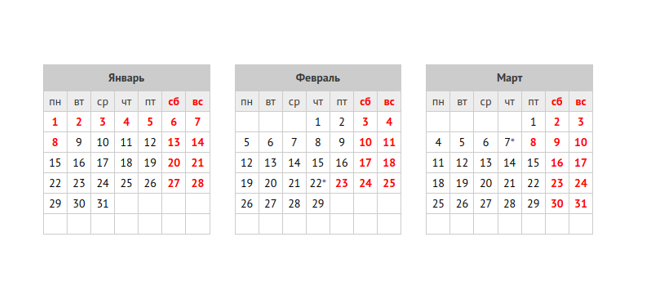
Новый Год уже совсем на носу, а значит нужен свежий производственный календарь в базе данных PostgreSQL. Но как совершенно обленившийся IT-шник, заводить его руками не хочется. Хочется, чтобы вызовом одной функции он сразу появился. Ну а уж из этой функции можно его сохранить в табличку и спокойно использовать до следующего Нового Года. А тогда опять просто вызвать вызвать функцию и с чистой совестью отрапортовать о выполненной работе. Цель статьи - показать возможности COPY ... FROM PROGRAM и простейшие приемы парсинга XML в PostgreSQL.

Читать далее

Правильная работа с базой данных на Python

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели35K

Эта статья рассчитана в большинстве своём на новичков. Тут мы поговорим о том, как не упереться в лимиты подключений к базе, и чтобы приложение в продакшн не упало.

Читать далее

Немного про OR в SQL запросах

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели16K

Несмотря на избитость темы и многочисленные рекомендации избегать OR в выражениях WHERE/ON SQL запросов, жизнь вносит свои коррективы. Иногда сама постановка задачи подразумевает необходимость использовать OR. Я не собираюсь здесь рассматривать простые случаи, а сразу возьму быка за рога и рассмотрю случай, когда OR должно привести к двум разным выборкам по разным индексам одной и той же таблицы.

Читать далее

Миграции в YDB с помощью «goose»

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели11K

Любой более или менее серьезный продакшен, работающий с базой данных, подразумевает процесс миграции - обновление структуры базы данных от одной версии до другой (обычно более новой) [источник].

Миграции в БД можно делать вручную или использовать для этого специальные утилиты (фреймворки). В данной статье речь идет об утилите goose. Это инструмент миграции схемы, который обеспечивает управление миграциями схемы в проекте. Начиная с версии v3.16.0 goose поддерживает YDB - распределенную open-source СУБД. В данной статье мы будем разбирать кейс применения миграций конкретно в YDB.

Читать далее

Использование Postgres-триггеров для исторических таблиц

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели17K

В динамичной среде управления базами данных постоянно присутствует необходимость фиксировать и понимать изменения данных с течением времени. Начните управлять временем с использованием Postgres-триггеров, которые открывают легкий путь к сложному решению — историческим таблицам.

Представьте себе мир, в котором каждое изменение вашей базы данных оставляет след, фиксирующую эволюцию ваших данных. В этом заключаются перспективы исторических таблиц — концепции, которая выходит за рамки традиционных ограничений проектирования баз данных. В этом исследовании мы углубимся во временное измерение PostgreSQL, раскроем возможности Postgres-триггеров и их ключевую роль в создании и обслуживании исторических таблиц.

Читать далее

Введение в SQL & СУБД на примере доступа к данным через Python

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели24K

Краткое введение в SQL (+СУБД) на примере доступа к данным через Python. Я начинающий Data Scientist и решил написать статью где будет базовое введение в sql, а также как извлекать данные через разные способы (SQLalchemy, Requests).

Читать далеее

PostgreSQL в «Тензоре» — публикации за год (#4)

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели3.7K

Под занавес уходящего года предлагаю традиционно вспомнить, про какие интересные возможности и особенности работы с PostgreSQL мы рассказали в нашем блоге.

Если не видели дайджест за прошлый год — время наверстать упущенное!

Читать далее

Как создать сервис по оценке транспортной доступности новостроек при горящих дедлайнах

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели2.8K

Привет, Habr! Меня зовут Руслан Габдрахманов, я руководитель команды разработки информационных систем в «МосТрансПроекте». Сегодня расскажу, как мы создавали городской сервис «Узнай про ЖК», упрощающий выбор квартиры или жилья. 

Читать далее

PostgreSQL: вернуть место после delete

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели15K

У вас есть таблицы, либо ряд таблиц, строки которых нужно очистить и единственный способ, которым вы можете это сделать - это операция DELETE.

Помимо очевидной цели - очистки ненужных данных из таблицы, хотелось бы также увеличить свободное место в области диска, доступного для данных postgresql. Но при определенных условиях - операция DELETE не возвращает место, а операция UPDATE дополнительно его забирает.

Читать далее

Ближайшие события

PostgreSQL 17: Часть 3 или Коммитфест 2023-11

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели4.9K


Ноябрьский коммитфест принес немало интересного! Без лишних предисловий приступаем к обзору.


Самое интересное об июльском и сентябрьском коммитфестах ― в предыдущих статьях серии: 2023-07, 2023-09.

Читать дальше →

SQL HowTo: итоги по строкам и столбцам «в одно действие»

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели20K

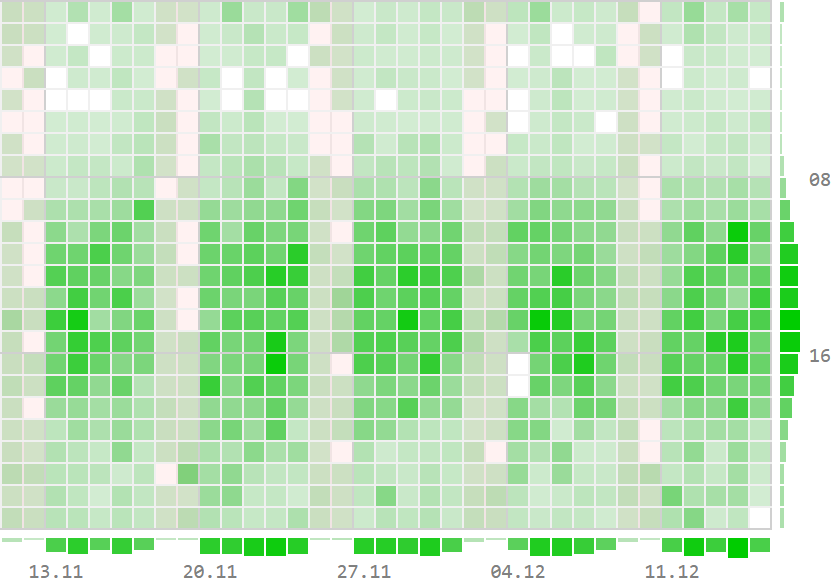
Немного отвлечемся от простых SELECT и посмотрим на реальной бизнес-задаче построения различных "тепловых карт" и "шахматок", как знание возможностей SQL может облегчить жизнь и разработчику, и его базе.

Читать далее

Победа над ORM путем кодогенерации

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели14K

Сразу хочу отметить перед читателем, что это не просто вольные рассуждения на тему, а в том числе и презентация моей библиотеки для Python, которую можно найти на github и установить через pip, и которая трудится в моей многопользовательской игре как SQL движок проекта.

Проблемы ORM известны всем, кто хоть раз ими пользовался. Об этом существует множество статей как у нас, так и в зарубежных источниках. Эти проблемы в общем можно объединить довольно сложным термином Object‑relational impedance mismatch, что позволю себе вольно перевести как «Объектно‑реляционная разница потенциалов».

Альтернативой использованию ORM всегда было использование чистых драйверов баз данных и написание сырых SQL запросов, которые в свою очередь очень тяжело поддерживать и рефакторить в реальных проектах.

В этой статье я не буду хаять ORM (до меня это уже делали на протяжении без малого полуторадесятка лет), но хочу предложить альтернативный путь к решению задачи доступа к базе данных из потенциально любого другого ЯП.

Читать далее

Курс «PostgreSQL для начинающих»: #2 — Простые SELECT

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели61K

Продолжаю публикацию расширенных транскриптов лекционного курса "PostgreSQL для начинающих", подготовленного мной в рамках "Школы backend-разработчика" в "Тензоре".

Сегодня поговорим о самых простых, но важных, возможностях команды SELECT, наиболее часто используемой при работе с базами данных - формировании выборок (VALUES), их ограничении (LIMIT/OFFSET/FETCH), фильтрации (WHERE/HAVING), сортировке (ORDER BY), уникализации (DISTINCT) и группировке (GROUP BY).

Как обычно, для предпочитающих смотреть и слушать, а не читать - доступна видеозапись и слайды.

Читать далее

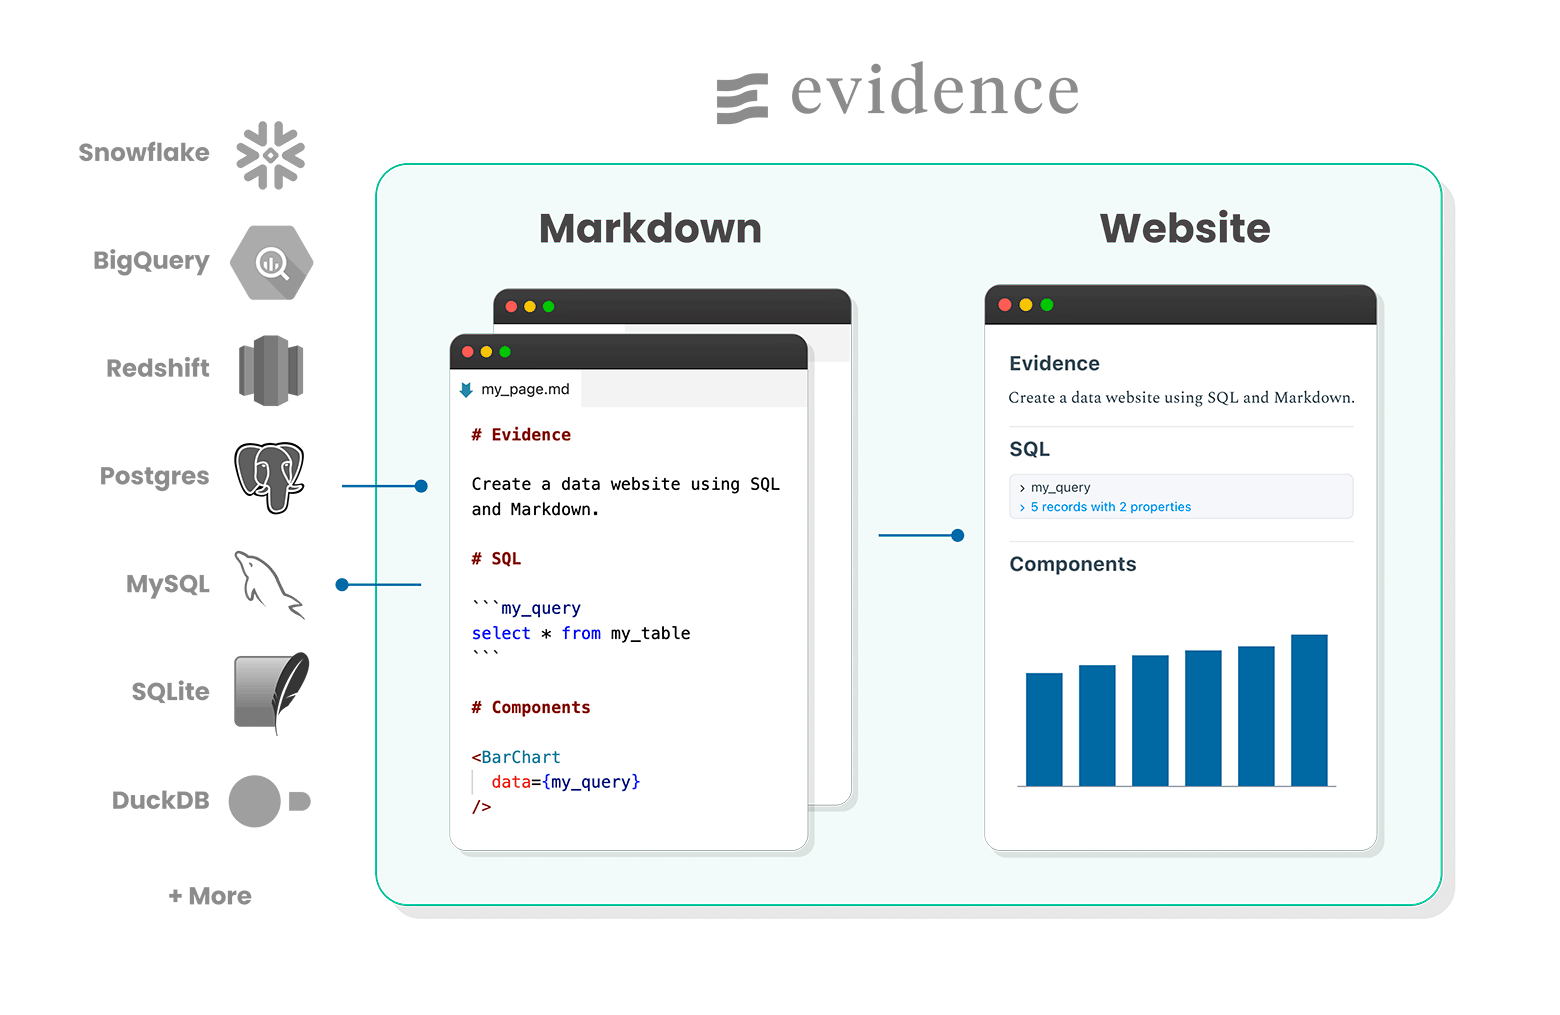
Nota, Typst и Evidence. Языки программирования для генерации документов

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели12K


Все настолько привыкли к Markdown, что считают его неким стандартом для оформления документов в вебе. Но это не конечная истина, высеченная на камне, а просто популярный язык разметки, как HTML и TeX.

В то же время появляется всё больше новых языков, которые позиционируют себя как замену, альтернативу или дополнение к Markdown и TeX. В некоторых случаях они включают функции программирования, то есть позволяют добавить в документ исполняемый код. Веб-редакторы нового поколения можно использовать даже вместо Google Docs.
Читать дальше →

Оптимизация хранения данных в Greenplum

Время на прочтение8 мин
Охват и читатели16K

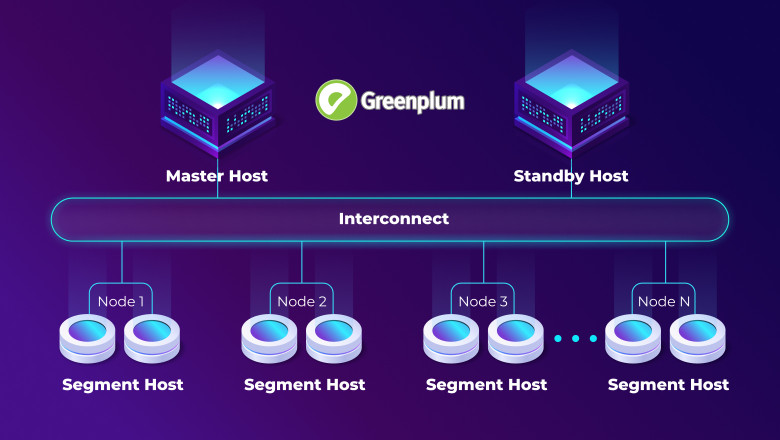
В мире современной аналитики данных, где информация – это ключевой актив организации, база данных должна быть не только масштабируемой, но и высокоэффективной. В этом контексте Greenplum, мощная и распределенная система управления базами данных, стоит в центре внимания. Greenplum предоставляет подходящие возможности для хранения и анализа огромных объемов данных, но, чтобы добиться максимальной производительности и оптимальной управляемости, необходимо грамотно оптимизировать хранение данных.

Данная статья в первую очередь для тех, кто только начинает знакомство с оптимизацией в Greenplum и хочет разобраться на что стоит обратить внимание в первую очередь. Будут рассмотрены три ключевых аспекта: компрессию данных, распределение и партиционирование. Узнаем – как правильно применять эти стратегии, чтобы улучшить производительность запросов, снизить потребление ресурсов и повысить эффективность работы базы данных.

Читать далее

Курс «PostgreSQL для начинающих»: #1 — Основы SQL

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели163K

Этим постом я запускаю публикацию расширенных транскриптов лекционного курса "PostgreSQL для начинающих", подготовленного мной в рамках "Школы backend-разработчика" в "Тензоре".

В программе: рассказ об основах SQL, возможностях простых и сложных SELECT, анализ производительности запросов, разбор [не]эффективного применения индексов и особенностей работы транзакций и блокировок в этой СУБД.

Курс не претендует на лавры "войти в айти", поэтому подразумевает наличие у слушателя опыта программирования или работы с другими СУБД, и, главное, желания самостоятельно изучать тему работы с PostgreSQL глубже.

Для тех, кому комфортнее смотреть и слушать, а не читать - доступна видеозапись и слайды.

Читать далее