Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

109,95
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Проектирование БД и почему важен SQL для системного аналитика: гайд по улучшению качества требований

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели32K

Берём в работу новую задачу или проект. Начинаем со сбора бизнес-требований. Потом архитектура системы и влияние требований на нее, БД, API, интеграции. И вот, в процессе разработки выясняется, что в требованиях опять что-то не учли. Что может быть хуже?

Может, коллеги! Когда через пол года вам же приходится возвращаться к задаче и вы понимаете, что требования к развитию системы по словам разработчиков нереализуемы. Как так?! Элементарная же задача! А потом мне показывают БД. И тут я понимаю, что пришло время делать выбор: дорого переделывать или "костыли" подойдут.

Один раз столкнувшись с такой ситуацией, больше не хочется оставлять без внимания базу данных, даже если её проектированием должны были заниматься разработчики.

Читать далее

Искусство ETL. Пишем собственный движок SQL на Spark [часть 3 из 5]

Уровень сложностиСложный
Время на прочтение20 мин
Охват и читатели2.4K

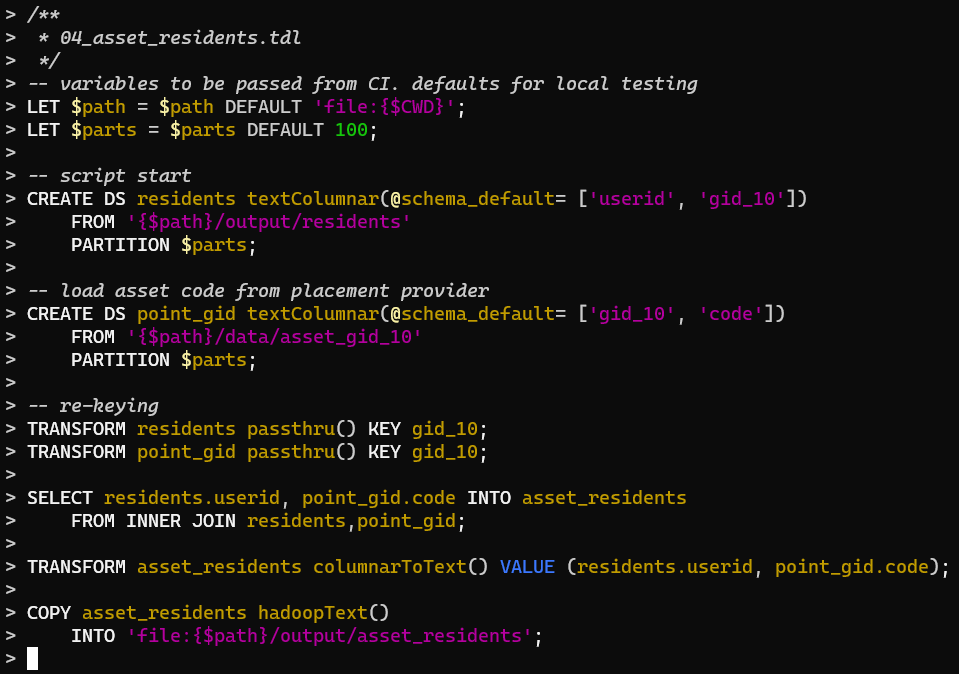
04_assets_residents.tdl


В данной серии статей я подробно рассказываю о том, как написать на Java собственный интерпретатор объектно-ориентированного диалекта SQL с использованием Spark RDD API, заточенный на задачи подготовки и трансформации наборов данных.

Краткое содержание предыдущей серии, последней, посвящённой проектированию спецификации языка:
Операторы жизненного цикла наборов данных (продолжение)
Операторы контроля потока выполнения
Операторы управления контекстом исполнения
Операторы выражений


В данном эпизоде мы наконец-то перейдём к самому интересному — имплементации. Хорошо, когда есть развёрнутая постановка задачи, можно просто брать спеку, и писать код согласно плану.


Предупреждение о рейтинге «M for Mature»

Уровень сложности данной серии статей — высокий. Базовые понятия по ходу текста вообще не объясняются, да и продвинутые далеко не все. Поэтому, если вы не разработчик, уже знакомый с терминологией из области бигдаты и жаргоном из дата инжиниринга, данные статьи будут сложно читаться, и ещё хуже пониматься. Я предупредил.

Читать дальше →

Вы вообще нормальн… нормализованный??

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели6.2K

Сказ о том, нормализация данных завела производительность many-to-many в postgres в тупик, как это зло было повержено, и как тут нам помог Clickhouse.

Порой бывают ситуации, когда стоит посмотреть на задачу будто с нуля и отбросить предыдущий опыт и best practices. Подумать на несколько шагов вперёд. И лучше до того, когда уже вышли из SLA или нахватали негатива от клиентов или бизнеса. Об одной такой задаче и стандартном решении, которое пришлось больно редизайнить, хочется и поделиться с сообществом в этой статье.

Читать далее

SQL HowTo: ближайший общий предок в дереве (LCA)

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели5K

В иерархических структурах регулярно возникает потребность определить ближайшего общего предка в дереве, он же наименьший общий предок (Lowest (Least) Common Ancestor).

Правда, "классические" алгоритмы для решения этой задачи работают лишь с парой узлов (раз, два, три, четыре), а мы, используя всю мощь PostgreSQL, будем решать задачу сразу для нескольких узлов.

Читать далее

7 аргументов почему UUID лучше, чем автоинкрементные идентификаторы

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели39K

В мире баз данных идентификаторы имеют решающее значение для уникальной идентификации записей. Традиционно многие разработчики предпочитали автоматически увеличивающиеся целочисленные идентификаторы. Однако есть еще один вариант, который набирает популярность: универсально уникальные идентификаторы (UUID). В этой статье мы рассмотрим, почему UUID часто являются лучшим выбором по сравнению с автоматически увеличивающимися идентификаторами.

Читать далее

MSSQL: Rebuild vs Reorganize в высоконагруженных системах

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели11K

В двух прошлых статьях я разобрал Index REBUILD в Enterprise и Standard editions. Настало время осветить Index Reorganize - то есть Index Rebuild для бедных. Рекомендую заглянуть в статьи по ссылкам выше - там описан скрипт, который выполняет rebuild или reorg, контролируя течение процесса.

Ведь index reorganize не держит долгих блокировок, почти не нагружает сервер, работая в одном треде, поэтому он безопасен, так? Правда? Ведь правда?

Читать далее

Как я писал сервер на NodeJS для базы Firebird 3.0

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.4K

В этой статье я расскажу, как писал самый простой сервер для общения со старой базой данных Firebird 3.0.

Читать далее

Быстрее быстрого в СУБД

Уровень сложностиСложный
Время на прочтение14 мин
Охват и читатели12K

Привет! Меня зовут Сергей, я технический эксперт в компании Bercut. Когда-то увлекался Delphi и J2ME, издал несколько книг на эти темы, и профессионально уже около 20 лет создаю высоконагруженные приложения баз данных, используя для этого PL/SQL и SQL.

В Bercut мы занимаемся разработкой и развитием IT-продуктов и решений для операторов цифровых услуг и мобильных сервисов. Наши системы работают на различном железе, разных СУБД и обслуживают 24x7x365 в режиме онлайн сотни миллионов абонентов по всему миру. И это только кажется, что абонент один раз в день куда-то позвонил и все, больше никакой нагрузки от него нет и никто с ним не работает. На самом деле каждый смартфон каждого абонента непрерывно обменивается данными с сетью, а это все работа инфраструктуры операторов сотовой связи, а значит, нашего ПО. Как же система справляется с таким огромным объемом нагрузки?

Сегодня расскажу, что нужно делать и чего избегать, чтобы построить максимально производительную систему на примере СУБД Оракл.

Читать далее

Способ залезть в «кишочки» операционной системы, Docker из PostgreSQL с помощью SQL

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели9.1K

Если у вас возникала идея получить доступ к метрикам операционной системы и оборудования компьютера из PostgreSQL, то теперь у вас есть инструмент для этого. Я не претендую на его зрелость и готовность к эксплуатации. Это просто прототип, позволяющий получить результаты запросов из osquery в PostgreSQL в виде табличных данных/JSON. Дальше с которыми можете использовать все привычные средства этой базы данных.

Читать далее

Что происходит в СУБД при записи регистра накопления 1С?

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели14K

Данная публикация – результат попытки разобраться в механизмах записи регистра накопления. Как влияют вид и настройки регистра, режим записи? Что происходит, когда используются агрегаты?

В статье рассмотрены запросы, выполняемые на стороне СУБД при записи регистров накопления остатков и оборотов с разделением итогов и без.

Все примеры выполнены на платформе 1С 8.3.23 в связке с MSSQL.

Читать далее

Как работает миграция между базами данных в реальном мире

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели37K

Недавно по основной работе у меня появилась задача по изучению процесса миграции данных между базами. Решил поделиться с сообществом своими исследованиями в сфере миграции, полученными в рамках этой задачи.

В статье я рассмотрю: с чего начать миграцию, зачем нужна миграция, подход PoC и парадигмы баз данных, тестирование и стратегии миграции.

Подробнее о миграции

SQL Задача про бинарное дерево

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели11K

Как-то, на просторах бескрайнего, наткнулся на любопытную задачу, которая, к тому же,
довольно просто решается.

Дальнейший текст, будет полезен для начинающих практиков, у кого есть, хоть какая-то база в написании SQL запросов. Для ушлых сеньоров, все что будет сказано ниже, может показаться слишком просто, и так понятно, примитивно и тривиально.

Пару слов о необходимом арсенале.

Для решения задачи, понадобится следующее:

Читать далее

JSONB и hstore: использование специальных типов данных PostgreSQL для работы с полуструктурированными данными

Время на прочтение11 мин
Охват и читатели34K

В современной разработке программного обеспечения, где данные играют ключевую роль, понятие "полуструктурированные данные" заняло особое место. Эти данные сочетают в себе гибкость документов и строгость таблиц, что позволяет эффективно моделировать сложные информационные потоки. Однако работа с такими данными требует специальных подходов и инструментов.

Полуструктурированные данные — это неотъемлемая часть современных приложений, работающих с разнообразной информацией. Они позволяют представить данные в формате, близком к человеческому восприятию, в то время как классические реляционные базы данных предоставляют ограниченные возможности для хранения и извлечения такого типа информации. Примерами могут быть структуры JSON, XML и другие форматы, которые могут содержать вложенные поля, дополнительные атрибуты и даже массивы данных.

Читать далее

Ближайшие события

Таблица-справочник – генератор DAG? А что так можно было?

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели8.4K

Таблица справочник, которая является медленно изменяющейся и также генерирует DAG.

В статье рассказывается как можно хранить бизнес-метрики и собирать их через DAG.

Читать далее

Какой парсер для автоматизации ревью кода лучше — DacFx или ANTLR

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели2.4K

Привет, меня зовут Артём Коршунов, я программист в ЮMoney. В нашей команде много разработчиков, и все они пишут огромное количество кода. Его нужно проверять, но встроенных валидаций для проверки не всегда хватает, из-за чего могут возникать проблемы. Рассказываю, с какими сталкивались мы, пока не попробовали DacFx с объектной моделью и не автоматизировали валидацию.

Читать далее

Как полностью устранить дублирующие записи в ClickHouse

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели12K
image

Всем привет!

Меня зовут Валерий Локтаев, я backend-разработчик сервиса биллинга в CloudMTS.

В этой статье я расскажу, как насовсем убрать дублирующие записи в ClickHouse (CH). Логичный вопрос — откуда вообще взялась проблема? Можно взять движок таблицы ReplacingMergeTree, указать ORDER BY в качестве ключа дедупликации, и CH чудесным образом удалит все дубли в базе.

ReplacingMergeTree, безусловно, отличное решение. Но представьте, что ваша задача — сделать так, чтобы в таблице дубли никогда не появлялись, даже на несколько секунд.

Далее я расскажу, в каких случаях это необходимо и какое решение удалось подобрать.

Читать дальше →

Анализ сентимента и эмоционального окраса текстов с помощью SQL

Время на прочтение10 мин
Охват и читатели5.2K

Cтремительное развитие социальных медиа, онлайн-платформ, а также огромное количество текстов, создаваемых и обменивающихся пользователями каждый день, делают необходимым понимание того, какие эмоции и оттенки содержатся в текстовых данных. В этом контексте анализ сентимента — определение эмоциональной тональности текста (положительной, отрицательной или нейтральной) — становится ключевым инструментом для бизнеса, маркетинга, общественной деятельности и даже политики.
Анализ сентимента позволит нам, к примеру выявить, какие аспекты вашего продукта вызывают положительные отзывы, а какие — негативные. Такая информация поможет вам улучшить продукт, повысить удовлетворенность клиентов и, как следствие, увеличить прибыль.

Читать далее

Почему тип поля enum на уровне базы — зло

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели51K

Часто разработчики интересуются почему не рекомендуется использовать тип поля enum в базе данных, и в этой статье мы рассмотрим все плюсы и минусы данного типа.

Тип колонки enum используется для хранения данных, которые могут принимать определённые значения из заранее определённого набора. Он обеспечивает ограничение значений, которые может принимать колонка, и позволяет более строго контролировать данные. Это может быть полезно для хранения статусов, категорий, типов или любых других значений, которые могут быть заданы только из ограниченного набора вариантов.

Но это в теории. А что на практике? Рассмотрим под катом.

Читать далее

Использование конечных автоматов с несколькими активными состояниями для автоматизации бизнес-процессов

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели3.9K

Производственная деятельность предприятия связана с работой ответственных должностных лиц над одним или несколькими документами, включая электронные. Порядок прохождения документов определён нормативными актами. Каждое должностное лицо заполняет ту или иную часть документа, согласовывает, утверждает документ, возвращает его на доработку, участвует в выполнении работ по документу.

Бизнес процессы, описывающие производственную деятельность принято представлять в формате BPMN, а системы, автоматизирующие бизнес-процессы, часто создают с использованием ИТ-платформ типа Camunda. Camunda выступает в роли BPMN-движка.

Camunda довольно специфический продукт, требующий привлечения специалистов соответствующей квалификации. Можно предложить подход к автоматизации бизнес-процессов, не требующий специальной подготовки аналитиков и разработчиков.

Читать далее

Просто о Deep #1

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели5.7K

Боль в написании backend

Разберем, какие есть боли у backend разработчика и как deep.foundation решает данную проблему и что предлагает для разработчика.

In deep