Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

114,27
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как расширить компетенции аналитиков при работе с Big Data

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели6.6K

В данной статье мы решили рассмотреть вопрос повышения эффективности работы единого хранилища данных компании. Хотим поделиться опытом: как повышение экспертизы аналитиков ЕХД влияет на процесс взаимодействия с хранилищем, и как применять современные тренды в данном процессе. Статья будет полезна командам, которые используют возможности ЕХД больших компаний и занимаются их проектированием. 

Читать далее

Иерархическая база данных

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели19K

Эта статья посвящена реально работающей информационной системе (ИС), основанной на иерархической модели данных. Скажу точнее - это не просто ИС - это инструмент разработки ИС любого уровня сложности, включая ERP, CRM, PPM и т.д., обладающий полным набором средств разработки (инструментом описания структуры данных, встроенным процедурным языком и языком запросов, инструментом разработки экранных форм, инструментом написания программного кода и т.д).

В статье я расскажу не только как это выглядит, но и как это все устроено. Статья будет большая, и поэтому мне придется разбить ее на несколько частей.

Читать далее

PostgreSQL Antipatterns: ходим по JSON-граблям

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели20K

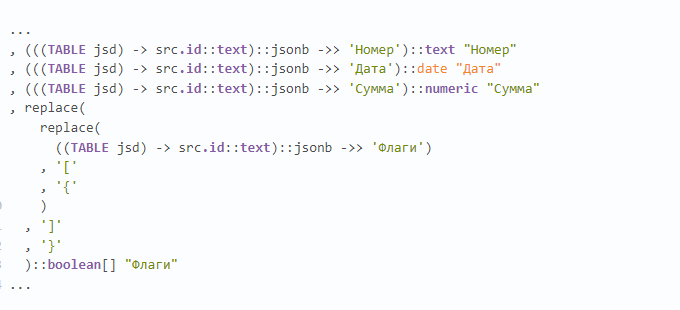
Недавно попался на глаза примерно такой кусок запроса, и тут прекрасно примерно все:

множество чтений из CTE (хоть и единственной записи, но все же);

извлечение по каждому ключу текста с раскастовкой в jsonb;

извлечение каждого отдельного json-ключа в каждое отдельное одноименное поле;

"ручное" преобразование текстового представления массива в json в текстовое представление PostgreSQL.

А как - правильно?

Читать далее

SQLx: raw SQL в Rust

Время на прочтение9 мин
Охват и читатели16K

Когда речь заходит об использовании SQL, экосистеме Rust есть что нам предложить: к счастью, нам доступны несколько отличных готовых к использованию решений. SQLx — это чисто асинхронный, независящий от рантайма SQL-крейт, позволяющий использовать проверяемые во время компиляции запросы без какого-либо DSL.

Читать далее

Пишем свой QTableView с нуля

Уровень сложностиСложный
Время на прочтение6 мин
Охват и читатели15K

Итак жил был фреймворк Qt и последние 10 лет ничего в нем не менялось. И захотел один чел написать свой QTableView с нужным ему функционалом, а именно захотелось ему выводить ячейки в несколько рядов (по горизонтали) в одной строке. Ещё ему хотелось растягивать одну из ячеек по ширине двух других.

Искал, искал чел готовый пример в интернете и не находил. И вот однажды подумал он посмотреть как сделан внутри сам QTableView и стало плохо ему от количества строк кода, не одна тысяча там.

Читать далее

PostgreSQL 17: Часть 2 или Коммитфест 2023-09

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.6K


Продолжаем следить за новинками 17-й версии PostgreSQL. На этот раз поговорим о том, чем запомнился сентябрьский коммитфест.


Самое интересное об июльском коммитфесте ― в предыдущей статье серии: 2023-07.

Читать дальше →

LLM'ы в преобразовании запроса на естественном языке в SQL (text2sql)

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели14K

Привет, Хабр! На связи участница профессионального сообщества NTA Марина Коробова.

Данные занимают центральное место в информационном обществе. Именно информация является основой для принятия решений, развития бизнеса и научных исследований. Многие организации инвестируют огромные средства в системы, способные хранить, обрабатывать и анализировать данные.

Одной из главных проблем, с которыми сталкиваются компании, это непосредственная работа с базами данных с помощью языка SQL (Structured Query Language). Не все знают этот язык, и не у всех есть время изучать его. Поэтому на рынке появляются инструменты, позволяющие писать запрос на естественном языке и получать ответ на языке запросов.

В посте познакомлю вас с двумя AI-инструментами для генерации SQL-запросов: SQLCoder Defog и SQLthroughAI.

Читать далее

Построение OLAP-запросов с использованием аналитических функций

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели13K

Привет, уважаемые читатели Хабра! Сегодня мы вас познакомим с OLAP и аналитическими функциями.

OLAP, или Online Analytical Processing, представляет собой технологию для анализа и извлечения данных из больших наборов информации. Это позволяет производить сложные агрегации, расчеты, фильтрации и срезы данных, что особенно полезно при работе с огромными объемами информации. В отличие от OLTP (Online Transaction Processing), который ориентирован на операции с данными, OLAP нацелен на поддержку бизнес-аналитики, многомерного анализа и принятия решений.

Читать далее

Отправка и обработка HTTP запросов в PostgreSQL

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели32K

Эта статья о том как отправлять и обрабатывать HTTP-запросы непосредственно из/в PostgreSQL. Автор расскажет о том, что такое асинхронное уведомление в PostgreSQL, и наглядно продемонстрирует, как с его помощью можно взаимодействовать с внешними системами из самой СУБД.

Читать далее

Airflow vs NiFi: исследуем оркестратор для формирования витрин данных

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели17K

Сегодня концепция витрин данных является стандартом и используется повсеместно. Поэтому даже небольшим компаниям важно определиться с помощью каких инструментов они будут решать проблему оркестрации процессов построения витрин. Какой инструмент в условиях относительно небольшого бюджета позволит достигать поставленных целей? Этот вопрос мы и постараемся раскрыть в статье. Для этого рассмотрим два известных инструмента: Airflow и NiFi, а также постараемся выявить их сильные и слабые стороны.

Читать далее

Повышение эффективности SQL-запросов: советы и рекомендации

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели32K

В статье представлен ряд советов и методов, которые помогут читателям оценить производительность своих SQL-запросов и улучшить ее при необходимости. Здесь будут рассмотрены некоторые ключевые аспекты оптимизации запросов для SQL Server, чтобы помочь пользователям сделать их более эффективными и быстрыми.

Читать далее

Регулярные выражения в реальных задачах

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели32K

Привет, Хабр! Меня зовут Татьяна, я разработчик в Росбанке, и в этом посте я расскажу про регулярные выражения. По своему опыту могу сказать, что регулярки — это очень полезный инструмент. Я часто пользуюсь ими, решая задачи по обработке текста в базах данных. Вначале я остановлюсь на теории, а затем рассмотрю несколько реальных задач, которые были решены с использованием регулярных выражений.

Читать далее

О Prepared statements, серверном кэше скомпилированных запросов или как эффективно кэшировать запросы в YDB

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели4.6K

Существуют различные способы снижения стоимости выполнения SQL-запросов в современных СУБД. Наиболее распространенными подходами являются использование подготовленных запросы и кэширование. Оба метода доступны в YDB.

Кэширование запросов позволяет скомпилировать запрос один раз (проанализировать его, построить оптимальный план запроса, в т.ч. JIT-скомпилировать в машинный код), а затем повторно выполнить его с разными значениями параметров. Это позволяет сократить общее время выполнения запроса на величину времени компиляции запроса. Кроме того, кэширование запросов значительно сокращает объем вычислительных ресурсов, необходимых для выполнения повторяющихся пользовательских запросов, поскольку они компилируются только при первом запросе (и инвалидации кеша). Ниже мы объясняем, почему в самых общих случаях необходима Prepare, какие трудности возникают с этим в случае распределенной СУБД и как кэшировать запросы без Prepare.

Читать далее

Ближайшие события

Многоуровневая группировка в SQL: Grouping sets

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели25K

Описан основной принцип работы конструкции Grouping sets в SQL на примере. Статья будет полезна для тех, кто хочет быстро разобраться с основными принципами группировки с использованием Grouping sets.

Читать далее

Небольшой тест нескольких БД при работе с многими таблицами

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели7K

Я новичок в работе с базами данных и для их изучения (а заодно для изучения Питона) начал небольшой пет-проект. В процессе оказалось, что в моей многопользовательской системе запросы к БД всегда касаются только одного пользователя. «Отлично!» подумал я, «раздам каждому пользователю по табличке и сэкономлю ресурсы сервера на индексации!». Конечно сначала я почитал литературу и подобных решений в ней не нашел. Потом сходил на один из популярных ресурсов и там мне объяснили, что так делать нельзя. Но почему – никто объяснить не смог (или возможно не захотел). Поэтому я решил сделать небольшой тест на самых популярных БД – проверить что будет на самом деле.

Читать далее

Погружаемся в базы данных и SQL: полезные материалы и инструменты от сотрудников Selectel

Время на прочтение4 мин
Охват и читатели14K

Почему программисты SQL так плохо шутят? Потому что их юмор — это всегда "SELECT * FROM jokes WHERE is_funny = 1".

Новичку нужно перебрать много сайтов, чтобы научиться работать с базами данных и понимать такие шутки. Это усложняется тем, что в открытом доступе мало действительно полезных материалов, которые могут закрыть все пробелы в знаниях.

Мы попросили наших коллег порекомендовать полезные ресурсы, которые помогут сделать первые шаги в работе с базами данных и SQL. Сохраняйте подборку в закладки, чтобы сэкономить время на изучение темы, и делитесь своими вариантами в комментариях.
Читать дальше →

Oracle/ClickHouse. DWH. Партицирование как средство быстрого обновления данных

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели13K

В этой статье хотелось бы рассмотреть такой вопрос - как частичное обновление больших объемов данных в таблицах, которые активно используются пользователями на чтение. Задача является типовой, и с ней сталкивается каждый инженер данных. При этом не важно на какой ступеньке своей карьерной лестницы вы находитесь, Junior или Senior, такие задачи будут.

Читать далее

Искусство ETL. FAQ по Data Cooker ETL

Время на прочтение5 мин
Охват и читатели4.5K

Как и было обещано, в завершение серии ( 1 2 3 4 5 ) статей о разработке инструмента для ETL больших данных, я выкладываю выжимку ответов на вопросы.


А то статьи были в формате туториала для разработчиков таких инструментов (длинные и с высоким уровнем сложности), так что стоит рассказать более кратко и понятно для каждого.


Q. Что это такое?


A. Специализированный инструмент для а) быстрого создания ETL процессов и б) эффективного по стоимости их выполнения.


Промка: https://dcetl.ru
Исходники: https://github.com/PastorGL/datacooker-etl
Официальная группа в телеге: https://t.me/data_cooker_etl

Читать дальше →

Clickhouse — непростая жизнь в продакшене

Уровень сложностиСложный
Время на прочтение13 мин
Охват и читатели24K

Около двух лет назад вышла небольшая статья Kafka Streams — непростая жизнь в production, в которой я описывал сложности, с которыми наша команда столкнулась при попытке решить задачи проекта с помощью kafka-streams. Эксперимент вышел неудачным, и мы в итоге совсем отказались от этой технологии. Вместо нее решили попробовать Clickhouse (CH), и сейчас уже можно сказать, что эта база нам очень хорошо подошла и отлично решает почти все задачи, которые нам ставит бизнес. В этой статье я расскажу об особенностях использования CH.

Читать далее

Искусство ETL. Пишем собственный движок SQL на Spark [часть 5 из 5]

Уровень сложностиСложный
Время на прочтение14 мин
Охват и читатели2.2K

REPL


В данной серии статей я подробно рассказываю о том, как написать на Java собственный интерпретатор объектно-ориентированного диалекта SQL с использованием Spark RDD API, заточенный на задачи подготовки и трансформации наборов данных.

Краткое содержание предыдущей серии, посвящённой API расширения и разного рода технической обвязке:


Расширяемость. API подключаемых функций
Режимы запуска. Пакетный режим, сборка для разных окружений, автотесты


Теперь можно поговорить о последних штрихах, делающих инструмент — инструментом, а именно, об интерактивно-отладочном режиме, то есть, REPL, клиенте и сервере, а также о генераторе документации.


Предупреждение о рейтинге «M for Mature»

Уровень сложности данной серии статей — высокий. Базовые понятия по ходу текста вообще не объясняются, да и продвинутые далеко не все. Поэтому, если вы не разработчик, уже знакомый с терминологией из области бигдаты и жаргоном из дата инжиниринга, данные статьи будут сложно читаться, и ещё хуже пониматься. Я предупредил.

Читать дальше →