
Просто о Deep #1
Простой
4 мин
Обзор
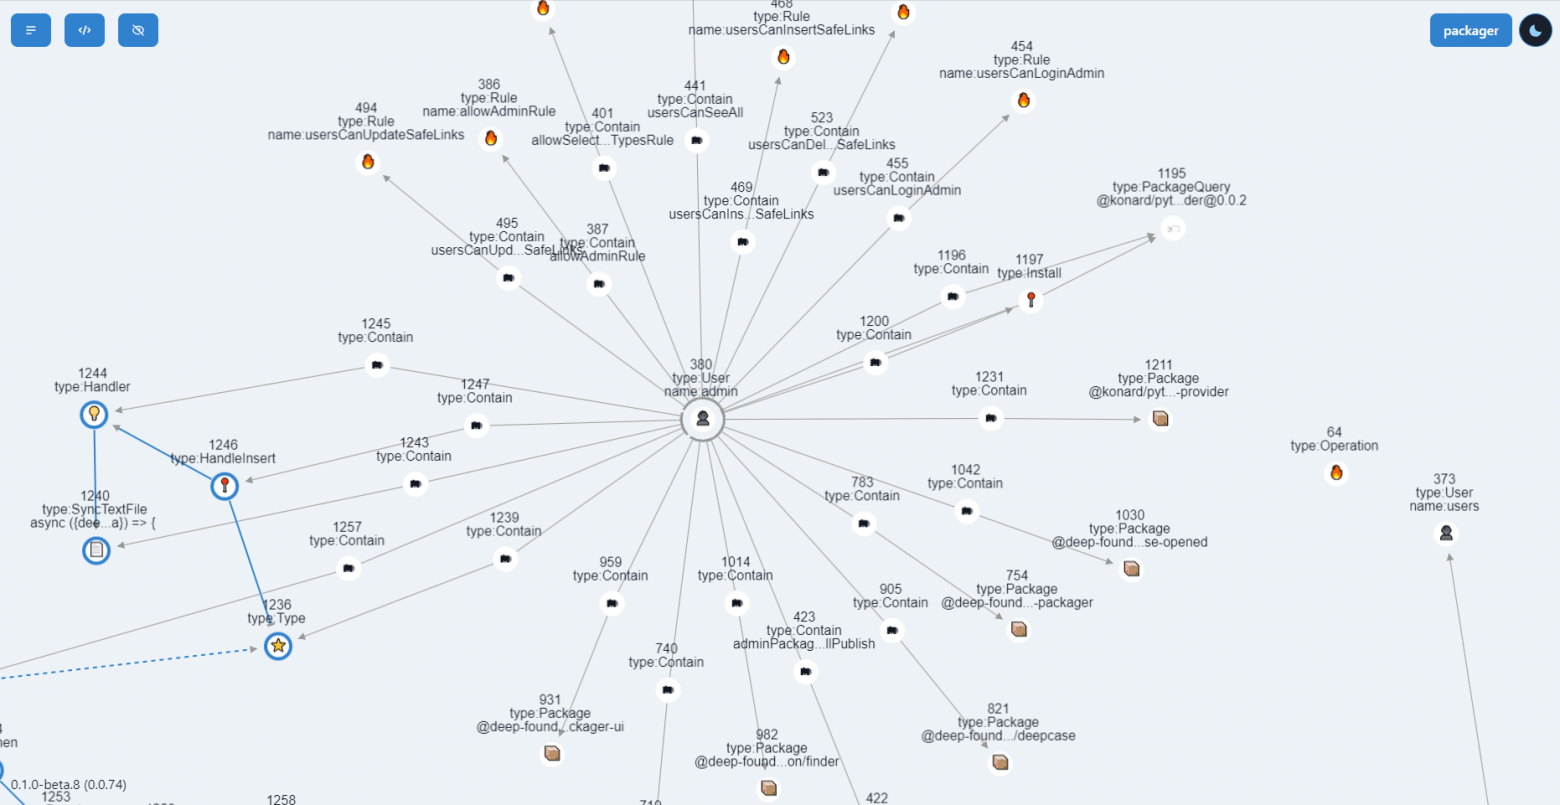
Боль в написании backend
Разберем, какие есть боли у backend разработчика и как deep.foundation решает данную проблему и что предлагает для разработчика.

Формальный непроцедурный язык программирования
Боль в написании backend
Разберем, какие есть боли у backend разработчика и как deep.foundation решает данную проблему и что предлагает для разработчика.

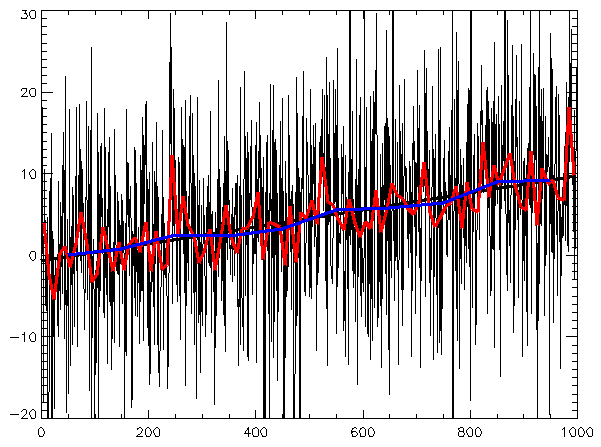
Не буду вдаваться в подробности о том, откуда берутся миллионы временных серий и почему они умудряются изменяться еженедельно. Просто возникла задача еженедельно сделать прогноз на 2-8 недель по паре миллионов временных серий. Причем не просто прогноз, а с кроссвалидацией и выбором наиболее оптимальной модели (ARIMA, нейронная сеть, и т.п.).
Имеется свыше терабайта исходных данных и достаточно сложные алгоритмы трансформации и чистки данных. Чтобы не гонять большие массивы данных по сети решено было реализовать прототип на одном сервере.

Продолжаем следить за новостями из мира PostgreSQL. Выпуск PostgreSQL 16 Release Candidate 1 планируется на 31 августа и, если всё будет в порядке, то 16-я версия выйдет 14 сентября.
Что изменилось в 16-й версии после апрельской заморозки кода? Что попало в 17 версию по результатам первого коммитфеста? Обо всем об этом в свежем обзоре.

Привет! Меня зовут Наташа Красильникова, я старший аналитик команды Operations Analytics в Skyeng. Мы завязаны на работе с сотней сервисов компании: забираем данные из сервисов и интегрируем много локальных документов с бизнесовыми маппингами, таргетами, а иногда и просто какими-то дополнительными данными.
Когда пришло время мигрировать наше многолетнее легаси на новый DWH… что ж, мы пережили целый спектр острых эмоций. И, конечно, выработали ноу-хау, чтобы сгладить переход и сделать его менее болезненным. В статье расскажу, что придумали и как применяли.
Если вы не первый год в аналитике, то знаете, каково это — прокладывать дорогу сквозь неопределённость. Рассматривать гипотезы и принимать ту, по которой работать, — это как выбирать дорогу, по которой идти всей команде. Волнительно и непросто отправляться на неосвоенные земли.
Вот вы — хороший штурман? Готовы встретиться с вызовами? Перетряхнём же рюкзак, посмотрим, чем он набит, и есть ли там самое важное, без чего не выжить в пути.


Как следует из названия, данная статья для тех, у кого есть сложности с пониманием SQL запросов, в составе которых, используется EXISTS, т.к., исходя из опыта, его использование частенько вызывает вопросы у начинающих, а иногда даже у продолжающих.
Стандартное описание работы оператора EXISTS, для SQL, выглядит примерно так: “Оператор EXISTS возвращает true, если подзапрос возвращает одну, или более записей, в противном случае, возвращает false”.
И еще: “Поскольку возвращения набора строк не происходит, то подзапросы с подобным оператором выполняются довольно быстро.”
Непонимание, обычно, как раз кроется, где-то здесь: Если EXISTS возвращает true/false, но не возвращает набор записей, то каким образом, основной запрос, в ходе выполнения, отбирает записи, соответствующие условиям описанным во вложенном запросе.

Привет!
Проектирование базы данных - это один из важнейших этапов создания информационной системы. Оно включает в себя определение сущностей, их атрибутов и связей между ними, а также выбор наиболее подходящих типов данных и ограничений целостности.
В данной статье мы рассмотрим процесс проектирования базы данных с нуля (в качестве примера возьмем только один слой БД - витринный, он же Data Mart) с использованием ПО SAP PowerDesigner. В качестве СУБД мы будем использовать Oracle 19c, но вы можете выбрать любую другую, по вашим потребностям (как - об этом чуть ниже).
Рассмотренный в статье инструмент будет интересен системным аналитикам, архитекторам, разработчикам БД и даже бизнес-аналитикам, поскольку помимо создания физических и логических моделей в нем можно рисовать ER-диаграммы, BPMN-модели и многое другое.

Эта статья имеет широкий спектр применения и будет актуальна для тех, кто хочет больше узнать о том, как управляются и обрабатываются данные в современном информационном мире, и особенно для людей, которые интересуются программированием и планируют строить карьеру в IT.
Статья предоставит читателю обзор основ баз данных и систем управления базами данных, а также поможет начать начать работу с языком структурированных запросов SQL.


Чем вызваны тормоза в PDM, PDM, ERP?
Вообще тормоза в большинстве современных систем мало связаны с тем, что программа может быть еще в разработке или что там может быть что-то не совсем оптимально сделано, хотя и не без этого.
Тут сам по себе важен принцип баз, на которых построены эти программы.
Большинство современных систем построено на MSSQL и его аналогах; впрочем некоторые из них в какой-то мере могут работать лучше, а в чем-то могут быть и хуже, да и развитие самой MSSQL не стоит на месте: что-то улучшается, что-то «оптимизируется». Некоторые пользователи уже давно считают, что имеет место заговор IT-гигантов с производителями электроники, и некоторые «оптимизации» сделаны специально для замедления работы. Впрочем, такие заговоры уже не раз вскрывались, и никто с этим так ничего и не сделал, а все подобные дела просто спускались на тормозах.
Рассмотрим принцип работы баз на основе PDM.

Что нужно автоматизировать в управляемой базе данных? Какие нас ждут проблемы эксплуатации MySQL в облаках? Разберём существующие решения, позволяющие обеспечивать эффективную конфигурацию под высокую доступность и высокие нагрузки, а также их недостатки и практическое применение.
Поможет нам в этом Дмитрий Смаль, руководитель подразделения Managed MySQL и SQL Server в Yandex Cloud. Каждый день он занимается эксплуатацией и автоматизацией СУБД, а до этого делал нагруженные и не очень web-приложения. В целом любит делать разные интересные штуковины, которые работают! Сегодня мы с ним будем говорить про решение для высокодоступного MySQL.
Всем привет. Меня зовут Михаил Потапов, я - главный системный аналитик компании "Ростелеком Информационные Технологии". В компании занимаюсь разработкой отчетности для сегмента B2B и проектированием хранилища данных, на базе которого эта отчетность функционирует. Работоспособность каждого отчета напрямую зависит от корректно выстроенных SQL-запросов к базе данных Oracle, поскольку при работе с большими объемами данных скорость выполнения запросов может существенно снижаться. Снижение скорости сильно затрудняет работу с отчетами для конечного пользователя, а в некоторых случаях и вовсе делает ее невозможной.
В этой статье мы рассмотрим основные принципы оптимизации запросов в Oracle SQL, которые помогут ускорить работу с базой данных и повысить эффективность работы. Сразу отмечу, что статья рассчитана на junior и middle-специалистов, которые пишут сложные запросы к базе данных, работают с большими объемами данных и при этом ранее с вопросом оптимизации не сталкивались. Статья не содержит подробное руководство к действию, но описывает базовые основы "культуры кода", соблюдение которых позволит снизить нагрузку на БД и даст возможность более эффективно извлекать из нее данные.

Практически от любого специалиста IT-сферы сегодня требуется хотя бы базовое знание SQL. Рынок онлайн-образования реагирует соответствующе: на любом сайте по теме можно найти что-то связанное с SQL и/или базами данных. В теории такие курсы действительно позволяют узнать основы языка, а иногда даже и немного больше, но на практике они не готовят специалиста ко взаимодействию с реальной базой данных. Многие стажеры и младшие (а иногда и грейдом повыше) специалисты допускают одни и те же ошибки.
В этот статье я бы хотела отметить важные моменты из работы с базами данных с помощью SQL, которые не изучают на курсах, но которые могут быть актуальны с самого начала карьеры для эффективной работы. Примеры в статье будут приведены для базы PostgreSQL.

Переносимость процессоров и паттерны
Вот и обещанная третья часть саги о том, что в NiFi можно делать и как это делать правильно, без претензий на истину в последней инстанции, конечно. Сегодня расскажу о переносимости процессоров и дам несколько паттернов для самых популярных задач на платформе ZIIoT. Если вдруг вам интересно почитать про оптимизацию схем и производительности в NiFi — велком в первую часть. Если мечтаете узнать больше о мониторинге, то вторая часть — must read. Только потом сюда не забудьте вернуться.

Всем привет! На связи разработчики БД - Юрий Плотников и Андрей Григорьев, в этот раз рассказывать мы будем вдвоем, вернее не совсем вдвоем - об одном "фирменном" решении расскажут коллеги из нашего центра компетенций PostgreSQL.
Пара слов о заглавной картинке и логотипе
Несмотря на то, что история pgmig началась раньше, большое развитие он получил при разработке наших "сказочных" продуктов (youtube).
Поэтому мы решили, что ему также место среди сказочных персонажей - домовенок, приводящий процессы в порядок
Начнем издалека, с очевидных вещей, однако без этого было бы сложнее понять главную идею. Итак, к делу:
Интервью, или как у нас их чаще называют, "собесы", проходят особой сюжетной линией вдоль карьерной лестницы айтишников.
Естественный путь профессионального становления, это когда ты сначала являешься кандидатом, и только проходишь интервью, ну или пытаешься, а потом, еще и проводишь интервью для других соискателей.
Те, кто побывал в обеих ролях, в каком-то смысле, имели возможность взглянуть на себя со стороны, но думаю многие обращали внимание на следующий момент. Нередко бывает так, что кандидатам, особенно джунам, теоретическая, ну или дискуссионная часть интервью, дается легче, чем решение практических задачек. Более того, некоторых кандидатов, буквально вводит в ступор, когда их просят выполнить
что-то практическое.


Среди применяемых в PostgreSQL методов доступа к данным Index Only Scan стоит особняком, считаясь у многих разработчиков "волшебной пилюлей" для ускорения работы запроса - мол, "Index Scan - плохо, Index Only Scan - хорошо, как только получим его в плане - все станет замечательно".
Как минимум, это утверждение неверно. Как максимум, при определенных условиях может вызвать проблемы чуть ли не на ровном месте.

Развернув очередной обратно разработчику Pull Request с поиском по аналитике, принимающей разные значения в разные промежутки времени, я решил на планерке обсудить этот вопрос. И был удивлен, что подавляющее большинство разработчиков не понимают, как эффективно искать на SQL в таких случаях. Погуглив, ради интереса, обнаружил, что этот вопрос как-то обходится стороной сообществом. В итоге решил написать статью, заодно ссылаясь на нее самому.
Сразу хочу уточнить, что речь идет именно об MS SQL, так как, например, в PostgreSQL уже есть диапазонные типы и виды индексов, позволяющие их индексировать.


Всем привет от команды ЮMoney ?
Делимся видеозаписями и главными мыслями митапа High SQL, который посвятили работе с данными в DWH на Microsoft SQL Server.
Кому советуем посмотреть доклады
◾️ Тем, кто планирует перебраться с Microsoft SQL в PostgreSQL, но всё ещё сомневается.
◾️ Тем, кто выбирает между ANTLR и DacFx и хочет научиться решать проблемы во время ревью TSQL-кода.
◾️ И тем, кто хочет узнать, зачем тестировать OLAP-кубы, что может пойти не так и какой результат дают автотесты силами разработчиков и тестировщиков.

В одной из моих предыдущих статей я рассказал о скрипте с названием GentleRebuild, который делал index rebuild в базах, работающих под нагрузкой 24/7, когда нет maintenance window, в Enterprise Edition. Там можно использовать опции ONLINE=ON и даже RESUMABLE=ON, вежливо уступая основной нагрузке базы.
А как же Standard Edition, где этого нет? Каюсь, раньше у меня в скрипте даже стояла проверка, и для Standard Edition скрипт сразу завершался. Но шеф меня попросил заняться и серверами со Standard Edition, и мне пришлось выжать из ситуации максимум.


Пример использования триггеров, при взаимном обновлении таблиц. При таких задачах возникает ошибка мутирования таблиц ORA-04091: table is mutating.