
Рекомендации по ведению SQL-кода
Простой
8 мин
Туториал
В этом материале разберем общие рекомендации по ведению SQL-кода на примере СУБД MS SQL (T-SQL). Однако, многие пункты можно также применить и к другим СУБД.

Формальный непроцедурный язык программирования

При работе с данными часто приходится сталкиваться с ситуацией, когда имеется некоторая функциональная зависимость yi = f(xi), которая получена в результате эксперимента или сбора статистики. То есть исходные данные представлены набором точек (x1, y1), (x2, y2) … (xn, yn), где n – количество экспериментальных значений. Если аналитическое выражение функции f(x) неизвестно или весьма сложно, то возникает чисто практическая задача: найти такую функцию Y = F(x), значения которой при x=xi будут близки к экспериментальным данным. Приближение функции f(xi) к более простой F(x) называется аппроксимацией. Аппроксимация позволяет исследовать числовые характеристики и качественные свойства объекта, сводя задачу к изучению более простых или более удобных объектов. Как правило, выбор модели аппроксимации определяется по минимальному значению погрешности на всем интервале исходных данных. Для расчетов необходимо использовать несколько видов аппроксимаций, чтобы определить более точное описание зависимости экспериментальных данных y = f(xi).

Привет, Хабр! На связи команда разработки «МосТрансПроекта».
Наш институт является интеллектуальным центром транспортного планирования Москвы, и для решения задач нам постоянно нужны данные. Для запуска компенсационных автобусов во время ремонта станции метро необходимо знать ее пропускную способность, пиковую нагрузку, конфигурацию переходов и парность поездов. А при проектировании благоустройства транспортного хаба нужна информация о пассажиропотоках, интервалах движения городского транспорта и интенсивности автомобильного трафика.
Необходимые данные (а их суммарный объем измеряется в петабайтах) собирают ЦОДД, Московский метрополитен, «Организатор перевозок», «Мосгортранс», «Администратор московского парковочного пространства» и другие структуры транспортного комплекса. В целом, ничего сложного: получаем доступ к базам, берем информацию, «причесываем», анализируем, действуем, решаем задачу. Но, как обычно это бывает с данными, все не так просто.
В поисках склада
Проблема в том, что для неподготовленного специалиста обособленные друг от друга базы напоминают склады с наваленными коробками — чтобы быть уверенным в результате, нужно заглянуть в каждую. Старожилы «МосТрансПроекта», конечно, знают, где взять ту или иную информацию, но без их помощи работать с данными было трудно. Иногда нужно было пройти увлекательный квест, чтобы забрать сведения, которые есть лишь у конкретного специалиста.
Кроме того, применялись разные подходы в расчете той или иной цифры. Исходные данные все использовали плюс-минус одни и те же, но в зависимости от задачи по-разному их обрабатывали и интерпретировали, а привычки документировать и делиться методиками еще не было.


Как собрать pgmodeler, если о Qt вы услышали первый раз, а о существовании C++, знаете только то, что он существует?


Привет, Хабр! Меня зовут Андрей Околелов, я работаю ведущим инженером в Блоке обеспечения и контроля качества выпуска изменений ПО в РСХБ. В банковской сфере я работаю с 1992 года, с 2018 основная деятельность — тестирование банковских приложений.
SQL написать просто, когда это обычный Select. Но становится сложно, когда критериев очень много, а вариативности еще больше. А если еще добавить команду разработчиков, в которой у каждого свое мнение, то процесс становится очень трудным. В материале я расскажу, как внимание к деталям и смена фокуса от модели к предметной области позволяют решить множество проблем разработки запросов и создать удобный инструмент не только для разработчика, но и для всей команды.

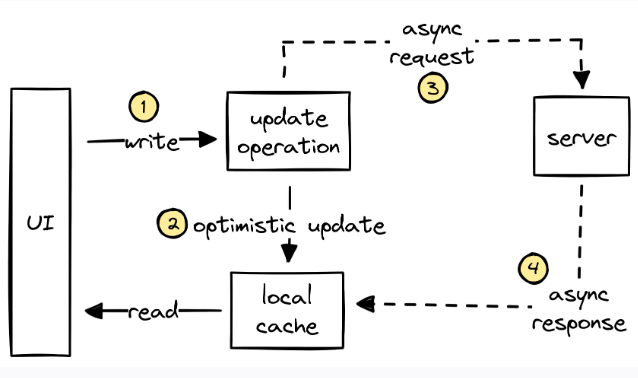
В жизни каждого инженера-фронтендера наступает момент, когда осознаёшь: далее не обойтись без кэширования данных из API. Всё может начаться с самых невинных вещей: сохраняем предыдущую страницу с данными, чтобы кнопка «Назад» срабатывала мгновенно; реализуем простенькую логику отмены действия или обеспечиваем слияние нескольких состояний от различных запросов к API. Но все мы знаем, чем такое кончается. Один за другим возникают запросы на новые фичи, и вскоре мы уже не покладая рук реализуем кэши данных, индексы для работы вручную, оптимистические мутации и рекурсивную инвалидацию кэша.
Эти фичи явственно смахивают на внутренние механизмы баз данных. Действительно, в любом достаточно сложном клиентском приложении программисту непременно придётся реализовывать такое множество фич для управления данными, что эта работа будет напоминать построение предметно-ориентированной базы данных. Такая дополнительная сложность удваивается в каждом проекте, над которым мы работаем, поэтому приходится тратить время на решение бизнес-проблем, а радовать пользователя – уже как успеем.
Поэтому сегодня предлагаю вам составить мне компанию – и мы вместе рассмотрим распространённые паттерны работы с данными приложений, а также разберёмся, как они соотносятся с фичами баз данных. Далее мы рассмотрим решения, которые могли бы стать альтернативами этим паттернам – например, как сделать в клиентской части оптимизированный стек базы данных, который позволил бы нам сосредоточиться на разработке приложения, а не на мелкой возне с данными.


Рассмотрим вариант расширения стандартного CADLib API в части выборки объектов с некоторыми параметрами из базы при помощи SQL-запросов на примере получения всех файлов публикации, в которых встречаются объекты коллизий. Подобную задачу мы решим сперва вручную при помощи только лишь методов CADLib API, а затем комбинированным способом, с переносом части логики в SQL-запрос. Весь исходный код доступен на GitHub по ссылке.

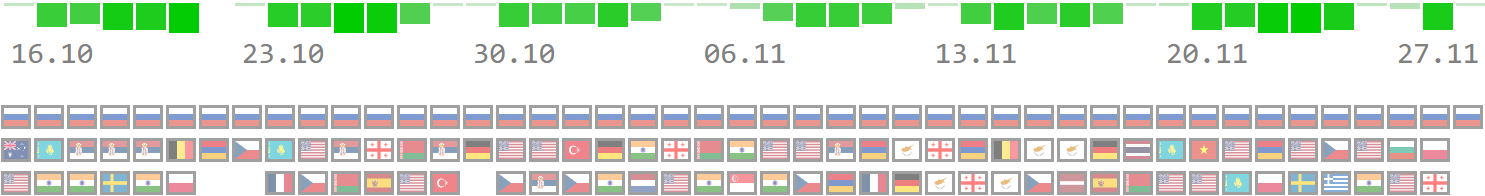
Периодически сталкиваюсь с однотипными задачами вида "показать TOP-N позиций на каждом из вложенных интервалов некоторого периода".
Это может быть "5 лучших по успеваемости студентов в каждом семестре за последний учебный год", или "помесячная динамика позиции 10 наиболее продающихся товаров", или, как у нас в сервисе визуализации PostgreSQL-планов explain.tensor.ru, "3 наиболее активных страны за каждый день":


Как не грабить память, не пытать диск, не мучать кластер. Или делать все это всего одним запросом на Impala к Hadoop.
Среди задач аналитиков данных, в рамках которых необходимо иметь дело с большими объемами однотипных данных, выделяются задачи построения витрин данных, автоматизации процессов сбора и обработки данных. Многие аналитики используют различные реляционные базы данных, в таблицах которых хранятся огромные объемы информации, агрегация и доступ к которым может занимать долгое время, поэтому правильное составление и оптимизация запросов к этим таблицам становится критически необходимым фактором для работы аналитиков, инженеров данных и data scientist.


Когда я ищу квартиру, для меня важно знать не типовой ли это дом "панелька" 60-90х. Одно время пожив в однокомнатной квартире в "Башне Вулыха" я проникся уважением к этим сериям домов советской эпохи по сравнению панельками. Затем пожил в монолитной новостройке с потолками 3.2м, но со слышимостью как в обычном панельном доме 70х.
Интересно было бы посмотреть на карте на застройку столицы определенной серией домов. Сказано - сделано! Добавил в данные карты на GitHub Pages тип проекта здания, чтобы поиск теперь работал и для типовых домов.

Возможно, вы как раз их тех, кто, просыпаясь каждое утро, задаёт себе три самых вечных жизненных вопроса: 1) как мне сделать потоковый SQL‑движок? 2) Что это такое — потоковый SQL‑движок? 3) Способен ли Господь наш сбрасывать те таблицы, коими владеет иной пользователь?
Я тоже ловил себя на том, что задаю себе эти вопросы, и порой они не оставляют меня даже во сне. Мне снятся различные SQL‑операторы, которые тычут в меня пальцем, насмехаются над моей некомпетентностью, а я умоляю их, чтобы они ответили на эти вопросы.
Так вот, где‑то год назад я (довольно смело, если «смелость» — это вообще про меня) снарядился как следует и пустился в долгий и тернистый путь, искать ответы на эти вопросы. Я шёл от монаха к пресвитеру, а от того — к жрецу макаронного монстра, и только в ужасе осознавал, сколь жалкие вопросы их занимают — например, каков смысл жизни, и как обрести мир с самим собой. Но, в конце концов, потерявшись в глубочайших расщелинах моего разума, я набрёл на часовенку, над входом которой значилось: «Epsio Labs». Тут я преисполнился откровения и вошёл в двери этого храма.
Друзья, сегодня я поделюсь с вами теми таинствами, которые познал там (за исключением тех, что подпадают под многочисленные NDA).

Привет, Хабр! Если вы читаете этот материал, скорее всего, вы готовитесь к собеседованию. Важным аспектом работы системного аналитика (СА) является умение эффективно работать с базами данных, и SQL — это ключевой инструмент для этого. Будьте готовы, что на техническом собеседовании вас могут попросить назвать операторы SQL, написать запросы для извлечения, обновления или удаления данных, создания новых таблиц и многого другого. Давайте посмотрим на некоторые примеры таких заданий.

Исходя из того, что предыдущую статью не заминусовали и даже не сильно критиковали, попробую продолжить серию и поделиться с проблемами некоторых различий типов данных в MS SQL и PostgreSQL.


Привет, Habr! Меня зовут Оля Плюта, я продуктовый аналитик маркетплейса Uzum Market. В этой статье я расскажу об иерархических деревьях ltree в PostgreSQL. Статья вводная, поэтому я постаралась сделать её максимально понятной и наглядной.

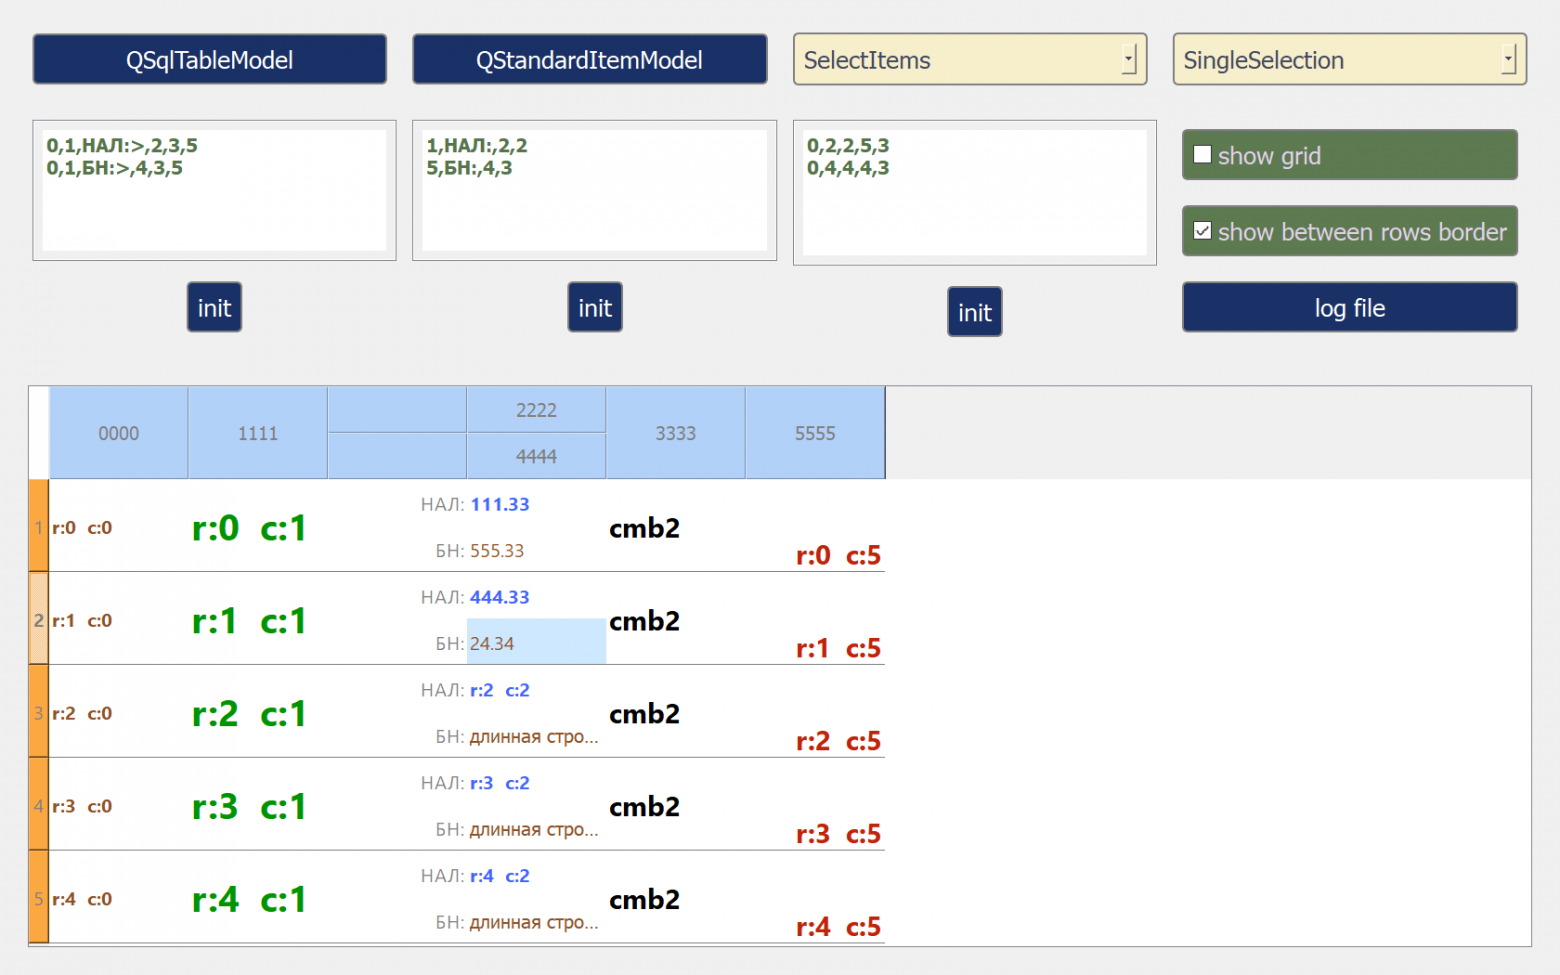
Создаем свой кастомный стиль для QTableView без css стилей и переопределения ролей модели данных. Занимаемся отрисовкой напрямую.


В этой статье хочу поделиться идеей разработки простого скриптового языка DSL, работающего в БД в виде хранимых процедур, который позволил жесткую логику тестирования на клиенте заменить на гибкую логику скрипта, хранящегося в базе данных. Скрипт поддерживает циклы , прямую и косвенную адресацию, установку параметров тестирования прямо из скрипта, позволяет работать в пошаговом режиме, проводить отладку операций, делать паузу и остановку и т д.
Подход с переносом логики управления в БД (включая перезапуск тестов и паузы) превратил SQL Server из простого хранилища в полноценный Оркестратор в SQL.

Привет, Хабр!
Многомерный анализ данных позволяет нам оперировать множеством измерений и атрибутов, создавая более глубокое понимание данных. Это важно для принятия обоснованных бизнес-решений, улучшения производительности и оптимизации процессов.
Работая с данными, мы сталкиваемся с разнообразными задачами, такими как анализ продаж, мониторинг производственных процессов, оценка клиентской активности и многое другое. Многомерный анализ данных позволяет им лучше понимать взаимосвязи между данными и выявлять скрытые закономерности.
SQL (Structured Query Language) и OLAP (Online Analytical Processing) – два важных инструмента, которые помогают осуществлять многомерный анализ данных. SQL – это стандартный язык запросов для работы с реляционными базами данных. Он позволяет выбирать, фильтровать, суммировать и агрегировать данные.
OLAP предоставляет специализированные инструменты и структуры данных для многомерного анализа. Он позволяет создавать многомерные кубы, где данные организованы вокруг нескольких измерений, облегчая агрегацию и навигацию по данным.

SQL-инъекция - это атака, которая может привести к компрометации конфиденциальных данных и даже полному захвату системы.
Разрабам и сисадминам важно знать об этой угрозе и принимать меры по ее предотвращению. Использование подготовленных инструкций с параметризованными запросами, проверка и очистка входных данных, а также регулярные аудиты могут значительно снизить риск успешной атаки.

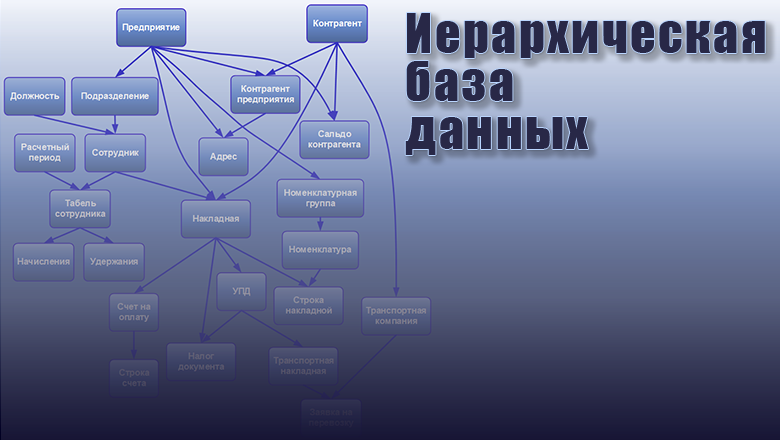
Эта статья посвящена реально работающей информационной системе (ИС), основанной на иерархической модели данных. Скажу точнее - это не просто ИС - это инструмент разработки ИС любого уровня сложности, включая ERP, CRM, PPM и т.д., обладающий полным набором средств разработки (инструментом описания структуры данных, встроенным процедурным языком и языком запросов, инструментом разработки экранных форм, инструментом написания программного кода и т.д).
Во 2-ой части статьи описывается внутреннее устройство ИС.