Обновить
7
Дмитрий Кан@DKey

Разработчик, team lead, CEO

5
Подписчики
Отправить сообщение

Как Яндекс научил искусственный интеллект понимать смысл документов

Время на прочтение10 мин
Охват и читатели81K
Сегодня мы расскажем о новой поисковой технологии «Королёв», которая включает в себя не только более глубокое применение нейронных сетей для поиска по смыслу, а не по словам, но и значительные изменения в архитектуре самого индекса.


Но зачем вообще понадобились технологии из области искусственного интеллекта, если еще лет двадцать назад мы прекрасно находили в поиске искомое? Чем «Королёв» отличается от прошлогоднего алгоритма «Палех», где также использовались нейронные сети? И как архитектура индекса влияет на качество ранжирования? Специально для читателей Хабра мы ответим на все эти вопросы. И начнем с самого начала.

Читать дальше →

API индивидуализированного изучения грамматики

Время на прочтение4 мин
Охват и читатели8.4K

image

Индивидуальное обучение иностранному языку всегда работает лучше, чем обучение по общим программам и по материалам, которые “подходят всем”. Действительно, программисту и флористу интересные разные темы, разные тексты, а значит — разный языковой материал (лексика в первую очередь). И многие сервисы, помогающие изучить иностранный язык, стараются строить обучение именно таким образом. Например, в ЛингуаЛео можно добавлять свои тексты или выбирать из большой библиотеки те, которые наиболее интересны, и изучать язык, точнее — лексику, именно из этих текстов. Easy Ten позволяет выбирать тематические списки слов. Но всё это про лексику. А что же с грамматикой? Можно ли изучение грамматики сделать индивидуальным?

Читать дальше →

Невидимые друзья вашего github-репозитория

Время на прочтение13 мин
Охват и читатели18K
image
Github это незаменимый инструмент, прочно вошедший в жизнь практически каждого разработчика.

Хотя многие из нас используют его постоянно, не все знают, что существует большое количество сторонних (и бесплатных) сервисов и инструментов, которые тесно интегрированы с github и расширяют его функциональность.

В данной статье мы уделим внимание, в основном, инструментам, работающим в инфраструктуре npm. Полный список сервисов, интегрирующихся с github, можно посмотреть на странице github integrations directory.

Сегодня в выпуске:


Читать дальше →

Утилиты командной строки могут быть в 235-раз быстрее вашего Hadoop кластера

Время на прочтение7 мин
Охват и читатели46K
Примечания tsafin:

Перед публикацией своего цикла статей по MapReduce в Caché, мне показалось важным озвучить данную прошлогоднюю точку зрения из статьи Адама Дрейка «Command-line tools can be 235x faster than your Hadoop cluster». К сожалению оригинальная статья Тома Хайдена, на которую он ссылается стала уже недоступна на сайте Тома, но её, по-прежнему, можно найти в архивах. Для полноты картины предлагаю ознакомиться и с ней тоже.

Введение


Посещая в очередной раз свои любимые сайты, я нашел крутую статью Тома Хайдена об использовании Amazon Elastic Map Reduce (EMR) и mrjob для вычисления статистики отношения выигрыш/проигрыш в наборе данных со статистикой по шахматным матчам, которую он скачал с сайта millionbase archive, и c которой он начал играться используя EMR. Так как объем данных был всего 1.75GB, описывающий 2 миллиона шахматных партий, то я скептически отнесся к использованию Hadoop для данной задачи, хотя были и понятны его намерения просто поиграться и изучить плотнее, на реальном примере, утилиту mrjob и инфраструктуру EMR.
Читать дальше →

Как конструировать слова (от автора, который ненавидит читать)

Время на прочтение4 мин
Охват и читатели25K
Честно говоря, я писатель. Мне платят за то, чтобы я писал слова. Но есть вещь, которую большинство обо мне не знают: я ненавижу читать.

Теперь не поймите меня неправильно — я все еще немного читаю. Я одолел книги и блоги, новые каналы и журналы. Но когда авторы становятся многословными, у меня замыливается взгляд. Мне скучно.

image

Все что я вижу — простыня слов.

В детстве я думал, что мое отвращение к чтению — моя слабость. Это было так, пока спустя годы я не осознал, что эта слабость и помогла мне стать хорошим писателем.

Дело в том, что, в основном, я пишу тексты для приложений и сайтов. Здесь краткость лучше восхитительного стиля, на счету каждый знак. А писать текст для интерфейса во многом напоминает дизайн — дизайн слов для людей, которые ненавидят читать.

101 способ приготовления RabbitMQ и немного о pipeline архитектуре

Время на прочтение18 мин
Охват и читатели46K

Павел Филонов (во время выступления работал в Positive Technologies)


Павел Филонов

В данном докладе я хочу поговорить о пересечении RabbitMQ и Pipeline архитектуры, и о том, как оно связанно с работой нашей компании.

Сначала немного в качестве пролога. Это приятная часть.


Сценка, разворачивающаяся в будний день в офисе, наводит нас на очень приятное размышление. Перед нами встает шикарная задача, новая система. Мало что так сильно будоражит ум инженера, как просьба разработать новую систему. Не починить что-то старое, не адаптировать что-то старое, а именно что-то создать, в каком-то смысле практически с нуля.

Вместе с такой задачей приходит и целая серия проблем.

Использование zRam для увеличения количества доступной памяти под Linux

Время на прочтение3 мин
Охват и читатели145K
image
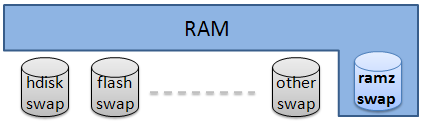
Уже 2 месяца использую на своих компьютерах модуль zRam и хочу поделиться результатами. На практике он позволил мне не используя раздел подкачки, и не получая видимого замедления работы компьютера увеличить размер оперативной памяти в 2.5-3 раза. На сервере виртуалок тот же подход позволил очень ощутимо увеличить отзывчивость при нехватке памяти.
Заинтересовавшихся прошу под кат.
Читать дальше →

Откуда растут ноги у hashCode

Время на прочтение2 мин
Охват и читатели91K
Опять на собеседованиях по Java спрашивают про hashCode и equals? А кто из собеседующих сам ответит на вопрос, как вычисляется Object.hashCode() и System.identityHashCode()? Насколько дорог вызов этих методов? Как их можно ускорить в HotSpot JVM? Держу пари, едва ли кто даст правильный ответ. Разве что, кто прочитает эту статью.
Читать дальше →

100 ресурсов и инструментов для продвижения стартапов на международном рынке

Время на прочтение5 мин
Охват и читатели25K


Большой интерес к нашей исходной компиляции на эту тему вдохновил нас на адаптацию пары (1, 2) добротных подборок, составленных пользователями GitHub.
Читать дальше →

Продвижение мобильных приложений: выученные уроки

Время на прочтение14 мин
Охват и читатели26K
Предвидя комментарии бывалых по поводу этой статьи, что все из написанного давно уже известно, и ничего нового в ней не сказано, спешу сказать, что это не абстрактная статья о том, каковы стандартные приемы и методы продвижения на мобильном рынке. Статья о том, как мы использовали эти методы, и какие результаты получили в итоге. Все это сопровождается реальными цифрами и графиками. Мы готовы поделиться такой информацией. Думаю, даже бывалым будет интересно почитать и сравнить со своим опытом, и, возможно, даже обсудить его в комментариях к статье.

История такова, что наша команда программистов в связи с отсутствием перспективы в основном направлении разработки из-за достаточного количества больших конкурентов (.NET компоненты для репортинга и визуализации данных) решила пойти совершенно в другую сторону — разработку мобильных приложений. Благо, есть инструменты, позволяющие использовать предыдущий накопленный опыт разработки, а не начинать с нуля.

Чего не скажешь об отделе маркетинга и продвижении мобильных приложений. Продвижение компонентов для разработчиков, несомненно, отличается от маркетинга мобильных приложений.

Флагманским продуктом в этом направлении стало приложение для создания и управления базами данных для Android устройств.

Все статьи, прочитанные на эту тему (а их было немало), англо- и русскоязычные, в один голос утверждали, что необходимо в первые дни после публикации (1-3 дня) нагнать как можно больше посетителей на вашу страничку в магазине и заставить посетителей установить приложение. Приложение, показавшее быстрый рост в первые дни после публикации, привлекает внимание издателей, и есть шанс, что оно попадет в список Featured Apps в своей категории или даже в целом в магазине, что несомненно принесет еще больше пользователей и, как следствие, прибыли (вы же для этого разрабатывали свое мобильное приложение). Такая стратегия была оправдана, когда приложений в магазине было не так много и новые появлялись не со скоростью света.

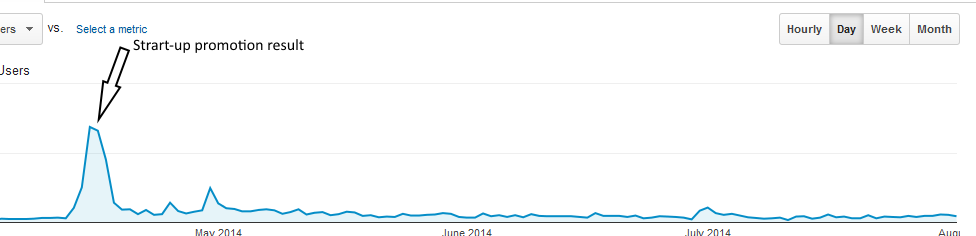
Результат такого подхода выглядит примерно так:
image

Эффект кратковременный, и если за 3 дня вы не попали в желаемый список Featured apps, считайте, что усилия и затраты не оправдались. Количество установок неминуемо снизится в разы.

Хочу рассказать о способах продвижения, о которых мы узнали из статей, и о том, как они работают и работают ли.
Читать дальше →

Подборка бесплатных инструментов для разработчиков

Время на прочтение28 мин
Охват и читатели192K
Сегодня мы представляем вашему вниманию адаптированную подборку инструментов (в том числе облачных) для разработчиков, которые позволяют создавать по-настоящему качественные проекты. Здесь представлены исключительно SaaS, PaaS и IaaS сервисы, предоставляющие бесплатные пакеты для разработчиков инфраструктурного ПО.

Читать дальше →

5 основных стереотипов подсознания, ведущих к неверным решениям

Время на прочтение4 мин
Охват и читатели34K
image

Скорость бережет время и силы, но иногда такая рефлекторная реакция приводит к плохим последствиям. В этой статье, Норма Монтегю, доцент бухгалтерского учета Уэйк-Форестского университета в Уинстон-Сейлем, расскажет, как избежать негативных последствий от мгновенно принятого решения.
Читать дальше →

Работа с кодировками в Perl

Время на прочтение10 мин
Охват и читатели58K
На хабре уже есть хорошая статья об использовании UTF-8 в Perl — habrahabr.ru/post/53578. Я все же немного по своему
хотел бы рассказать о кодировках.

Очень много вопросов связано с многообразием кодировок, а также используемой терминологией. Кроме того, многие из нас сталкивались с проблемами, которые связаны с кодировками. Я постараюсь в этой статье написать в понятной форме информацию по этому вопросу. Начну с вопроса автоматического определения кодировки текста.
Читать дальше →

RuSSIR Music Hackathon 2013: как это было

Время на прочтение5 мин
Охват и читатели4.9K
В ночь с 20 на 21 сентября в рамках VII международной школы-конференции по информационному поиску RuSSIR 2013 в Казани состоялся первый российский музыкальный хакатон RuSSIR Music Hackathon. На правах главного организатора, я хотел бы представить рассказ об этом событии. Данный пост посвящен тем впечатлениям, которые мог получить очевидец события, а следующий пост будет содержать более эксклюзивную информацию — заметки организатора.

Наше мероприятие проходило при поддержке Казанского федерального университета, Высшей школы ИТИС КФУ, НП РОМИП, а главным спонсором и партнером выступил Zvooq — музыкальный сервис компании Dream Industries.

image


Итак, лейтмотивом нашего хакатона стало создание приложений в области музыки в режиме 24 часов. Участники не были ограничены ни типом приложений, ни платформой для реализации. Благодаря тому, что мероприятие проводилось в те же дни, что и школа RuSSIR, наш хакатон собрал довольно уникальный состав участников (всего — 34 человека): в основном, это были молодые ученые из разных городов Европы и России, а также казанские профессионалы-разработчики. По этой причине английский язык стал основным языком общения во время мероприятия. Кроме того, сама площадка для проведения — аудитории университета — придавала особую атмосферу: вместо ночи музеев — ночь в университете!

Читать дальше

Mathlingvo — блог о компьютерной лингвистике

Время на прочтение2 мин
Охват и читатели5.5K
Natural Language Processing — область, которая становится все популярнее и популярнее в Росссии. Но отдельных ресурсов, посвященных этой теме, в рунете практически нет. Полгода назад на Хабре представляли NLPub, каталог ресурсов по компьютерной лингвистике. Но что делать, если хочешь читать новости? Можно попробовать начать с блога mathlingvo.ru

image

Читать дальше →

NLPub — каталог лингвистических решений

Время на прочтение2 мин
Охват и читатели9.4K
Я хочу представить NLPub — небольшую базу знаний, посвящённую компьютерной лингвистике в России.

Сейчас никого не удивить устройствами и приложениями, способными понимать и говорить на человеческом языке. В основе таких приложений лежат методы обработки естественного языка, образующие общее направление на стыке лингвистики и искусственного интеллекта.

Почему подавляющее большинство устройств, приложений и сервисов не работает с русским языком?
Читать дальше →

Точка, точка, запятая: машинное обучение

Время на прочтение7 мин
Охват и читатели17K
Как научить поисковую машину правильно разбивать текст на предложения? Сделать так, чтобы она могла распознавать точки, которые не являются концами предложений.

Наша статья о машинном обучении объясняет одну из техник, которые применяются в поисковой машине тогда, когда возникает нужда в корректном разбиения текста на предложения. Решение такой задачи имеет принципиальное значение, например, при генерации сниппетов поисковыми системами или при построении базы контекстов словоупотребления. Сейчас эта технология встраивается в индексатор Поиска@Mail.Ru. Точность метода, по нашим наблюдениям — не менее 99%.
О том, как это работает, читайте в нашей статье.
Читать дальше →

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность