Обновить
25
Максим@MaximML

Machine Learning Team Lead, автор канала @ml_maxim

24
Подписчики
Отправить сообщение

Ни зарплат, ни отпусков, ни больничных. Зато есть User Story и Merge Request: как AI‑агенты работают у меня в Jira

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели17K

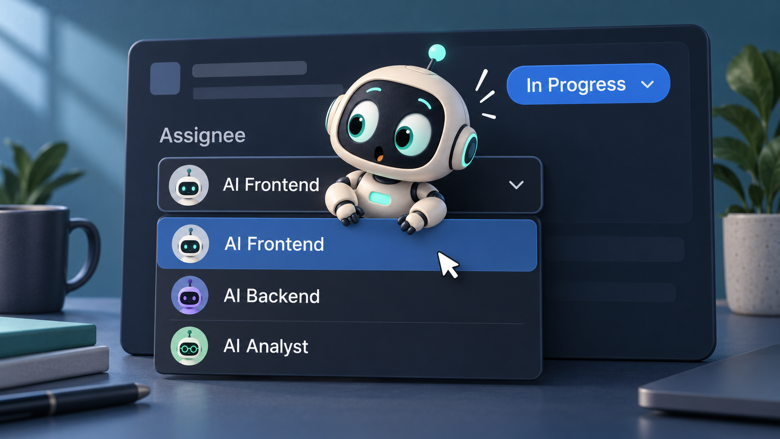
IT-команда в средней компании (продуктовой, интеграторе, неважно) обычно состоит из продукт-менеджера, бизнес-аналитиков, разработчиков и QA-инженеров. Работают они, как правило, в одном трекере вроде Jira. А теперь представьте, что в поле Assignee появились виртуальные коллеги на все эти роли. У меня таких три: фронт, бэк и аналитик.

Людей они не заменяют. Ревью, ответы на вопросы и последнее слово в MR остаются за человеком, ниже покажу, где именно. Агентам я отдаю oneshot-задачи: достаточно понятные и ограниченные, чтобы решить их за один проход без долгой переписки.

Как это работает на практике

Приниматоры решений: бенчмарк на русском для Jev‑style моделей

Время чтения10 мин
Охват и читатели9K

Последние пару лет мы довольно странно используем большие языковые модели.

Из-за их умения делать всё мы пытаемся решить с их помощью всё — роутинг запросов, модерацию, оценку и многое другое. При этом такой сетап инженерно некрасивый: у нас есть модели, которые умеют вести диалог, хорошо программировать и писать статьи, но немалую часть времени инференса они тратят на ответы на достаточно простые вопросы с двумя-тремя вариантами ответов.

Это работает. Но выглядит как доставка упаковки сырников на завтрак на огромной фуре, а альтернатива — обучать отдельную модель под каждую задачу. В сентябре 2026 года вокруг этой проблемы сформировался отдельный класс моделей — Decision Models. 15 сентября TypeSafe показали Jev, а дальше модели принятия решений полетели со всех сторон.

Мне ооочень нравится этот класс моделей, и потому возник простой вопрос: а насколько хорошо это работает в реальной жизни и можно ли тащить это в прод?

Чтобы ответить на этот вопрос, я сконструировал бенчмарк для сравнения качества, скорости и стоимости принятия решений. Будем тестировать и облачные, и self-hosted модели: Perplexity Decider 27B, TypeSafe Jev, Fastino GLiDE и GLiNER2.5-Decide, Cloudflare Clef 27B, OpenAI GPT-6 Luna Decisions, Liquid d1, Kev-9B, Cloudflare Clef-flash 9B, FRIDA-Decisions (и FRIDA Embedder) и Laya Typed Decisions.

Погнали!

Читать далее

Бьем автоматизацией по ручной работе с данными: как мы избавились от рутины с ML-моделями

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели10K

Всем привет! Это DS-ы Павел Парфенов и Максим Шаланкин из команды Финтеха Big Data МТС. Мы и наши коллеги Data Scientists и Data Analysts ежедневно обрабатываем огромные массивы информации, строим модели и выделяем целевые сегменты, чтобы принимать обоснованные решения. Наши рутинные задачи — предварительный анализ данных (EDA), обучение ML-моделей и сегментация аудитории — часто отнимают кучу времени и ресурсов. 

Для себя и коллег с другими компетенциями мы решили сделать инструмент, который сэкономит время на рутинных задачах. В этой публикации мы подробно расскажем, что именно оптимизировали с помощью автоматизации и на каких этапах рабочего процесса применяем нашу командную платформу. Используя этот опыт, вы сможете освободиться от монотонных действий при работе с данными и сосредоточиться на по-настоящему важных вещах.

Читать далее

40 млн строк кода: как меняется ядро Linux в 2026 году

Время чтения5 мин
Охват и читатели7.8K

Начало 2026 года для сообщества ядра Linux получилось насыщенным. В конце января в документацию добавили раздел Linux kernel project continuity. В нем описывается, что произойдет, если ключевые участники проекта внезапно не смогут выполнять свою работу. Обсуждения шли еще на Maintainers Summit в декабре 2025-го, и теперь этот вопрос зафиксирован в документации в явном виде.

Все вполне логично. Ядро Linux давно превратилось в часть огромной мировой инфраструктуры — с десятками миллионов строк кода, тысячами разработчиков из компаний по всему миру и постоянным давлением со стороны требований к производительности, безопасности и энергоэффективности. Поэтому сообщество вынуждено не только поддерживать текущий уровень стабильности, но и экспериментировать, стараться сделать систему гибче и надежнее. В 2026 году проявились несколько направлений такой работы — от Rust и планировщиков до поддержки новых архитектур. Давайте посмотрим, что тут и как.

Читать далее

7 pet-проектов с LLM: приватность, скорость и безопасность своими руками

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели15K

Зачем всё это?

В последние годы NLP развивается так быстро, что собрать LLM‑систему стало почти так же просто и естественно, как поднять веб‑сервис или собрать пайплайн данных. И всё же логичный вопрос: зачем делать что-то с нуля, если есть готовые SaaS и open-source решения, которые уже просто работают из коробки?

Потому что готовые решения обычно оптимизированы под средний сценарий, а реальный мир почти всегда про частные ограничения: приватность данных, стоимость инференса, задержки, нестандартные источники знаний, требования безопасности и воспроизводимость.

Pet‑проект - это способ руками потрогать ключевые узлы современного LLM‑стека и понять, где именно рождаются качество, скорость и риски. В этой подборке я собрал направления, которые сам считаю самыми обучающими и практически применимыми в 2026 году. В каждом пункте: что строим, зачем, минимальный план и что получится на выходе.

Читать далее

В Anthropic показали, что «характер» в LLM — это отдельное направление в нейросети

Время чтения2 мин
Охват и читатели6.6K

Anthropic опубликовали исследование "The Assistant Axis": попытку формально описать и стабилизировать «характер» больших языковых моделей. Работа опирается на анализ внутренних нейронных активаций в нескольких open-weights моделях. 

Ключевая идея: характер — это не абстрактная роль, а конкретная персона в пространстве других возможных персонажей модели. И у этой персоны есть измеримая координата.

Коротко по основным результатам:

Читать далее

А король-то голый! Как написать свой Claude Code в 200 строках кода

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели26K

Современные кодинг-помощники кажутся магией. Достаточно описать нужное вам на хотя бы немного понятными словами, после чего они сами читают файлы, редактируют проект и пишут работающий код.

Но вот что я вам скажу: в основе этих инструментов не лежит магия. Для них достаточно примерно двухсот строк простого Python.

Давайте с нуля напишем собственный функциональный кодинг-агент.

Читать далее

Performance Review: почему твоя премия — это беспроцентный кредит компании

Время чтения3 мин
Охват и читатели31K

Сейчас в Я проходит очередной perf review, а весной он будет в других крупных бигтех-компаниях. Сотрудники нервно заполняют самооценку, пишут фидбек на коллег, строят теории о том какие оценки получат по итогу и гадают какой в этот раз у них будет бонус.

А теперь вопрос, который все знают, но не озвучивают: справедливо ли, что деньги за твои переработки компания держит у себя целый год, пока ты работаешь как беспроцентный кредитор?

Читать далее

Топ вопросов с NLP собеседований: трансформеры и внимание до малейших деталей

Уровень сложностиСредний
Время чтения20 мин
Охват и читатели11K

Архитектура трансформера и его сердце механизм внимания уже давно стали базой собесов на NLP, LLM и даже CV. В работе трансформеры тоже доминируют. Именно поэтому очень важно до деталей разбираться в том, как они устрены, из каких частей состоят, как работают и где применяются на практике.

Разберем архитектуру по слоям с примерами кода и большим количеством картинок и схем.

Читать далее

Ускоряем LLM по максимуму. Как я создал кросс-платформенный Flash Attention с поддержкой Turing+ архитектур и не только

Уровень сложностиСложный
Время чтения28 мин
Охват и читатели17K

На сегодняшний день трансформеры правят балом хайпа в мире машинного обучения, особенно после появления ChatGPT и ему подобных языковых моделей. Это стало возможным благодаря лежащему в основе их архитектуры механизму внимания (attention), однако он же и является слабым местом с точки зрения производительности и потребления памяти. Хотя в связи с этим и была разработана изящная концепция Flash Attention (Tri Dao), её существующие реализации имеют ряд ограничений.

Поэтому представляю вашему вниманию первую и единственную open-source реализацию Flash Attention 2 на Triton с поддержкой Linux и Windows, Turing-Blackwell архитектур (теперь можно работать в Google Colab и Kaggle), гомо и гетерогенных кластеров, опциональным детерминизмом, а также возможностью ручной кастомизации ядер (kernels) для более гибкой настройки под каждую GPU архитектуру отдельно. Более подробно о том как это устроено и не только — далее в статье.

Читать далее

Как Claude научился файн-тюнить опенсорсные LLM

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели9.7K

Claude Code теперь умеет сам файнтюнить LLM на облачных GPU — от валидации датасета до пуша модели на Hub. Показываю, как это работает.

Читать далее

Память как у слона: представлена система GAM, превосходящая RAG в длинных контекстах

Время чтения2 мин
Охват и читатели7.9K

Память остаётся одной из самых уязвимых сторон современных ИИ‑систем. Когда беседы затягиваются или задачи становятся многошаговыми, может происходить контекстное угасание.

В новой работе учёные представляют систему под названием general agentic memory (GAM). Она сочетает сжатие данных с подходом, напоминающим just‑in‑time compilation в программировании, когда оптимизация выполняется ровно в тот момент, когда код нужен.

Читать далее

Второй мозг для автора — собираем экосистему из нейросетей и заметок

Уровень сложностиПростой
Время чтения15 мин
Охват и читатели12K

Второй мозг для автора — собираем экосистему из нейросетей и заметок

Привет, Хабр! Эта статья - результат совместного труда двух авторов. В своей карьере мы перепробовали много различных методик. Мы искали способы «вытаскивать» мысли из головы в цифровое пространство, где их удобнее структурировать, чтобы затем превратить в связный живой текст. Делимся своим опытом работы с инструментами написания и редактирования текстов, среди которых есть как проверенные временем, так и появившиеся сравнительно недавно.

Узнать больше

Как агенты на базе LLM становятся практичнее: подход Anthropic к выполнению кода в MCP

Уровень сложностиСредний
Время чтения3 мин
Охват и читатели7.7K

С ростом числа MCP-инструментов в реальных агентах стало заметно ограничение: модель начала получать слишком много промежуточных данных. Это увеличивает количество токенов и время отклика, а в сложных цепочках действий приводит к ошибкам. Anthropic предложила решение: вынести выполнение операций в отдельную среду исполнения кода, сохранив за моделью только роль планировщика.

Читать далее

Perplexity под капотом: архитектура AI-песочницы

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели7.4K

Каждый, кто работает с AI, рано или поздно сталкивается с его ограничениями. Недавно я столкнулся с такой ситуацией: Perplexity успешно проанализировал сайт и собрал все ссылки, но отказался их обработать, сославшись на «превышение лимитов ресурсов». Что это за «лимиты» в облачной системе, обладающей, казалось бы, бесконечными мощностями? Этот, на первый взгляд, рядовой сбой стал отправной точкой для технического исследования: я решил заглянуть «под капот» AI-песочницы, чтобы понять, как она на самом деле устроена и почему знание ее архитектуры помогает работать с ней гораздо эффективнее

Читать далее

Как создать AI-аналитика во время учебы: кейс выпускного проекта студентов Школы аналитиков данных МТС

Время чтения7 мин
Охват и читатели6.6K

Привет, Habr! На связи Максим Шаланкин из команды Школы аналитиков данных МТС. Каждый год наши студенты в качестве итогового проекта решают реальные бизнес-задачи, и этот не стал исключением. Четверо выпускников — Анна Шестакова, Григорий Суханов, Михаил Футьянов, Алексей Жданов — создали InsightFinder, мультиагентную систему для автоматического анализа данных (EDA). Этот проект автоматизирует EDA и бизнес-интерпретацию данных, сокращая рутинный процесс с нескольких часов до пяти минут. 

Добавление бизнес-интерпретации повышает вариативность использования: проект становится полезным инструментом как для специалистов Data Scientist или Data Analyst, так и для менеджеров, которые занимаются развитием продуктов и которым нужна быстрая проверка гипотез.

В этом материале я не только покажу результат работы ребят, но и дам подробное руководство, как создать такое решение самостоятельно. Это будет полезно всем, кто интересуется применением LLM в аналитике, мультиагентными системами и следит за развитием анализа данных.

Читать далее

Chonkie: революция в RAG-чанкинге — скорость, лёгкость, удобство

Уровень сложностиПростой
Время чтения11 мин
Охват и читатели17K

В эпоху, когда большие языковые модели (LLM) становятся всё более мощными и применяются во многих задачах, одна из ключевых проблем остаётся прежней — как эффективно снабжать их релевантным контекстом. Одним из популярных решений является подход RAG, где качество итогового ответа зависит от целого ряда факторов, одним из которых является качественное чанкирование исходных текстов. Сегодня мы рассмотрим одно из новых и интересных решений.

Всем привет! Меня зовут Вадим, я Data Scientist в компании Raft. В этой статье я расскажу о Chonkie — библиотеке для простого и быстрого чанкирования документов, а также на практике применю её и сравню с другими популярными решениями: LangChain и LlamaIndex.

Читать далее

Topical Authority на практике: как стать экспертом в глазах Google (и почему одна статья никогда не ранжируется)

Уровень сложностиСложный
Время чтения13 мин
Охват и читатели5.7K

Ко мне пришел клиент с блогом о кофе. Он показал статью на 4500 слов про методы заваривания эспрессо. Текст написан бариста с двенадцатилетним стажем. Фотографии профессиональные. Техническая оптимизация безупречна.

Позиция в Google? 47-е место.

Я открыл топ-3 по тому же запросу и увидел картину, которая повторяется в моей практике. Статьи слабее по глубине, без экспертного авторства, с посредственными иллюстрациями. Но эти материалы были частью сайтов, где про кофе написано всё — от истории напитка до химии экстракции кофеина, от обзоров профессиональных кофемашин до детальных гайдов по выбору зёрен из разных регионов произрастания. Google воспринимает эти ресурсы как экспертные источники по всей теме "кофе". А блог моего клиента остаётся точечным игроком. Одна статья. Пусть даже гениальная.

Вот в чём суть проблемы, которую я наблюдаю последние три года работы с клиентами из разных ниш. Алгоритмы больше не ранжируют отдельные страницы в изоляции. Они оценивают сайты как целостные источники знаний по топику. Согласно обновленным Google Search Quality Rater Guidelines от декабря 2024 года, раздел 3.3 явно указывает на важность демонстрации expertise через "объём и глубину контента по теме, созданного квалифицированными авторами".

Цифры это подтверждают жестко. Исследование Ahrefs, проанализировавшее 1.8 миллиарда страниц в 2024 году, показало шокирующую закономерность — сайты с высоким топикальным авторитетом получают на 53% больше органического трафика, чем ресурсы с разрозненным контентом при одинаковом профиле обратных ссылок. Вдумайтесь. Одинаковые ссылки, но в полтора раза больше трафика только за счёт комплексного покрытия темы.

Читать далее

Как Cursor устроен изнутри. Часть 1

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели61K

Вторая часть статьи здесь

Всего за год нагрузка на Cursor выросла в 100 раз: более 1 млн запросов в секунду и миллиарды автодополнений кода каждый день. Подробный разбор архитектуры — вместе с сооснователем Суалехом Асифом.

Cursor — это IDE с кодогенерацией на AI-агентах, которая сейчас пользуется наибольшей популярностью среди разработчиков. В прошлогоднем опросе, Cursor был самым частым ответом на вопрос «Назовите вашу любимую IDE с генеративными функциями, помогающими в работе».

Стартап, стоящий за Cursor — Anysphere, был основан в 2022 году, а в марте 2023 года запустил Cursor. Недавно Anysphere сообщила, что привлекла $900 млн, при оценке компании в $9.9B. Годовой доход (автор имеет в виду годовой повторяющийся доход, Annual Recurring Revenue, ARR. Прим. пер.) уже превысил $500M. Ни одна другая компания в сфере инструментов для разработчиков, которую я знаю, не достигала этого рубежа в течение первых 2 лет после запуска первого продукта. Поспособствовало этому и то, что Cursor используется более чем половиной из 500 крупнейших технологических компаний из списка Fortune 500.

Я встретился с сооснователем Cursor, Суалехом Асифом, чтобы узнать, как работает Cursor и как команда этот инструмент создает. Обсудили следующие темы:

Технологический стек. TypeScript, Rust и куча облачных провайдеров — Turbopuffer, Datadog, PagerDuty и другие.

Как работает автодополнение. Устройство low-latency движка для передачи зашифрованного контекста на сервер для инференса.

Читать далее

От GPT-2 к gpt-oss: анализ достижений архитектуры

Уровень сложностиПростой
Время чтения21 мин
Охват и читатели8.1K

📝 Описание

На этой неделе разбираем релиз GPT-OSS — первых полностью открытых моделей OpenAI с момента GPT-2 в 2019 году. Две модели: gpt-oss-20b и gpt-oss-120b представляют собой современные LLM с архитектурой MoE (Mixture of Experts), оптимизированные для рассуждений и способные работать на одном GPU благодаря квантованию MXFP4.

Читать далее
1
23 ...

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность