Обновить
6
Иван Камшуков@athmath

Data scientist

4
Подписчики
Отправить сообщение

Как раскатывалась сталь: история про хрупкую девушку в металлургии

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели3.4K

Привет, Хабр! Меня зовут Надя, уже более двух лет я работаю дата-сайнтистом в «Инфосистемы Джет». Я привыкла почти всегда находиться в мужском коллективе, а выбор профессиональной сферы деятельности не особо помогает изменить эту ситуацию: раньше я работала в ракетно-космической отрасли, а сейчас — в металлургии.

Про переход в ИТ, ML на производстве и гендерные стереотипы — смотри ниже.

Читать далее

Все способы покупки крипты в России: детальный разбор со ссылками

Время на прочтение15 мин
Охват и читатели220K

Привязанные к доллару стейблкоины для многих эмигрантов стали чуть ли не главным средством перевода своих денег в неблокируемое и незамораживаемое состояние и вывоза их из РФ. В этом гайде мы разберем нюансы и риски всех основных способов легального приобретения крипты в России.

Читать далее

1. Теория информации + ML. Энтропия

Время на прочтение9 мин
Охват и читатели27K

Теория Информации и Machine Learning мне видятся как интересная пара областей, глубокая связь которых часто неизвестна ML инженерам, и синергия которых раскрыта ещё не в полной мере.

Начнём с базовых понятий Энтропии, Информации в сообщении, Mutual Information, пропускной способности канала. Далее будут материалы про схожесть задач максимизации Mutual Information и минимизации Loss-а в регрессионных задачах. Затем будет часть про метрику Фишера, геодезические и градиентные методы, и их связь с гауссовскими процессами.

Читать далее

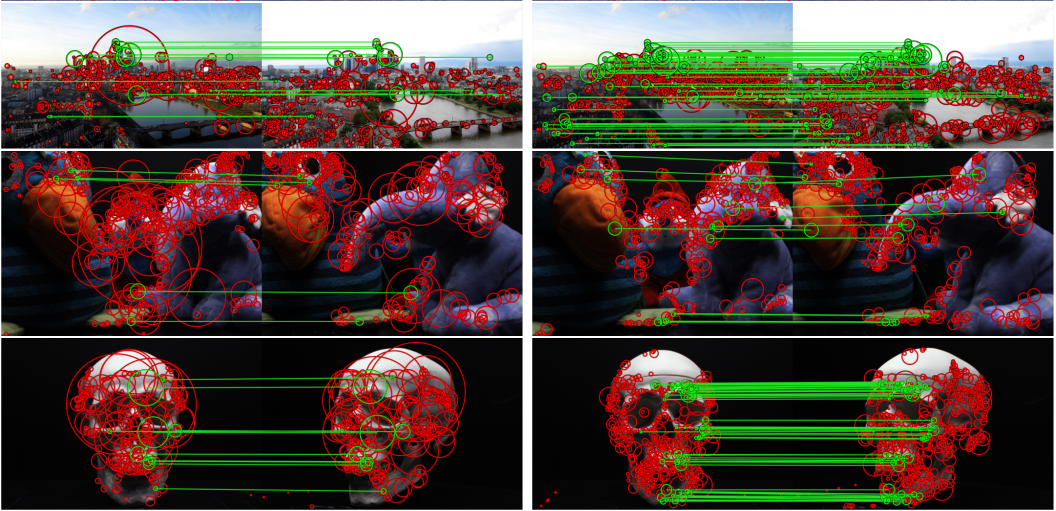
LIFT: Learned Invariant Feature Transform

Время на прочтение7 мин
Охват и читатели12K

image


Введение


В последние годы вездесущие нейронные сети находят все больше и больше применений в различных областях знаний, вытесняя классические алгоритмы, использовавшиеся многие годы. Не стала исключением и область компьютерного зрения, где год за годом все больше и больше задач решаются при помощи современных нейронных сетей. Настало время написать об еще одном павшем бойце в войне "Традиционное зрение vs. Глубокое Обучение". Долгие годы на задаче поиска локальных особенностей изображений (так называемых ключевых точек) безраздельно властвовал алгоритм SIFT(Scale-invariant Feature Transform), предложеный в далеком 1999 году, многие сложили головы в попытках превзойти его, но удалось это лишь Deep Learning'у. Итак, встречайте, новый алгоритм поиска локальных особенностей — LIFT (Learned Invariant Feature Transform).

«Другие» рекомендации. Часть 1

Время на прочтение15 мин
Охват и читатели6.7K

Сейчас в различных источниках имеется огромное количество статей, материалов конференций, телеграм-каналов и открытых репозиториев в GitHub на любую тему из сферы Data Science. В статье хочется обратить ваше внимание на отдельный класс задач, которому, по нашему мнению, уделяют меньше внимания и который не так часто встречается в рамках Data Science кейсов, соревнований или хакатонов.

Речь пойдет о «Других» рекомендациях -- ML-системах, которые уже нельзя отнести к рекомендательным в популярном/классическим смысле. Давайте разберемся, что для нас классика, а что — нет.

Читать далее

Object Detection. Распознавай и властвуй. Часть 1

Время на прочтение10 мин
Охват и читатели47K


Технологии компьютерного зрения позволяют в сегодняшних реалиях сделать жизнь и бизнес проще, дешевле, безопаснее. По оценкам разных экспертов этот рынок будет двигаться в ближайшие годы только в сторону роста, что и позволяет развиваться соответствующим технологиям как в сторону производительности, так и качества. Одним из наиболее востребованных разделов является Object Detection (обнаружение объектов) – определение объекта на изображении или в видео потоке.

Времена, когда обнаружение объектов решалось исключительно путем классического машинного обучения (каскады, SVM...) уже прошли – сейчас в этой сфере царят подходы, основанные на Deep Learning. В 2014 году был предложен подход, существенно повлиявший на последующие исследования и разработки в этой области – R-CNN модель. Последующие его улучшения (в виде Fast R-CNN и Faster R-CNN) сделали его одним из самых точных, что и стало причиной его использования по сей день.

Помимо R-CNN есть еще много подходов реализующих поиск объектов: семейство Yolo, SSD, RetinaNet, CenterNet… Кто-то из них предлагает альтернативный подход, а кто-то развивает текущий в сторону увеличения показателя производительности. Обсуждение почти каждого из них можно вынести в отдельную статью, по причине обилия фишек и ухищрений :)

К изучению предлагаю набор статей с разбором двухступенчатых Object Detection моделей. Умение разбираться в их устройстве приносит понимание базовых идей, применяемых и в других реализациях. В этом посте рассмотрим самую базовую и, соответственно, первую из них – R-CNN.
Читать дальше →

ViT — на кухне фаворит

Время на прочтение15 мин
Охват и читатели21K

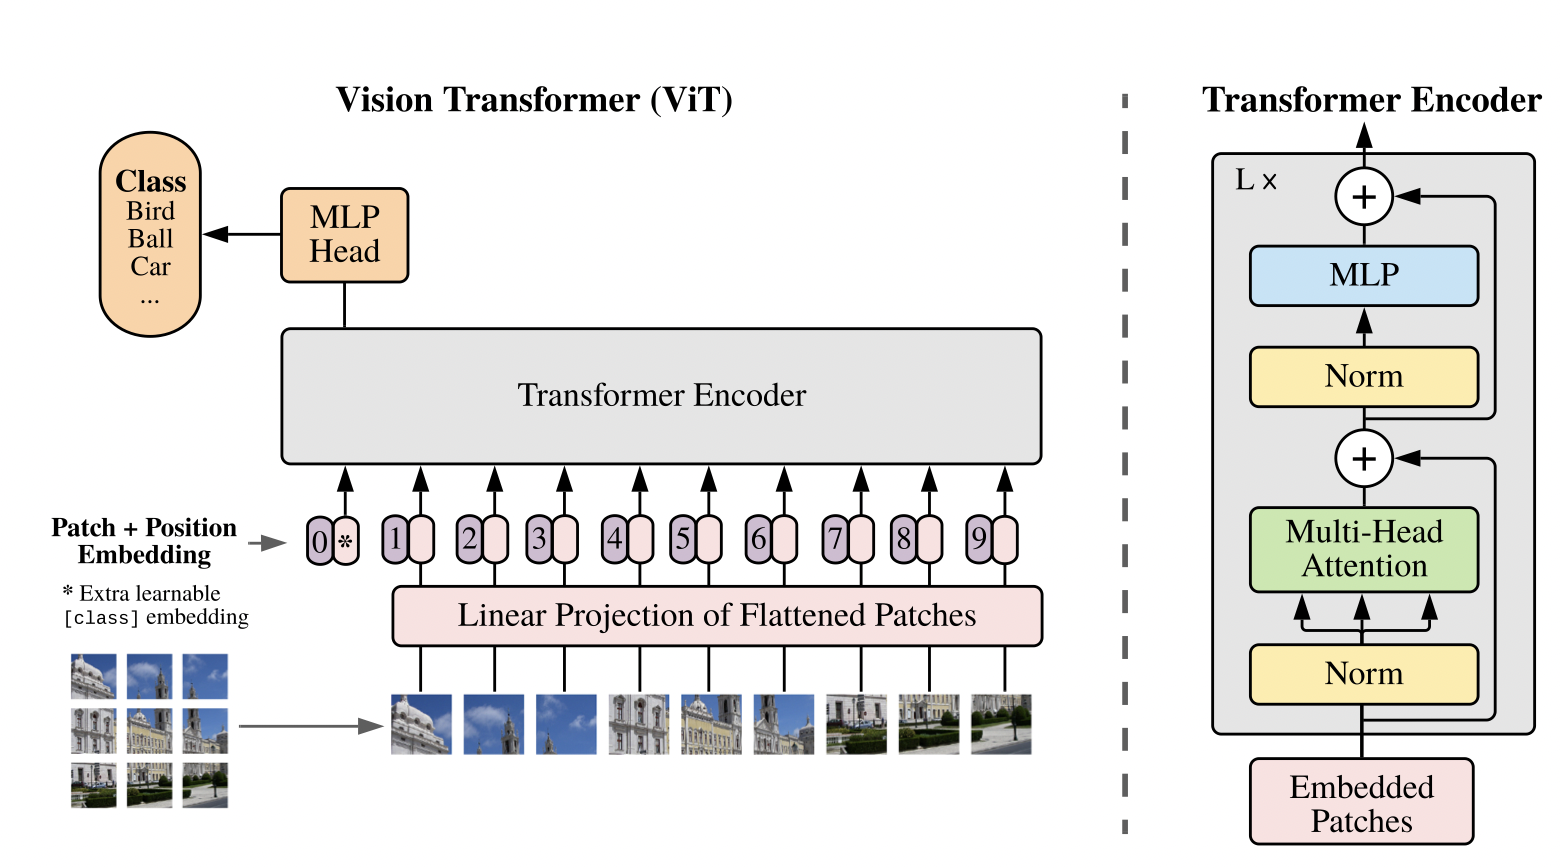
Прошедший 2021-й год ознаменовался настоящей революцией в области компьютерного зрения.

Трансформеры, подобно новым штамма Ковида, вытеснившие конкурентов в области обработки естественного языка (NLP) и задачах, связанных с обработкой звука, добрались и до компьютерного зрения.

Сверточные сети, чье место на Олимпе в различных бенчмарках компьютерного зрения и первые места в топах на PapersWithCode казались незыблемы (в том смысле, что против лома нет приема, если нет другого лома) были сброшены с них рядом архитектур частично или полностью основанных на механизме внимания.

В данном обзоре я хотел бы рассказать о нескольких самых ярких прорывах и идеях в совершенствовании архитектур и обучении ViT-ов (Visual Transformers).

Читать далее

Аналитика vs Data Science: как я ускорил поиск себя в профессии и нашел те самые задачи

Время на прочтение11 мин
Охват и читатели16K

Мне 26 лет, я сменил направление карьеры с прикладной аналитики на Data Science. В моей истории не было кардинальной смены профессии, но я последовательно искал задачи «под себя».

Мой опыт может быть полезен тем, кто пытается найти себя в аналитике и смежных областях, но некоторые моменты и стратегии универсальны и будут полезны всем, кто задумался о переменах в карьере. Поиск «своих задач» похож на сборку LEGO, где блоки — это разные задачи, но вы свободны выкидывать ненужные детальки, обмениваться ими с коллегами или даже брать элементы из другого набора, чтобы построить именно то, что нужно вам. Также я поделюсь списком из почти 20 источников и ресурсов, которые помогли мне сменить профессиональную область.

Читать далее

Гиперпараметры: как перестать беспокоиться и начать их оптимизировать

Время на прочтение11 мин
Охват и читатели24K

«Подбор гиперпараметров». Если у вас в голове при произнесении этой фразы прокатились несколько панических атак и непроизвольно задергался глаз, а, возможно, и рука в инстинктивном желании перевернуть стол с криками «Да ну его, этот ваш дата сайнс» (нецензурную брань оставим за скобками), значит вы, как и я, хоть раз пытались обучить наивный байес мало-мальски тяжелую модель на большом объеме данных.


Источник изображения: thecode.media


Размер батча, learning rate, размер того слоя, размер сего слоя, вероятность dropout-a. Страшно? Уже представляете часы (дни) ожидания? А это я еще про количество голов у трансформеров не говорил…

Читать дальше →

Как мы боремся с копированием контента, или первая adversarial attack в проде

Время на прочтение7 мин
Охват и читатели61K

Привет.


Вы знали, что платформы для размещения объявлений часто копируют контент у конкурентов, чтобы увеличить количество объявлений у себя? Они делают это так: обзванивают продавцов и предлагают им разместиться на своей платформе. А иногда и вовсе копируют объявления без разрешения пользователей. Авито — популярная площадка, и мы часто сталкиваемся с такой недобросовестной конкуренцией. О том, как мы боремся с этим явлением, читайте под катом.


Читать дальше →

Регулярные выражения в Python от простого к сложному. Подробности, примеры, картинки, упражнения

Время на прочтение25 мин
Охват и читатели1.9M

Регулярные выражения в Python от простого к сложному


Решил я давеча моим школьникам дать задачек на регулярные выражения для изучения. А к задачкам нужна какая-нибудь теория. И стал я искать хорошие тексты на русском. Пяток сносных нашёл, но всё не то. Что-то смято, что-то упущено. У этих текстов был не только фатальный недостаток. Мало картинок, мало примеров. И почти нет разумных задач. Ну неужели поиск IP-адреса — это самая частая задача для регулярных выражений? Вот и я думаю, что нет.
Про разницу (?:...) / (...) фиг найдёшь, а без этого знания в некоторых случаях можно только страдать.

Плюс в питоне есть немало регулярных плюшек. Например, re.split может добавлять тот кусок текста, по которому был разрез, в список частей. А в re.sub можно вместо шаблона для замены передать функцию. Это — реальные вещи, которые прямо очень нужны, но никто про это не пишет.
Так и родился этот достаточно многобуквенный материал с подробностями, тонкостями, картинками и задачами.

Надеюсь, вам удастся из него извлечь что-нибудь новое и полезное, даже если вы уже в ладах с регулярками.
Читать дальше →

Исследование устойчивости сверточных нейросетей. Часть 1: Теория

Время на прочтение11 мин
Охват и читатели5.9K
Если Вам интересно разобраться, насколько современные (прежде всего, сверточные) нейросети устойчивы, насколько легко можно менять их выход небольшим искажением входных данных, а также возможно ли это делать на уровне реальных (физических) атрибутов объектов перед их съемкой на (фото)видеокамеру — милости просим под кат!
Читать дальше →

Наука о данных, искусственный интеллект, машинное обучение: путь самоучки

Время на прочтение8 мин
Охват и читатели34K
Не каждый может найти время и деньги на то, чтобы получить очное образование в сферах Data Science (DS, наука о данных), AI (Artificial Intelligence, искусственный интеллект), ML (Machine Learning, машинное обучение). Недостаток времени и нехватка денег — это серьёзные препятствия. Преодолеть эти препятствия можно, занявшись самообучением. Но и тут не всё так просто. Для того чтобы успешно учиться самостоятельно, нужны дисциплина, сосредоточенность и правильный подбор учебных предметов. Самообучение в выбранной области, при правильном подходе, можно свободно совмещать с обычной жизнью или с учёбой в общеобразовательных учреждениях. Но в некоторых областях знаний, в таких, как DS, AI, ML, очень сложно начать учиться самостоятельно. Однако, прошу поверить мне на слово, сложности стоят того, что можно получить в результате. Ключ к успеху в самообучении лежит в том, чтобы учиться в собственном темпе.


В этом материале я хочу рассказать о том, как можно действовать тому, кто хочет самостоятельно обрести знания в областях DS, AI и ML. Применение предложенных здесь методов учёбы способно привести к хорошему прогрессу в изучении нового. Здесь, кроме того, я собираюсь поделиться ссылками на ресурсы, которыми я пользуюсь, и которые я без тени сомнения готов порекомендовать другим.
Читать дальше →

Информация

В рейтинге
Не участвует
Работает в
Зарегистрирован
Активность