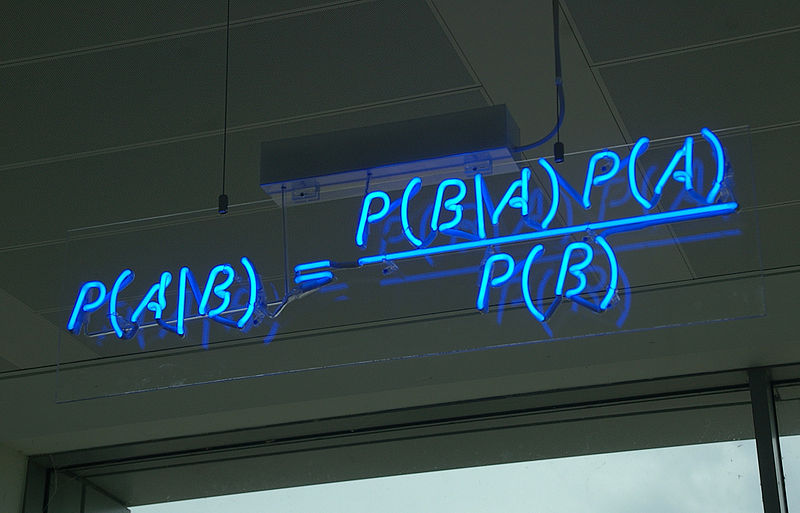Обновить
0

Пользователь

Отправить сообщение

Как мы собрали 12-этажный стек технологий и не сошли с ума

Время чтения8 мин
Охват и читатели7.4K
Appodeal — это компания из ~100 человек, которые работают в Москве, Сан-Франциско, Барнауле, Луцке, Кирове, Барселоне, а с июня 2018 года — еще и в Минске.

Мы занимаемся монетизацией мобильных приложений с помощью показа рекламы пользователям. Начинали мы с медиации рекламы, но стек технологий постоянно растет, поэтому к медиации добавились и другие продукты из отрасли Ad Tech.
image

Для тех, кто еще не знаком с Ad Tech — это область работы технологичных компаний, которые работают в сфере рекламы. Когда рассказываешь кому-то, что ты работаешь в сфере мобильной рекламы, то люди часто реагируют скептически — видимо, на ум приходит надоедливая реклама «Азино три топора». На самом деле это лишь верхушка айсберга, и вся эта “дикая” реклама не имеет никакого отношения к настоящему рекламному бизнесу.
Читать дальше →

Поваренная книга Ruby-разработчика: Domain Driven Design рецепты ( 1-я часть, область применения )

Время чтения7 мин
Охват и читатели18K

Введение


Я хотел бы рассказать об опыте применения практик DDD к существующему Ruby on Rails проекту. Изначально, мы имели монолит, который писался 10 лет. Основная трудность проекта была в достаточно сложных процессах, и высокой связанности. Нам удалось не только декомпозировать приложение на отдельные сервисы, но и существенно повысить читаемость кода, сделать описываемые процессы прозрачными.


Решение задач в рамках системы стало предсказуемым, мы перестали работать с черным ящиком, и в конечном итоге система сама стала подсказывать нам решения.


Для облегчения как восприятия, так и написания, рассказ о применяемых подходах будет представлен в виде цикла статей. Данный подход не является "серебряной пулей", поэтому я бы хотел выделить прежде всего тот сегмент проектов, которым это решение сможет подойти. Далее, я более подробно расскажу о DDD методологии и микросервисной реализации данного паттерна, распишу возможные комбинации применяемых паттернов с учетом их имплементации, и в конечном итоге приведу пример конкретной реализации одного небольшого сервиса.

Читать дальше →

Rails + Postgres + bindings

Время чтения3 мин
Охват и читатели5.5K
image

Привет друзья. Ни для кого не секрет, что работая на крупных проектах со сложной логикой, Active Record становится не помощником, а обузой. Представьте, что вам необходимо сделать очень сложный запрос для PostgreSQL нативным образом (на чистом SQL), где должно присутствовать некоторое количество переменных. Но в Rails есть одна неприятная мелочь, функционал выполнения нативных запросов не позволяет использовать именованные биндинги. Но решение есть :) Опробовано и успешно внедрено на проекте с Rails API 5.2 + Ruby 2.6.0 + Postgres 11.
Читать дальше →

Стажёр Вася и его истории об идемпотентности API

Время чтения11 мин
Охват и читатели299K

Идемпотентность — звучит сложно, говорят о ней редко, но это касается всех приложений, использующих API в своей работе.


Меня зовут Денис Исаев, и я руковожу одной из бэкенд групп в Яндекс.Такси. Сегодня я поделюсь с читателями Хабра описанием проблем, которые могут возникнуть, если не учитывать идемпотентность распределенных систем в своем проекте. Для этого я выбрал формат вымышленных историй о стажёре Васе, который только-только учится работать с API. Так будет нагляднее и полезнее. Поехали.


image

Читать дальше →

Дайджест свежих материалов из мира фронтенда за последнюю неделю №263 (15 — 21 мая 2017)

Время чтения4 мин
Охват и читатели20K
Предлагаем вашему вниманию подборку с ссылками на новые материалы из области фронтенда и около него

Читать дальше →

Формула доверия

Время чтения8 мин
Охват и читатели8.6K
image

Сегодня мы расскажем об одной из ключевых фишек нашей DLP-системы — уровне доверия. Это показатель, который присваивается каждому человеку в компании и отражает вероятность того, что данный сотрудник окажется нарушителем.

Сейчас в DLP-решениях на первый план выходит аналитика. Пару лет назад все российские вендоры стали понемногу пытаться «разворачивать» DLP-системы от борьбы с утечками в сторону выявления и предотвращения других нелегитимных действий сотрудников — мошенничества, откатов, сговоров и т.п. Однако каждый человек генерирует такое количество информации в день, что отслеживать действия каждого невозможно даже в средних компаниях, не говоря о крупном бизнесе. Поэтому способность системы сделать качественную аналитику в автоматическом режиме и очертить круг лиц «под подозрением» была бы очевидным преимуществом. Так возникла идея создания уровня доверия, основной целью которого была прозрачность ситуации с внутренними угрозами в компании.
Читать дальше →

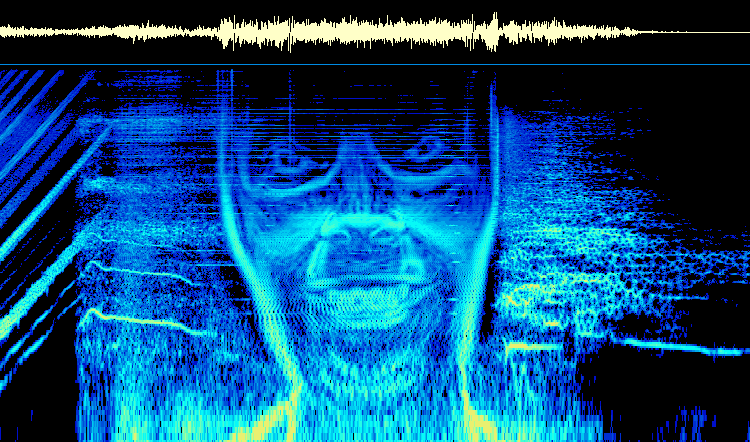
Скрытые послания в музыке

Время чтения7 мин
Охват и читатели77K


Нетрудно вообразить места применения знаний того, как в неявном виде поделиться какой-то информацией, введенной в артефакты массовой культуры. Сегодня в большинстве случаев в скрытии каких-то посланий в музыке нет ровно никакой практической нужды — это лишь приятные бонусы для особенно ярых поклонников музыкальных коллективов. Вплетение посланий в слова песен и меняющиеся краски рисунков в оформлении музыкальных альбомов здесь, конечно, не рассматриваются.

Начнем с простых способов, не имеющих отношения к информатике и вычислительной технике. Наиболее очевидно наложить такие звуки, которые в воспроизведении грампластинки в обратную сторону на бытовом электропроигрывателе или специальной аппаратуре дадут разборчивую человеческую речь.

Бэкмаскинг


Потенциал подобной техники увидел ещё изобретатель фонографа Томас Эдисон, а впервые ею воспользовались пионеры электронной музыки в 50-ых годах прошлого века, хотя, конечно, популяризации приемов бэкмаскинга мы обязаны группе Beatles. В частности, под воздействием марихуаны Леннон прокручивал пленки задом наперед, и полученный звук его очень заинтересовал. Первой песней со скрытым сообщением была Rain.
Читать дальше →

10 советов по прототипированию в Sketch

Время чтения4 мин
Охват и читатели57K


Так как Sketch был создан специально для работы над мобильными и веб-интерфейсами, неудивительно что он стал одним из самых быстрых и гибких инструментов для прототипирования. Эти 10 советов сделают его еще более мощным средством.
Читать дальше →

Занимательная математика в Hearthstone

Время чтения8 мин
Охват и читатели57K
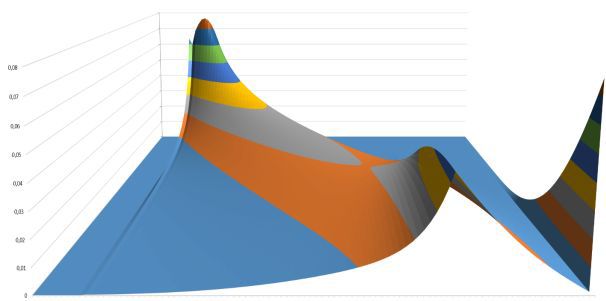
Я любитель популярной компьютерной карточной игры Hearthstone, разработанной компанией Blizzard Entertainment. Однажды я задался вопросом: «Можно ли исходя только из правил, описывающих динамику переходов игрока между уровнями при проигрыше\выигрыше партии, получить статистику распределения игроков по достигнутому ими уровню?»

image

Несмотря на то, что в сети есть огромное количество сайтов и wiki, посвящённых Hearthstone, поверхностный поиск результатов не дал. На глубокий поиск было жаль времени, поэтому я решил задачу «на коленке». Полагаю, это решение может стать темой для занятия в школьном математическом кружке.
Читать дальше →

О формуле Байеса, прогнозах и доверительных интервалах

Время чтения9 мин
Охват и читатели71K
На Хабре много статей по этой теме, но они не рассматривают практических задач. Я попытаюсь исправить это досадное недоразумение. Формула Байеса применяется для фильтрации спама, в рекомендательных сервисах и в рейтингах. Без нее значительное число алгоритмов нечеткого поиска было бы невозможно. Кроме того, это формула явилась причиной холивара среди математиков.

image

Читать дальше →

Каково быть слабым в математике

Время чтения3 мин
Охват и читатели214K
Я, как учитель математики нередко разочаровываюсь в учениках. Они прогуливают. Они ленятся. Они плачут, словно младенцы, если у них отнять калькуляторы. Но хуже всего то, чего они не делают. Не задают вопросов. Не записывают. Не исправляют тесты, даже если это может повысить их общий балл. Разве их не волнуют их неудачи в учебе?


Существует много объяснений такого поведения: лень, равнодушие, отвлекающие внешкольные факторы и т.д. Но если спросите меня, то я назову более глубокую причину: незнание математики заставляет чувствовать себя глупо. А это неприятно.
Читать дальше →

Алгоритм Диффи — Хеллмана

Время чтения1 мин
Охват и читатели167K
Одна из фундаментальных проблем криптографии – безопасное общение по прослушиваемому каналу. Сообщения нужно зашифровывать и расшифровывать, но для этого обеим сторонам нужно иметь общий ключ. Если этот ключ передавать по тому же каналу, то прослушивающая сторона тоже получит его, и смысл шифрования исчезнет.

Алгоритм Диффи — Хеллмана позволяет двум сторонам получить общий секретный ключ, используя незащищенный от прослушивания, но защищённый от подмены канал связи. Полученный ключ можно использовать для обмена сообщениями с помощью симметричного шифрования.

Предлагаю ознакомиться с принципом работы алгоритма Диффи – Хеллмана в замечательном видео от Art of the Problem в моем переводе.

Ричард Фейнман: Алгебра

Время чтения1 мин
Охват и читатели10K

На этот раз знаменитый физик вспоминает свое детство, недоумение по поводу школьной системы образования и свои первые шаги в изучении математики.

На Хабре немало школьников тема образования в последнее время как никогда популярна… Этот ролик, конечно же, не решит проблем дурацких экзаменов и инертных преподавателей… Но тот, кто хочет знать, получит из него как минимум приятный пример.

(Оригинал ролика на английском языке)

Команда математиков за полгода написала 600-страничную книгу, используя GitHub

Время чтения4 мин
Охват и читатели62K
Перевод статьи Андрея Бауера — The HoTT book

Книга по HoTT закончена!

Начиная с весны, и даже раньше, я участвовал в командном проекте по написанию книги по гомотопической теории типов (Homotopy Type Theory). Она наконец написана и готова к употреблению. Вы можете скачать книгу бесплатно: homotopytypetheory.org/book. Майк Шульман рассказал о содержании книги, так что я не буду повторять то же самое. Вместо этого я бы хотел прокомментировать некоторые социо-технологические аспекты создания книги и, в частности, рассказать о том, чему нас научило сообщество Open source.
Читать дальше →

Простыми словами о преобразовании Фурье

Уровень сложностиСредний
Время чтения14 мин
Охват и читатели1.2M
Я полагаю что все в общих чертах знают о существовании такого замечательного математического инструмента как преобразование Фурье. Однако в ВУЗах его почему-то преподают настолько плохо, что понимают как это преобразование работает и как им правильно следует пользоваться сравнительно немного людей. Между тем математика данного преобразования на удивление красива, проста и изящна. Я предлагаю всем желающим узнать немного больше о преобразовании Фурье и близкой ему теме того как аналоговые сигналы удается эффективно превращать для вычислительной обработки в цифровые.

image (с) xkcd
Без использования сложных формул и матлаба я постараюсь ответить на следующие вопросы:
  • FT, DTF, DTFT — в чем отличия и как совершенно разные казалось бы формулы дают столь концептуально похожие результаты?
  • Как правильно интерпретировать результаты быстрого преобразования Фурье (FFT)
  • Что делать если дан сигнал из 179 сэмплов а БПФ требует на вход последовательность по длине равную степени двойки
  • Почему при попытке получить с помощью Фурье спектр синусоиды вместо ожидаемой одиночной “палки” на графике вылезает странная загогулина и что с этим можно сделать
  • Зачем перед АЦП и после ЦАП ставят аналоговые фильтры
  • Можно ли оцифровать АЦП сигнал с частотой выше половины частоты дискретизации (школьный ответ неверен, правильный ответ — можно)
  • Как по цифровой последовательности восстанавливают исходный сигнал


Я буду исходить из предположения что читатель понимает что такое интеграл, комплексное число (а так же его модуль и аргумент), свертка функций, плюс хотя бы “на пальцах” представляет себе что такое дельта-функция Дирака. Не знаете — не беда, прочитайте вышеприведенные ссылки. Под “произведением функций” в данном тексте я везде буду понимать “поточечное умножение”

Итак, приступим?

Пузырьки, кэши и предсказатели переходов

Время чтения6 мин
Охват и читатели11K
Эта заметка написана по мотивам одного любопытного поста, краткий коммент её же автора к которому сподвиг меня разобраться в происходящем поподробнее. Предлагается сравнить две вариации алгоритма сортировки пузырьком. Первая из них – обычный пузырёк, с небольшой оптимизацией — внутренний цикл можно закончить немного раньше, зная, что оставшаяся часть массива уже отсортирована:
for (i=0; i<N; i++)
  for (j=0; j<N - (i+1); j++)
    if (a[j] > a[j+1])
      swap(a[j], a[j+1]);


Во втором варианте внутренний цикл проходит по другой части массива, однако алгоритмически этот вариант эквивалентен первому (подробности ниже):
for (i=0; i<N-1; i++)
    for (j=i; j>=0; j--)
        if (a[j] > a[j+1])
            swap(a[j], a[j+1]);


Запускаем (код), например, для N=100 000 на массиве int'ов, и получаем около 30 секунд в первом случае, и меньше 10 секунд — во втором, то есть отличие в 3 раза! Откуда же тогда берётся такая разница?
Читать дальше →

Теория кэша

Время чтения5 мин
Охват и читатели14K

Введение


Кэширование – это неотъемлемая часть всех сложных систем. Кэширование позволяет существенно увеличить скорость работы приложения, путем сохранения трудновычислимых данных для их последующего использования. Впрочем, не буду вдаваться в определения, большинство разработчиков отлично знает что это такое.

В данной статье я попытаюсь «разложить по полочкам» проблему кэширования, ориентированную прежде всего на сайты и системы управления контентом. Сразу предупреждаю, это мои личные соображения, которые не претендуют на истину в последней инстанции. Вся терминология так же моя, вы можете использовать её, если считаете нужным на своё усмотрение. Конструктивная критика приветствуется.
Читать дальше →

Рекомендательные системы — будущее интернета

Время чтения3 мин
Охват и читатели6.2K
image

Недавно наткнулся на новомодный тренд: рекомендательные системы, — на конкретного его представителя Surfingbird (нет, я не сотрудник данной компании). Сразу встал вопрос, как я могу на этом заработать, не стоит ли готовиться к очередной смене схемы поведения пользователей в сети?

Почему так серьезно?

Читать дальше →

Добавляем вычисление SHA-1 и MD5 хешей в контекстное меню файлов

Время чтения2 мин
Охват и читатели40K
Доброго времени суток!
Как часто вы проверяете скачиваемые файлы на равенство хеш-сумм? Я — никогда. Но сегодня я почему-то решил порвать с этой порочной практикой и сделать свою жизнь более безопасной.
Согласитесь, основная причина не сравнивать хеш-сумму файла — это лень. Нужно искать какую-нибудь программу, запускать ее, натравливать на файл, и это просто уйма действий. Как можно упростить эту процедуру? Я не придумал ничего лучше, чем добавить в контекстное меню файла опцию «Посчитать хеш». Интересующимся предлагаю краткую инструкцию.
Читать дальше →

Ночь фракталов

Время чтения4 мин
Охват и читатели55K
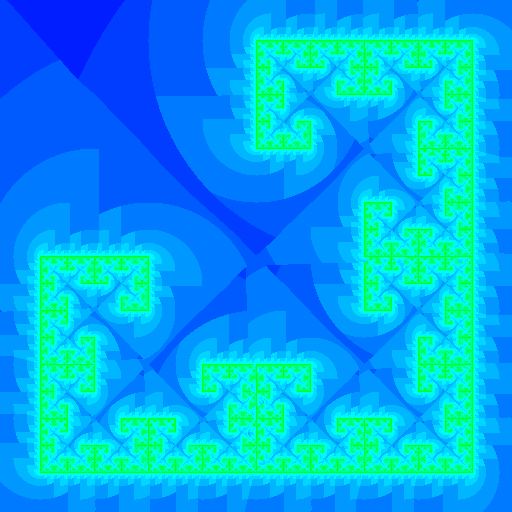
Шёл уже последний час этого воскресенья, я уже думал идти спать, но добрый sourcerer прислал мне картинку с моего заброшенного сайта, которую можно увидеть ниже, и текст «красиво!». Эти картинки я рисовал лет пять назад, с помощью т. н. алгоритма времени убегания, но для применимости данного алгоритма, нужно уметь для заданного набора преобразований разбивать плоскость на регионы, тогда я не придумал, как это сделать, и больше к этому алгоритму не возвращался. Но сейчас я сразу сообразил, что делать, и написал Диме: «Сначала Random IFS, потом kNN, а затем Escape-Time Algorithm!»


Под рукой у меня был только старый нетбук, который мне дали друзья на время, пока мой ноутбук в ремонте. Дима мне ещё что-то говорил, я ему что-то отвечал, но у меня уже в голове писался код, и я искал на нетбуке хоть какой-нибудь компилятор или интерпретатор и нашёл C++ Builder 6! После этого я понял, что утро я встречу наедине с борландовским компилятором. Через пять часов я отправил Диме новых картинок, но он, как нормальный человек, давно спал…


Читать дальше →
1
23 ...

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность