Pull to refresh

Technotext

Картографический фотопроект «По местам съёмок фильма «Брат»

Reading time2 min
Reach and readers15K

Идея создать проект «По местам съёмок фильма «Брат» пришла спонтанно, когда я собирался в поездку в Санкт-Петербург. Подумал о том, что я могу объединить профессиональные знания в картографии и своё почтительное отношение к фильму, тем более, что совсем недавно было 25 лет со дня выпуска фильма. Стандартные туристические маршруты надоели. Мне не нравится гулять там, где ходят толпы туристов, делая одни и те же фотографии.

Первый этап — это понимание того, где конкретно снят тот или иной фрагмент. Информацию искал в интернете, но многие точки были описаны очень неконкретно. Двор на такой-то улице или Морская набережная, 15Б, а по факту этот дом на 29 подъездов. Приходилось на месте искать точки съемки и делать фото, потом уточнять точки в геоинформационной программе на карте QGIS.

Читать далее

Неравный join

Reading time7 min
Reach and readers7.4K


«Неравный брак», В. Пукирев, 1862 г.


Задача объединения табличных представлений очень часто встречается как в аналитике, так и в разработке (БД). Существует несколько различных типов слияний, фактически, это операции над множествами. Не будем погружаться в детали, на эту тему написано множество книг, семинаров, публикаций. Посмотрим на эти механизмы в преломлении практических задач. Будем смотреть по нарастающей сложности и пытаться решить их на «офисном» ноутбуке, не привлекая бесконечные мощности больших данных или реляционные БД.


Является продолжением серии предыдущих публикаций.

Читать дальше →

Отображение возраста контактов в Гугл календаре на день их рождения

Level of difficultyEasy
Reading time3 min
Reach and readers6.4K

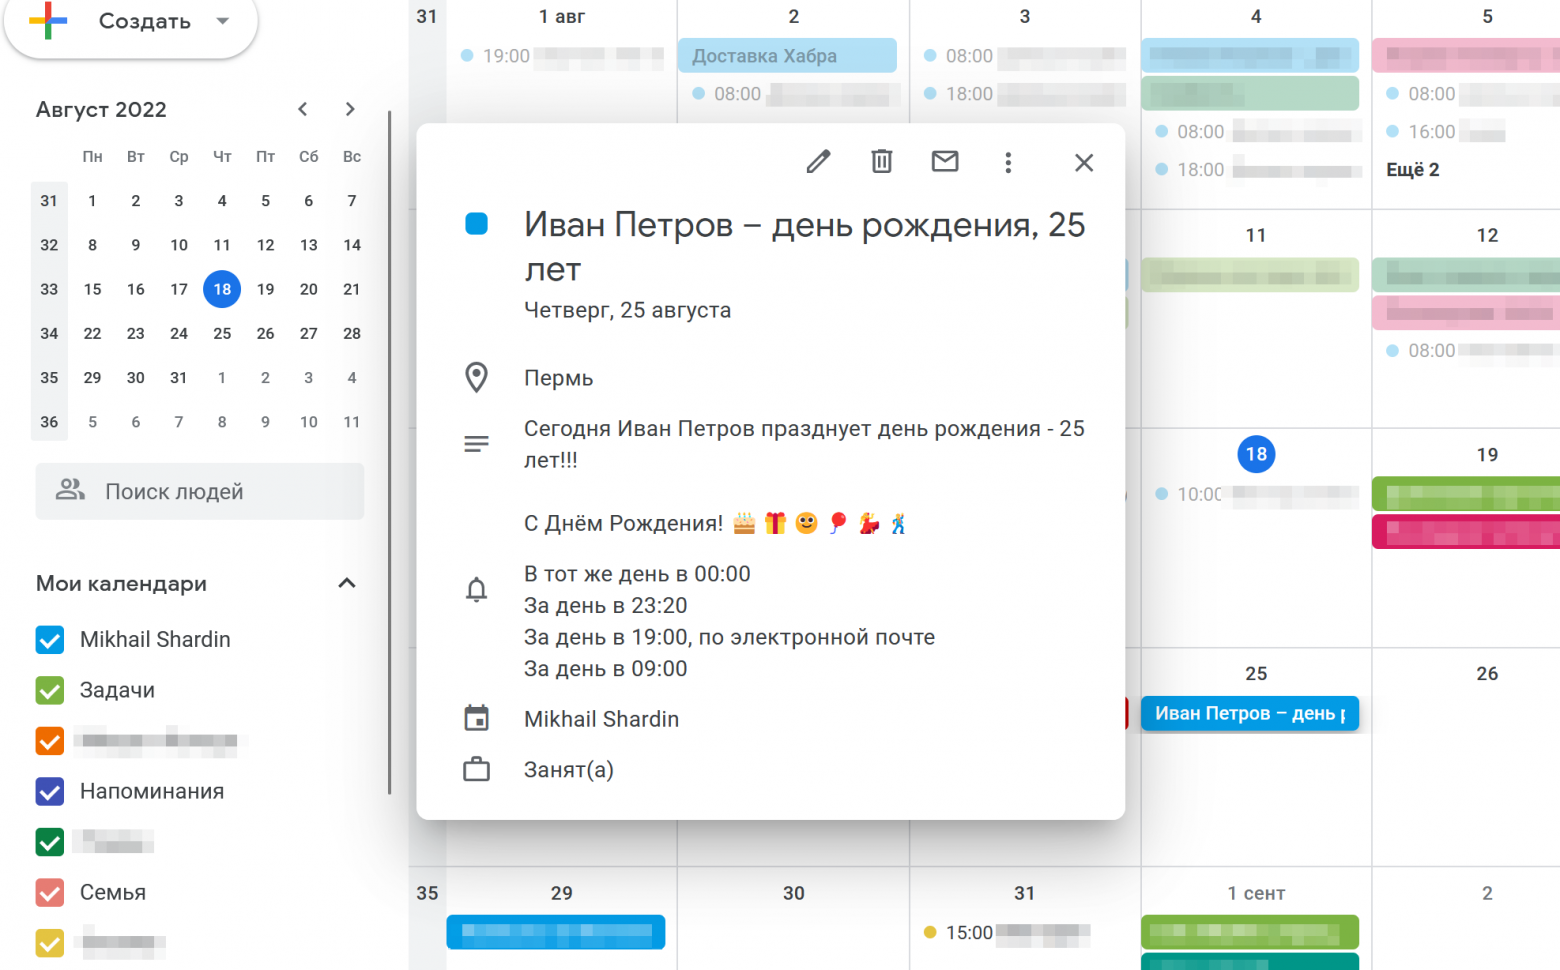
Я уже много лет пользуюсь Гугл календарём и Гугл контактами и единственная вещь которая мне не нравится это отдельный календарь, который не отображает возраст, а показывает только сам факт дня рождения. Ещё в 2019 году я написал скрипт, который решает эту проблему, но прошло 3 года и с помощью одного из читателей Хабра мы добавили склонения слов на русском языке при обозначения возраста и ещё несколько технических функций.

А ещё обновили похожий скрипт для детей: это когда каждый месяц скрипт автоматически создаёт событие в Гугл календаре, в заголовке к которому указано сколько исполнилось годов и месяцев вашему малышу (работает с самого рождения, 0 лет), а в описании указан возраст (годы и месяцы) каждого из родителей. Я сам обычно не помню даты и эти скрипты стали для меня настоящим спасением. 

Пошаговая инструкция внутри

Пятьдесят лет на стезе программирования. Часть V. Назад в СССР. 1988-1991 г.г

Reading time20 min
Reach and readers15K
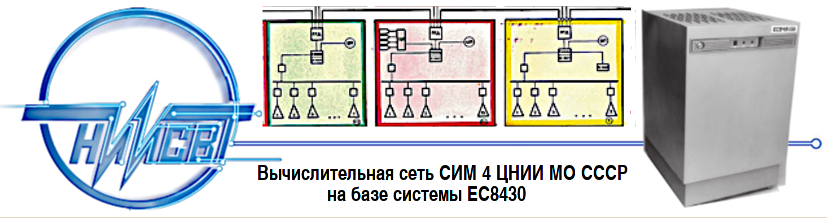
imageПосле эйфории 1987 года, связанной с выходом Постановления ЦК КПСС и СМ СССР по Программе «Противодействие» (СП-2000), в котором мы смогли прописать не только работы, связанные с созданием стенда имитационного моделирования (СИМ), но и предусмотреть поставки средств вычислительной техники (СВТ), началась ежедневная работа по подготовке машинных залов для ЭВМ. Помимо персональных ЭВМ в комплект поставки входили и большие машины ЕС-1066 и ЕС-1007, которые должны были стать центральными звеньями локальных вычислительных сетей, создаваемых в каждом научном управлении института.
Если ЕС-1066 должны были размещаться в новом корпусе 47Б вычислительного центра (ВЦ) и за их ввод в эксплуатацию отвечало также ВЦ, то с ЕС-1007 всё было сложнее.
Для каждой ЕС-1007 необходимо было спроектировать и оборудовать машинный зал с гермозоной для лентопротяжных механизмов и накопителей на магнитных дисках. Машинный зал занимал площадь не менее 25 м2, а если ещё устанавливался, например, графопостроитель, то эта площадь существенно увеличивалась.
Читать дальше →

Как мы сделали самописный длинномер для работы в дата-центрах

Reading time5 min
Reach and readers5.7K

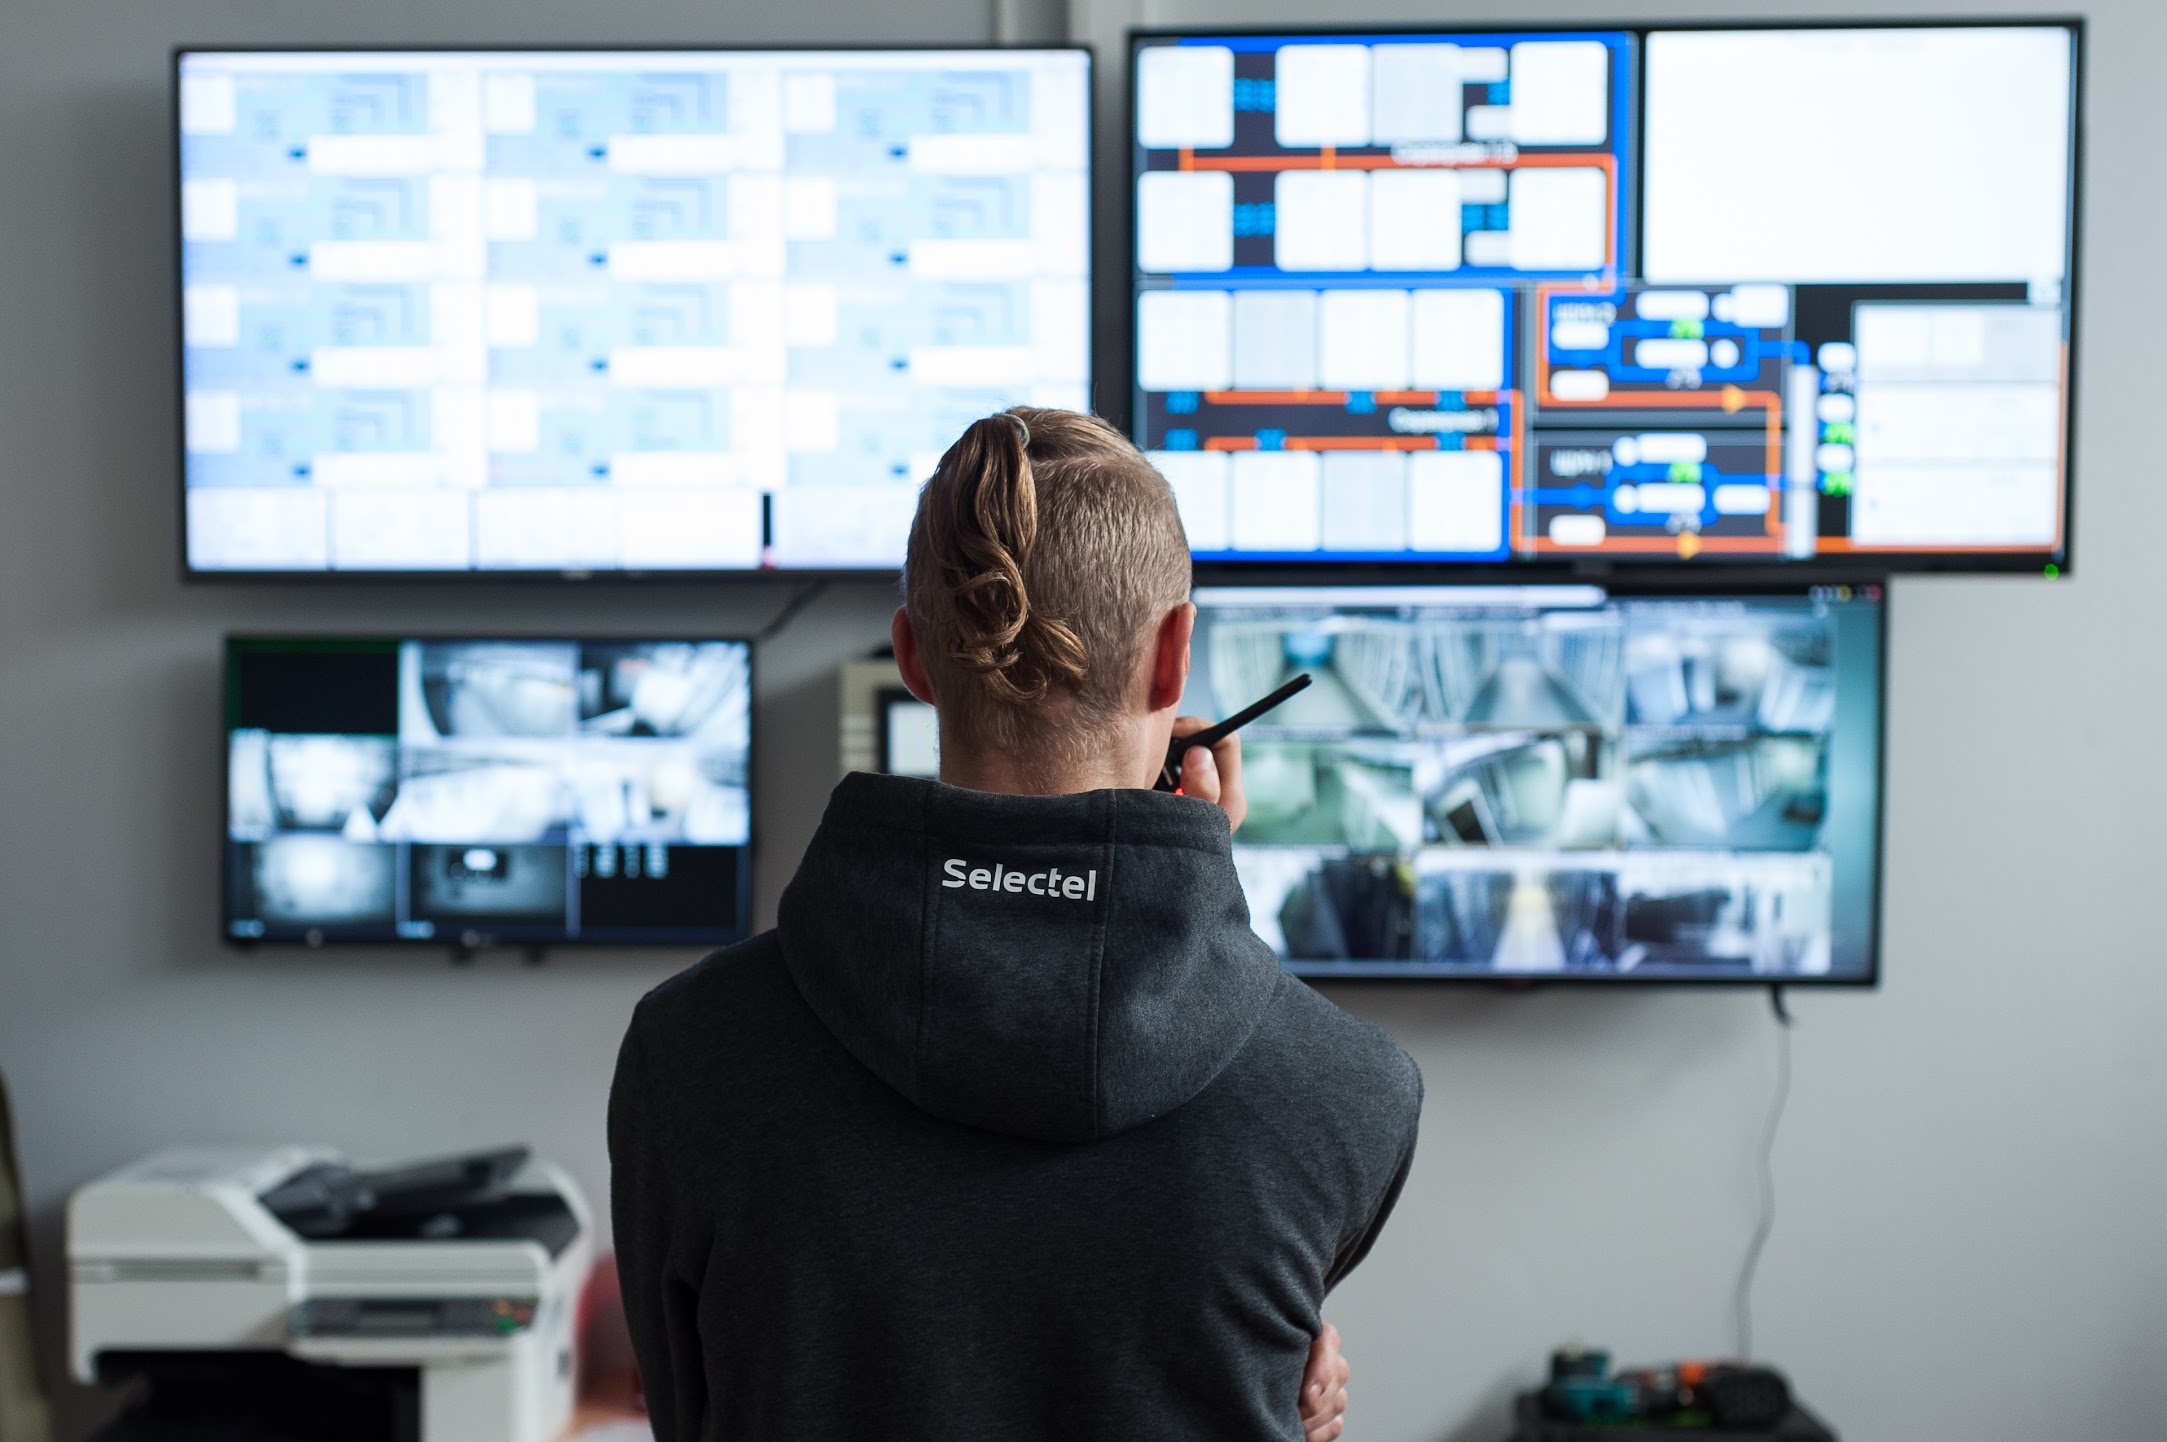
Привет, Хабр! Меня зовут Валентин Тимофеев, я системный инженер в Selectel. Сегодня я поделюсь историей, зачем нам потребовался собственный инструмент для измерения расстояний между стойками для кроссировки и что мы в итоге сделали.

Кроссировка нужна, например, при масштабировании клиентских вычислительных мощностей в сезон активных продаж или при резервации. За последние два года мы кинули порядка 4 000 линков только в дата-центре Цветочная-2.
Читать дальше →

Как мы навели порядок в C++/Qt проекте с помощью Conan

Reading time12 min
Reach and readers18K

О себе

Привет, Хабр! Я Тимлид/Архитектор в компании Монитор Софт. В прошлом C++ разработчик, сейчас все еще удается иногда выходить в поля)). Хочу поделиться нашим опытом использования Conan. С момента описываемых ниже событий прошло года 4, и в целом наше решение уже прошло проверку временем.

Читать далее

Создание ботов для торговли криптовалютами и акциями на Postgres

Reading time22 min
Reach and readers57K

Создание надежных ботов и эмуляторов для торговли акциями и криптовалютой управляемый через телеграмм на базе Postgresql с использованием только pgsql.

Читать далее

Пока, ФИАС! Рассказываем, как устроен адресный справочник ГАР

Reading time9 min
Reach and readers151K

1 сентября 2021 года ФНС перестала обновлять свой адресный справочник в формате ФИАС. Относительно новый ГАР внезапно стал единственным государственным адресный реестром, доступным общественности. Рассказываем, что из себя представляет новый справочник и чем он отличается от ФИАС.

Читать далее

Многомодульный BDSM: как связать Gradle модули и как с ними общаться после этого?

Level of difficultyHard
Reading time15 min
Reach and readers8.1K

В многомодульном приложении часто возникает ситуация, когда в одном модуле находится интерфейс, а вот его реализация находится в совершенно другом модуле. Как следствие, возникает потребность как-то получить реализацию при наличии лишь интерфейса. Всё так или иначе сводится к тому, чтобы обратится к какой-либо сущности, которая отдаст нам реализацию. Но ведь сначала этой сущности надо сообщить, где взять реализацию. Этот процесс я называю связыванием, так как мы связываем интерфейс с его реализацией. Видел, что многие называют это склейкой. Сегодня мне бы хотелось проговорить, какие есть для этого способы. И да, спойлер, их несколько.

Читать далее

Паттерн Outbox: как не растерять сообщения в микросервисной архитектуре

Reading time8 min
Reach and readers189K

Привет! Меня зовут Михаил Боровиков, я тимлид команды, которая отвечает за систему процессинга заказов Lamoda — Orders Management. Эта система, словно «сердце» Lamoda, через которое проходит самый важный для бизнеса шаг — оформление заказа.

Раньше система представляла из себя монолит. Теперь вместо него у нас много отдельных сервисов, которые общаются по сети. В рамках новой схемы взаимодействия сервисов между собой мы и столкнулись с проблемой потери данных в процессе создания заказа, чего допускать в важной для нас системе было категорически нельзя.

Для решения этой проблемы мы выбрали паттерн Outbox. И в этой статье я расскажу, что он из себя представляет, как мы его применили, почему пошли по пути at-least-once и не положились на работу одного брокера сообщений.

Читать далее

Как быстро реализовать поиск на корпоративном портале

Reading time8 min
Reach and readers7.7K

Привет, меня зовут Антон Щербак, я разработчик корпоративного портала Selectel. Это внутренняя система, где можно узнать новости компании, поучаствовать в Selectel Game (это наша собственная геймификация рабочих достижений) и, конечно, найти необходимого коллегу или структуру.

Нас уже более 700, и иногда поиск человека превращается в выпуск ток-шоу «Жди меня». Поэтому у нас была задача сделать его более удобным и приводящим к нужному результату. Под катом рассказываю, к какому решению мы в итоге пришли и как реализовали.
Читать дальше →

К микросервисам через reverse engineering и кодогенерацию

Reading time19 min
Reach and readers8.3K

Разрабатывая информационную систему с нуля, мы можем выбрать практически любой вариант технологии и архитектуры в целом, в том числе — принцип взаимодействия частей системы. Но что делать, если система уже есть и у неё довольно богатая история? Как большую энтерпрайз систему, которая развивалась в режиме монолита, разделить на микросервисы и организовать взаимодействие между ними? 

Часто основная сложность заключается в том, что нужно одновременно поддерживать уже существующий код монолита и параллельно внедрять новые принципы и подходы.  В статье я расскажу, как мы в Wrike, используя reverse engineering и немного кодогенерации, реализовали первые шаги по выделению отдельных микросервисов и запустили первый «почти настоящий» BFF-сервис в рамках нашего монолита.

Читать далее

Предотвращаем утечки памяти в Go, ч. 2. Особенности рантайма

Reading time13 min
Reach and readers20K

Мы продолжаем наш рассказ о причинах повышенного потребления памяти в языке Go. В предыдущей статье мы детально разобрали ошибки бизнес-логики приложения, которые могут привести к утечкам памяти. Сегодня же сосредоточимся на особенностях рантайма языка Go.

Читать далее

Взгляд с обратной стороны: как смотрит на код реверсер

Reading time12 min
Reach and readers7.9K
Привет! Меня зовут Денис, я Lead Security Researcher в центре Global Research & Analysis Team (GReAT) — подразделении «Лаборатории Касперского», которое занимается целевыми вредоносами. Это значит, что их авторы не рассылают трояны всем подряд, а тщательно выбирают свои организации-жертвы. Иногда их «продукты» написаны интересно.

Мы в GReAT в буквальном смысле слова годами следим за командами, которые пишут такое, детально разбираем их зло, формируем отчеты для заказчиков, плюс иногда подкидывая идеи и продуктовым командам.

image

Эта статья написана по мотивам выступления на C++ Russia. Я хочу рассказать, как на код C++ смотрит реверсер и что он видит в этом комбайне прекрасном языке. Обычно разработчик идет от исходного кода к двоичному, а мы — наоборот. Ко мне и коллегам приезжают самплы — уже скомпилированные исполняемые (PE, ELF, etc.) файлы, возможно, какой-то байткод одного из intermediate languages или даже прошивка. И мы начинаем их разбирать. Как мне кажется, реверсеры и разработчики могли бы обогатить друг друга.
Читать дальше →

Как мы развивали бэкенд War Robots, в процессе заDDoSив самих себя — и чему научились после этого

Reading time14 min
Reach and readers7.5K

Привет! Меня зовут Андрей Михеев, я занимаюсь развитием бэкенда War Robots (это мобильный PvP-шутер, в котором с помощью больших роботов можно выяснить, кто круче). Игре уже почти 9 лет, и за это время мы повидали всякого.

Круто, когда у вас в команде есть большой опыт в разработке конкретной задачи, архитектура выверена, библиотеки и фреймворки отлажены. Но что делать, если опыта не хватает, готовых решений нет, проект — потенциальный highload, а запуститься желательно было бы уже вчера? Мы как раз оказались в такой ситуации. Об этом и поговорим — а заодно о выводах, которые тут можно сделать.

Читать далее

Оптимизация поиска по большому полю

Reading time10 min
Reach and readers7K
Вновь привет, уважаемые читатели Хабра! Работая с одной из систем хранения метаданных о файлах в «Лаборатории Касперского» вспомнил, что давно хотел написать об оптимизации поиска по большому полю в базах данных. О чем далее и расскажу более подробно.

В данной публикации будет рассмотрена оптимизация поиска по полю бинарного массива и, в частности, по равномерно распределенным данным, а также сравнение между собой выявленных способов.


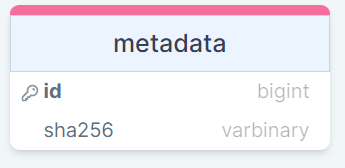
Итак, представьте: у вас есть таблица в базе данных MS SQL, в которой десятки миллиардов строк данных. И в эту таблицу вставляются и удаляются суммарно десятки и сотни тысяч строк в секунду. Назовем эту таблицу dbo.metadata.

Замечание. Для проведенного анализа ниже была создана новая база данных TEST, в которой были созданы две таблицы dbo.metadata и dbo.sha256_checksum (о второй таблице будет написано ниже) и сгенерированы синтетические данные на 1+ млрд строк в каждую. После каждого вызова запроса проводился полный сброс кэша планов для базы данных TEST (DBCC FREEPROCCACHE), чтобы план для запроса каждый раз строился заново, а не брался уже готовый.
Таблица dbo.metadata упрощенно выглядит так:

Определение таблицы dbo.metadata
Читать дальше →

Как мы делали свой поиск в Ozon: эволюция архитектуры от SQL до O2

Reading time16 min
Reach and readers38K

Привет, Хабр! Меня зовут Сергей, я руководитель команды поиска в Ozon. Сегодня я расскажу об эволюции наших поисковых систем: как всё начиналось более 20 лет назад с обычных SQL-запросов, как мы осваивали Sphinx и Elasticsearch и как сейчас наш собственный поисковый движок O2 на базе Apache Lucene выдерживает нагрузку в десятки тысяч RPS в сезон распродаж. Исторические хроники восстанавливались по воспоминаниям современников и представлены для полноты картины. Новейшая история описана на основе собственного опыта, поэтому подробностей будет на порядок больше. Поехали!

Читать далее

Без А/B результат XЗ, или Как построить высоконагруженную платформу А/B-тестов

Reading time17 min
Reach and readers30K

Один из важных вопросов как в нашей жизни, так и в бизнесе, и в IT — вопрос эффективности. Эффективно ли мы планируем наше время, те ли задачи решает бизнес, тот ли код мы оптимизируем? Чтобы ответить на эти вопросы, результат должен обладать главным критерием — измеримостью. Измеримость результата новых фич для бизнеса и IT обеспечивает платформа А/B-тестов. О том, как её можно построить, выдерживать большой RPS и при этом не облажаться уронить прод, я расскажу в этой статье. 

В конце статьи вы узнаете, как мы задетектили проблемы инфраструктуры, оптимизация которых значительно повлияла на скорость всего Ozon. 

Читать далее

Как упростить жизнь за 312 коротких шагов: проектируем GraphQL API в микросервисной архитектуре

Level of difficultyEasy
Reading time9 min
Reach and readers15K

Звук – HiFi-сервис с большой командой инженеров. Мы используем передовые технологии и современный стек, и экспериментируем, чтобы решать сложные, нестандартные задачи. Одна из технологий  – GraphQL.

Эта статья изначально создавалась как гайд по работе с GraphQL для инженеров Звука (системные аналитики, разработчики, QA). При этом статья может быть полезна всем, кто никогда не работал с GraphQL, но очень хочет понять, зачем он может быть нужен, и как поможет решить задачу вашего бизнеса.

Читать далее

Децентрализованный поиск для свободного веба

Reading time12 min
Reach and readers12K

Возможно ли создать поисковую систему, которую тяжело подвергнуть цензуре, влиянию и блокировке?

Говоря техническим языком, возможно ли выполнять полнотекстовый поиск не имея удаленного сервера, удобным для пользователя способом, одновременно храня поисковый индекс в peer-to-peer системе и имея возможность быстро обновлять поисковый индекс?

Да, это возможно!

Под катом описание архитектуры поискового движка Summa на Rust и набора приемов, позволивших ответить утвердительно на все вопрос

Читать далее
1
23 ...