Обновить
32K+

Распределённые системы *

Нюансы проектирования распределенных систем

33,56
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

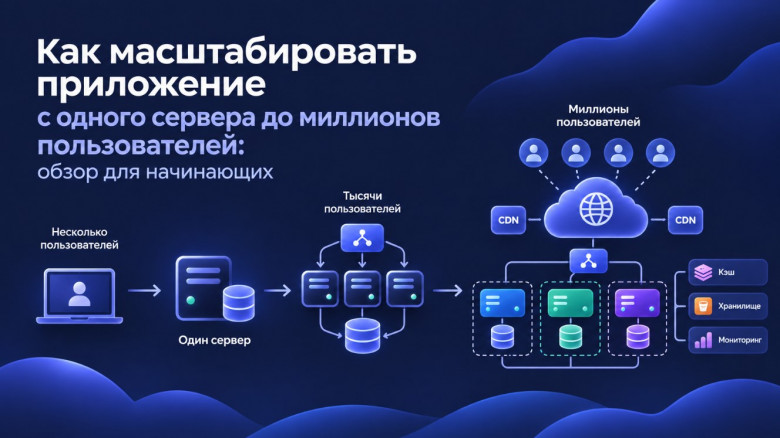
Как масштабировать приложение с одного сервера до миллионов пользователей: обзор для начинающих
Уровень сложностиСредний
Время на прочтение21 мин
Охват и читатели7.2K

В момент запуска ваш сервер может обслуживать совсем немного пользователей — вас и несколько десятков клиентов. Но если вы работаете над своим проектом долго, то постепенно растёт нагрузка: через месяц — 100 человек, через полгода — уже сто тысяч. А потом может случиться вирусный рост, и ваш сервер просто перестанет справляться с нагрузкой из-за миллионов запросов. Именно на этом переломном моменте обычный план по самому обычному деплою сервера уже перестаёт работать. База данных может начать захлёбываться, пользователи видят бесконечные экраны загрузки или, чего похуже, сообщения об ошибках, и проблемы в логике.

Проблема здесь может состоять не только в качестве кода, но и в архитектуре, рассчитанной на один сервер, которая физически не может масштабироваться для миллионов пользователей. И увы, апгрейд характеристик сервера не всегда помогает. В этой статье я расскажу о первых азах System Design — проектировании систем — для начинающих и продвинутых разработчиков, которые хотят перейти на новый уровень профессионализма. Мы пройдём путь от одного сервера до отказоустойчивой инфраструктуры, обслуживающей миллионы пользователей, с опорой на современные подходы и реальные кейсы. Вперёд!

Читать далее

Агентная система для тех, кто вкатывается: собираем агента поддержки от одного файла до Temporal, саги и circuit breaker

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели9.9K

Тысяча классификаций обращений стоит $0,23 на Claude Haiku 5.5 и $4,50 на Sonnet 5.5. Почти двадцать раз, и это не самое дорогое место в системе, где агент поддержки возвращает клиентам деньги. Дороже выходят возврат, проведённый дважды после падения воркера, сто воркеров, которые долбят упавшего провайдера модели, и крупная сумма, ушедшая без человека.

Собираем такую систему по шагам, начиная с агента в одном файле. На каждом шаге упираемся в проблему и добавляем компонент: API и базу, Temporal с его собственной базой, LLM-шлюз с circuit breaker, сагу с точкой невозврата и консоль оператора, роутер, который отдаёт агенту только спорные случаи, трейсы и outbox. Схема растёт вместе с текстом по C4, от Context до Component. В конце чек-лист из 11 пунктов: какой компонент добавлять при какой боли.

Где ставить circuit breaker

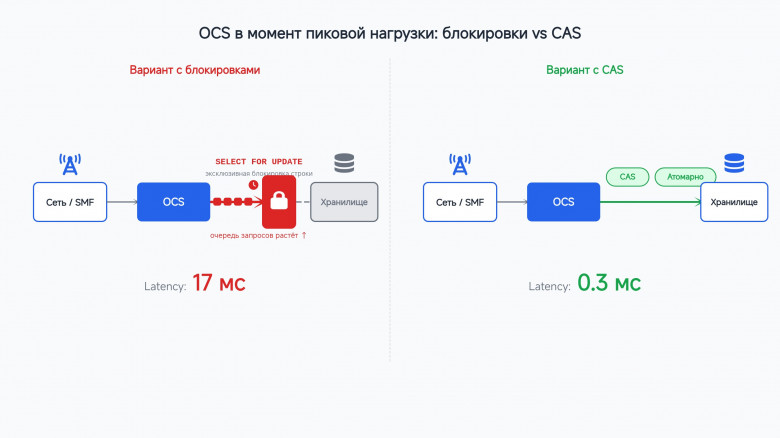
Проблематика Parallel / Multi‑service Charging в системах OCS

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели4.9K

В данной статье расскажу реальную историю которая произошла в компании которая создавала OCS который поддерживал паралельный чарджинг. Пока немного теории

Читать далее

Микросервисы становятся дорогими: как понять, что вашему проекту пока нужен монолит

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.9K

Микросервисная архитектура обещает независимые релизы и гибкое масштабирование, но вместе с ними приносит сетевые задержки, инфраструктурные расходы и дополнительную нагрузку на команду. Если границы домена ещё меняются, а разработчики пока могут работать в одном релизном цикле, декомпозиция рискует превратиться в дорогой распределённый монолит.

Разберём, по каким критериям выбирать между монолитом, модульным монолитом и микросервисами, какие скрытые издержки учитывать и в какой момент переход действительно оправдан.

Разобраться в архитектуре

AI-агент в проде для тех, кто вкатывается: инструменты, RAG, надёжность и проверки

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели13K

Агент застрял и сделал 100 ходов вместо 30. Ходов в 3,3 раза больше, а денег в 5,3 раза: каждый ход заново читает всю историю. А если процесс упал на 25-м ходе и задачу запустили с нуля, она дорожает на 81%, и все уже сделанные действия повторятся. Письмо клиенту уйдёт дважды.

Собрал практики, которые отделяют агента из демо от агента в проде. Какие инструменты давать модели и как держать контекст коротким. Когда RAG не нужен вовсе, а когда поиск по словам и переранжирование сокращают провалы с 5,7% до 1,9%. Как ограничить цикл и бюджет, какие ошибки повторять, как сделать инструмент идемпотентным, зачем Temporal и как спрашивать подтверждение у человека. Плюс наблюдаемость, проверки, защита от prompt injection и чек-лист из 13 пунктов.

Почему письмо уйдёт дважды

«Письмо отправлено». Как у нас дважды за месяц молча ломалась почта

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4.3K

Человек регистрируется в нашем сервисе, вводит почту и видит «Письмо отправлено». Ждёт код. Код не приходит. Он нажимает «отправить ещё раз», снова ждёт, потом закрывает вкладку. Мы об этом не знаем: API ответил 200, ошибок в ответах нет.

Так было с 14 сентября по 1 октября, а потом ещё раз 5 октября. Причины разные, результат один: тишина. Ниже оба сбоя с конфигами, кодом и тем, что мы поменяли.

Читать далее

Как потерять трейсинг в микросервисах (и не заметить этого)

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели8.5K

За время работы над разными проектами, в разных компаниях, я замечал одну похожую историю: все собирают трейсы, но пользы от них мало. Их просто никто не смотрит, потому что они неполные. В них буквально не видно весь путь запроса от клиента до последнего микросервиса в цепочке интеграций разных продуктов и команд в компании. В итоге на них все забивают, ищут проблемы по логам, это входит в привычку, так дальше и живут.

В этой статье я хочу рассказать, где же теряются трейсы в микросервисах и как перестать жрать кактус.

Читать далее

Self-Service Data Platform на StarRocks: 3 инженера, 25 аналитиков и 0 тестовых стендов

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели8K

Привет, Хабр! Меня зовут Виталий, я руководитель команды инженеров данных в группе компаний, которая занимается разработкой и поддержкой В2В финтех-платформы. Два года назад мы получили в свое распоряжение Oracle — с часами ожидания запросов и legacy процедурами на тысячи строк кода.

Сейчас у нас StarRocks, Airflow, dbt и 25 аналитиков, которые самостоятельно собирают витрины через Git.  Основные витрины, которые раньше строились десятки минут, теперь отдаются за секунды: по статистике за последнюю неделю 99% всех запросов укладываются в 14 секунд. При этом мы не покупали dev-кластер и не нанимали новых инженеров данных.

В статье поделюсь опытом, как мы к этому пришли. 
Будет полезно тем, кто хочет организовать производительную аналитическую платформу без увеличения инфраструктурных затрат и расширения штата.

Читать далее

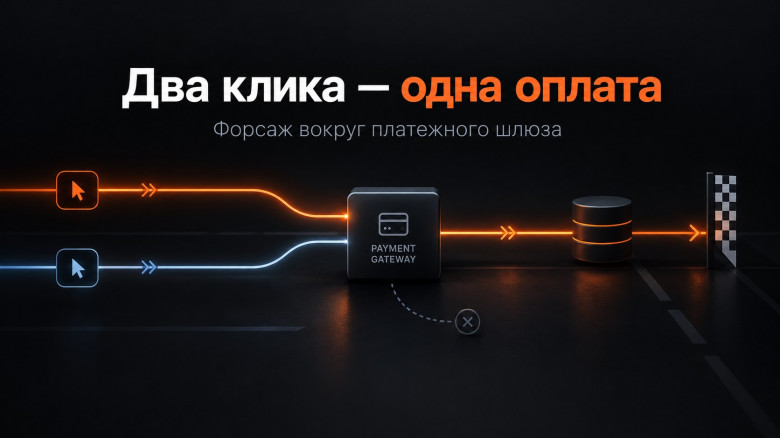
Два клика — одна оплата: Форсаж вокруг платежного шлюза

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6K

Два клика по кнопке оплаты. Два запроса к провайдеру. И внезапно один заказ превращается в две платежные сессии.

В этой статье разберём реальный кейс рефакторинга платёжной интеграции: начнём с наивного Create, попробуем локальные блокировки, столкнёмся с несколькими экземплярами сервиса и доберёмся до PostgreSQL advisory locks, идемпотентности и конкурентных Check/Cancel.

Немного C#, много PostgreSQL и чуть‑чуть «Форсажа». Посмотрим, как устроить гонку запросов так, чтобы победитель был только один.

Press W

От FaaS к PaaS: почему я построил собственный оркестратор вместо Kubernetes

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели8.8K

Раньше я уже рассказывал на Хабре об Inquir Compute, который тогда был платформой для запуска serverless-функций. С тех пор проект вырос в PaaS с поддержкой контейнерных приложений, баз данных, фоновых задач и собственной системой управления вычислительными ресурсами.

Вместо Kubernetes или Nomad я решил развивать собственный оркестратор с allocation plane, планировщиком и вычислительными раннерами на containerd. Главная причина не в желании переписать существующие инструменты, а в возможности объединить долгоживущие приложения и serverless-функции в одну ресурсную модель, напрямую связанную с жизненным циклом сервисов и тарификацией платформы.

Расскажу, как развивалась архитектура Inquir Compute, почему я считаю собственный оркестратор правильным выбором для этого проекта, какие задачи удалось решить и над чем ещё предстоит работать.

Читать далее

OpenAI: две аварии с Azure Cosmos DB. Зато чтение Habitat ускорили в 12 раз

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.2K

OpenAI ускорили чтение Habitat в 12 раз, но аварии Azure вызывают вопрос: кто отвечает за надёжность управляемого облака?

Читать далее

Как мы незаметно перемещаем десятки петабайт данных внутри S3

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели7.6K

Всем привет! Меня зовут Никита, я старший разработчик в команде Storage. Мы делаем собственное S3-совместимое хранилище в Ozon, которое уже хранит 130 PB данных. Какое-то время назад мы очень подробно рассказали почему нам перестали подходить коробочные решения, по каким критериям мы выбирали технологии для собственной реализации и с деталями описали основную схему получившегося хранилища.

Хранилище постоянно растёт, и вместе с ним появляются задачи, которых раньше просто не существовало в таком масштабе. Одна из них звучит довольно просто: как перенести огромный бакет из одной части S3 в другую, продолжая принимать запросы на чтение и запись и не заставляя пользователей вообще думать о том, что где-то идёт миграция.

Слона будем есть по частям. Чтобы понять, зачем нам понадобилось перемещать данные, сначала коротко разберём архитектуру.

Читать далее

Тренды развиваются не так, как их себе представляют Устоявшиеся тренды часто кажутся вечными, но это не так....

Охват и читатели5.1K

Тренды развиваются не так, как их себе представляют

Устоявшиеся тренды часто кажутся вечными, но это не так. Инновации, новые идеи и технологии меняют траекторию существующих трендов и создают новые.

Мальтузианская катастрофа

Томас Мальтус, философ и экономист, в 1798 году предположил, что человечество неизбежно столкнётся с катастрофой: население растёт экспоненциально, а производство продовольствия — лишь линейно. Из этого следовал мрачный вывод: рано или поздно людей станет больше, чем способна прокормить земля, а значит, мир ждут голод, болезни, войны и массовая преждевременная смерть. Ошибка Мальтуса заключалась не в логике, а в том, что он не мог предвидеть промышленную революцию и последующий технологический переворот в сельском хозяйстве — от железного плуга и удобрений до селекции, механизации и новых способов хранения пищи. Именно эти изменения позволили резко увеличить урожайность и отсрочить предсказанную им развязку. До сих пор мальтузианская катастрофа не наступила, хотя вопрос о границах роста человечества по-прежнему остаётся открытым. Главный урок здесь в другом: даже самые устойчивые и долгосрочные тренды могут измениться, если в игру вступают технологии.

Читать дальше →

Ближайшие события

Почему Idempotency‑Key не спасает от двойного списания и как это исправить

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.3K

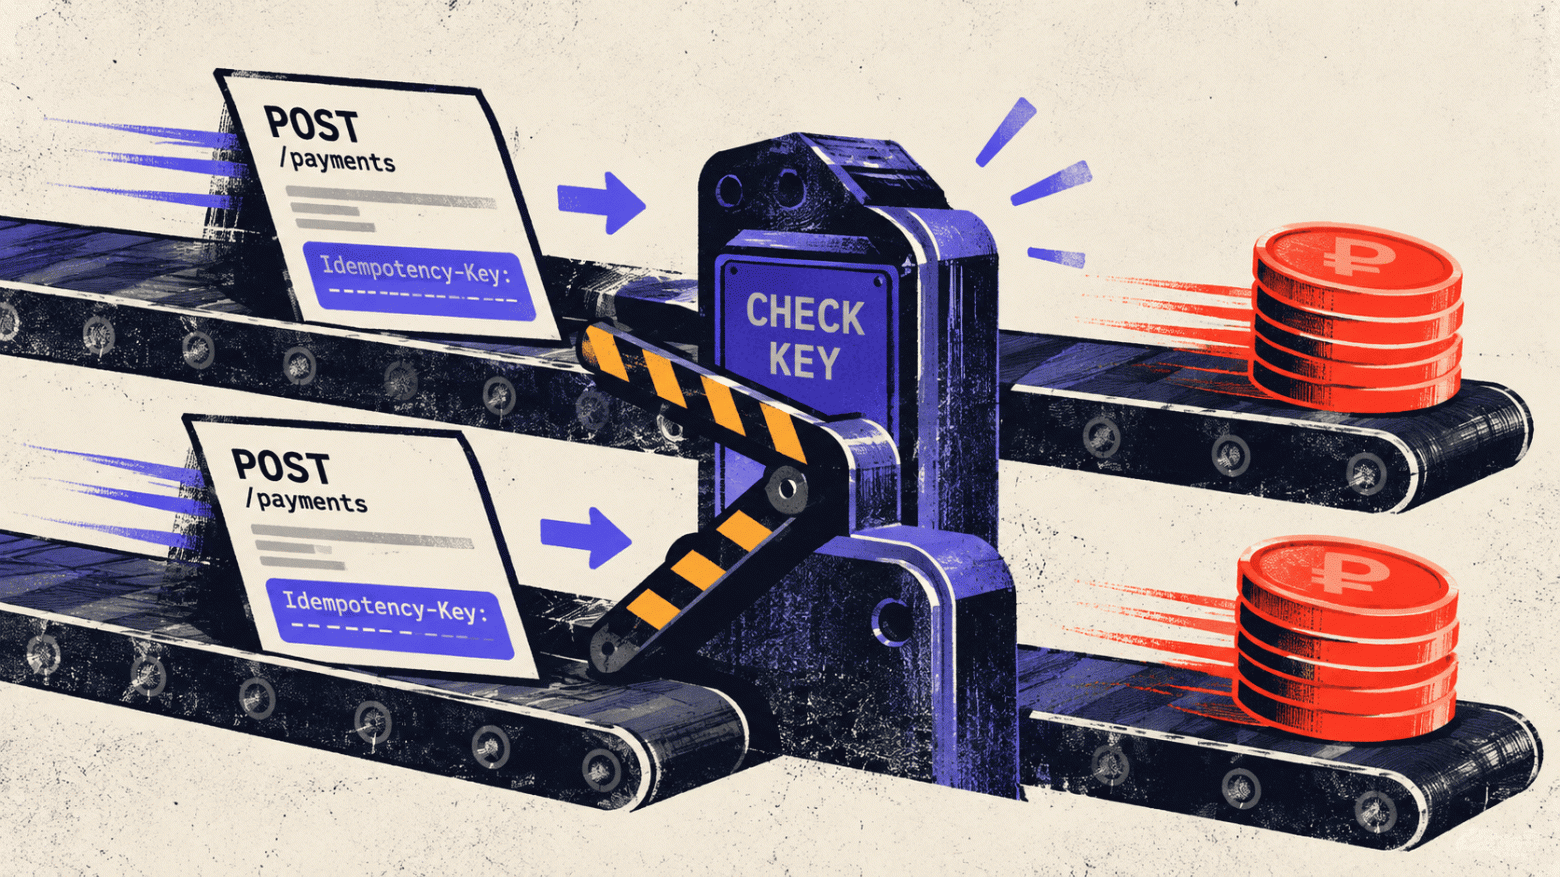
Клиент отправил платёж, не дождался ответа и повторил запрос. На сервере предусмотрен Idempotency-Key, тесты проходят, но деньги всё равно списываются дважды. Проблема возникает, когда второй запрос приходит до завершения первого: оба обработчика успевают проверить ключ и запустить оплату.

Разберём, как закрыть эту гонку с помощью PostgreSQL, что делать при падении процесса и почему даже правильно реализованная идемпотентность внутри сервиса не всегда спасает от повторного списания.

Разобрать решение

Как fan-out создаёт хвост задержек: эксперимент с параллельными вызовами сервисов

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.3K

Каждый сервис отвечает быстро, запросы выполняются параллельно, но итоговый ответ всё равно не укладывается в SLA. Причина может быть в самом количестве зависимостей: чем их больше, тем выше вероятность дождаться хотя бы одного медленного ответа. На примере карточки товара разберём, как fan-out влияет на хвостовые задержки, почему растёт p99 и какой ценой можно ускорить ответ, ограничив ожидание необязательных данных.

Разобрать эксперимент

Kafka и ребалансинг: что можно сделать до возникновения проблемы

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели7.2K

Ребалансинг в Kafka — не самая популярная и местами не самая понятная тема. Обычно о нём вспоминают только тогда, когда consumer начинает отставать, обработка останавливается, а группа уходит в бесконечные ребалансы.

В этой статье попробую простым языком разобраться, почему это происходит, какие проблемы могут к этому привести и что можно сделать, чтобы минимизировать частые ребалансировки.

Узнать больше

Два сервиса писали в один ключ Redis одно и то же. Это и было опасно

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.2K

Переводя сервис прогнозов на общий Redis, я увидел в чужой базе ключ current_occupancy_cache и обнаружил, что ровно такой же пишет мой сервис. Развёл по разным номерам баз. Сегодня полез проверять эту историю и выяснил две вещи. Во-первых, коллизия стала невозможна через два дня сама по себе: мультигородность добавила ключу суффикс :city, и ни в одном коммите той фичи сервис прогнозов не упоминается. Во-вторых, и это интереснее, на тот день обе записи были одинаковыми поле в поле. То есть затирание прошло бы совершенно корректно, без ошибки и без строчки в логе. Опасным оно стало бы четырьмя днями позже, когда в одну из записей добавили has_live_data, а на фронте стоит ?? true. Про то, почему совпадение данных это не свойство системы, а след копипасты, и почему разводить общие пространства имён надо до того, как данные разъехались.

Читать далее

NATS: архитектура, модель работы и области применения

Время на прочтение15 мин
Охват и читатели6.6K

Всем привет! Я Алексей Трофимов, .NET-разработчик в компании МУЛЬТИФАКТОР. Попал сюда как раз в тот момент, когда команда заканчивала переход на NATS. В этой статье я расскажу, как устроен NATS и в каких сценариях стоит его выбирать.

Читать далее

Thyron — плеер, которому не нужен ЦОД

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели5K

Меня давно раздражали лаги в стримингах и постоянные редизайны, когда ты не понимаешь, как теперь всё работает, а иногда оно и не работает вовсе. Отдельно раздражает, когда заходишь в лифт, а «скачанный» трек почему-то не включается. Ну и отсутствие каких-либо треков или их удаление из твоего же плейлиста. Я устал собирать годами плейлисты, чтобы потом они оказались выкошены под ноль. Мне не нужны концерты и фотки артистов, криво прилепленные к карточкам. Не нужны нейрослоп и реклама даже в платном продукте. Я просто хочу слушать музыку.

Читать далее

HurriCache: как мы подружили строгую типизацию с RESP‑коннектором

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.3K

Спустя некоторое время экспериментов с HurriCache я пришёл к важному выводу: чтобы существующие проекты могли попробовать решение с минимумом изменений, нужен способ быстрого входа без переписывания кода.

Строгая типизация в HurriCache — осознанный выбор. Мы явно создаём скаляры (целые числа, числа с плавающей точкой, байтовые массивы) и контейнеры (List, Vector, Queue, OrderedSet, HashSet, SortedMap, HashMap) без ленивого приведения типов. Это даёт предсказуемость поведения и контроль над памятью, но повышает порог входа: нельзя просто взять и «подставить» HurriCache вместо Redis, не меняя семантику работы с данными.

Чтобы решить эту проблему, мы добавили RESP‑коннектор, совместимый с Redis‑клиентами. И сразу столкнулись с фундаментальными различиями моделей данных: то, что в Redis «просто строка», в HurriCache требует явного типа и стратегии создания.

Читать далее
1
23 ...