Обновить
64K+

Обработка изображений *

Работаем с фото и видео

149,47
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

«LLM без OCR в обработке документов не работает»: как «АльфаСтрахование» построила IDP-оркестратор с ИИ Smart Engines
Уровень сложностиПростой
Время чтения11 мин
Охват и читатели4.8K

Ежегодно «АльфаСтрахование» обрабатывает порядка 40 млн документов. За последние десять лет компания прошла путь от потокового сканирования и распознавания штрихкодов до собственной платформы интеллектуальной обработки документов (IDP), объединяющей OCR, машинное обучение и большие языковые модели. Сегодня эти технологии помогают автоматизировать десятки бизнес-процессов, справляться с растущими объемами документов без расширения штата и обеспечивать экономический эффект в десятки миллионов рублей.

О том, как менялись задачи автоматизации документооборота, почему LLM не заменяют классические технологии распознавания и какую роль в этом процессе играют решения Smart Engines, мы поговорили с Натальей Корецкой, директором операционного департамента «АльфаСтрахование».

Посмотреть запись открытого диалога можно здесь.

Читать далее

Вышло обновление RapidRAW 1.7.0 — открытого редактора изображений RAW

Время чтения3 мин
Охват и читатели9.6K

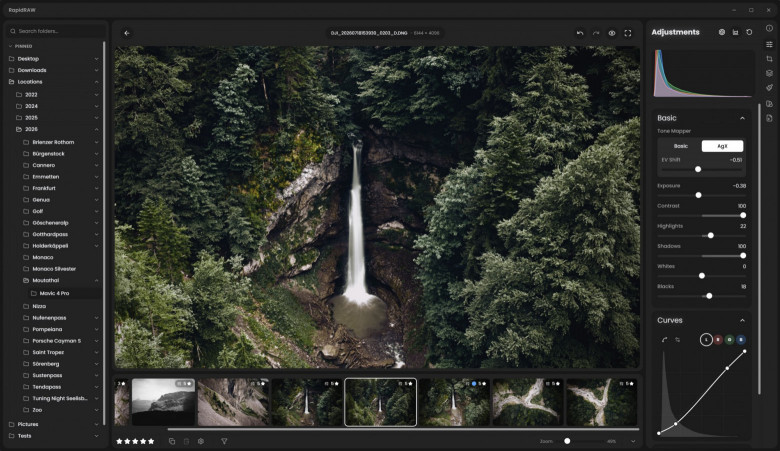
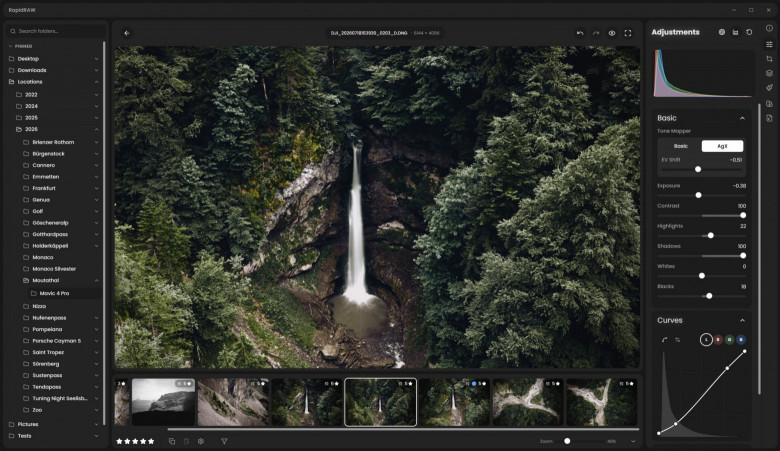
Состоялся выпуск обновления открытого мультиплатформенного редактора изображений RapidRAW 1.7.0. Проект предлагает простой способ обработки изображений RAW с помощью GPU. Решение использует лёгкую (~30 МБ) и эффективную кодовую базу, созданную на основе Rust, React и Tauri.

Читать далее

KandiShop: как за считанные секунды получить узнаваемые лица и читаемый текст на любых ИИ‑изображениях

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели6.7K

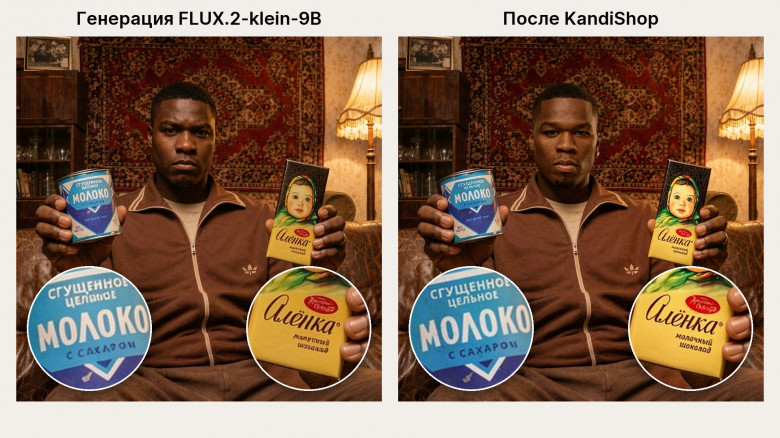
Современные генеративные модели уже умеют по одной фотографии поместить человека или товар в любую сцену. Но присмотритесь: лицо получилось «почти» тем, а мелкий текст на упаковке превратился в набор похожих на буквы закорючек.

На связи команды Контролируемого генеративного ИИ и Генерации видео AIRI. В этой статье мы расскажем, откуда берется эта проблема и как мы её решили с помощью нашего нового метода KandiShop — без единого шага обучения.

Читать далее

От картинки к релевантной странице: исследование мультимодальных эмбеддингов

Уровень сложностиПростой
Время чтения32 мин
Охват и читатели6.1K

Всем привет! Я Артем, Data Scientist в Raft Digital Solutions. Недавно я гонял три мультимодальных эмбеддера на сканах, таблицах и графиках. Расскажу, что в них можно настроить, что это даёт в качестве поиска и что отнимает: время, память GPU и место в индексе.

Начну с задачи. У вас тысячи сканов: договоры, счета, письма, отчёты. Сотрудник спрашивает: «В каком договоре штраф за просрочку 0,1% в день?» Система должна найти нужную страницу...

Читать далее

«Хаусфишинг»: как мошенники приукрашивают фотографии недвижимости с помощью ИИ

Время чтения2 мин
Охват и читатели7.6K

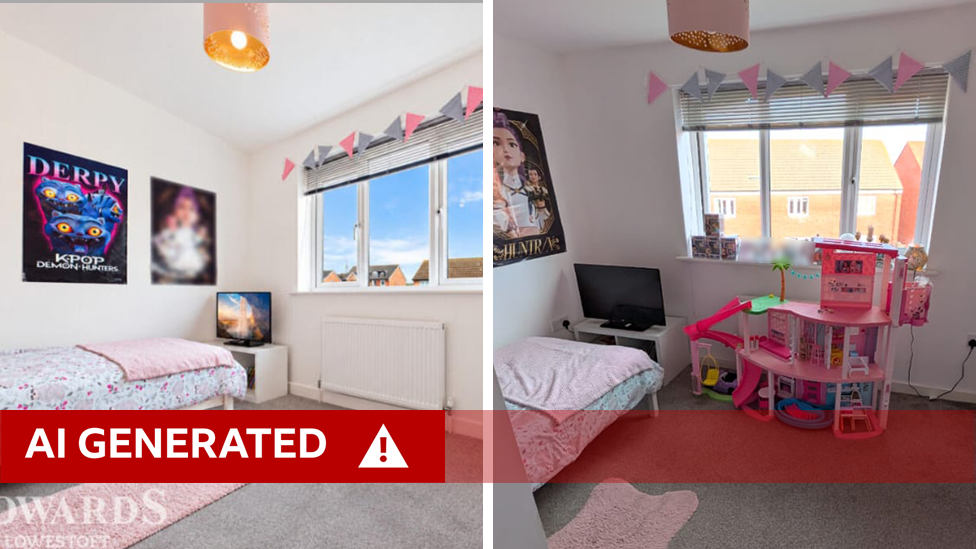
По данным BBC, в Великобритании набирает обороты так называемый «хаусфишинг» (housefishing) — практика, при которой продавцы недвижимости при помощи ИИ редактируют (или вовсе подменяют) фото объекта. Термин образован по аналогии с «кетфишингом» (catfishing) — созданием фейкового образа в соцсетях для обмана других людей.

Читать далее

Релиз открытого проекта PaintFE 1.5 — портативного редактора изображений для Windows и macOS

Время чтения3 мин
Охват и читатели9.9K

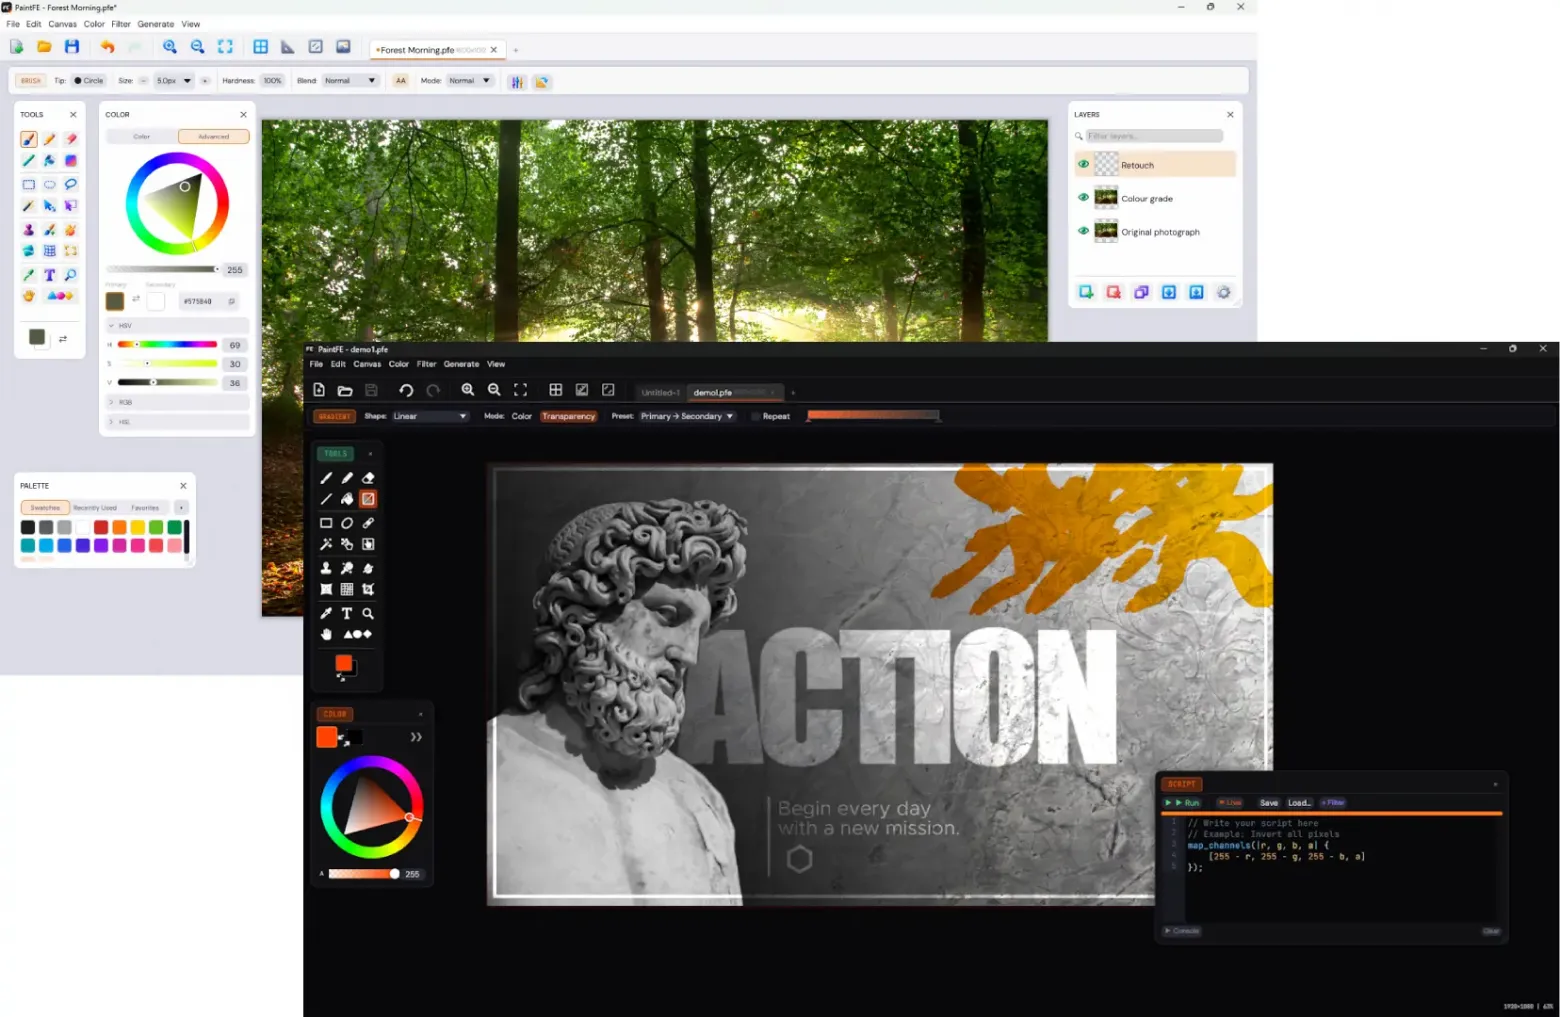
В середине ноября 2026 года разработчик Кайл Джексон представил обновление открытого проекта PaintFE 1.5.0 (Fе — это символ железа в периодической таблице, отсылка к каламбуру про Rust). Это портативный редактор изображений для Linux, Windows и macOS со слоями, градиентами, режимами наложения, фильтрами с поддержкой работы с GPU, скриптами и поддержкой анимированных GIF/APNG. Исходный код решения написан на Rust и опубликован на GitHub под лицензией MIT. Версия PaintFE 1.0 вышла в феврале 2026 года.

Читать далее

sd.cpp вместо Forge Neo: что умеют девять моделей на 16 и 8 ГБ

Уровень сложностиПростой
Время чтения10 мин
Охват и читатели7.2K

Stable-diffusion.cpp: один бинарник на C++ вместо гигабайтов Python, модели в GGUF под 8 и 16 ГБ видеопамяти. Заодно сравнил девять локальных моделей на одних и тех же промптах — скорость, быстрый режим. Внутри таблица замеров и примеры картинок от каждой модели.

Читать далее

Месть за голосовые: генерирую видео с печатающими руками прямо в браузере

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели22K

У меня есть друзья, которые присылают голосовые на три минуты. Содержание обычно умещается в одно предложение, но чтобы его достать, нужно прослушать «короче, слушай, тут такое дело…». Голосовое не пробежишь глазами, на созвоне его не включишь, а ночью рядом со спящим человеком тем более.

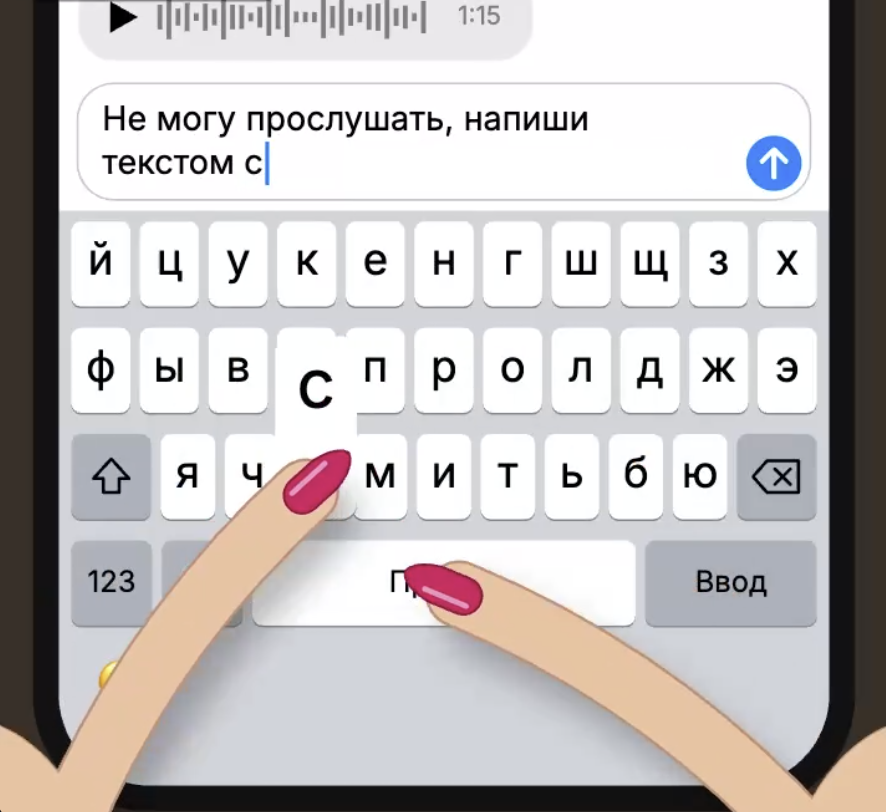
В какой-то момент я решил ответить им так же неудобно. Получился pleasejusttext.me: пишешь ответ текстом, а на выходе MP4, где мультяшные руки не спеша набирают его на телефоне. Меня заставили слушать, пусть теперь смотрят.

Как это устроено

Почему «momentum»-сэмплер для ComfyUI рисует синюю кляксу на flow-модели и какой momentum на самом деле помогает

Время чтения4 мин
Охват и читатели6.5K

Почему «momentum»-сэмплер для ComfyUI рисует синюю кляксу на flow-модели и какой momentum на самом деле помогает

Читать далее

Тусмав, он же Густав: как я с ИИ писал каталог домашней библиотеки

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели7K

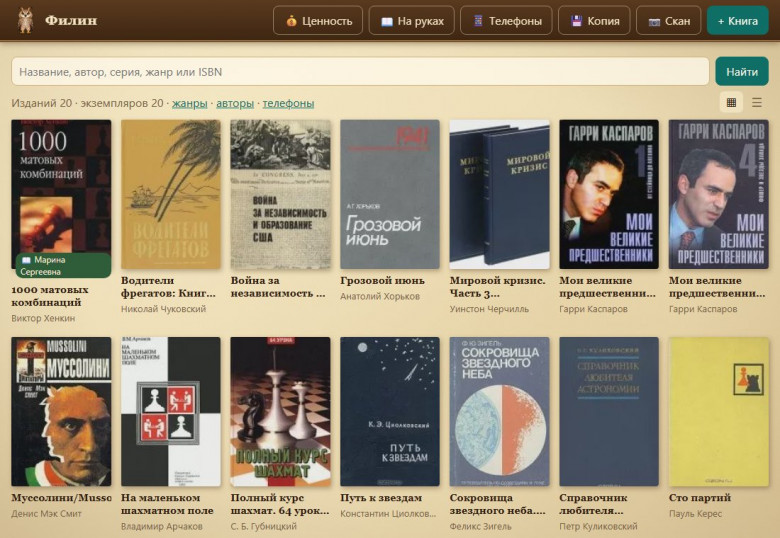
Отец собирал книги, а я однажды понял, что покупаю те, которые уже стоят дома. Так появился «Филин» — каталог домашней библиотеки со сканером на телефоне. Со штрихкодами всё пошло быстро, а на советском титульном листе программа прочитала «Густав» как «Тусмав» и записала «Руку» в соавторы.

Читать далее

Выпуск открытой платформы для самостоятельного хранения и управления фото и видео Immich 3.4

Время чтения3 мин
Охват и читатели7.8K

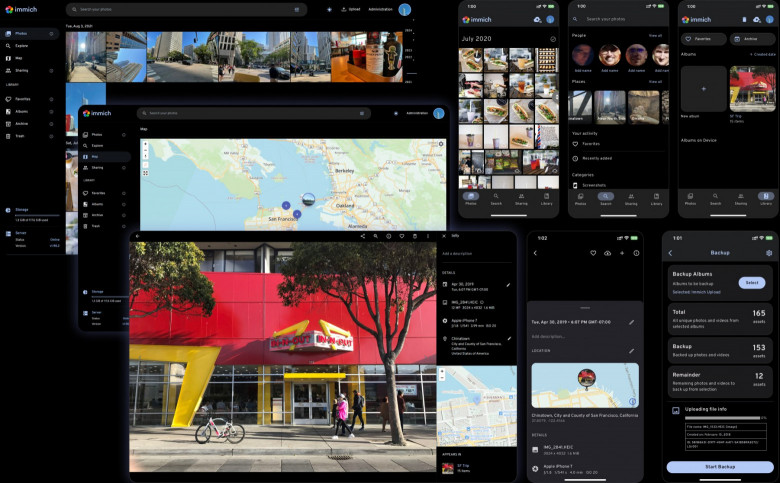
Состоялся выпуск обновления открытой платформы для самостоятельного хранения и управления фото и видео Immich 3.4. Проект находится в разработке с начала 2022 года и опубликован на GitHub под лицензией GNU Affero General Public License v3.0.

Читать далее

Как я оживил картину XIX века: Photoshop, локальная LLM, MiniMax H3 и After Effects

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели8K

В этой статье мы рассмотрим можно ли взять историческую картину XIX века и превратить её в полноценную анимированную сцену - так, чтобы композиция, стиль и положение персонажей остались на своих местах. Основные инструменты про которые будет идти речь: Adobe Photoshop для разбора картины, локальная мультимодальная модель Qwen 3.8 27B Q5_K_XL через LM Studio для подготовки промтов, видеогенерация MiniMax H3 в ComfyUI и финальный композитинг в After Effects.

Исходник - произведение Лоуренса Альма-Тадемы "Anno 1812. Kapitein Benthien aan de Beresina" (также известно как The Crossing of the River Berezina - 1812). Ссылка на оригинал

Небольшая оговорка в начале: задача была не в том, чтобы закинуть картину в видеогенератор и получить какое-нибудь движение. Я хотел разобрать изображение на независимые элементы, подготовить каждого персонажа по отдельности, восстановить то, что было скрыто за ними, а потом анимировать фрагменты и собрать всё обратно в одну композицию.

Видео с полным процессом и финальным результатом: https://youtu.be/kedgNXEFHJs?si=XcYYtQ0vVzd9CNhY (YOUTUBE-ВИДЕО, продолжительность 10:41)

Источник и лицензия

Картина Альма-Тадемы посвящена ноябрю 1812 года - переправе через Березину во время отступления армии Наполеона. На ней голландские понтонёры под командованием капитана Бентьена строят переправу: люди, деревянные конструкции, вода, лёд, мосты и куча мелких деталей, из которых складывается вся историческая сцена.

Оригинал хранится в Amsterdam Museum (инвентарный номер SA 4857). Цифровая репродукция лежит на Wikimedia Commons под лицензией Public Domain Mark 1.0 - так что работать с ней можно свободно.

Читать далее

Сметчик завода считал КП целый рабочий день. Мы свели это к 30 секундам: почему ChatGPT тут бесполезен

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели11K

Снабженец строительного объекта отправляет ведомость металлопроката одновременно в 4-5 заводов и заказывает у того, кто первым прислал точный расчет. На производстве инженер-сметчик тратит от 4 до 8 часов на ручной перенос номенклатуры и сверку коэффициентов по бумажным справочникам ГОСТ.

Популярная идея «скормить скан ведомости в ChatGPT» на реальном заказе ведет к прямому кассовому разрыву: при расчете партии швеллера 16П модель ошиблась в массе на 41% в минус, что дает 126 720 рублей чистого убытка на одной строке.

В статье разбираем трехслойную архитектуру решения: как подружить нечеткий семантический парсинг сканов (OpenCV + Vision API) с детерминированным расчетным ядром на Python

Читать далее

Ближайшие события

По косточкам: что видео финиша расскажет о бегуне

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели13K

Можно ли предсказать результат на 10 км по двум шагам бегуна? По тысяче финишных видео с забегов сравниваем движения быстрых и медленных участников.

Читать далее

Универсальный ридер кодов libscanner‑unir против zxing‑cpp, ZBar и OpenCV на 6900 снимках из открытых наборов

Уровень сложностиСредний
Время чтения22 мин
Охват и читатели11K

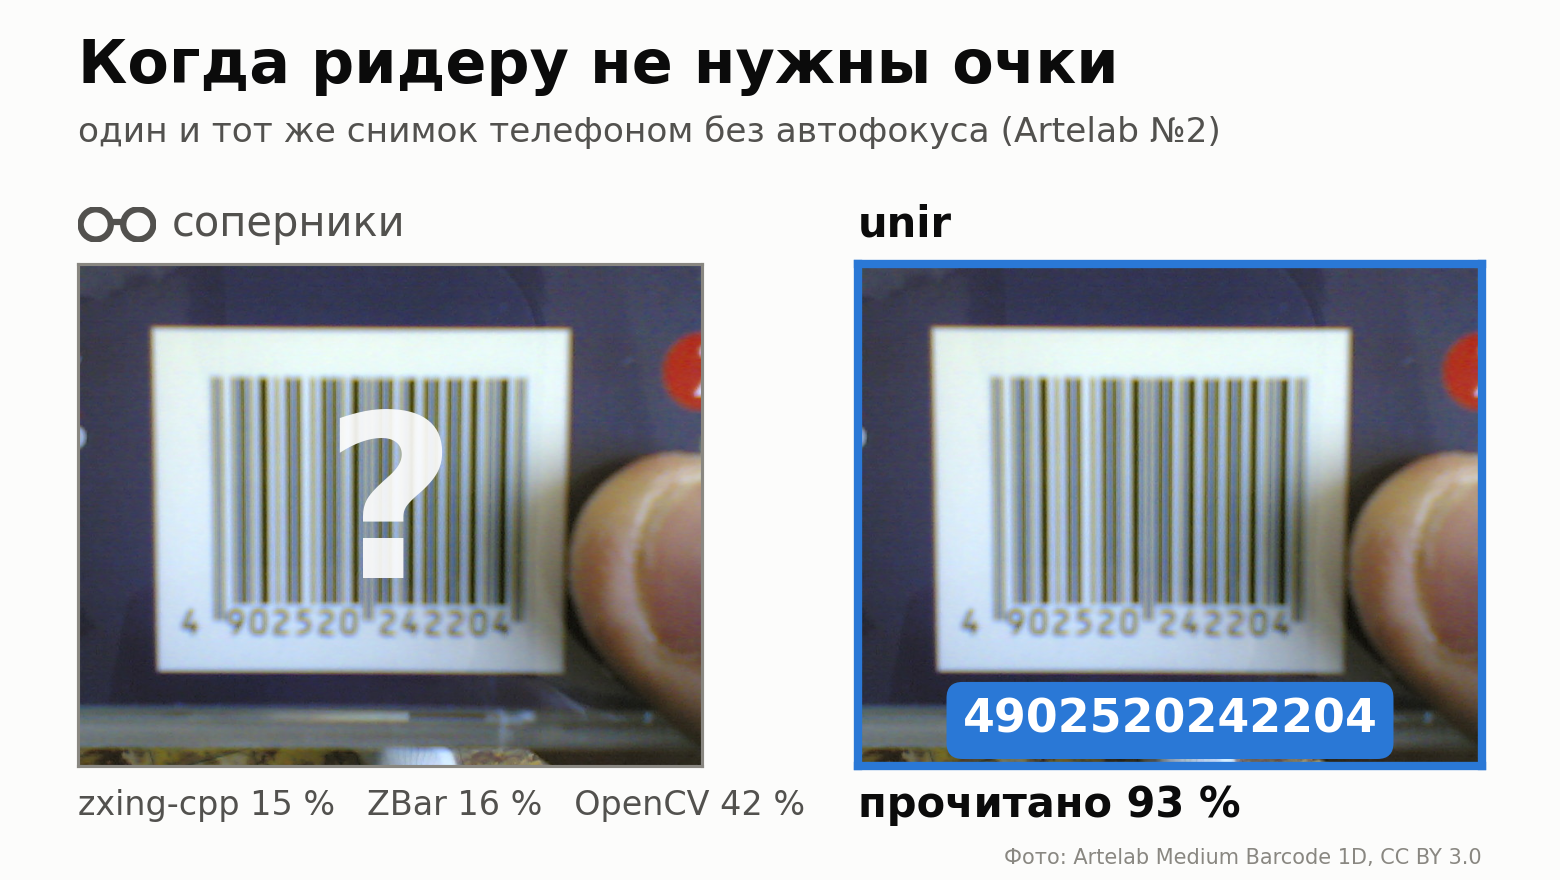
EAN-13 на пачке, сфотографированной телефоном без автофокуса. Code 128 на коробке под углом, SSCC на паллетной этикетке, которая проезжает под камерой конвейера. Мы сравнили, как такие снимки читают zxing-cpp, ZBar, OpenCV и движок линейных штрихкодов нашего универсального ридера кодов (unir). Снимки — из открытых наборов с чужой разметкой, их может скачать любой, и любую цифру можно проверить.

Коротко:

Всего прочитано: unir — 72 % из 6899 штрихкодов, ZBar — 56 %, zxing-cpp — 54 %, OpenCV — 42 %.

Главная разница — на размытых снимках. На наборе Artelab-2 unir читает 93 %, соперники — от 15 до 42 %.

Ложных чтений нет у unir, zxing-cpp и ZBar на 4231 снимке без кода; у OpenCV — 7.

По скорости ридеры почти равны: на обычном снимке у всех, кроме ZBar, 10–20 мс. Если на кадр дано 60 мс, чёткие коды все читают почти одинаково, а трудные — только unir.

Слабое место unir: на снимке, который он не может прочитать, он долго перебирает варианты. И часть кодов соперники читают, а он нет — о них ниже.

Читать далее

Google изменила сохранение правок в «Google Фото» на Android

Время чтения1 мин
Охват и читатели6K

Google внедрила новый механизм сохранения правок в «Google Фото» на Android. Теперь отредактированный снимок больше не будет появляться в галерее отдельной копией.

Читать далее

Поиск по визуалу: дообучаем ColPali и ColQwen3 на русский домен, сравниваем текстовый и мультимодальный ретрив

Время чтения9 мин
Охват и читатели6K

Привет, Хабр! Мы — Роман Макеев из X5 Tech и Егор Мачнев из Т-Банка — работали над поиском по документам с таблицами, графиками и сложной вёрсткой. Чтобы адаптировать визуальные поисковые модели к нужной предметной области, мы разработали методологию подготовки обучающих данных: берём документы и автоматически генерируем и проверяем запросы к их страницам. Составлять обучающие запросы вручную не нужно. В статье расскажем об этом процессе и сравнении с текстовым поиском. На закрытом корпусе X5-private, который не участвовал в обучении, дообученная ColQwen3-2B получила 0,84 nDCG@5 против 0,77 у лучшей текстовой модели.

Читать далее

Бесплатный сигнал кривизны для сэмплеров flow matching: он предсказывает ошибку

Время чтения6 мин
Охват и читатели11K

Бесплатный сигнал кривизны для сэмплеров flow matching: он предсказывает ошибку, но работу делает статическая сетка шагов

Читать далее

Дело не в языке: как открытые модели для ComfyUI понимают русский промпт

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели8K

«Пять жёлтых резиновых уточек плавают в ванне». По этой фразе FLUX.2 klein 4B нарисовала в ванне жёлтые палочки, причём дважды, с двумя разными сидами. SD-Turbo выдала вид на город сверху: крыши, жёлтые кроны деревьев и что-то похожее на стадион. По-английски обе модели уточек нарисовали.

Я прогнал 12 русских промптов с подвохами через пять открытых моделей и посмотрел, где они ломаются, что помогает без переводчика и когда переводчик в графе ComfyUI всё-таки нужен.

Читать далее

Вышло обновление RapidRAW 1.6.9 — открытого редактора изображений RAW

Время чтения3 мин
Охват и читатели7.4K

Состоялся выпуск обновления открытого мультиплатформенного редактора изображений RapidRAW 1.6.9. Проект предлагает простой способ обработки изображений RAW с помощью GPU. Решение использует лёгкую (~30 МБ) и эффективную кодовую базу, созданную на основе Rust, React и Tauri.

Читать далее
1
23 ...