Обновить

Администрирование

Сначала показывать
Порог рейтинга
Уровень сложности

Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1
Время на прочтение15 мин
Охват и читатели14K

Disclaimer: статья проверена по документации и репозиторию Uncloud для стабильной версии v0.20.0. Проект активно развивается, поэтому отдельные CLI-команды и Compose-возможности могут меняться между релизами.

Как всегда, всё начинается со специфического запроса от Заказчика: «Мы хотим забыть Kubernetes как страшный сон и вернуться к Docker Compose!».

На этом месте, наверное, многие DevOps-инженеры с пониманием улыбнутся. 

Но после ещё было: «Только, пожалуйста, сделайте так, чтобы было возможно масштабирование. И ещё бесшовное обновление приложений! Но чтобы остался Docker Compose».

В этот момент становится понятно, что задача перестает быть тривиальной.

А если оставить Docker Compose, но добавить к нему часть возможностей, ради которых в подобных сценариях начинают рассматривать Kubernetes? Оказывается, можно. Есть целый класс промежуточных решений: Docker Swarm, Nomad, Kamal, различные PaaS-инструменты, собственные deployment-скрипты. И еще — Uncloud.

Читать далее

Бэкап SQLite прошёл integrity_check, но потерял 90% данных: проверяю пять способов копирования

Время на прочтение10 мин
Охват и читатели5.7K

Для небольшого проекта мне понадобилось настроить резервное копирование SQLite. База используется постоянно, останавливать приложение ради каждого бэкапа не хотелось. При этом копия должна сохранять все подтвержденные транзакции. Я рассматривала несколько вариантов: обычное копирование файлов, SQLite Backup API и VACUUM INTO.

Я начала с самого простого способа — скопировать только app.db. В скрипте для этого использовалась функция shutil.copy2(), то есть обычное файловое копирование. Копия создалась без ошибок, а проверка PRAGMA integrity_check вернула ok. Однако из ста подтвержденных заказов в копии оказалось только десять.

Читать далее

Как рабочее место оторвалось от «железа»: история VDI через призму технологий, компаний и людей. Часть 2

Время на прочтение16 мин
Охват и читатели6.3K

Во второй части история подходит непосредственно к VDI. Первая часть закончилась на терминальных серверах середины 1990-х: приложения вернулись на сервер, но каждый пользователь по-прежнему делил одну операционную систему с остальными. Разберемся, почему терминальных серверов оказалось недостаточно, как VMware научила x86 делать то, для чего эта архитектура вообще не проектировалась. Также рассмотрим, как из экспериментов заказчиков вырос отдельный класс виртуальных рабочих мест и почему его судьбу в итоге определили не только гипервизоры, но и протоколы удаленного доступа, BYOD, облака и пандемия.

Читать далее

Форма, таблица и канбан без ручного переноса: тестируем MWS Tables

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.9K

Мы все знакомы с болью огромного количества сервисов для организации рабочих процессов, и полуручного переноса данных из одного сервиса в другой. Кроме основной работы там вырастает дополнительная — проблемы рассинхронизации и дублирования данных. Очень сложно поддерживать единство данных в разных местах, и ошибки неизбежны.

Сегодня я проверю, можно ли с помощью MWS Tables полностью синхронизировать форму заявок, таблицу их хранения/контроля и таск-трекер в едином сервисе (спойлер: можно). 

Читать далее

Вы восстановили взломанный Proxmox из бэкапа. А атакующий уже снова внутри

Время на прочтение18 мин
Охват и читатели6.7K

Почти детектив: как в августе‑сентябре 2026 года массово взламывали гипервизоры Proxmox VE, прятали майнеры даже от root‑а, исправляли уязвимости на захваченных серверах и возвращались после восстановления инфраструктуры.

7 сентября 2026 года хостинг‑провайдер Netfront завершил восстановление кластера из 22 гипервизоров Proxmox VE. За предыдущую неделю злоумышленники получили административный доступ к серверам, внедрили руткиты, установили майнеры и проникли внутрь клиентских виртуальных машин. Администраторы восстанавливали системы из резервных копий, меняли пароли и SSH‑ключи, проверяли целостность файлов. После нескольких суток работы инфраструктуру наконец вернули клиентам.

За время расследования выяснилось, что на серверах побывали атакующие с как минимум тридцати трёх разных внешних IP‑адресов. Одни атакующие последовательно обходили узлы кластера, другие выполняли тысячи команд, третьи устанавливали средства скрытого доступа. На части гипервизоров системные утилиты перестали нормально работать: top аварийно завершался, команды зависали, а load average достигал 160 при отсутствии соответствующей вычислительной нагрузки.

В общем, администраторы Netfront не спали почти неделю, восстанавливая всё и вся. Однако вечером 7 сентября, вскоре после объявления о восстановлении инфраструктуры, злоумышленники снова вошли в кластер. В 20:31 началась новая подозрительная активность, а в 22:22 неизвестный пользователь запросил расписание резервного копирования и сразу после этого — список виртуальных машин, для которых резервное копирование не настроено. Позднее выяснилось, что атакующие заранее создали десятки API‑токенов и дополнительные учётные записи. Эти механизмы доступа сохранились в общей конфигурации кластера и пережили восстановление всех 22 серверов.

Такие дела, собачка!

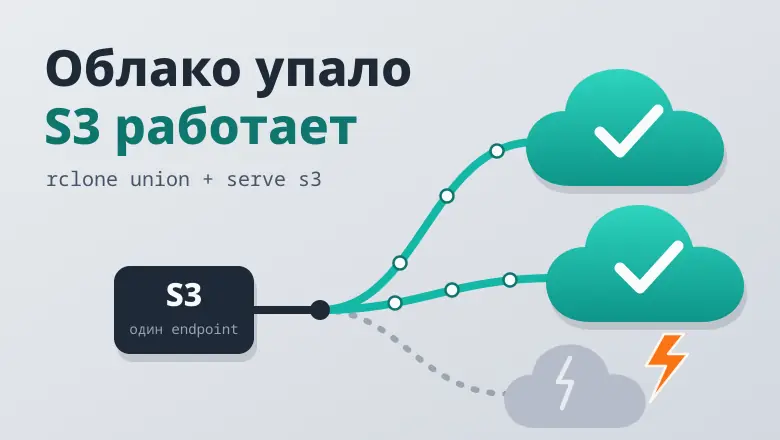
Переезд S3 без простоя и без привязки к одному облаку: rclone union + serve s3 на практике

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели7.4K

«Три зоны доступности» внутри одного облака не спасают, когда отказывает само облако. Собираем S3, который переживает отказ провайдера: один endpoint для приложения, за ним несколько облаков, переезд без простоя и без правок в коде. Всё на rclone — union, combine и serve s3. Два режима: старое облако работает или после аварии отдаёт данные только на чтение.

Читать далее

7 шагов для подготовки инфраструктуры к высоким нагрузкам, атакам и сбоям

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели2.5K

Подробный чек-лист, чтобы проверить, готова ли ваша инфраструктура к форс-мажорам.

Когда ИТ-инфраструктура даёт сбой, последствия ощущает весь бизнес: клиенты не могут оплатить заказ или воспользоваться услугой, сотрудники — получить доступ к рабочим системам. Причиной может стать высокая нагрузка, кибератака или отказ оборудования. 

Меня зовут Никита Демянчук, я руковожу группой технического взаимодействия с клиентами EdgeCenter. В этой статье разберу семь шагов, которые помогут проверить готовность инфраструктуры: найти слабые места, выбрать подходящие меры защиты и подготовиться к восстановлению после сбоя.

Читать далее

Сгенерировал сервис, а где его хостить и сколько это стоит

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели13K

«Вайбкодинг» стал словом 2025 года, а каждый второй, мне кажется, стал вайбкодером именно в 2026 году. Codex, Claude Code, Cursor и даже KIMI за вечер могут написать тебе красивый и полезный сервис. Осталась ерунда — повесить его куда-то, чтобы работал и им могли пользоваться другие. Авось людям пригодится и денег принесёт... Под катом разберу, куда нести ваш классный пет-проект.

Читать

Грабли Microsoft 365, о которые я споткнулся, пока делал «админку поверх админки»

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.9K

Админка Microsoft 365 и Graph не умеют главного — показать, что изменится, до того как изменится. Я делаю открытую утилиту, где любое действие сначала строит план «было → станет» и только потом применяет его, будь то Graph, Exchange PowerShell или LDAP. Вышла версия 2.0.

В статье — не обзор кнопок, а грабли, о которые пришлось споткнуться: Exchange PowerShell, который не работает на Mac, откат Conditional Access и Intune к снимку (где Intune подсовывает маски вместо секретов), и как запускать чужие PowerShell‑скрипты с админским токеном, не отдавая им всё.

Читать далее

Почему раньше Windows переустанавливали каждые полгода, а теперь можно годами жить на одной

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели8.3K

Когда-то Windows была для компьютеров чем-то вроде расходника. Проходило от нескольких месяцев до года, система забивалась мусором, начинала безжалостно тормозить, и кто-нибудь из знакомых обязательно нам советовал «просто переставить винду». Ну, мы и переставляли. Да и что было делать? Многие вообще превращали это в ежеквартальный ритуал просто на всякий случай. Но прошли годы, Windows сменила несколько итераций, и необходимость переустанавливать ее как по расписанию куда-то пропала. Не сказать, конечно, что кто-то из-за этого сильно расстроился. Просто интересно, что вдруг изменилось? Об этом сегодня и поговорим.

Читать далее

Собираем домашний сервер для локальных LLM на доступных GPU (NVIDIA CMP 50HX)

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели92K

Привет! Меня зовут Александр Щербаков, я DevOps-инженер в X5 Tech. В одной из прошлых статей я рассказывал о домашних серверах на потребительском железе. Сегодня поговорим о том, как моя лаборатория доросла до серверной платформы и двух CMP 50HX с 20 ГБ видеопамяти каждая.

С локальными LLM я пока разбираюсь и хочу поделиться тем, что получилось: от покупки карт и неудачного первого запуска до настройки сервера и замеров. Кому интересна такая затея — добро пожаловать под кат.

Читать далее

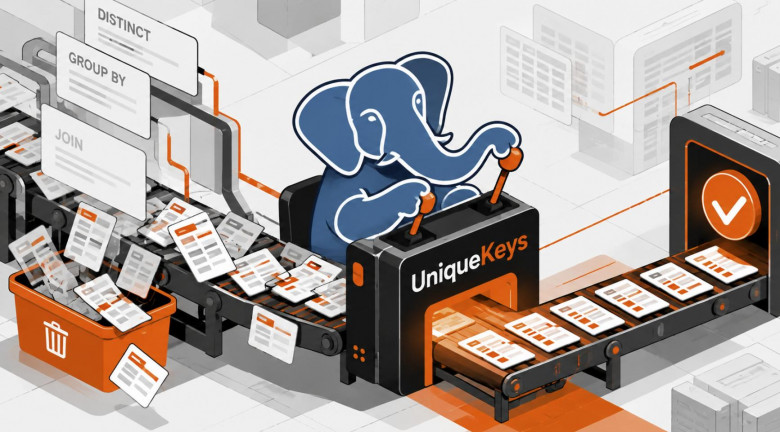
UniqueKeys — планировщик PostgreSQL учится помнить, где строки уникальны

Время на прочтение11 мин
Охват и читатели8.4K

Патч UniqueKeys для PostgreSQL предлагает научить планировщик распознавать случаи, когда строки запроса уже гарантированно уникальны. Сейчас он (планировщик) не всегда может это определить и выполняет лишнюю работу: повторно проверяет данные на дубликаты, хотя в этом нет необходимости, или упускает более дешеый план выполнения. Механизм UniqueKeys позволяет прослеживать уникальность данных через сложные соединения и подзапросы, чтобы исключать ненужные операции DISTINCT и GROUP BY и точнее оценивать стоимость запросов. В Tantor Postgres этот механизм уже реализован, а патч предложен для рассмотрения сообществом PostgreSQL в рамках CommitFest.

Читать далее

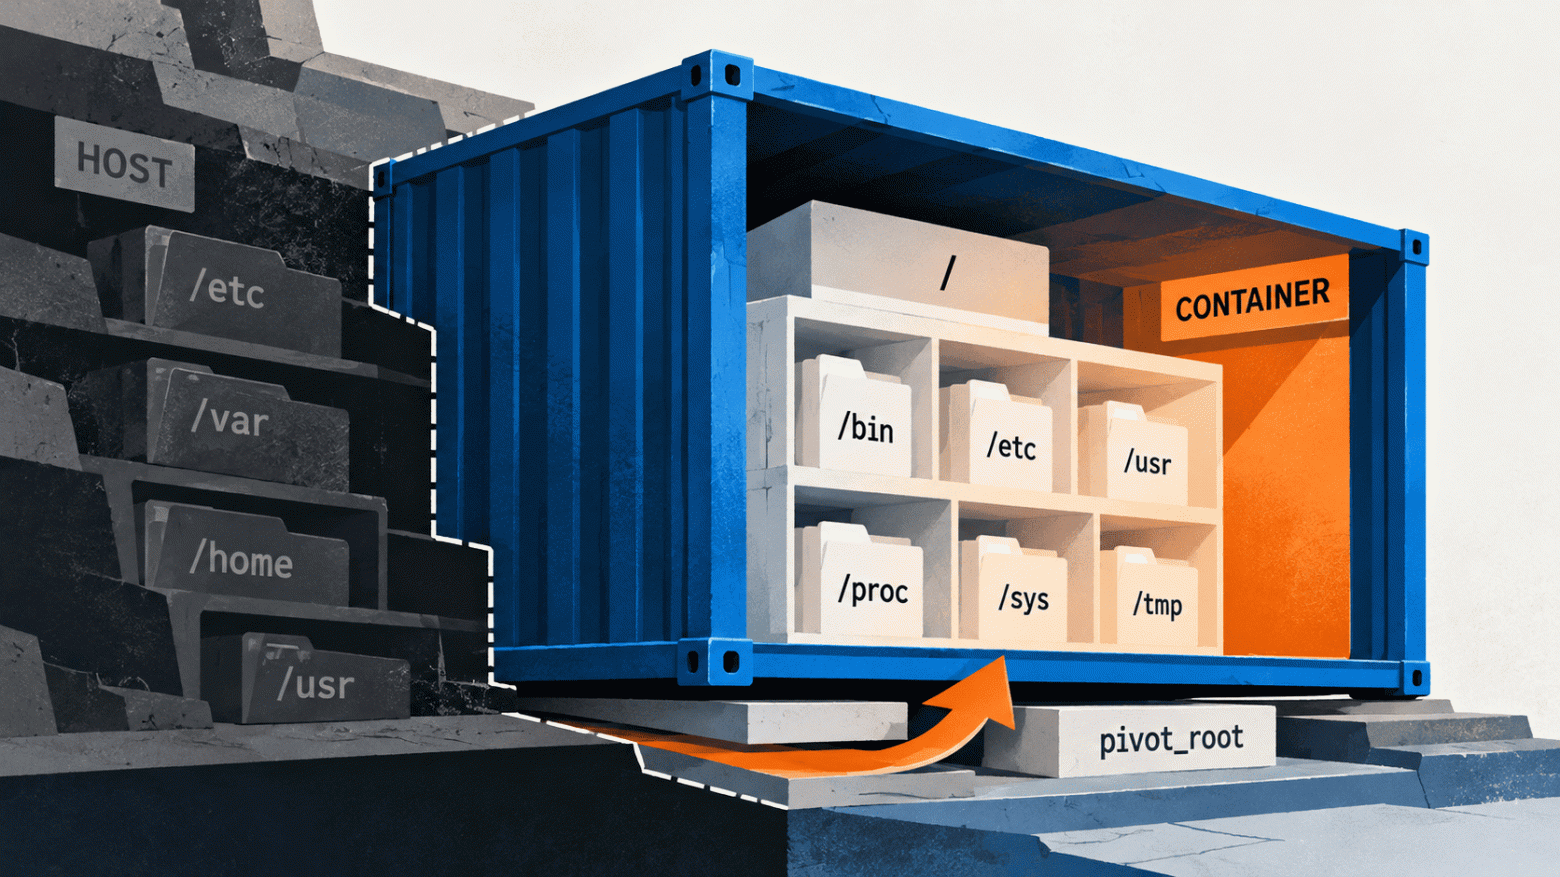
Как собрать Linux‑контейнер с нуля без Docker: unshare, pivot_root и rootfs

Уровень сложностиСредний
Время на прочтение27 мин
Охват и читатели9.4K

За одной командой docker run скрывается целая последовательность операций с файловой системой Linux. Но что потребуется, чтобы воспроизвести их вручную? Пройдём путь от создания пространств имён и настройки rootfs до запуска приложения в собственном контейнере, используя стандартные инструменты Linux.

Разобраться в изоляции

Ближайшие события

Prom++ против Prometheus: проверяем 7,8 раза экономии памяти на своём стенде

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели9.1K

Для моих задач Prometheus ел слишком много памяти, и я стал искать альтернативу. Нашёл Deckhouse Prom++, у которого заявлена экономия памяти в 7,8 раза, и решил проверить это на своём стенде. Сравнил его с Prometheus 3.15.0 и 2.55.1 на 500 000 активных серий, 12 прогонов за два дня. Получилось 4,4 раза по памяти, 3,8 по процессору и около 24% по скорости запросов при 16 клиентах. Рассказываю, как мерил, где ошибся и почему цифры отличаются от заявленных.

Читать далее

Как Zabbix 8.0 обрабатывает поток событий: окна, корреляция и Complex Event Processing

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели6.7K

Один реальный сбой редко порождает один алерт. Если падает сетевой uplink, система мониторинга может одновременно сообщить о недоступности узла, ошибках HTTP-проверок, остановке приложений и пропаже бизнес-сервисов. Для инженера это один инцидент, но для платформы — несколько независимых событий.

Меня зовут Антон Касимов, я работаю в Gals Software, веду телеграм-канал Zabbix Recipes, посвященный Zabbix, где делюсь своим опытом. Сегодня поговорим про новый функционал в Zabbix 8.0 — Complex Event Processing (CEP). Это механизм обработки потока событий с состоянием, временными окнами и правилами. Он обрабатывает поток событий по правилам, сохраняет выбранные события во временных окнах и выполняет над ними операции в заданные моменты.

CEP позволяет:

• группировать события по хосту, тегу, IP-адресу, сервису или другому контексту;

• ограничивать окно временем и количеством событий;

• связывать первое событие с последующими как причину и симптомы;

• подавлять повторные проблемы, изменять важность и теги, закрывать или клонировать события;

• находить более сложные последовательности с помощью JavaScript.

Устраивайтесь поудобнее, мы начинаем.

Читать далее

Будни администратора Minecraft-сервера: пора обновляться

Время на прочтение10 мин
Охват и читатели13K

Уже больше года я занимаюсь активным администрированием сервера Selectel в Minecraft. За это время вышло шесть обновлений, которые дополняют игровой процесс. Первые обновления прошли без серьезных вызовов, но версии 26.2 и 26.3 внесли изменения в генератор мира. 

Из-за особенностей игры новые локации могут появиться только там, где до обновления еще не ступала нога игрока. Это подтолкнуло меня провести небольшой аудит нашего игрового мира и подготовить его к обновлению — сбросить области, в которых игроки были только «проездом». Отсутствие вайпов (периодического полного сброса игрового процесса) на сервере и относительно большой игровой мир сделали эту задачу особенно интересной.

В этой статье вас ждет обзор утилит для управления мирами, скриншоты нашей карты и описания некоторых внутриигровых механик.

Читать далее

Почему ИТ узнаёт о потребностях в оборудовании позже всех

Время на прочтение4 мин
Охват и читатели5.6K

«А почему это не заложили в бюджет?» — спрашивает финансовый директор, когда в ноябре ИТ-отдел просит срочно закупить сорок ноутбуков. Вопрос справедливый, но и у ИТ ответ честный: бюджет утвердили ещё в декабре прошлого года, а техника начала массово выходить из строя только сейчас.

Читать далее

Самохостинг 10 ТБ на ноутбуке, свой сервер вместо облака, личные сайты и сисопки

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели94K

Домашний сервер — обычное дело в наше время. Кажется, таким никого не удивишь. Но некоторые экстремальные примеры всё-таки поражают. Вот недавно товарищ рассказал, как организовал у себя дешёвый аналог S3: купил пять недорогих HDD по 8 ТБ и подключил их к ноутбуку через дисковую стойку.

Читать далее

Прод лёг вместе с WAF: как я поднимал портал за четыре часа

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели7.5K

Воскресенье, 11 октября. Я просыпаюсь в четыре утра от того, что у меня разрывается телефон. Коллеги сообщают: прод лёг. Уже тогда я понял, что ночь будет веселой. К восьми утра портал снова работал — прод на двух ядрах вместо восьми и за фильтром, который я собрал на ходу. Ниже — как это было по шагам, где мы чуть не встряли и что я советую сделать заранее всем, чтобы облегчить себе жизнь.

Читать далее

DataSafeS3 1.5.0: доставка событий и переключение Postgres с отчётом

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели9K

В DataSafeS3 1.5.0 я переделал доставку событий. Раньше вебхук уходил после записи метаданных, и если сервер падал между записью и отправкой, событие пропадало: система аудита или антивирус просто не узнавали об изменении объекта. Теперь событие записывается в таблицу исходящих событий в той же транзакции, что и метаданные, а отдельный процесс доставляет его в вебхуки, NATS JetStream или Kafka. Событие доставляется хотя бы один раз, поэтому возможны дубли. Есть и случаи, когда оно может не дойти, и их видно в метриках.

Как устроены доставка событий в DataSafeS3