Обновить
256K+

DevOps *

Методология разработки программного обеспечения

299,1
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Ноутбук DevOps-инженера и $6,3 млрд: почему на безопасность нужно выделять время

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели2.7K

29 октября из Binance, крупнейшей криптобиржи мира, вывели около $6,3 млрд. По первой версии самой биржи, всё началось со скомпрометированного ноутбука DevOps-инженера.

Через ноутбук атакующий добрался до service container и оттуда отправил транзакции на вывод. Ключи от кошельков не утекли: транзакции подписала сама система биржи, потому что запрос пришёл изнутри.

Криптовалюта здесь вторична. Мне интереснее другое: задачи по безопасности у нас месяцами лежат в бэклоге, а ноутбук инженера с доступом в прод остаётся самым удобным входом в компанию.

Читать далее

Новости

Яnetes — Kubernetes для тех, у кого свои масштабы (и для страданий, конечно)

Время на прочтение30 мин
Охват и читатели9.4K

Вчера звонил Сатана. Оказывается, в аду зачитываются фанфиком про Gachinetes. Они давно хотели улучшить систему своих пыток, сделать ее более клиентоориентированной и подстроенной под каждого посетителя.

По словам Люцифера, им понадобился подходящий инструмент для пыток продуктовых команд Яндекса. Взамен он обещал, что после смерти найдет мне местечко в подземелье Вана, чтобы я не слишком страдал в аду, а даже радовался загробной гачи-жизни. Предложение было слишком привлекательным, чтобы отказываться. Да и Веельзевул мужичонка солидный, иметь таких в пуле должников весьма полезно.

Так появился особый дистрибутив для инженеров Яндекса, попавших в ад, Яnetes.

Читать далее

Как мои автоматические проверки врали мне зеленым цветом

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.3K

Почти весь код своего проекта kb-engine я писал вместе с ИИ-агентом и быстро понял: правило, которое можно пропустить, когда неудобно, никто соблюдать не будет. Работает только то, что проверяет код.

Сейчас в проекте 21 автоматическая проверка. Вот пять историй, и в нескольких из них проверка была зеленой и при этом ничего не проверяла.

Читать далее

Ключ корня DNS сменили 11 октября: что делает старый резолвер в пересозданном контейнере

Время на прочтение6 мин
Охват и читатели7.7K

С 11 октября 2026 года корень DNS подписывает набор ключей только новым KSK-2024 (38696). За четыре дня до смены Эфраин Гарай показал, что BIND из Debian 11 с одним старым ключом при первом запуске сам начинает доверять новому. Через 20 дней после смены я запустил тот же BIND с пустым состоянием, как в пересозданном контейнере: SERVFAIL на всё, включая неподписанный google.com. Для unbound такой старт спасает unbound-anchor, но только при открытом HTTPS к data.iana.org, а при неудаче пишет старый ключ и выходит с кодом 0. dnsmasq из Debian 12 со своим файлом якорей отказывает на всём, а с якорями, где есть 38696, работает: их подставляет сервисная обёртка дистрибутива.

Читать далее

Жизнь после блокировки: нейронки изменили мою профессию и я не хочу снова работать по‑старому

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели78K

Недавние истории с блокировками от Anthropic заставили меня всерьез задуматься, как я буду работать, если и мой аккаунт отлетит в бан.

В мгновение я поймал себя на мысли, насколько сильно изменилась моя инженерная профессия. Прошло всего около года, но я уже вспоминаю прежний уклад своей деятельности, как что‑то очень далекое из прошлой жизни.

Но самое главное в другом: я осознал, что меня пугает возврат назад...

и вот почему

Старый софт на свежем Linux: свой GCC, свой OpenSSL и честный RPATH

Уровень сложностиСложный
Время на прочтение17 мин
Охват и читатели6.3K

А что если… нужен старый софт, но при этом хост Linux свежий?

Как вариант, можно взять, да хоть на примере питона, нужный официальный образ в докере. Да и пользоваться.

Казалось бы, проблема решена. Но есть нюанс (с). Добро пожаловать под кат.

Читать далее

Домашний прод, часть 1: от двух LXC до Istio

Уровень сложностиСредний
Время на прочтение29 мин
Охват и читатели7.5K

Я DevOps-инженер. В DevOps я перешел незадолго до начала этой истории, а до того год работал в сопровождении с элементами SRE. Еще раньше я сидел в центре мониторинга сетей у телеком-оператора. Дома у меня мини-ПК и медиасервер, которым каждый вечер пользуется семья. На этом медиасервере я и учился тому, за чем пришел в профессию: Kubernetes, Istio, Jenkins.

Медиасервер у меня собран из целого arr-стека. Так называют набор self-hosted сервисов, которые сами находят, качают и раскладывают по папкам фильмы и сериалы. Смотрим мы все в Jellyfin, это медиасервер, что-то вроде домашнего КиноПоиска. Заявки принимает Seerr (раньше он назывался Jellyseerr): выбрал фильм на витрине, и заявка ушла дальше. Фильмами занимается Radarr, сериалами Sonarr. Оба спрашивают Prowlarr, а тот ищет раздачи по торрент-трекерам. Если трекер закрыт капчей Cloudflare, Prowlarr проходит ее через FlareSolverr. Качает qBittorrent, субтитры подбирает Bazarr. Когда все работает, человек нажимает одну кнопку, и через какое-то время фильм появляется в Jellyfin.

В прошлой статье, «Я даже не пойму, если что-то сломал», я рассказывал, как бросил учебный демо-магазин и перенес все на медиасервер. Закончил я ее тем, что фильм играет, а значит, о поломке я узнаю. С дивана, как потом выяснилось, видно далеко не все. Самые неприятные ошибки за следующие месяцы выглядели как успех: джоба писала, что все прошло, кино играло, а того, что должно было случиться, не случалось.

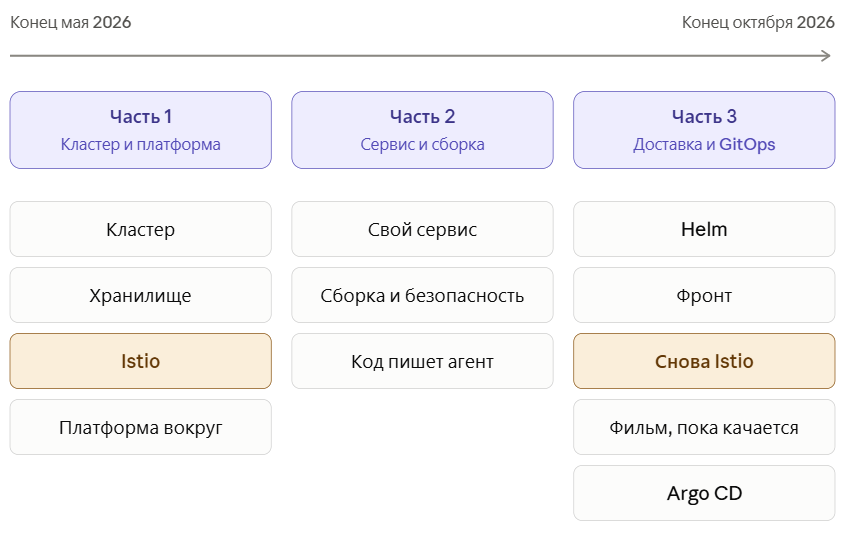
Пишу я это прежде всего для себя. С конца мая по конец октября 2026 года я сделал много отдельных кусков и ни разу не видел путь целиком. Хочу собрать его в одном месте и понять, что вообще произошло. Текста вышло на три статьи. Эта первая, про кластер, хранилище, Istio и платформу вокруг. Во второй будет свой сервис, сборка с проверками безопасности и то, как код у меня начал писать агент. В третьей Helm, фронт, возвращение к Istio, просмотр фильма, пока он качается, и Argo CD.

Читать далее

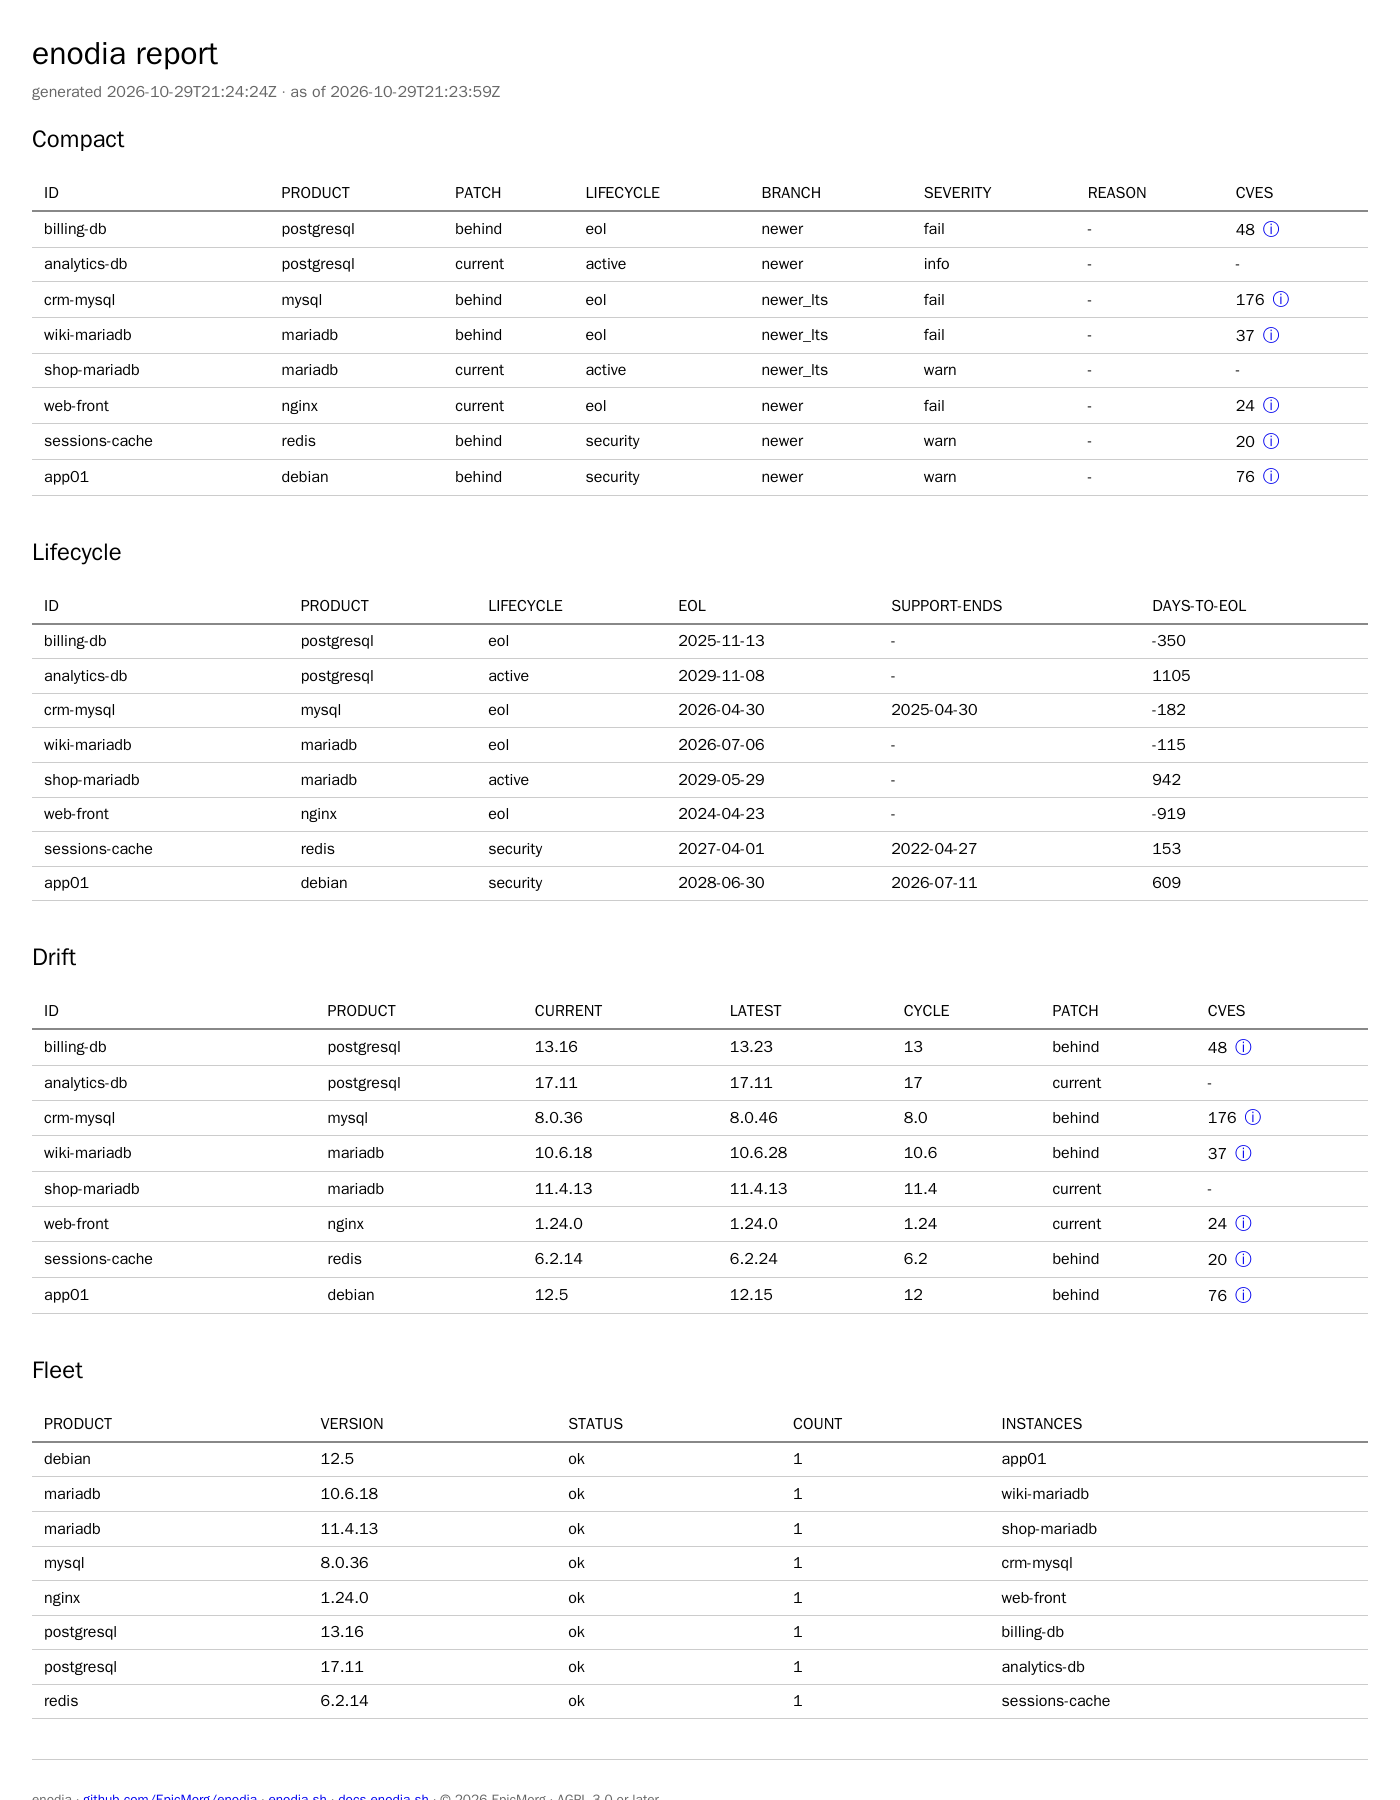
Зоопарк версий под контролем: как я создал enodia — инвентаризацию сервисов с EOL и CVE

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели6.9K

Сколько у вас в инфраструктуре версий PostgreSQL? А какие из них уже не поддерживаются? А сколько CVE висит на том nginx, который «работает — не трогай»?

Если вы ответили на все три вопроса без поиска по чатам и вики, дальше можно не читать. А я в какой‑то момент понял, что не могу, и написал для этого инструмент. Под катом история о том, как он появился, на какие грабли я наступил по дороге и почему MySQL однажды заблокировал собственный хост из‑за моего мониторинга.

Читать далее

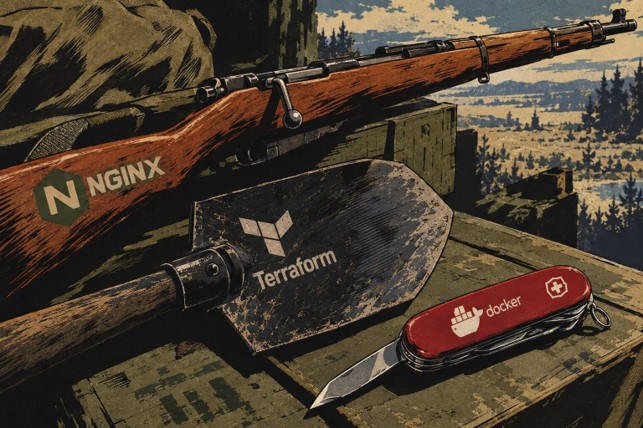
Если бы облачные сервисы были оружием, то MongoDB — граната без чеки

Время на прочтение9 мин
Охват и читатели7.8K

У нас под постом про ЦОДы развернулась дискуссия: какой должна быть ракета, чтобы устроить дата-центру пробитие. Я почувствовал себя среди оружейных баронов и экспертов по уничтожению дата-центров.

Знаете, у нас есть некоторая экспертиза в этом. Потому что сгоревших ЦОДов мало, а вот попадавших из-за кривых рук — очень много. Поэтому мы тут решили на Хэллоуин сравнить разные технологии с тем, как бы выглядело оружие на их базе.

Кроме MongoDB без чеки из заголовка у нас есть ещё 20 не менее убойных штук.

Читать далее

Как IaC, документация и бэкапы помогли восстановить сервисы, когда пострадали дата-центры Яндекса

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели12K

Привет, я Сергей, DevOps-инженер в KTS. Перейду сразу к делу.

К отказу отдельной виртуалки вы наверняка готовы. Но не все готовы к другому классу аварии: к потере площадки, на которой находятся почти все ВМ проекта.

Именно с такой ситуацией столкнулся один из наших заказчиков после серии атак на дата-центры Яндекса в октябре 2026 года. Компания сообщила, что дата-центр в Сасово был серьезно поврежден и полностью остановлен, часть инфраструктуры площадки в Калуге вышла из строя, а позднее остановилась работа дата-центра во Владимире.

Авария затронула инфраструктуру Yandex Cloud, где работали сервисы нашего заказчика. Восстановить работу системы на прежней площадке в тот момент было невозможно, а очередь за новыми ресурсами обрабатывалась несколько дней.

Заказчика и его внутренние системы я называть не буду, статья не о нем. На его примере я хочу поговорить о механике восстановления: что происходит после потери основного дата-центра и какие инженерные практики помогают вернуть бизнес в рабочее состояние.

Читать далее

Оперативка есть? А если найду?

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.1K

Снова статья о том, как надо/не надо делать.

Long story short.

У меня все еще работает CHUWI CoreBox, который уже появлялся в предыдущих статьях: Core i7-13620H, 16 ГБ LPDDR5 (а жаль!), SSD на 512 ГБ. Он успел побыть прокси, NAS, VPN, сервером Lineage 2 и складом 3D-моделей для печати. Склад потом переехал на отдельный накопитель, а сбор моделей я остановил. Даже качественные модели скачивались гораздо быстрее, чем я успевал их печатать. На освободившемся мини-ПК шла разработка своего продукта, ибо я привык к linux, и там же крутились тесты. С обычными проверками еще можно было жить, но мутационное тестирование занимало часы. Хотелось продолжать работу, пока оно выполняется, а свободных ресурсов на той же машине было немного.

Зато рядом стоял мой любимый игровой компьютер: Ryzen 9 9950X3D и золотые 64 ГБ Kingston FURY Beast DDR5-6000 CL30. Память до 64 ГБ я докупал в 2026 году. Кто в этом году собирал комплуктер, тот понимает, почему я сейчас это упоминаю и ставлю на этом акцент.
К этому моменту я уже смотрел по квартире, у чего еще есть оперативка. Поглядывал дергающимся глазом на робот-пылесос и духовку. Если они подключаются к Wi-Fi, значит, они чем-то думают и чем-то помнят.

Но начал все-таки с ПК. Windows оставил на месте, потому что игры нужно на чем-то играть, поставил WSL с Ubuntu и отдельным Docker. Разработку оставил на мини-ПК, а тяжелые проверки решил вынести на игровую машину. Первый измеренный запуск PIT на ней занял больше девяти часов и закончился с ошибкой памяти. Это же разочарование я ловил много раз на мини-пк, разбирал по этому разочарованию логи, в течение десятков часов, в надежде исключить дефицит памяти. Смотрим.

Читать далее

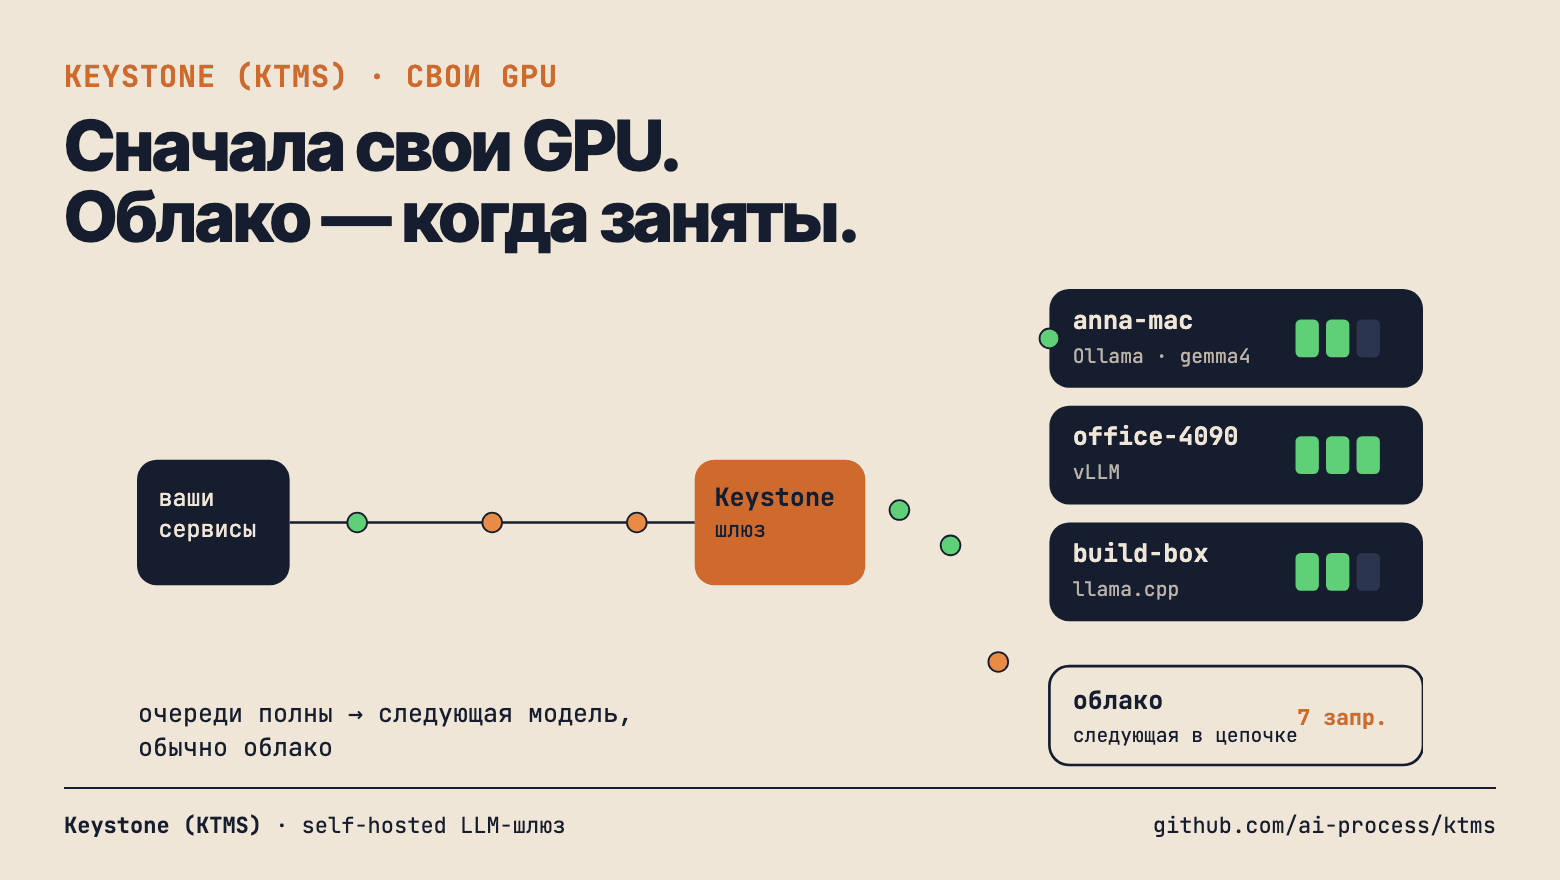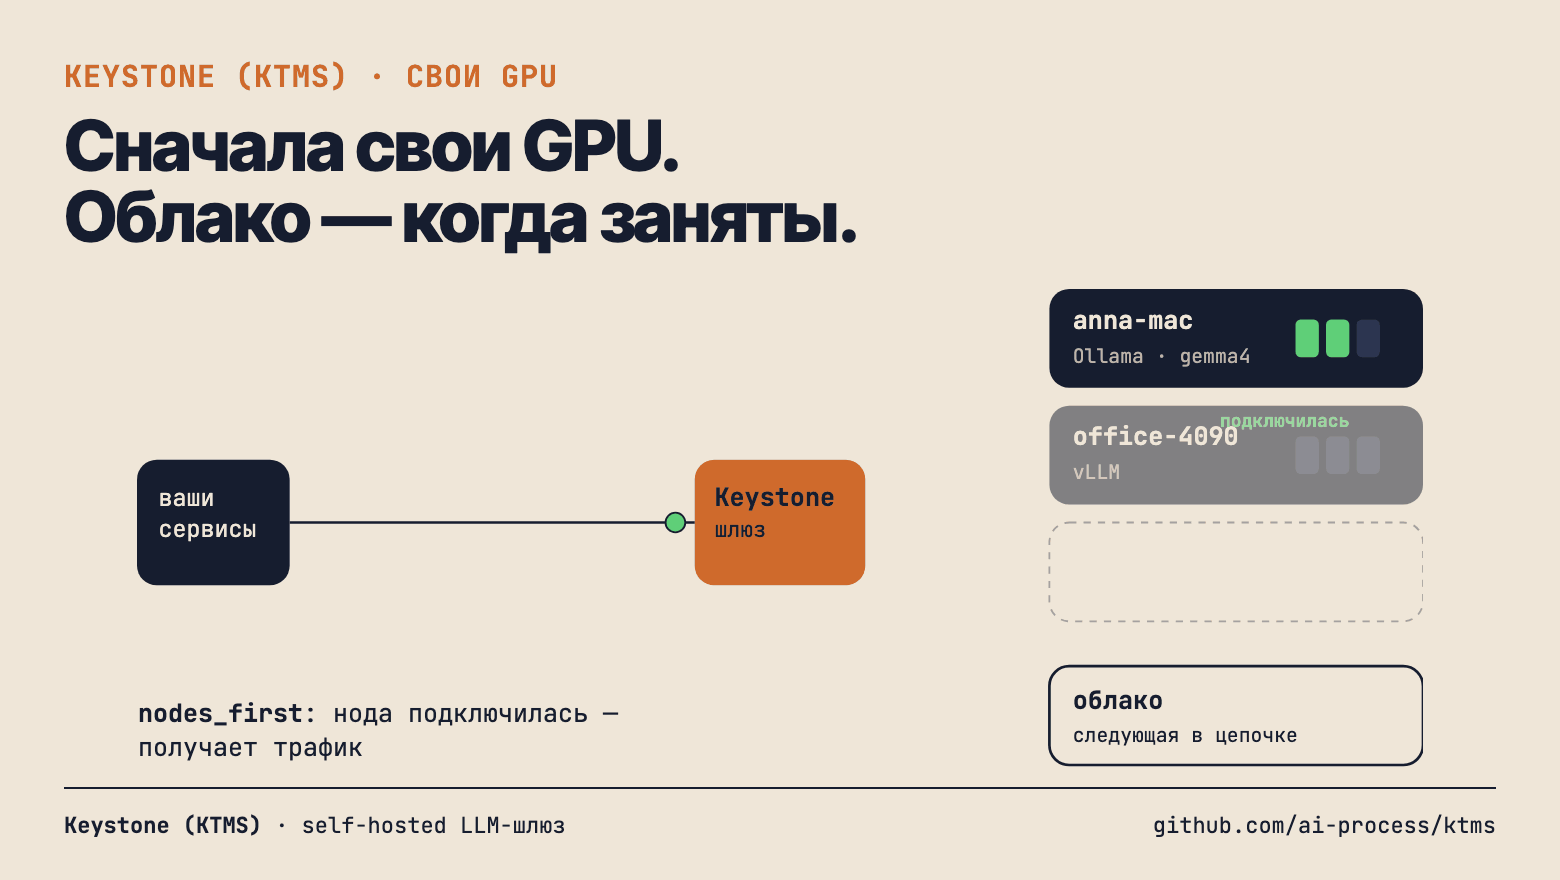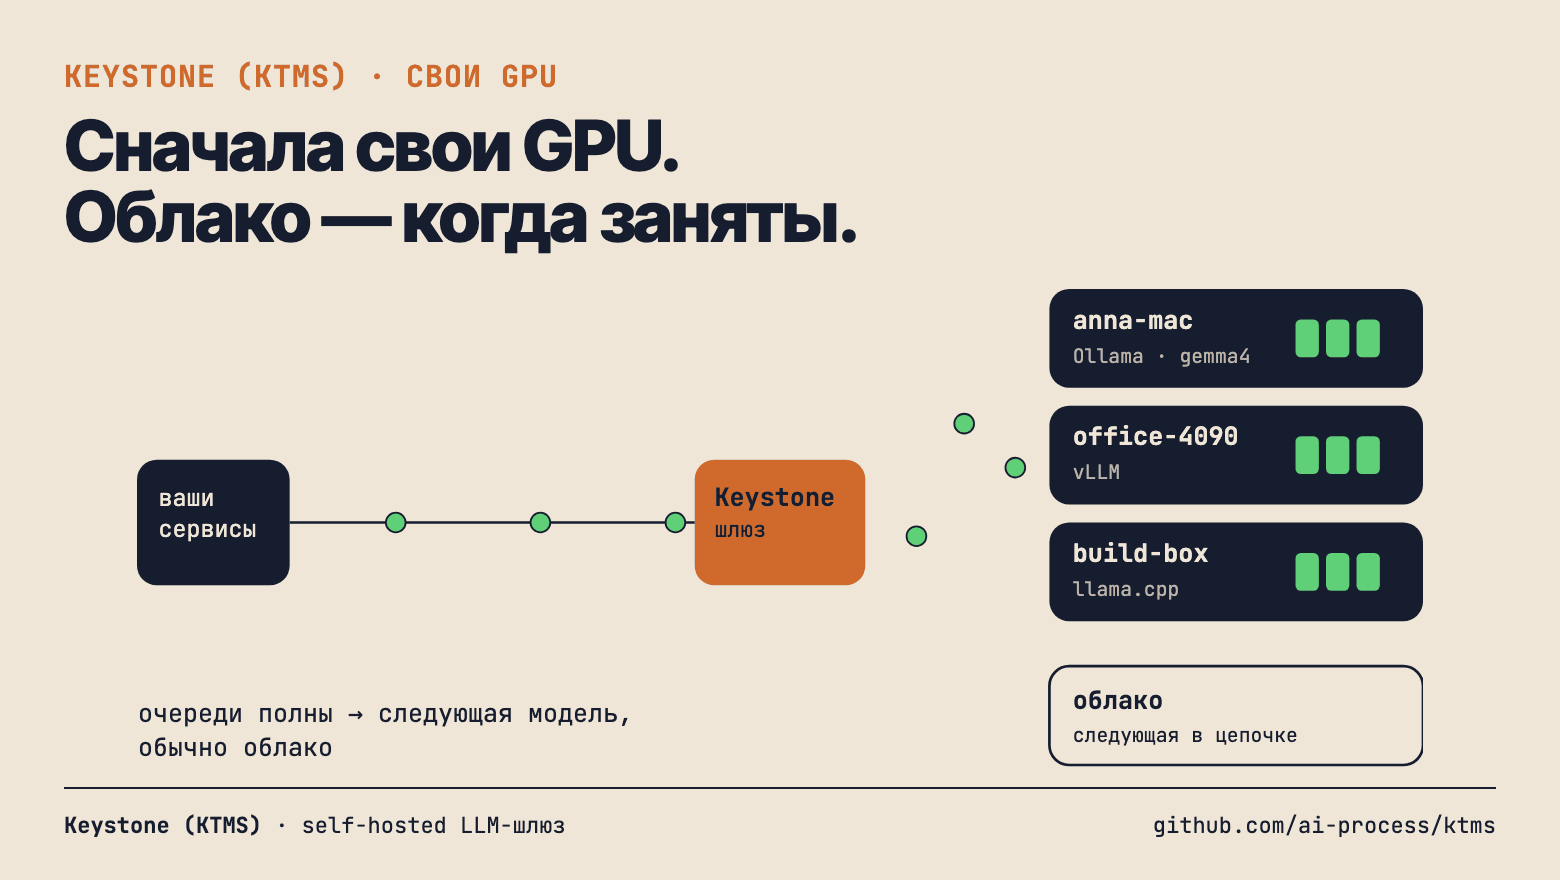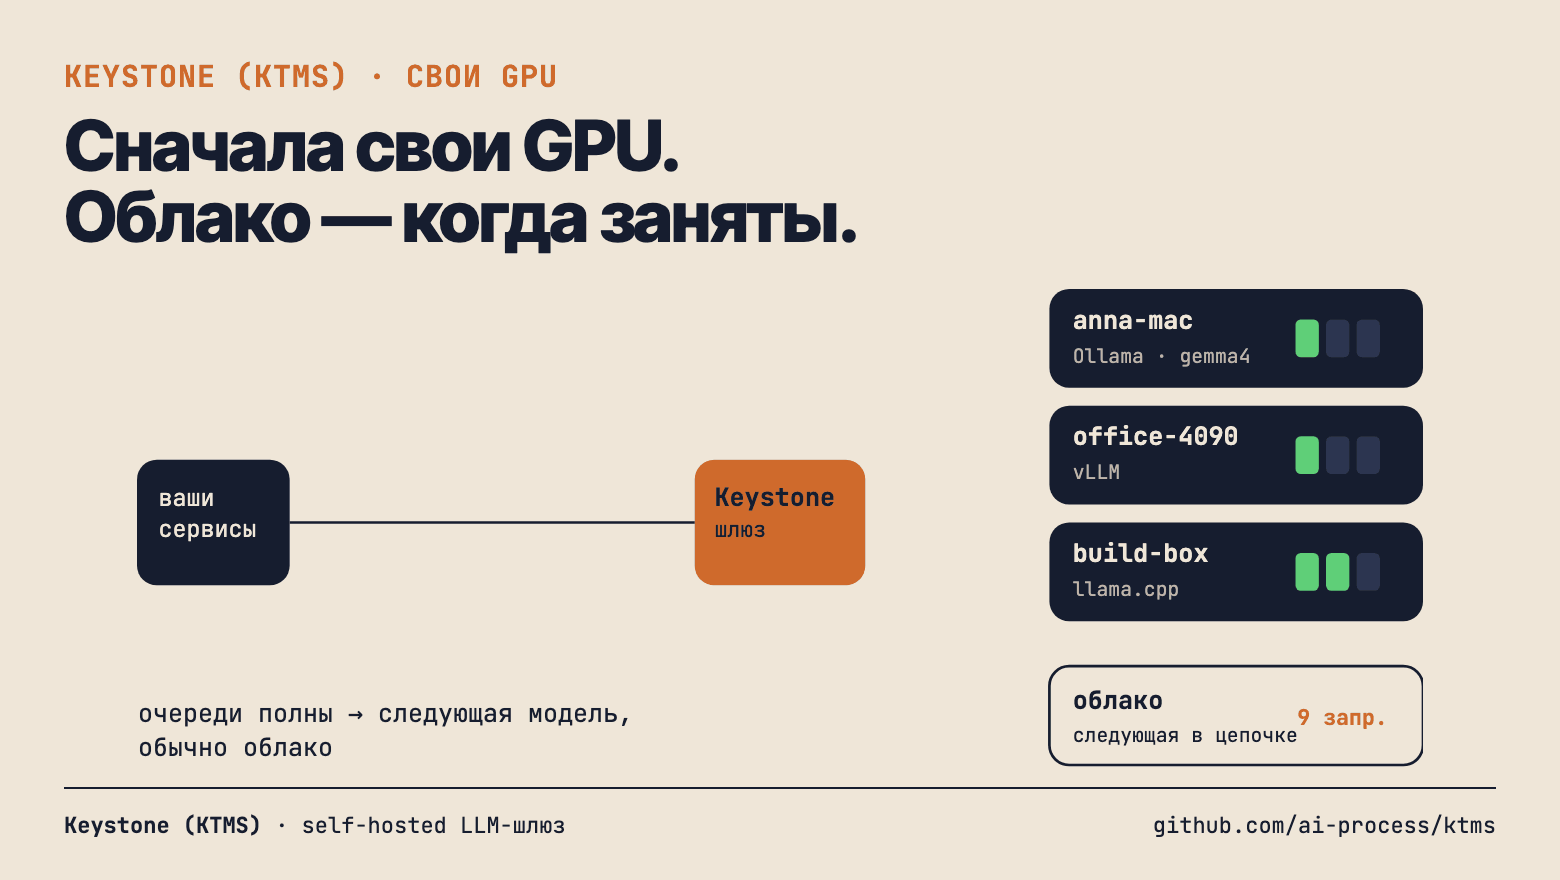
Свои GPU плюс облако: как LLM-шлюз живёт в продакшене — ноды, отказы, ключи, обновления

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.6K

В прошлой статье я рассказывал про маршрутизацию и деньги в Keystone. The Model Switchboard. (KTMS), нашем open-source LLM-шлюзе на Go. Эта статья про эксплуатацию: как подключить свои видеокарты, что происходит, когда отказывает каждая зависимость, как менять ключи шифрования, как проверять, что вы скачали именно наш релиз, и как обновляться без простоя.

Читать далее

Думал, дел на пару вечеров… Но демка на Vercel выросла в PWA с собственным CI/CD на Coolify

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели7.8K

Привет! На связи Никита Шелепин, менеджер поддержки в Selectel. Расскажу о том, как однажды подписался на легкое на первый взгляд задание, предвкушая потратить пару вечеров, а закончилось все собственным CI/CD, Docker’ом и PWA.

Предстояло сделать сервис, который позволит оценивать когнитивные способности пользователей, а также будет собирать и сохранять результаты для выгрузки и дальнейшего исследования.

За моими плечами тогда было около года опыта — я писал инструменты администрирования на Vue с Bootstrap для одной компании в качестве подработки. Затем самостоятельно познакомился с SvelteKit — мне понравились его философия и модульность, а также то, что «из коробки» он дает удобный роутер и простые инструменты для создания fullstack-приложения.

С этим багажом знаний я и приступил к работе.

Читать далее →

Ближайшие события

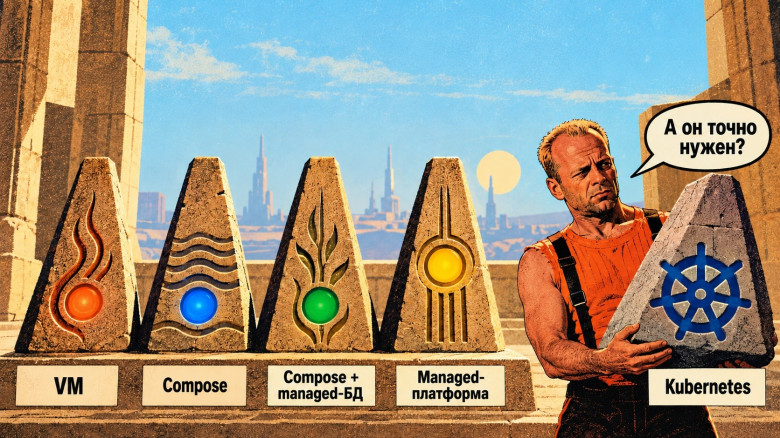
Нужен ли Kubernetes сервису с одной базой данных? Четыре способа запуска и границы между ними

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.1K

У вас небольшой сервис в облаке. Он работает, но проект растет: в команде больше разработчиков, появляются фоновые задачи, пользователи ждут стабильной работы. Пора менять инфраструктуру или текущая схема еще справится?

В статье решил сравнить четыре способа запустить одно и то же приложение и разобрал случаи, когда действительно нужен Kubernetes.

Эта статья для бэкенд-разработчиков, DevOps, SRE и тимлидов. Если вы работали с виртуалками и Docker, но пока присматриваетесь к Kubernetes — велком под кат.

Узнать, нужен ли пятый элемент

«client prematurely closed connection», хотя пользователь никуда не уходил

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.4K

В логах nginx появляется 499, и кажется, что клиент просто закрыл соединение. Но за таким обрывом может скрываться таймаут балансировщика, медленный бэкенд и запросы, которые продолжают выполняться впустую. На примерах с Go, aiohttp и Angie разбираемся, откуда берутся 499, как они влияют на инфраструктуру и по каким признакам отличить обычную отмену запроса от проблемы на стороне сервера.

Разобраться с 499

Gachinetes: три хундрет бакс, честная борьба за ресурсы и Билли в сердце (никакой пошлятины, только полезные фичи)

Время на прочтение20 мин
Охват и читатели8.7K

Ладно, это было неизбежно. Кстати, официальные конформанс-тесты от CNCF дистрибутив прошел на ура: 462/462.

Читать далее

От FaaS к PaaS: почему я построил собственный оркестратор вместо Kubernetes

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели8.6K

Раньше я уже рассказывал на Хабре об Inquir Compute, который тогда был платформой для запуска serverless-функций. С тех пор проект вырос в PaaS с поддержкой контейнерных приложений, баз данных, фоновых задач и собственной системой управления вычислительными ресурсами.

Вместо Kubernetes или Nomad я решил развивать собственный оркестратор с allocation plane, планировщиком и вычислительными раннерами на containerd. Главная причина не в желании переписать существующие инструменты, а в возможности объединить долгоживущие приложения и serverless-функции в одну ресурсную модель, напрямую связанную с жизненным циклом сервисов и тарификацией платформы.

Расскажу, как развивалась архитектура Inquir Compute, почему я считаю собственный оркестратор правильным выбором для этого проекта, какие задачи удалось решить и над чем ещё предстоит работать.

Читать далее

Перенос Moodle на Ubuntu 24.04 LTS: восстановление из бэкапов, PHP 8.3 и диагностика ошибок

Время на прочтение10 мин
Охват и читатели7.2K

Перенос учебного портала на новый сервер выглядит довольно просто: развернуть веб-сервер, восстановить базу данных, распаковать файлы и поправить конфигурацию. На практике всё оказалось интереснее.

При восстановлении Moodle 4.1.11 на Ubuntu 24.04.5 LTS мы столкнулись с несколькими проблемами: в конфигурации оказалось неправильное имя базы данных, на сервере обнаружились два каталога с кодом Moodle, MySQL отказывался запускаться, а после восстановления возникли ошибки кэширования и invalidparameter.

В этой статье разберём последовательность работ, диагностические команды и выводы, которые можно использовать при переносе собственной LMS.

Важно: на момент подготовки статьи часть ошибок ещё находилась в стадии диагностики. Поэтому ниже я отдельно отмечаю, что удалось установить, а что требует дополнительной проверки.

Читать далее

Итоги конференции СисАдмин 2026: технологии, тенденции и что ждет сисадмина

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели7.4K

Открывая СисАдмин 2026, Егор Бугаенко пообещал залу, что через пять лет половина присутствующих станет инструкторами по йоге, поварами и владельцами кофеен, а людям просто запретят заходить в консоль. Через полчаса на ту же сцену вышел Максим Парицкий из банка ПСБ и рассказал, как его команда своими силами перевела десятки тысяч рабочих мест на Astra Linux. Первая фраза его доклада: «Рановато там еще искусственный интеллект применять».

Кто из них прав? Мы прослушали все 26 докладов конференции для системных администраторов и собрали главное: что на самом деле происходит с ИИ и импортозамещением, куда движется управление рабочими местами и как меняется профессия сисадмина. По нескольким вопросам зал так и не договорился. Предлагаем продолжить в комментариях.

Читать далее

Делаем AppImage средствами Nix

Уровень сложностиСложный
Время на прочтение17 мин
Охват и читатели8.9K

«И что это я, в самом деле, всё про QEMU да про QEMU? Давайте я вам лучше про AppImage расскажу. Короче, случай из жизни nix». (c)

Для сборки QEMU с своими доработками (новые машины, tcg-code-quality, i2c-remote-master, GPIO наружу через GUSE и прочее) у каждого коллеги свой путь: кто-то собирает сам, кто-то берёт готовый бинарник у соседа, кто-то сидит на дистрибутиве, где glib на три года старше, чем нужно, а студенты вообще не хотят ничего собирать сами...

Хотелось простого: один файл, который скачал, сделал chmod +x и запустил. На любом x86_64 Linux, без root, без установки пакетов и без «а у меня не собирается». При этом сама сборка должна быть воспроизводимой, а не «собрано на ноутбуке у Пети».

Ниже история о том, как из этого получился небольшой flake, который собирает QEMU через Nix и упаковывает его в AppImage. Здесь я покажу как подписывать образы, обновлять их дельтами и подсовывать QEMU свою, экспериментальную libfuse так, чтобы она использовалась только для QEMU.

Читать далее
1
23 ...