Обновить
512K+

Python *

Высокоуровневый язык программирования

362,85
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Делаем простого бота в Telegram на Python. Интеграция с Excel

Время на прочтение9 мин
Охват и читатели79K

Друг предложил мне поработать над проектом для нашей кафедры. ТЗ пока не сформулировано, но точно известно, что это будет бот в телеге. Я хоть и питонист, но с ботами дел никогда не имел, поэтому пишу эту статью, как заметку, для себя и молодых перспективных ребят, чтоб у них было от чего оттолкнуться. Постараюсь писать максимально понятным и простым языком. Профессионалам тут особо делать не чего, хотя, может и придёт какая-нибудь идея.

Читать далее

Почему стоит научиться «парсить» сайты, или как написать свой первый парсер на Python

Время на прочтение3 мин
Охват и читатели221K

В этой статье я постараюсь понятно рассказать о парсинге данных и его нюансах.


image

Для начала давайте разберемся, что же действительно означает на первый взгляд непонятное слово — парсинг. Прежде всего это процесс сбора данных с последующей их обработкой и анализом. К этому способу прибегают, когда предстоит обработать большой массив информации, с которым сложно справиться вручную. Понятно, что программу, которая занимается парсингом, называют — парсер. С этим вроде бы разобрались.

Перейдем к этапам парсинга.

  • Поиск данных
  • Извлечение информации
  • Сохранение данных

И так, рассмотрим первый этап парсинга — Поиск данных.


Так как нужно парсить что-то полезное и интересное давайте попробуем спарсить информацию с сайта work.ua.
Для начала работы, установим 3 библиотеки Python.

pip install beautifulsoup4

Без цифры 4 вы ставите старый BS3, который работает только под Python(2.х).

pip install requests
pip install pandas


Теперь с помощью этих трех библиотек Python, можно проанализировать нашу веб-страницу.

Второй этап парсинга — Извлечение информации.


Попробуем получить структуру html-кода нашего сайта.
Давайте подключим наши новые библиотеки.

import requests
from bs4 import BeautifulSoup as bs
import pandas as pd

И сделаем наш первый get-запрос.

URL_TEMPLATE = "https://www.work.ua/ru/jobs-odesa/?page=2"
r = requests.get(URL_TEMPLATE)
print(r.status_code)

Статус 200 состояния HTTP — означает, что мы получили положительный ответ от сервера. Прекрасно, теперь получим код странички.

print(r.text)

Получилось очень много, правда? Давайте попробуем получить названия вакансий на этой страничке. Для этого посмотрим в каком элементе html-кода хранится эта информация.

<h2 class="add-bottom-sm"><a href="/ru/jobs/3682040/" title="Комірник, вакансия от 5 ноября 2019">Комірник</a></h2>


У нас есть тег h2 с классом «add-bottom-sm», внутри которого содержится тег a. Отлично, теперь получим title элемента a.
Читать дальше →

Модели глубоких нейронных сетей sequence-to-sequence на PyTorch (Часть 6)

Время на прочтение25 мин
Охват и читатели8.1K

В этом разделе мы будем реализовывать (слегка измененную версию) модели Transformer из статьи Attention is All You Need. Подобно свёрточной модели Sequence-to-Sequence, Transformer не использует никакой рекуррентности. Он также не использует свёрточные слои. Вместо этого модель полностью состоит из линейных слоев, механизмов внимания и нормализации.

Читать далее

Обзор Databrick. Что облачный продукт может дать начинающим специалистам

Время на прочтение5 мин
Охват и читатели30K

Добрый день, уважаемые читатели! Данная публикация посвящена Databricks и она получилась не совсем обычный по двум причинам.

Во-первых, в ней не будут обсуждаться типичные вопросы: целесообразность перевода всех сервисов и служб компаний в облако, возможные ошибки при такой миграции, стоимость использования сервиса, правовые аспекты хранения данных не на территории РФ. Это темы сложные, дискуссионные и без указания конкретных цифр и бизнес-факторов их сложно полноценно раскрыть в статье. Поэтому я решил посмотреть на Databricks под другим углом и заострить внимание читателей на таком аспекте: что может дать изучение инструмента аналитику данных.

Во-вторых, чтобы обзор продукта был максимально комплексным и технически взвешенным я с самого начала планировал написать материал в соавторстве с инженером данных и специалистом в сфере data science. В таком случае была бы возможность донести до читателей концепцию Delta Lake и рассказать о нюансах машинного обучения. Но предложение не нашло отклика в сердцах коллег по цеху, поэтому итоговый результат получился в стиле: “Я художник - я так вижу!”) Это была преамбула, а теперь настало время познакомиться поближе с Databricks.

Читать далее

Как победить несбалансированность датасета: метод upsampling data

Время на прочтение6 мин
Охват и читатели16K

Каждый начинающий дата саентист хоть раз сталкивался с проблемой несбалансированности данных для классификации: какой-то класс превосходит другие. Существует далеко не один способ борьбы с этой проблемой. В статье мы рассмотрим метод upsampling

Читать далее

Как превратить фотографию в 3D-объект с помощью Nvidia Kaolin и PyTorch: рендеринг DIB-R

Время на прочтение12 мин
Охват и читатели20K

В научной работе NVIDIA 2019 года улучшенный дифференциальный рендерер — DIB-R представлен как инструмент решения одной из самых популярных сегодня задач Deep Learning: генерации 3D-объектов из одного двухмерного изображения. Статья на ArXiv содержала исходный код, но в ней не оказалось необходимой для его выполнения ML-модели. К старту курса «Machine Learning и Deep Learning», партнёр которого — компания NVIDIA, делимся переводом о том, как запустить руководство по работе с этой программой визуализации, как она работает, как обучить ML-модель рендеринга и проверить её в действии.

Читать далее

Как работают Django Class-based views

Время на прочтение13 мин
Охват и читатели75K

Для новичка, который осваивает Django, представления на основе классов больше похожи на магию чёрного ящика, по крайней мере, у меня при первом знакомстве сложилось именно такое впечатление. Обильные руководства зачастую показывают, какие атрибуты и методы следует определить в вашем классе, чтобы этот ящик работал на вас, но не дают понимания принципа работы.

Я хочу залезть под капот фреймворка и строчка за строчкой разобрать, как же работают представления на основе классов. Надеюсь, что по прочтении, Class-based views уже не будут казаться такими пугающими и я подстегну вас к дальнейшему самостоятельному изучению исходников. Возможно, вы думали о фреймворке как о некой магии, которую невозможно понять, но на самом деле это обычный код, написанный опытными разработчиками.

Читать далее

Модели глубоких нейронных сетей sequence-to-sequence на PyTorch (Часть 5)

Время на прочтение23 мин
Охват и читатели5.1K

В этом разделе мы будем реализовывать модель из статьи Convolutional Sequence to Sequence Learning.

Эта модель кардинально отличается от предыдущих моделей, реализованных нами. Здесь вообще не используются рекуррентные компоненты. Вместо этого применяются свёрточные слои (CNN), обычно используемые для обработки изображений.

Читать далее

Управление сетевой инфраструктурой через Telegram за 5 EUR/месяц

Время на прочтение3 мин
Охват и читатели8.2K

Каким бы не был удобным WEB интерфейс системы управления сетью, это все-равно будет не так удобно, как использование мессенджера Telegram, где все в одном приложении: от общения с друзьями и получения прогноза погоды до управления сетевыми устройствами. В дополнение, удобный API интерфейс платформы Telegram позволяет получить желаемый сервис с минимальными трудозатратами. В данной статье я приведен самый простой пример одного из таких решений.

Читать далее

NFStats — анализ netflow данных для ISP «на коленке»

Время на прочтение5 мин
Охват и читатели18K

Приветствую! Продолжая рубрику "на коленке" (написал два года назад одну статью и уже рубрика), наконец у меня появилось время поделиться и рассказать еще об одном проекте (а заодно и привести его в порядок), который используется у нас на сети небольшого транзитного провайдера для сбора и анализа статистики сетевого трафика .

Это web-приложение позволяет просматривать статистику в разрезе BGP автономных систем, IP-адресов, интерфейсов, что полезно при балансировке трафика и общего понимания какой трафик проходит через/в/из вашу/ей AS. Удобное подспорье для небольших ISP.

Читать далее

Django Rest Framework для начинающих: создаём API для записи и обновления данных (часть 1)

Время на прочтение13 мин
Охват и читатели34K
Продолжаем изучать Django Rest Framework с точки зрения новичка. Мы уже разобрали создание REST API для получения данных из БД, включая отдельную статью о работе сериалайзера.

В этой статье расскажу, как с помощью сериалайзера проверить поступившие данные для записи в БД. Валидация в DRF состоит из множества этапов с массой нюансов. Если при чтении покажется, что деталей очень много и картинка в голове начинает плыть, в конце статьи есть обобщающая таблица с кратким описанием последовательности всех проверок.

image

Читать дальше →

Приятная капча и ее решение

Время на прочтение5 мин
Охват и читатели4.8K

В статье пойдет речь о решении визуально привлекательной капчи, решение которой не только немного расслабляет и погружает в транс медитации, но также позволяет немного стряхнуть пыль с фреймворка selenium для python, а также пакета opencv. Именно эти инструменты и будут использоваться на капче, которая относится к так называемому виду капч «с перетаскиванием». Но, для начала, присказка.
Читать дальше →

Большая подборка телеграмм-каналов для аналитиков

Время на прочтение6 мин
Охват и читатели86K

Работа аналитика требует постоянного пополнения своих знаний - новые инструменты, обновления и методы создаются, как горячие пирожочки. Но перерабатывать такие объемы информации просто нереально, а узнавать что-то новенькое и полезное хочется. И что делать?

Можно, конечно, подписаться на «стоковые» группы и каналы, которые каждый день публикуют по 10-20 постов с «полезным» материалом. Но, признайтесь, это просто самообман: во-первых, столько информации в день просто невозможно пропустить через себя - это только и надо, что статьи читать, а есть же еще работа/учеба. Во-вторых, «полезность» этих статей сомнительна - не каждый пост от умного индуса можно считать полезным, увы :(

Так как же быть? Ответ прост - читать авторские каналы, где реальные специалисты делятся информацией, которую они для себя считают полезной!

Итак, мы собрали для Вас большую подборку телеграм-каналов на любой вкус - каждый найдет для себя что-то интересное. Здесь и BI, и продуктовая аналитика, и программирование, и дашборды, и хранилища данных - одним словом, есть где разгуляться аналитической душе! 

Сохраняйте себе и подписывайтесь на ребят - они это точно заслужили! :)

Читать далее

Ближайшие события

Общего решения из коробки — нет, или Тестируем PySpark MLlib

Время на прочтение9 мин
Охват и читатели3.5K

Андрей Гаврилов работает в компании EPAM software инженером и занимается data-инженерными задачами. Пишет на Python, работает с Big Data и изучает Data Science — потому что невозможно заниматься Big Data на Python, не касаясь при этом Data Science.

И однажды он захотел выяснить, насколько модуль Spark, связанный с machine learning —  рабочий. Имеет ли  смысл его применять, когда мы мигрируем какое-то решение — например, Scikit-learn — на Spark. На конференции Russian Python Week 2020 он рассказал о своем эксперименте, а сегодня — самая суть для вас.

Обозначим задачу: есть пайплайн, написанный с привычными для Data Scientist фреймворками типа Scikit-learn. Это нужно перенести в кластер Spark’а. Посмотрим, в чем тут может быть проблема. 

Читать далее

Модели глубоких нейронных сетей sequence-to-sequence на PyTorch (Часть 4)

Время на прочтение19 мин
Охват и читатели4.5K

В этой части мы добавим несколько улучшений — упакованные дополненные последовательности и маскировка — к модели из предыдущего раздела. Упакованные дополненные последовательности используются, чтобы сообщить нашей RNN, что нужно пропускать маркеры заполнения в нашем кодировщике. Маскировка явно заставляет модель игнорировать определенные значения, такие как внимание к элементам с заполнением. Оба эти метода обычно используются в обработке естественного языка (NLP).

Кроме того, мы рассмотрим как использовать нашу модель для вывода целевого предложения, давая ей входное предложение, видя результат её перевода, и выясняя, на что именно она обращает внимание при переводе каждого слова.

Наконец, мы будем использовать метрику BLEU для измерения качества наших переводов.

Читать далее

DataScience Digest — 15.07.21

Время на прочтение2 мин
Охват и читатели2.1K

Встречайте свежий выпуск дайджеста полезных материалов из мира Data Science & Machine Learning подготовленный командой Data Phoenix и не забывайте подписываться на наш Telegram-канал.

Читать далее

Модели глубоких нейронных сетей sequence-to-sequence на PyTorch (Часть 3)

Время на прочтение13 мин
Охват и читатели4.6K

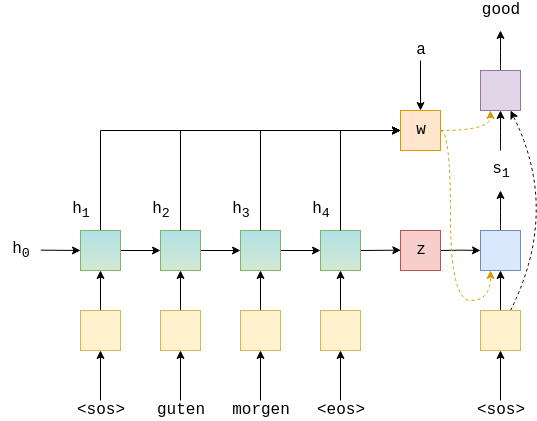
В этом третьем посте о моделях sequence-to-sequence с использованием PyTorch и torchText мы будем реализовывать модель из стать Neural Machine Translation by Jointly Learning to Align and Translate. Эта модель демонстрирует лучшую точность из из трёх моделей (~27 по сравнению с ~34 у предыдущей модели).

Читать далее
Тебя заморозили, чтобы разбудить в будущем. Здорово? Ты тоже так думал, пока не проснулся и не увидел, что вокруг одни роботы. И они не очень-то рады человеку: у них и так безработица, кризис, цены на гелий-3 растут, а тут ещё и ты из прошлого понаехал. Но ты программист, а программисты не сдаются! Вместе с Академией больших данных MADE от Mail.ru Group мы подготовили задачи, с которыми не справились местные ИИ. Готов решить их и доказать, что человека не заменить? Тогда вперёд! В будущем всё же есть один плюс: все документы и медосмотр тут делает ИИ. Занимает это считанные секунды, и никакой бюрократии. Вот и новая работа… Ты заглядываешь через плечо коллеги-робота и от удивления чуть не роняешь нанокружку. Да это же код на Python! Что ж, хоть какие-то человеческие ценности вечны!
Ладно, где там задачи? Подайте их сюда!

Модели глубоких нейронных сетей sequence-to-sequence на PyTorch (Часть 2)

Время на прочтение10 мин
Охват и читатели8.4K

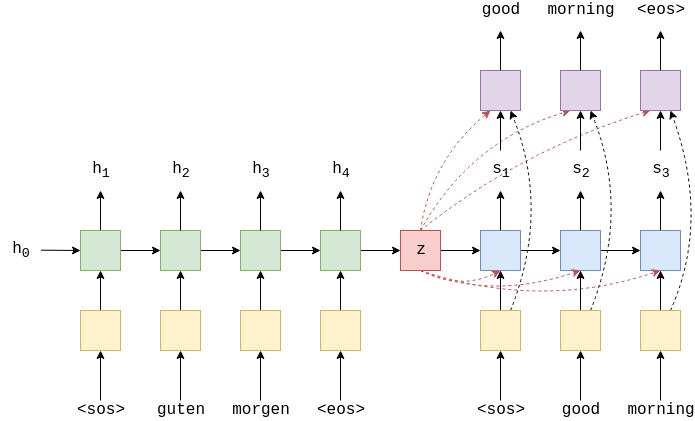
Во втором разделе учебных материалах о моделях sequence-to-sequence с использованием PyTorch и TorchText мы будем реализовывать модель из работы Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation. Эта нейронная сеть позволит достичь лучшей точности при использовании только однослойной RNN как в кодере, так и в декодере.

Читать далее

Как контейнеризировать среды ML разработки и не посадить на мель процессы MLOps

Время на прочтение11 мин
Охват и читатели5.1K


Проблема эффективного создания продуктов на базе Machine Learning в бизнесе не ограничивается подготовкой данных, разработкой и обучением нейросети или другого алгоритма. На итоговый результат влияют такие факторы, как: процессы верификации датасетов, организованные процессы тестирования, и размещение моделей в виде надежных Big Data приложений.
Бизнес-показатели зависят не только от решений Data Scientist’а, но и от того, как команда разработчиков реализует данную модель, а администраторы и инженеры развернут ее в кластерном окружении. Важно качество входных данных (Data Quality), периодичность их поступления, источники и каналы передачи информации, что является задачей дата-инженера. Организационные и технические препятствия при взаимодействии разнопрофильных специалистов приводят к увеличению сроков создания продукта и снижению его ценности для бизнеса. Для устранения таких барьеров и придумана концепция MLOps, которая, подобно DevOps и DataOps, стремится увеличить автоматизацию и улучшить качество промышленных ML-решений, ориентируясь на нормативные требованиям и выгоду для бизнеса. Применять подходы MLOps необходимо на всех этапах создания ML решений.

В статье мы поговорим об использовании принципов и практик MLOps на стадии разработки моделей, и расскажем как самим развернуть сервис самообслуживания по созданию сред разработки для дата-саентистов.
Читать дальше →