Обновить
256K+

Python *

Высокоуровневый язык программирования

360,82
Рейтинг
Сначала показывать
Период
Уровень сложности
Формат публикации

58 рекламных роликов, которые я не снимал, а закоммитил

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4.4K

Мой главный актёр не умеет повторять дубль. Попросил его сказать фразу — он сначала зевнул, потом ушёл к краю экрана и только потом сказал. Поправил текст реплики — «тот же самый» дубль уже не снять, будет другой путь и другая поза.

Читать далее

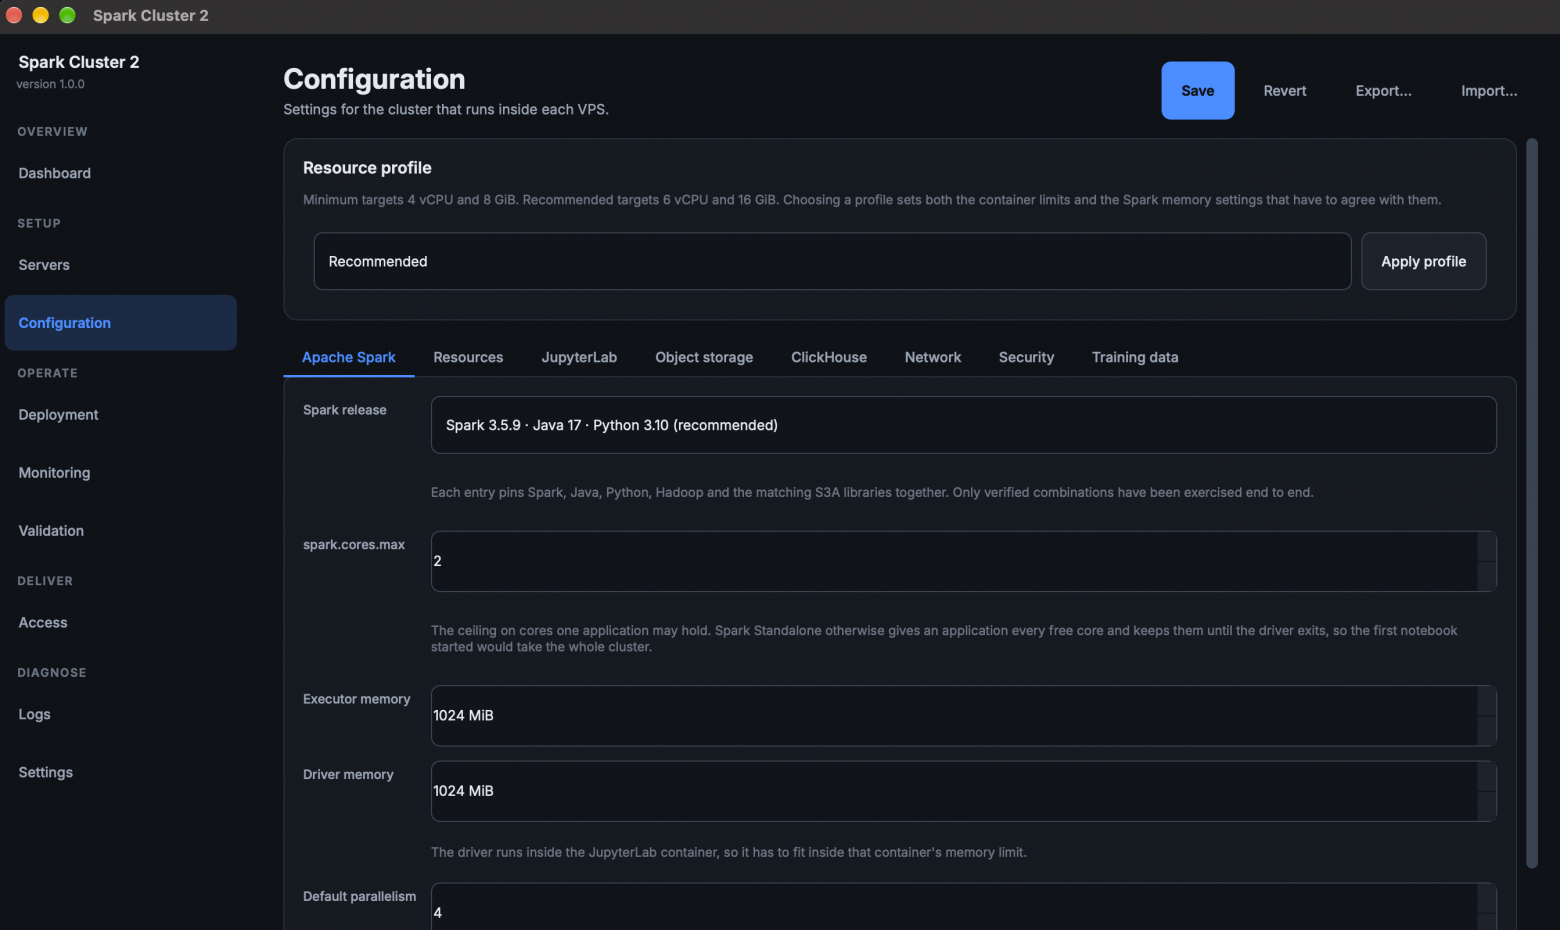
Spark Cluster 2: как я создал приложение для автоматического развёртывания Apache Spark

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели5.6K

Привет, Хабр!

В процессе преподавания дисциплин, связанных с анализом больших данных и распределёнными вычислениями, я регулярно сталкиваюсь с необходимостью организовывать практическую работу студентов с Apache Spark. На первый взгляд задача достаточно простая: подготовить серверы, установить необходимые компоненты, настроить взаимодействие между ними и предоставить студентам доступ к работающему кластеру.

Но когда речь идёт не об одном стенде, а о целой учебной группе, подготовка инфраструктуры превращается в отдельную задачу. Особенно если каждому студенту необходимо предоставить собственный кластер для выполнения лабораторных работ. Некоторое время назад я решил автоматизировать этот процесс и разработал небольшое настольное приложение для развёртывания Apache Spark на виртуальных серверах.

Читать далее

Nvidia представила открытый проект SkillSpector. Сервис сканирует любой навык для ИИ перед установкой и ставит ему...

Охват и читатели4.4K

Nvidia представила открытый проект SkillSpector. Сервис сканирует любой навык для ИИ перед установкой и ставит ему оценку безопасности и уровень риска от 0 до 100. Проект помогает найти в навыках для ИИ ощибки в ИБ, включая публикацию ключей API, пересылку данных на чужие адреса, запуск вредоносных скриптов со сторонних сайтов.

Читать дальше →

Представлен открытый проект FacePlugin (Open Source Face Recognition SDK). который позволяет создать собственный Face...

Охват и читатели5K

Представлен открытый проект FacePlugin (Open Source Face Recognition SDK). который позволяет создать собственный Face ID и ставить систему распознавания лиц в своих проектах и приложениях:

Читать дальше →

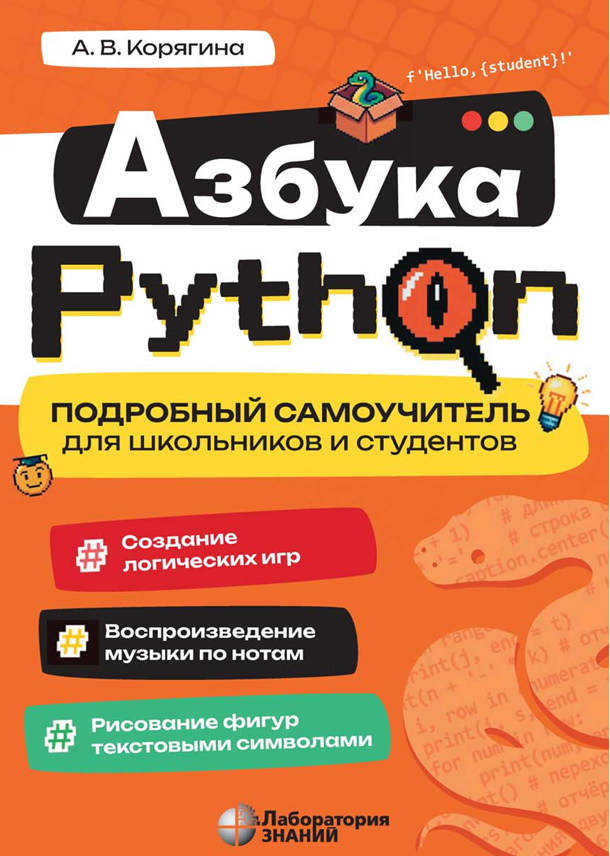
Книга по Python для школьников и студентов

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели5.4K

В образовании я уже второй десяток и все мои учебные программы создаются самостоятельно. Каждый год я обновляю их новыми алгоритмами, идеями занятий согласно возрастным особенностям учащихся и требований по стандартам как государственным, так и бизнеса. Обучаю математике, программированию и робототехнике, как в рамках школьного и дополнительного образования, затрагивая вузовскую программу, так и в рамках индивидуальных занятий для приобретения человеком тех или иных навыков и знаний в профессиональной деятельности.

Поэтому всегда изучаю вышедшие книги, обновления софта и так далее. Одной из сложных задач является составления интересных учебных программ для школьников, так чтобы они отвечали и ФГОС, и подходу STEAM. Дети лучше понимают академический материал на наглядных примерах, которые дают им либо новый опыт познания мира, либо служат хорошим прикладным инструментом для решения насущных задач.

Книг такого характера можно пересчитать по пальцам, у которых действительно есть связь со школьной программой, условно, от 3 до 11 класса по определённым предметам. В моём случае — это математика, информатика и физика. И вот относительно недавно у меня появилась новая книга, отвечающая заданным критериям, под названием «Азбука Python. Подробный самоучитель для школьников и студентов».

Читать далее

Если спросить у нейросетей на английском про российский бренд, в ответах почти не будет русскоязычных источников

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели11K

Допустим, ваш продукт продаётся в России и за рубежом, и по-русски нейросети уже ссылаются на ваш сайт и статьи. Я проверил, переносится ли это на английский: сравнил, из каких сайтов Google AI Overviews, Perplexity и Алиса AI собирают ответы на русские и на английские вопросы. В Google и Perplexity русских сайтов на английском почти не осталось, хотя регион в настройках Google стоял российский. Видимость по-русски сама в английскую не превратится, её придётся строить отдельно.

Читать далее

Как я заставил ИИ-агентов собирать себе harness под конкретную задачу

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели8.9K

Я дал Claude Code (Opus 5.5) тестовое задание: нарисовать в SVG сцену из «Бегущего по лезвию 2049». Агенты, которые я пробовал, провалили его одинаково: на настоящий кадр никто не посмотрел, рисовали по памяти и сообщали бездумно, что готово. Тогда я начал подсказывать агенту вопросы: есть ли документация, с чем сравнивать результат, когда остановиться. Из этих вопросов вырос AutoHarness — скилл, который заставляет агента подготовиться к задаче до того, как он начнёт её делать.

Читать далее

ChatGPT теперь можно подключить прямо к Blender — представлен открытый проект loopcut, который помогает...

Охват и читатели3.9K

ChatGPT теперь можно подключить прямо к Blender — представлен открытый проект loopcut, который помогает встроить ИИ‑агента в 3D‑редактор, чтобы управлять сценами обычными текстовыми запросами. Нейросеть может настраивать освещение, редактировать объекты, работать с материалами и писать код на Python.

Читать дальше →

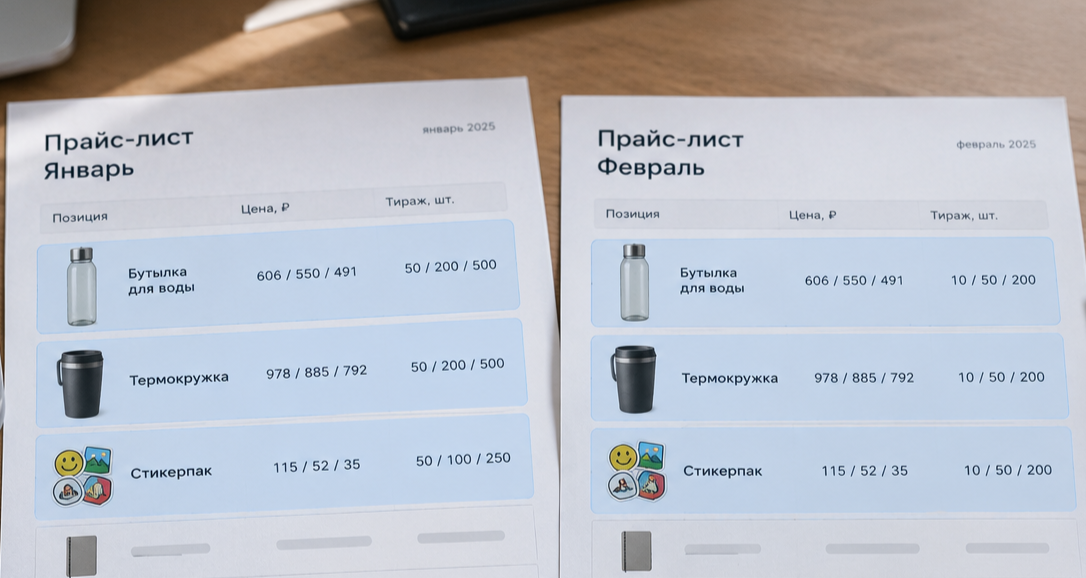
Цена за 50 штук записалась в колонку «200 штук»: разбираю 42 PDF с коммерческими предложениями

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.4K

У нас в мастерской за год накопилась папка коммерческих предложений: 42 PDF, 532 страницы, 650 мегабайт. Прайсы, презентации, предложения под конкретных заказчиков. Мне понадобилась из неё одна таблица: позиция, тираж, цена за штуку. Вопрос простой: насколько дешевеет изделие, когда тираж растёт с 10 до 200 штук, и одинаково ли это работает для футболки и для стикеров.

Казалось, что это вечер работы: снять текст, найти числа рядом со словом «шт», сложить. Вышло иначе, и почти все ошибки по дороге были тихими. Скрипт отрабатывал без исключений и выдавал правдоподобные числа, которые не совпадали с тем, что напечатано на странице.

Читать далее

mAP50 = 0,99 за 22 минуты на CPU. Жаль, что цифра ничего не значит

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели4.9K

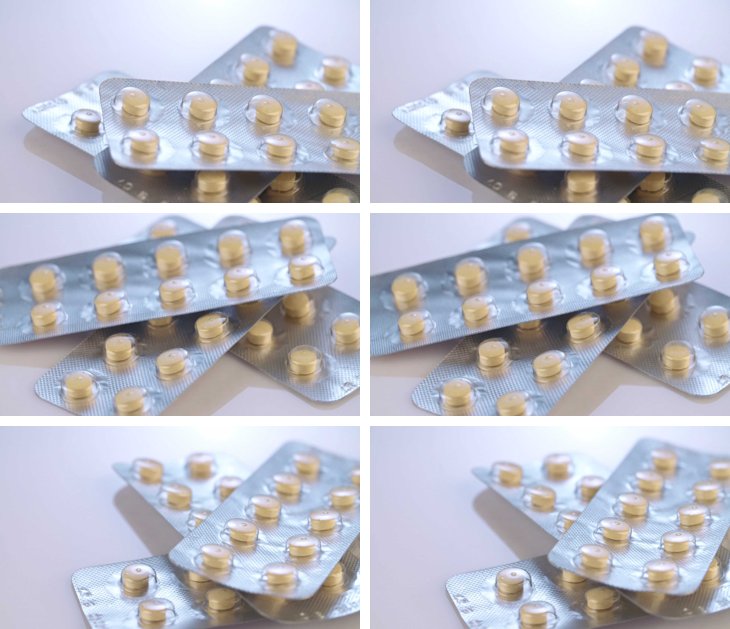
Я дообучил YOLO11n на датасете medical-pills из документации Ultralytics: 60 эпох, 22 минуты на ноутбучном Ryzen 7, mAP50 = 0,991 на валидации. По всем признакам — успех: можно делать скриншот и рассказывать, как легко сегодня учить детекторы.

Потом я прогнал тот же датасет через dataset-doctor — свою проверялку датасетов — и узнал, что у каждого из 23 валидационных кадров есть почти точная копия в train. Валидация измеряла не «как модель справится с новыми таблетками», а «как хорошо модель помнит то, что уже видела».

Под катом: что именно нашлось, почему метрика при этом не врёт в прямом смысле, но и не говорит ничего полезного, как ловить такую утечку за два десятка строк на Python (dHash плюс корзины) и как делить данные, чтобы её не было.

Читать далее

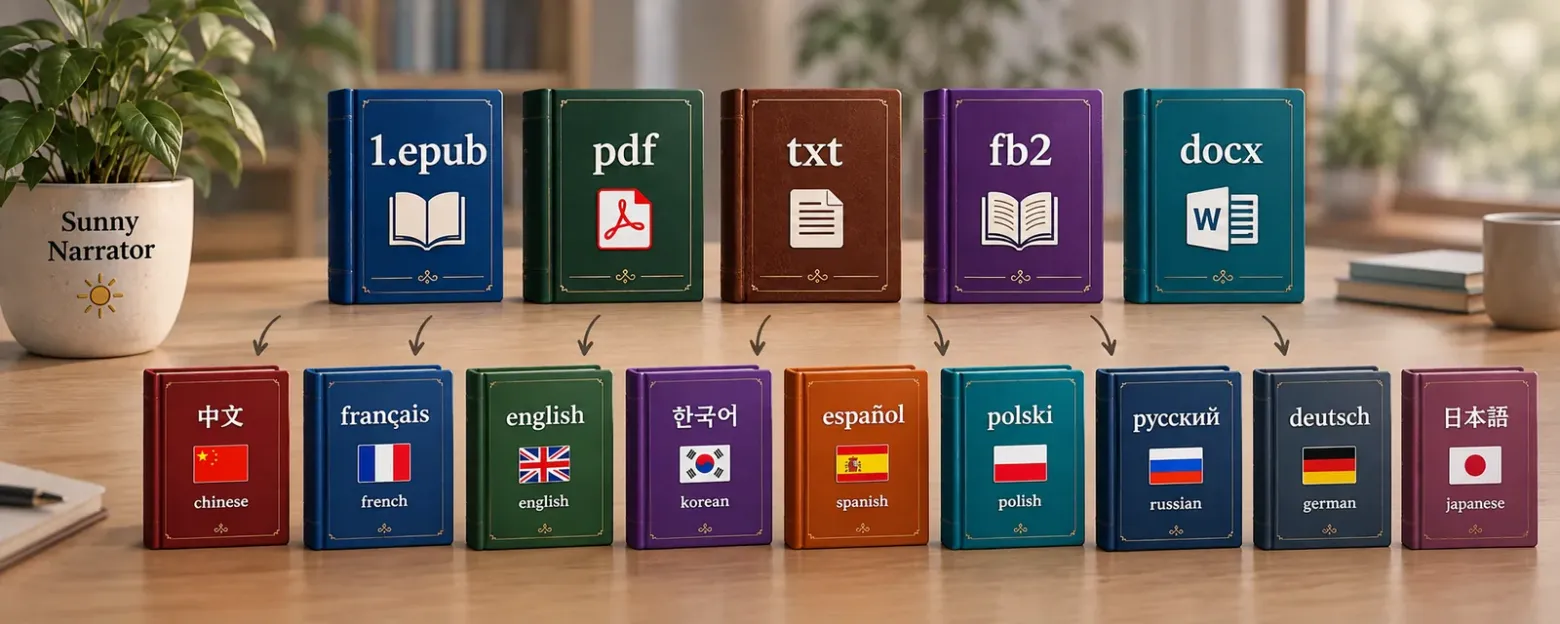
Снижаем барьеры: переведённая книга за день — без видеокарты, почти без Python

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели6K

Третья статья о Sunny Narrator — переводчике книг нейросетями «для себя». Первая была про прототип, который переводил тысячу страниц два дня. Вторая — про словари, скорости и то, почему переводчики всё ещё нужны. Эта — про то, что запустить перевод теперь может почти любой.

ОФФтопик : Мне тоже жаль что Хабр да и весь инет залит нейрослопом, сырыми ИИ-продуктами, да и вообще, мы не так что бы нужны. Это не реклама - если вам она кажется такой поставь минус и получи мое сердечко и пусть у тебя будет хороший день завтра.

Это статья для тех кому нужн перевод некоего художественного текста либо для тех кто решил открыть для себя мировую литературу и не осилил другие языки как и я (посыпаю голову пеплом), но вот не смог.
Коротко: немного питона и 100 рублей денег на сервисы нейронок и полдня . Такова цена входа. Ну для тех кто любит пожестче я уже писал - там CUDA, сервера , claude\chatgpt и прочеее длиной в месяцы и годы. Поэтому статья разделилась на две части:

Читать далее

AG‑UI 1.0: у протокола наконец появилась спецификация. Разбираем, что изменилось, на связке AG2 + CopilotKit

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели5.7K

15 октября Tesla показала летающий Roadster, а мы разберём не менее важное: вышел AG-UI 1.0 - мажорный релиз протокола между агентом и интерфейсом. Что в нём нового и как это выглядит на связке AG2 + CopilotKit

Читать далее

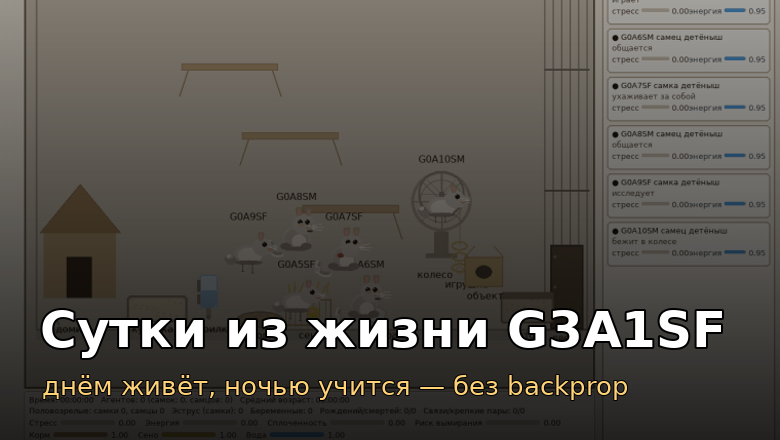
Сутки из жизни G3A1SF: как я учу агента без backprop — днём он живёт, ночью учится

Время на прочтение12 мин
Охват и читатели6.8K

Что происходит с агентом, который не решает одну задачу, а живёт — долго, в мире, который всё время меняется? Я собрал NOWA-Cognitive, когнитивную архитектуру без backprop, без глобальной функции потерь и без языковой модели в контуре решений: днём агент записывает опыт быстро и «начерно», а долговременную память переписывает ночью, во сне. Рассказываю, как это устроено, на примере одних суток одной шиншиллы из колонии — G3A1SF.

Читать далее

Ближайшие события

Полный гайд по локальному запуску DeepSeek на русском: от домашнего ПК до сервера с 8 GPU В открытом доступе...

Охват и читатели4.2K

Полный гайд по локальному запуску DeepSeek на русском: от домашнего ПК до сервера с 8 GPU

В открытом доступе руководство из 18 частей о том, как запустить DeepSeek V4, R1 и дистилляты у себя, без облака и интернета. Бесплатно, приватно и офлайн.

Внутри весь путь: выбор модели и расчёт железа, установка и настройка Ollama, llama.cpp, LM Studio, Open WebUI, vLLM и SGLang, работа через API и Python, подключение к IDE. Дальше промптинг, ускорение, RAG, агенты и fine-tuning, а в конце топ-30 приёмов, разбор ошибок, FAQ и готовые конфиги.

Для домашнего ПК основной вариант это R1-дистилляты от 1.5B до 70B. Запуск одной командой: ollama run deepseek-r1:8b. По таблицам гайда в кванте Q4 модель на 8B занимает 5-6 ГБ памяти, на 14B около 9-10 ГБ, на 32B около 20 ГБ, на 70B около 43 ГБ.

Старшие модели уже про серверное железо. DeepSeek-V4-Flash на 284B параметров, из них 13B активных, с контекстом 1M требует около 103 ГБ в 3-битном кванте. DeepSeek-V4-Pro на 1.6T параметров с 49B активными нужны 800 ГБ и больше, то есть сервер с 8 GPU.

Несколько практичных советов из гайда. Для русского языка брать модели от 14B, на меньших дистиллятах качество заметно проседает. Квант Q4_K_M считается стандартным выбором, а большая модель в низком кванте обычно лучше маленькой в высоком. Температура около 0.6 для R1 и 1.0 для V4. Проверять через ollama ps, что модель целиком на GPU. И не открывать порт Ollama 11434 в интернет: у API нет пароля.

Репозиторий: https://github.com/justxor/deepseek-local-guide-ru

Читать дальше →

Как я собрал модель для определения стадии диабетической ретинопатии на бесплатном Colab

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели7.4K

Предыстория

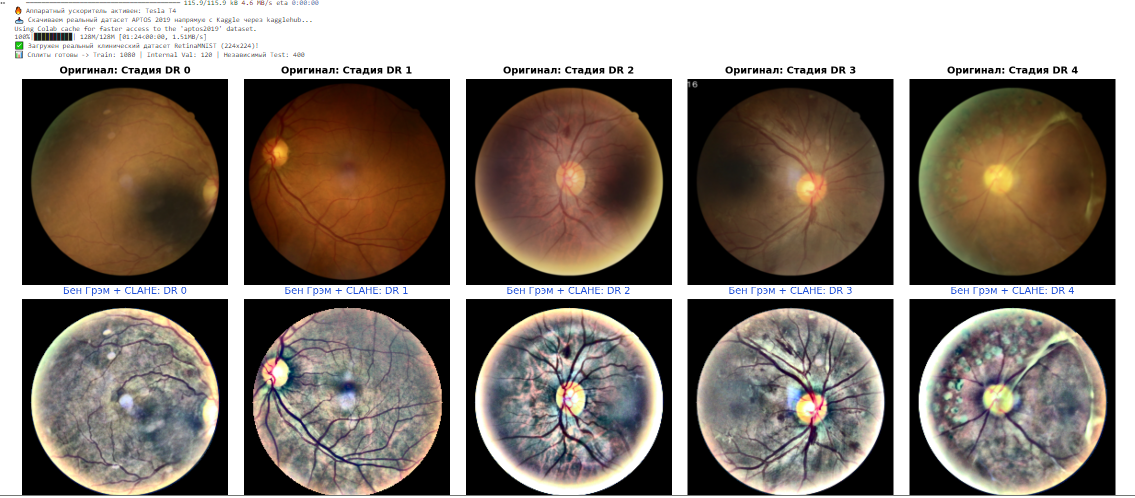
Я собрал двухпоточную модель: она смотрит на снимок глазного дна и одновременно получает клинические показатели пациента. На отложенном тесте первый запуск дал QWK 0.834. Потом я стал разбираться, за счёт чего, и оказалось, что клинические признаки в моих данных содержат ответ. Я поставил три контрольных эксперимента, в том числе обучил отдельную модель только по снимкам. У неё QWK 0.713. Ниже весь пайплайн и способы, которыми такая утечка находится.

Читать далее

Звезды Telegram: где купить, сколько стоят и как все работает

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.1K

Хотел купить звезды Telegram подешевле - в итоге разобрался, как самому их продавать.

Открыл поиск, а там звёздами торгуют все подряд. Даже МТС. Покупка одна и та же, цены разные - стало интересно, сколько можно сэкономить и что вообще делает продавец после того, как получает деньги.

Так обычный поиск дешёвых Stars превратился в разбор всей цепочки: от ввода имени получателя до платежа и подтверждения покупки. В приложенном коде можно увидеть, как эти действия автоматизированы.

Начну с цен: сравню МТС, SMMESE и ещё один сервис на одинаковом количестве звёзд, чтобы определить самый дешёвый вариант среди них. Затем покажу механику покупки через Fragment и разберу код. Если захочется пойти дальше покупки для себя - этот механизм можно взять за основу собственного сайта по продаже звёзд Telegram.

Читать далее

Последний пинг: tower defense про защиту дата-центров Сделал браузерную игру, в которой нужно защищать дата-центры от...

Охват и читатели6.8K

Последний пинг: tower defense про защиту дата-центров

Сделал браузерную игру, в которой нужно защищать дата-центры от дронов, ракет и тяжёлых машин. В обороне участвуют роверы и условные зенитные установки. Всё аркадное: никаких реальных характеристик вооружения.

Главный ресурс — энергия. Нужно балансировать между обороной, ремонтом и развитием. Серии перехватов заряжают способности, после волн можно выбирать улучшения, а следующую волну — вызвать досрочно ради бонуса. Если уверен в своей расстановке.

Сейчас доступны четыре карты. На Севере приходится распределять обогрев, в Порту — перевозить батареи между секторами, на Крышах — защищать сразу три дата-центра. Есть три сложности и боссы с несколькими фазами.

Разработку вёл с AI-агентами: отдельно реализация, отдельно ревью и проверки. Игровая логика покрыта 79 тестами, включая прохождение всех сочетаний карты и сложности. Проверки в браузере дополняют тесты, но не заменяют живых игроков: интересный баланс одними зелёными галочками не доказать.

Поиграть без установки и регистрации: td.kosarevsky.dev

Интересно, какую тактику вы найдёте и на какой волне игра впервые заставит её пересмотреть.

tg

Читать дальше →

decision-cascade: открытый движок машинных решений против проприетарных System One-моделей На GitHub появился...

Охват и читатели4.1K

decision-cascade: открытый движок машинных решений против проприетарных System One-моделей

На GitHub появился decision-cascade — локальный движок принятия решений, который возвращает типизированные, калиброванные ответы вместо генерации текста. Автор позиционирует его как открытую альтернативу проприетарным System One-моделям вроде Jev от TypeSafe AI, но с полным контролем над данными и инфраструктурой.

Что это. Вместо авторегрессионной генерации движок превращает состояние (строку-описание ситуации) в признаки через энкодер, а головы решений возвращают строго типизированные вероятностные ответы трёх типов: Noul (да/нет с вероятностью), Choice (выбор из опций) и Score (оценка на шкале). Каждый ответ — датакласс с полем confidence, валидируемым распределением и версией схемы. В режиме cascade локальные головы отвечают сами, а внешняя модель подключается только при уверенности ниже порога (по умолчанию 0.6).

Индивидуальность. Рынок System One-моделей оживился: Cloudflare Clef, Perplexity pplx-decider, ConvAI Laya. decision-cascade отличается тремя вещами. Во-первых, это полный цикл в одном репозитории: обучение голов через SFT, RLCD-калибровка с гейтом «не навреди», метрики ECE/Brier, latency-профилирование и деплой через systemd. Во-вторых, совместимость с протоколом SystemOne (POST /v1/systemone) без облачной зависимости и умение проксировать запросы к Jev/Clef/Laya через DECISION_BACKEND=http — свои данные можно обрабатывать локально, а сложные случаи эскалировать. В-третьих, честная мультимодальность: сервис объявляет поддерживаемые модальности и отклоняет остальные типизированной ошибкой, а не тихо деградирует.

Читать дальше →

Мой бот прислал мне репо-ловушку с 1774 звёздами. Разобрал 321 репо из трендов и собрал два фильтра

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели7.3K

У меня есть Telegram-бот, который каждое утро присылает пять трендовых репозиториев GitHub с trendshift.io. Под каждым кнопка: нажал, и бот выдаёт выжимку README, чтобы разобрать идею. Я читаю эту ленту каждый день и иногда ставлю то, что понравилось.

26 сентября в ленте был «Microsoft Activation Scripts»: 1774 звезды, аккуратное описание, теги. Бот оформил его так же, как четыре соседних проекта, с той же кнопкой.

Это была ловушка.

Читать далее

Как я поставил дешёвую модель-фильтр перед Claude и что показали первые две недели

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели11K

Сохраняю в Telegram всё подряд, а Claude Sonnet раз в сутки пишет по каждому материалу разбор для блога. Почти половина сохранёнок для блога лишняя, и на каждую уходит полный разбор. Рассказываю, как поставил перед Sonnet дешёвую модель Jev, которая отвечает вероятностью, почему формулировка вопроса оказалась важнее модели (AUC 0,46 против 0,95), какие предохранители стоят в коде и что показал журнал за две недели.

Читать далее