Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

107,45
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Репликации в PostgreSQL

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели114K

Один инстанс PostgreSQL в продакшене — это риск для отказоустойчивости и производительности. В статье разберём, зачем нужны реплики, чем физическая репликация отличается от логической и как настроить базовые сценарии на практике.

Читать далее

PostgreSQL Antipatterns: Индиана Джонс и максимальное значение ключа, или В поисках «последних» записей

Время на прочтение2 мин
Охват и читатели11K

Сегодняшняя задача вполне традиционна для любых учетных систем - поиск записей, содержащих максимальное значение по каждому из ключей. Что-то вроде "покажи мне последний заказ по каждому из клиентов", если переводить в прикладную область.

Кажется, что тут и споткнуться-то негде в реализации - но все оказывается совсем не тривиально.

Читать далее

Магия оптимизации SQL запросов

Время на прочтение7 мин
Охват и читатели83K

Даже самый простой SQL запрос можно выполнить по-разному. Но из всех вариантов СУБД нужно выбрать оптимальный, как же это сделать? Неужели придётся перебрать все возможные варианты? Давайте разбираться.

Читать далее

Парсинг HTML с помощью PHP и SQL. Немного провокационный пример с анализом пользователей Хабра

Время на прочтение11 мин
Охват и читатели13K

Выковыривание информации из html — это скучно. Очень. Между тем, эта потребность выстреливает редко, но метко (© Суворов). Из-за этого есть спрос на готовые и короткие инструкции о том, как это сделать, чтобы не тратить время на изучение. Перед вами как раз такая.

Чтобы добавить хоть какой-то интерес скучнейшему занятию мы для примера будем парсить пользователей Хабра. А чтобы не мелочиться — ещё и реанимируем для этого экспериментальную библиотеку 11-летней давности.

Есть такой проект — htmlSQL. Старая библиотека времён Очаковских и покоренья Крыма (© Грибоедов). Она позволяет делать выборку из HTML в стиле SQL-запросов как на КДПВ, чем она мне когда-то и полюбилась.

Воскресим старую любовь?

Как создать свою СУБД с нуля и не сойти с ума. Практическое пособие начинающему некроманту. Часть первая

Время на прочтение43 мин
Охват и читатели45K

Наступил Апокалипсис.

Нет, не стоит бежать запасаться банками с консервами и крышками отечественной бай-колы! Апокалипсис произошёл только в нашей фантазии и с определённой целью — чтобы проверить, а может ли человек, обладающий только книгами по теме и стандартной библиотекой языка, воссоздать инструмент, который будет служить ему верой и правдой?

Так родился учебный проект SicQL, реляционная СУБД, чей символ — сова — это олицетворение силы знаний и мудрости. Олицетворение тех знаний и той мудрости, которые мы получим, создав с нуля то, чем мы пользуемся каждый день, может, не осознавая всей сложности таких инструментов.

Приглашаю присоединиться к увлекательному путешествию!

Принять приглашение на борт

Запись в БД некой ИС (информационной системы), которая хочет ПБ (поработать бесплатно) или новые «записки шизоидов»

Время на прочтение5 мин
Охват и читатели6.5K

Мотивированный ИТ-шник, он же реципиент почки, хочет что-то поменять в стране в плане трансплантации органов (лист ожидания).

Суть вопроса: какая информационная система (ИС) в РФ подбирает и распределяет донорские органы? В идеале, покажите код (возьмите на работу на 0.01 ставки, вдруг я на что-то сгожусь, как мотивированный разработчик или тестировщик в прошлом).

Читать далее

Как изучить SQL за 2 месяца с нуля. План обучения

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели111K

То, что данные называют нефтью 21 века известно уже давно: на них учатся нейросети, их мгновенная обработка и передача сильно упростили нашу жизнь, и одной из самых распространенных структур хранения данных является реляционная.

Основным инструментом для взаимодействия с реляционными БД является структурированный язык запросов или же SQL.

Вкратце, на мой взгляд, необходимо знать следующие разделы:

Читать далее

Как выбрать NewSQL-СУБД для вашей компании

Время на прочтение7 мин
Охват и читатели8.7K

Привет! Меня зовут Пётр, я менеджер по отказоустойчивости в QIWI. В этом посте мы поговорим про выбор новых классов продуктов. Как-то раз мы с одним разработчиком из другой компании стали обсуждать, почему бы не выбрать для работы какую-то распределенную СУБД, поддерживающую SQL? Из этой дискуссии родился мой доклад для нашей QIWI Server Party. Представляю вам его текстовую версию.

Читать далее

Будьте внимательны при использовании AT TIME ZONE в запросах SQL Server

Время на прочтение2 мин
Охват и читатели3.3K

Если вы не разобрались в тонкостях работы базы данных, то использование новых средств языка T-SQL может привести к неожиданным результатам в плане производительности.

Читать далее

Сравнение производительности обычного SQL, ORM и GraphQL в Golang в контексте принципов «радикальной простоты»

Время на прочтение6 мин
Охват и читатели8.8K

Вам, наверное, знаком подход радикальной простоты, который заключается в том, чтобы иметь как можно меньше систем и наименьшее количество строк кода и конфигурации. Это снижает затраты на техническое обслуживание и делает изменения дешёвыми и лёгкими. Но радикальная простота не означает использование ассемблерного кода или C.

При написании серверного кода для чтения из базы данных разработчики обычно используют прямой SQL либо ORM. ORM экономит время на написании SQL-кода, но снижает производительность и увеличивает потребность в большем количестве классов. Прямой SQL быстрее и содержит меньше типовых строк кода, но его сложнее...

Читать далее

Применение регулярных выражений для обработки данных

Время на прочтение4 мин
Охват и читатели7.1K

История создания регулярных выражений берет свое начало с 1942 года. В то время Уолтер Питтс — американский логик, работавший, в основном, в области когнитивной психологии, работал  с известным физиологом Уорреном МакКаллоком. Основой их работы были труды связанные с теоретическим построением нейронных сетей. Немного позже, американский математик Стивен Клини изучал события в сетях МакКаллока-Питтса и предложил способ описания таких событий при помощи языка регулярных выражений.

Работа Клини вышла в середине 50-х годов двадцатого века. Научные труды были бы забыты, но американский программист Кен Томпсон в конце 60-х годов обнаружил, что регулярные выражения можно использовать для задания шаблонов поиска строк в длинных текстах. Смысл поиска заключается в том, что регулярное выражения преобразуется в конечный автомат, который производит поиск строк, которые должны соответствовать определенным шаблонам. Для построения конечного автомата Томпсон придумал специальный алгоритм, который сейчас носит название «построение Томпсона». Таким образом Кен Томпсон смог принести в мир стандарт для задания поисковых шаблонов.

Сами по себе, регулярные выражения есть ни что иное, как текстовый шаблон, который соответствует какому-то тексту. В трудах Джеффри Фридла пишется, что: «Регулярные выражения— это мощнейший инструмент, хорошо известный программистам. Однако он может быть полезен не только программистам, но и всем людям, работающим с кодом или простым текстом». При использовании регулярных выражений человеку придется работать с литералами и метасимволами. Это два существенно различающихся по своей сущности понятия. Литералы – это обычные символы, т.е. при записи в строках регулярного выражения они интерпретируются так, как они записаны. Примером литералов в регулярных выражениях может быть любая буквенная последовательность. В свою очередь, метасимволы интерпретируются при поиске особым образом. Примером может служить символ «*», который задает последовательность любого количества литералов.

Читать далее

PostgreSQL в «Тензоре» — публикации за год (#3)

Время на прочтение3 мин
Охват и читатели4.1K

Под занавес уходящего года предлагаю традиционно вспомнить, про какие интересные возможности и особенности работы с PostgreSQL мы рассказали в нашем блоге.

Если не видели дайджест за прошлый год — время наверстать упущенное!

Читать далее

Как стать аналитиком? (и зачем)

Время на прочтение13 мин
Охват и читатели55K

Они носят множество имен: Data Analyst, Data Scientist, Business Analyst и т. д., но всех их объединяет одна основная черта — эти люди занимаются анализом данных. Итак, начнем с главного. Сколько получают аналитики?

Читать далее

Ближайшие события

Оптимизация поиска по большому полю

Время на прочтение10 мин
Охват и читатели7K
Вновь привет, уважаемые читатели Хабра! Работая с одной из систем хранения метаданных о файлах в «Лаборатории Касперского» вспомнил, что давно хотел написать об оптимизации поиска по большому полю в базах данных. О чем далее и расскажу более подробно.

В данной публикации будет рассмотрена оптимизация поиска по полю бинарного массива и, в частности, по равномерно распределенным данным, а также сравнение между собой выявленных способов.


Итак, представьте: у вас есть таблица в базе данных MS SQL, в которой десятки миллиардов строк данных. И в эту таблицу вставляются и удаляются суммарно десятки и сотни тысяч строк в секунду. Назовем эту таблицу dbo.metadata.

Замечание. Для проведенного анализа ниже была создана новая база данных TEST, в которой были созданы две таблицы dbo.metadata и dbo.sha256_checksum (о второй таблице будет написано ниже) и сгенерированы синтетические данные на 1+ млрд строк в каждую. После каждого вызова запроса проводился полный сброс кэша планов для базы данных TEST (DBCC FREEPROCCACHE), чтобы план для запроса каждый раз строился заново, а не брался уже готовый.

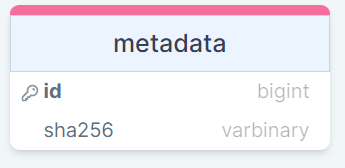
Таблица dbo.metadata упрощенно выглядит так:

Определение таблицы dbo.metadata
Читать дальше →

От Isolation к Consistency — дорога длиной в 30 лет

Время на прочтение17 мин
Охват и читатели11K

Участвую в стартапе, в котором разрабатывается СУБД нового типа (работает поверх некоторых kv-движков, кардинально расширяя их возможности, про это немного можно прочитать здесь). Для того, чтобы сравнить то, что понемногу получается, с тем, что имеется в индустрии, пришлось на глубоком уровне проработать первоисточники по темам Isolation и Consistency (уточню, что имеется ввиду не та Consistency, что в ACID). Обнаружил интересные нюансы, которые и излагаю в этой статье.


Тезисно:


  • Термин Phantom Read является продуктом испорченного телефона
  • Смысл понятий Lost Update, Write Skew и Read Skew для разделения уровней изоляций неочевиден и относителен
  • Движок, который обеспечивает уровень изоляции Serializable, в распределённом мире может вести себя весьма причудливо, например, всегда возвращать пустой результат для read-only транзакций — и ему за это по стандарту "ничего не будет"
  • Strong consistency в Cosmos DB — предел мечтаний? (спойлер: нет)

Ну, и ещё кое-что по мелочи. В конце рассмотрим вот такой венец творения человеческого разума:


Читать дальше →

Изучаем PostgreSQL. Часть 1. Знакомимся с архитектурой

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели194K

Пока PostgreSQL работает штатно, его архитектура легко кажется теорией. Но при зависших транзакциях, проблемах с производительностью или настройке кластера быстро выясняется, что без понимания внутренних процессов администрирование превращается в перебор параметров.
В статье разберём устройство PostgreSQL, отличия основных редакций и базовый сценарий установки на Ubuntu.

Читать далее

Миллион записей для змеи

Время на прочтение14 мин
Охват и читатели9.1K

Загрузить миллион записей в питон за секунду?
Нет. Получилось еще быстрее!

У меня есть небольшое хобби - я экспериментирую с машинным обучением применительно к торговле на бирже, в частности, с криптовалютами. После различных наколенных экспериментов я захотел создать удобный инструмент - базу торговых котировок. В процессе работы необходима быстрая загрузка достаточно большого количества данных. Это необходимо для расчетов, генерации данных для обучения, бэк-тестинга и других задач. Количество записей, которые нужно загрузить в питон довольно велико - речь может идти о миллионах и более записей.

Читать далее

PostgreSQL 16: Часть 3 или Коммитфест 2022-11

Время на прочтение10 мин
Охват и читатели7.1K

Продолжаем следить за новинками будущей 16-й версии. В начале декабря завершился третий коммитфест и вот его результаты.


Самое интересное из первых коммитфестов можно прочитать в предыдущих статьях серии: 2022-07, 2022-09.

Читать дальше →

Влияние сбора статистик на скорость выполнения запросов в СУБД TERADATA

Время на прочтение17 мин
Охват и читатели4.6K

Расскажу о такой важной особенности работы СУБД TERADATA, как сбор и использование статистик при выполнении запросов и как их наличие или отсутствие может повлиять на скорость выполнения таких запросов. Попытаюсь объяснить, что представляют собой статистики и для чего они нужны TERADATA.

Читать далее

DBA: хранение списков — таблица, массив, строка?

Время на прочтение4 мин
Охват и читатели21K

Достаточно часто при проектировании схемы БД возникает задача сохранить по основной сущности некоторый набор простых второстепенных данных.

Например, это могут быть ФИО сотрудников, принимающих участие во встрече, список приложенных к сообщению файлов или перечень отгружаемых по документу позиций.

Во всех этих случаях мы заранее понимаем, что список этот меняется редко и ни индексировать эти данные, ни искать по ним, ни извлекать отдельно от основной сущности (встречи, сообщения или документа), мы не захотим.

Давайте посмотрим, какие варианты хранения таких данных мы можем использовать в PostgreSQL, и какой из них окажется в разы более эффективным.

Читать далее