
SQL *
Формальный непроцедурный язык программирования


Безопасная разработка в Java

Язык программирования Java является одним из самых распространенных языков программирования. На нем написано множество сложных приложений как под Linux, так и под Windows. Однако, как и у любого другого языка программирования, у Java есть свои уязвимости.
Цель этой статьи познакомиться с уязвимостями, типичными для языка программирования Java, а также разобрать практики безопасного кодирования.

Sore query language, или 5 ошибок при первом изучении SQL

Эта статья о том, как аналитик изучает основы SQL, какие допускает ошибки и как старается их исправить. В статье будет то, что помогает погрузиться в SQL впервые: схемы и примеры кода, понятия и определения, проблемы и решения. Статья рассчитана на аналитиков-новичков.
Предыстория: аналитик создает отчёты в BI для директора компании «ABC». Аналитик не умеет программировать и подключается к данным по инструкции. Директор требует срочно добавить в отчёт данные из 3 источников: SAP – объем выручки от продаж; HRLink – затраты на персонал; Битрикс – время обработки заявок.
Аналитик ставит задачу data инженеру на добавление новых данных в BI. Data инженер – единственный специалист по работе с данными в офисе из 400 человек. Он критически оценивает сроки выполнения задачи и объявляет: «Минимум – 2 недели». Такой срок директора не устраивает. Инженер предлагает аналитику альтернативное решение...

Как выбрать для своего конвейера данных максимально эффективную архитектуру

Привет! Меня зовут Михаил Благов, я руководитель департамента «Чаптер инженеров данных и разработчиков» в beeline tech. В этом посте я хочу поделиться способом, с помощью которого можно выбрать подходящую архитектуру для конвейера данных в зависимости от требований к нему. В частности, обсудим паттерн CDC (change data capture, aka «захват изменений»), основная идея которого — быстрая репликация какого-то источника в аналитическое хранилище.
Под катом мы:
- познакомимся с вариантами архитектуры конвейеров данных: из каких компонентов и как его можно собирать,
- рассмотрим и сравним четыре разные архитектуры конвейеров.
Disclaimer: серебряной пули не будет, в этой статье я поделюсь опытом выбора архитектуры для решения конкретной задачи. Аналогичный выбор для других случаев потребует дополнительных исследований и замеров производительности.
Начнем с матчасти

SQL HowTo: крупицы золота в реестре
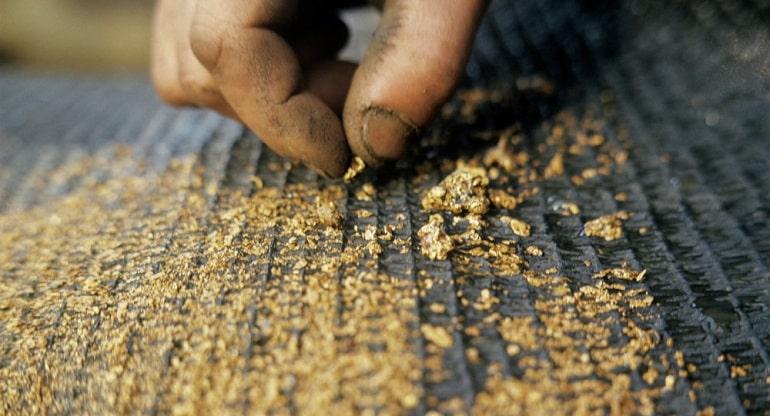
В большинстве учетных систем, типа нашего СБИС, рано или поздно возникает проблема быстрого отображения реестра, в который по просьбам бизнес‑пользователей накручено несколько комбинируемых фильтров с очень редкой выборкой, ну никак не ложащихся в вашу красивую структуру базы данных и индексов базовой таблицы реестра — что‑нибудь типа "список продаж покупателям, чей день рождения выпадает на 29 февраля".
Универсального способа сделать «хорошо» тут нет, но я расскажу про модель запроса, которая позволит вам дать пользователю быстрый отклик, но при этом весьма эффективно с точки зрения PostgreSQL.


Делаем ТруЪ-DevOps в мире хранилищ данных
Меня зовут Василий, и уже больше пяти лет я причиняю DevOps в хранилищах. Последние полтора года руковожу группой автоматизации хранилищ данных в Почтатехе.
В нашем data warehouse 6,5 петабайт активных данных. Вы и сами можете представить масштабы, когда речь идет о Почте России: работа сайта и приложения, логистика, трейсинг посылок и даже строительство сортировочных центров основываются на данных нашего хранилища.
Я расскажу, как мы применяем DevOps-практики на таких объемах DWH и как внедрить подобное у себя.

Наследование данных или иерархический справочник неограниченной глубины, который всегда возвращает значение…
Без справочников не обходится ни одна информационная система. Как правило, такие справочники представлены в виде одной либо нескольких таблиц, иногда связанных между собой. Одной из проблем является "неполнота" данных, когда справочник не заполнен по определенным позициям.
Необходимо разработать структуру справочника, который выдает значение "всегда", если нет значения в запрашиваемом узле справочника - должно быть выдано значение из вышестоящего уровня иерархии.

Справочники и документы. В чем сила 1С

Многие воспринимают 1С как платформу для автоматизации учёта, но одна из главных причин её живучести скрыта гораздо глубже. За привычными справочниками и документами стоит архитектурная идея, которая уже больше 25 лет помогает быстро создавать прикладные системы и остаётся актуальной даже на фоне современных low-code и enterprise-платформ.

Автоматизация маркетинга и продаж: 900+ заявок ежемесячно
После всем известных событий некоторые каналы привлечения платного трафика стали недоступны или существенно снизилась их отдача.
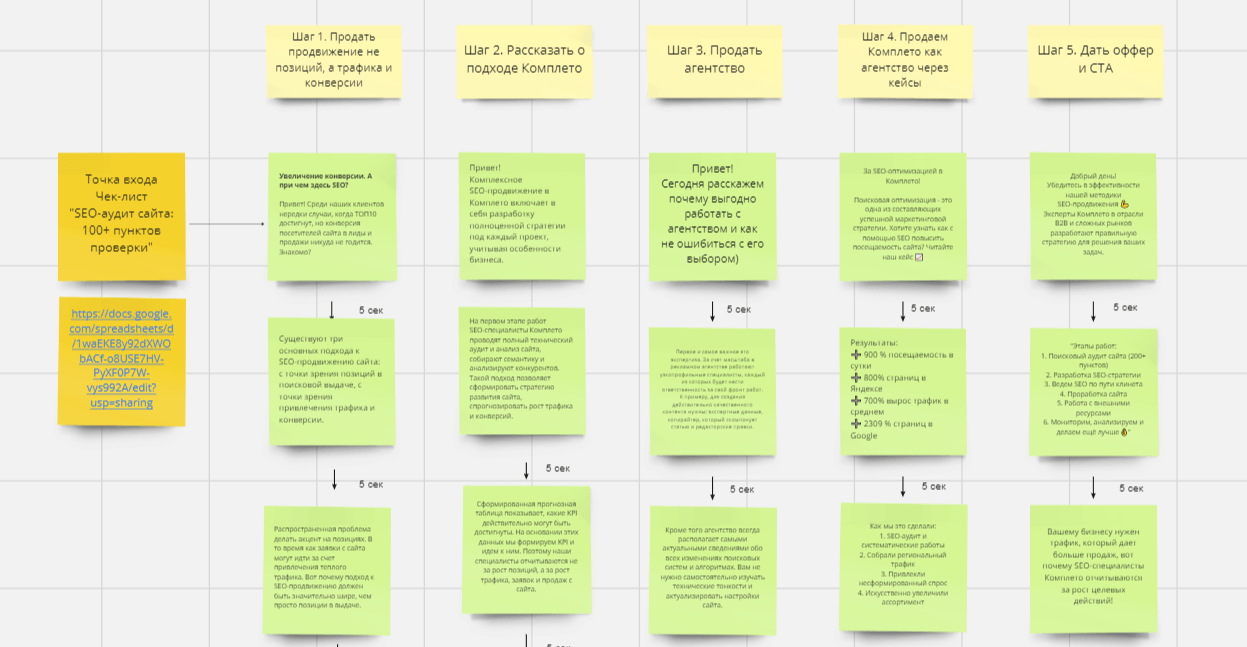
Мы в Completo более активно стали привлекать клиентов с помощью других инструментов. Это позволило не просесть по лидам. В результате мы получаем от 900 до 1200 MQL ежемесячно, в том числе благодаря автоматизации процессов. В этом материале делимся опытом и рассказываем, как работает автоматизация у нас.

8 книг по PostgreSQL: от баз данных с «нуля» для самоучек до руководства про БД в облаках
В целом, эта объектно-реляционная СУБД в дополнительном представлении не нуждается. Разработанная более 20 лет назад, она предназначена для создания и поддержки баз данных серверных приложений, в том числе ресурсоемких аналитических БД. Одна из особенностей PostgreSQL — открытый исходный код. Мы любим ее за развитое комьюнити и возможность развернуть «постгрю» самостоятельно и бесплатно.
Подготовили подборку полезных книг для тех, кто только начал или собирается работать с PostgreSQL. В нее вошли актуальные руководства на русском и английском языках. Если знаете еще одну-две отличных книги, смело рекомендуйте в комментариях.

Распределенный SQL: альтернатива шардированию баз данных
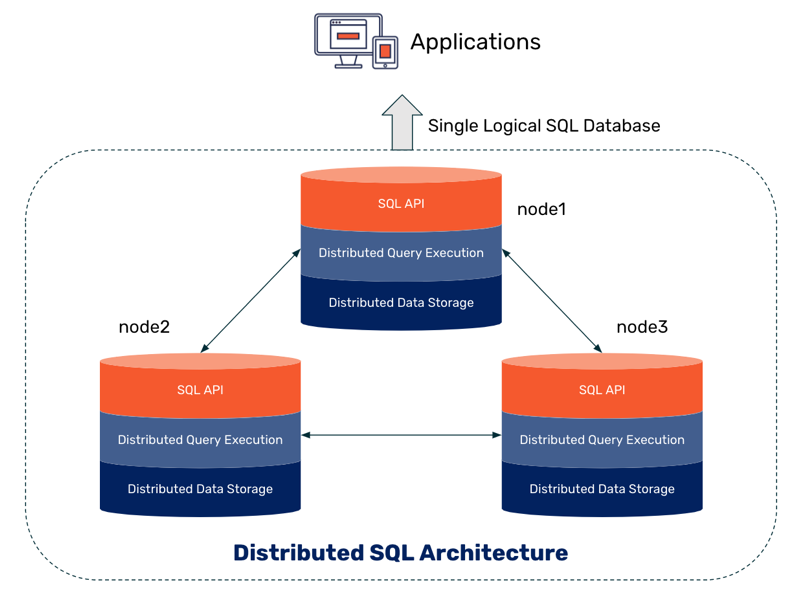
Шардирование баз данных – это процесс разделения данных на меньшие части, называемые «шарды». Эта техника обычно используется, когда возникает потребность в масштабировании записей. В течение жизненного цикла успешного приложения способность сервера его базы обрабатывать операции записи рано или поздно достигает своего предела. Деление данных на несколько шардов – с размещением каждого на собственном сервере БД – уменьшает нагрузку на отдельные узлы, по сути, повышая записывающую способность базы данных в целом. Этот процесс и является шардингом.
Распределённый SQL представляет новый способ масштабирования реляционных баз данных с помощью полностью автоматизированной и прозрачной для приложений стратегии, подобной шардингу. Распределённые БД SQL изначально спроектированы под практически линейное масштабирование. В текущей статье вы познакомитесь с основами распределённого SQL и узнаете, как начать работу с этими базами данных.

Проблема N+1 и как её решить с помощью EntityGraph
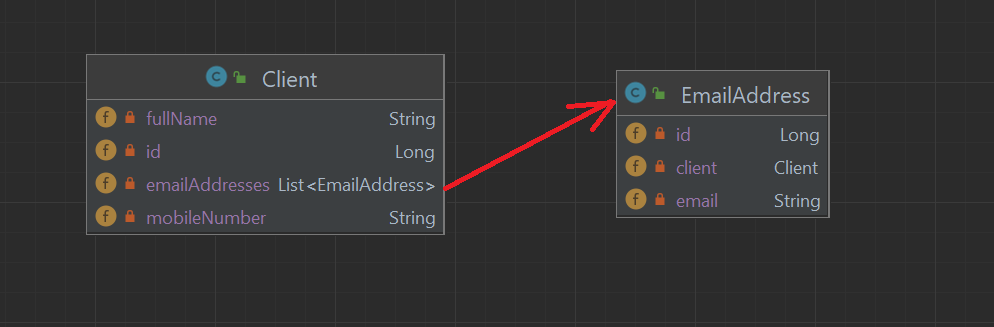
Всем привет! В данной статье попробуем разобраться с проблемой N+1 (или может правильнее 1+N?) и как ее решить с помощью использования EntityGraph.
Проблема N+1 возникает, когда мы генерируем запрос на получение одной сущности из базы данных, но у данной сущности есть свои связанные сущности, которые мы тоже хотим получить и hibernate генерирует вначале один (1) запрос к базе данных, чтобы получить интересующую нас сущность, а потом N запросов, чтобы достать из базы данных связанные сущности. Данная проблема отражается отрицательно на производительности работы базы данных из-за большого числа обращений к ней.
Создадим проект и подключим следующие зависимости:
Ближайшие события

Как я создавал свой первый дашборд на Visiology 3 и почему второй буду делать немного позже

Привет, Хабр! Меня зовут Салават Сафиуллин, и сегодня я хочу поделиться с вами своим первым опытом создания дашборда на Visiology 3. Это новая версия платформы, которой мы пользуемся уже несколько лет, но она кардинально отличается как архитектурой, так и принципами работы. Дашборды на версии нужно создавать заново и по-другому. Поэтому мне было особенно интересно сделать пробу и подготовить дашборд на базе демонстрационной Visiology 3.0. Под катом — подробный рассказ о моем "пилоте" и некоторые мысли о работе с новой версией Visiology.

Пять факторов, которые влияют на выбор базы данных
При выборе баз данных для текущего проекта (или при замене тех, которые не отвечают вашим текущим потребностям) количество возможных вариантов очень велико. Это и хорошо, и плохо, ведь нужны какие-то критерии фильтрации.
Сегодня есть гораздо больше баз данных, чем когда-либо. В декабре 2012 года, когда DB-Engines.com впервые начал ранжировать базы данных, у него получился список из 73 систем (существенный рост по сравнению с самым первым списком из 18 систем). Спустя десять лет, на декабрь 2022 года в списке было уже почти четыреста систем. За последнее десятилетие произошёл настоящий кембрийский взрыв технологий баз данных. Нужно ориентироваться в обширном пространстве вариантов: SQL, NoSQL, множество «многомодельных» баз данных, которые могут быть сочетанием SQL и NoSQL, или множественные модели данных NoSQL (сочетающие две или более опций: документы, ключи-значения, широкие столбцы, графы и так далее).
Кроме того, пользователи не должны путать популярность с применимостью для них. Хотя сетевой эффект имеет свои преимущества («Все пользуются X, поэтому не ошибусь, если выберу её»), он также может привести к групповому мышлению, торможению инноваций и конкуренции.
Мы с моим коллегой Артуром Песа недавно рассмотрели пять факторов, которые пользователи должны учитывать в первую очередь при выборе и сравнении баз данных.

Tarantool Data Grid + Java = …
В последнее время всё большую популярность набирает Tarantool — платформа in-memory вычислений с гибкой схемой данных, включающая в себя NoSQL-базу данных и сервер приложений. В этой статье я хочу рассказать об одной из его реализаций — Tarantool Data Grid (TDG).
Разворачиваем MySQL: установка и настройка

MySQL на сегодняшний день является одной из наиболее распространенных в мире. Достаточно сказать, что по рейтингам 2021 года данная СУБД лишь немного уступала Oracle.

Книги по SQL: что почитать новичкам и специалистам
SQL — декларативный язык программирования, который используют для описания, изменения и извлечения информации в реляционных базах данных. Язык структурированных запросов популярен у программистов, разработчиков и администраторов баз данных. В этом обзоре собрали 6 книг, которые помогут на старте изучения SQL и при углублении в тему.
Читали ли вы какие-нибудь из них? Или, может, вы можете дополнить этот список? Делитесь в комментариях!

Как в Учи.ру построили платформу для анализа A/B-тестов на ClickHouse
Привет, Хабр! Меня зовут Федор Тюрин, я руководитель команды продуктовой аналитики в Учи.ру. Мы проводим очень много А/Б-тестов (десятки запусков в неделю и сотни в течение года). В таких условиях очень важна автоматизация процесса анализа и подведения итогов теста.
Репликации в PostgreSQL

Один инстанс PostgreSQL в продакшене — это риск для отказоустойчивости и производительности. В статье разберём, зачем нужны реплики, чем физическая репликация отличается от логической и как настроить базовые сценарии на практике.