Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

107,45
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

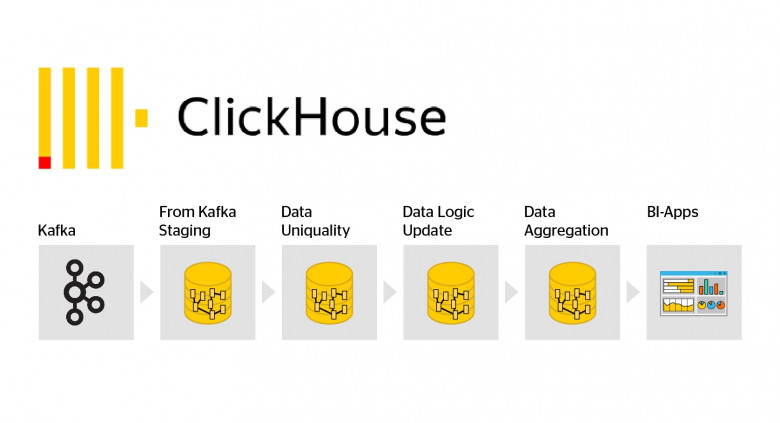
Обновить данные в ClickHouse без UPDATE: кейс IBS

Время на прочтение16 мин
Охват и читатели9.3K

Привет, Хабр! Меня зовут Антон, я – старший разработчик в отделе разработки баз данных в IBS. В этой статье я расскажу о том, как нашей командой была решена задача по сохранению в ClickHouse большого количества данных, генерируемых веб-приложением, с последующим получением сохранённых данных в агрегированном виде.

Решение задачи, описанной выше, было бы простым и вряд ли заслуживающим отдельной статьи на Хабре. Но наш случай представлял собой ряд нюансов: здесь есть технические дубли записей и бизнес-дубли (обновления), есть агрегированные данные и необходимость обновления агрегированных данных. А это уже пример не совсем типичного использования ClickHouse, которым мы и хотим поделиться.

Интересно? Переходите под кат.

Детальное рассмотрение поведения при использовании INCLUDE

Время на прочтение14 мин
Охват и читатели12K

Некоторые базы данных такие, как Microsoft SQL Server, IBM Db2, а также PostgreSQL начиная с 11 версии – предлагают прибегнуть к оператору include для генерации индекса. Представление данного функционала в PostgreSQL (исходная статья вышла 30.04.2019) послужило поводом для этого объёмного рассуждения о работе с оператором include.

Содержание:

1)    Напоминание: btree-индексы

2)    Напоминание: Index-only сканирование

3)    Оператор include

4)    Фильтрация по полям в include

5)    Уникальные индексы при использовании include

6)    Сравнение

7)    PostgreSQL: Никакой фильтрации до проверки области видимости

Читать далее

PostgreSQL Antipatterns: простой(?) INSERT… VALUES

Время на прочтение3 мин
Охват и читатели20K

Представим, что у вас есть некоторая табличка статистики, куда вы периодически скидываете таймстамп последнего "текущего" состояния в паре координат - например, (ID организации, ID сотрудника).

Как больно наступить на грабли в совсем простом, казалось бы, запросе?

Читать далее

Как избежать распространенных ошибок при работе с СУБД

Время на прочтение8 мин
Охват и читатели15K

В этом материале мы поговорим о практиках и ошибках при работе с разными СУБД, а также поделимся чек-листом от менеджера PaaS-продуктов Selectel Андрея Андронова.

Мы начнем с планов на проект и серверных комплектующих, пройдем через правила проектирования баз данных и доберемся до уровня доступности.
Читать дальше →

NULL-значения в PostgreSQL: правила и исключения

Время на прочтение8 мин
Охват и читатели82K

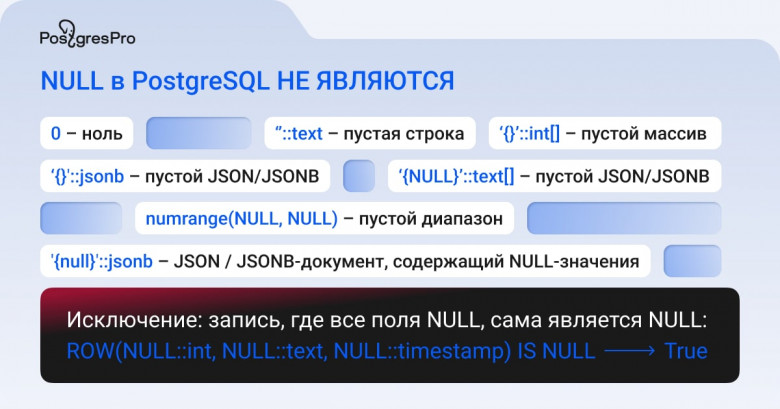
Навскидку многим кажется, что они знакомы с поведением NULL-значений в PostgreSQL, однако иногда неопределённые значения преподносят сюрпризы. Предлагаем вашему вниманию расшифровку доклада Алексея Борщева с PGConf.Russia 2022 — он был полностью посвящён особенностям NULL-значений в Postgres.

NULL простыми словами

Что такое SQL база данных? Согласно одному из определений, это просто набор взаимосвязанных таблиц. А что такое NULL? Обратимся к простому бытовому примеру: все мы задаём друг другу дежурный вопрос: «Как дела?». Часто мы получаем в ответ: «Да ничего...» Вот это «ничего» нам и нужно положить в базу данных — NULL, неопределённое, некорректное или неизвестное значение.

Читать далее

Как понять, что вашими отчетами в Metabase пользуются?

Время на прочтение4 мин
Охват и читатели5K

Разработка отчета, как и обычная разработка, стоит времени программиста. Информация о количестве просмотров отчетов, количестве активных пользователей и многих других метрик, связанных с BI, может повысить эффективность вашей команды аналитики и помочь правильно отслеживать КПД вашей аналитики. Такие метрики каждая команда определяет для себя сама. Чаще всего они связанны с использованием отчетов и пользователями, которые их просматривают. Метрики, которые используются в нашей команде, и как реализовать отчет с ними в Metabase, рассмотрим в этой статье.

Читать далее

PostgreSQL 16: Часть 2 или Коммитфест 2022-09

Время на прочтение14 мин
Охват и читатели8.3K

PostgreSQL 15 уже вышел официально. И в сети появилось множество информации о новинках версии.


А мы продолжаем знакомить с новинками будущей 16-й версии. В начале октября завершился второй коммитфест и есть что обсудить.


Самое интересное из первого, июльского, коммитфеста можно прочитать в предыдущей статье серии: 2022-07.

Читать дальше →

Топ полезных SQL-запросов для PostgreSQL

Время на прочтение7 мин
Охват и читатели145K

Статей о работе с PostgreSQL и её преимуществах достаточно много, но не всегда из них понятно, как следить за состоянием базы и метриками, влияющими на её оптимальную работу. В статье подробно рассмотрим SQL-запросы, которые помогут вам отслеживать эти показатели и просто могут быть полезны как пользователю.

Читать далее

Визуализация данных с помощью Metabase

Время на прочтение4 мин
Охват и читатели86K

Привет, Хабр!

Сегодня я рассмотрю основные возможности BI-инструмента с открытым исходным кодом Metabase.

Читать далее

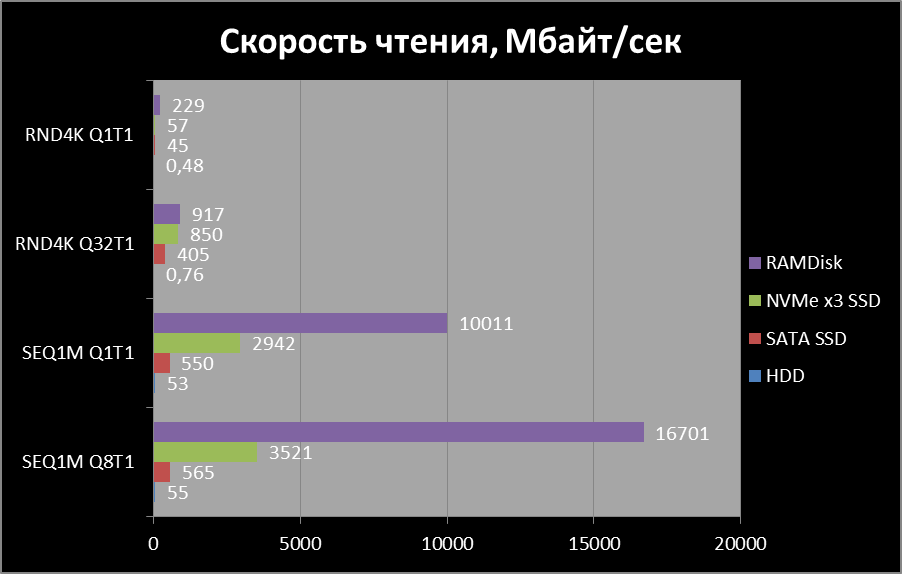
Тестирование скорости работы 1C в режиме файловой версии, MS SQL и POSTGRES на HDD, SSD и RAMDisk

Время на прочтение5 мин
Охват и читатели25K

Мне всегда было интересно (и не только мне) есть ли смысл запуска 1С в диске из оперативной памяти, потому что если посмотреть на графики скорости чтения различных типов накопителей, то преимущества  очевидны:

Читать далее

BigQuery. Что делать, если повредил или случайно удалил таблицы

Время на прочтение3 мин
Охват и читатели8.3K

Как быть, если случайно удалил или повредил таблицу в BigQuery? Первое о чем нужно помнить: BigQuery хранит состояние вашей существующей таблицы на любой момент времени в течение прошедших 7 дней + у вас есть 2 суток, чтобы восстановить случайно удаленную таблицу. Рассмотрим, как это все провернуть.

Читать далее

Индексирование JSON в MySQL

Время на прочтение8 мин
Охват и читатели12K


В середине 2015 года, в MySQL 5.7.8 появился тип данных JSON. С тех пор он применяется, чтобы избегать жёстких определений столбцов и сохранять документы JSON всех форм и размеров: логи аудита, параметры конфигурации, сторонние полезные нагрузки, пользовательские поля и др. Подробности — к старту нашего курса по анализу данных.

Читать дальше →

Как запускать SQL в Go с максимальным комфортом

Время на прочтение5 мин
Охват и читатели25K

Писать SQL руками или использовать ORM — тема очень спорная, и я опишу, как использовать первый подход максимально эффективно. А какой из подходов выбрать, думаю, каждый сам для себя уже решил.

Читать далее

Ближайшие события

Новая схема SQL Join-ов

Время на прочтение1 мин
Охват и читатели18K

Учу SQL и понимаю, что схема Join-ов основанная на пересекающихся кругах не корректна. Результатом джойнов всегда идет увеличение таблицы в ширь. А по схеме с кругами площадь кругов почти везде не увеличивается. И также круговая схема не показывает заполнение NULL-ами при LEFT и RIGHT джойнах. Предлагаю схему на прямоугольниках, где закрашенный красный это результирующие данные в таблице после джойнов, черный это заполнение NULL-ами. Серые прямоугольники оставлены просто для наглядности и ничего не означают.

Читать далее

Управление данными с помощью CI/CD

Время на прочтение9 мин
Охват и читатели7.5K

Я вспоминаю свой первый день разработчиком-джуном, он свеж в моей памяти, как будто это было вчера. Я ужасно нервничал и понятия не имел, что делаю. Наверно, мой стресс был заметен, потому что одна добрая душа решила взять меня под свою защиту. В тот день я научился писать SQL в коде на PHP, чтобы делать интересные вещи с базой данных.

Однако прежде чем начать, я должен был попросить администратора базы данных (database administrator, DBA) создать несколько таблиц. Я быстро понял, что для того, чтобы сделать любое действие, нужно сразу обращаться к DBA. Нужен новый столбец? Свяжись с DBA. Необходимо отредактировать хранимую процедуру? Это работа для DBA. Я смотрел на него снизу вверх, он был такой суперзвездой, что в итоге позже я сам стал администратором.

Разумеется, я понимаю, что зависимость от кого-либо неизбежно создаёт ограничения. Это безрассудно, трудно и, что хуже всего, впустую тратит навыки DBA.
Читать дальше →

MySQL. Оптимизация псевдо-больших данных

Время на прочтение7 мин
Охват и читатели8.3K

Работая над различными интересными задачами, мне только и приходилось слышать о существовании программ, которые работают с большими данными (в области действия одного сервера). И вот настал тот день, когда к нам обратился клиент, у которого сайт грузился очень долго. Задание для решения этой проблемы выдали моего коллеги. Немного прошло времени, до того как он подозвал меня к себе, с целью показать, столь диковинное для меня зрелище, связанное с объёмом таблиц, в которых находились данные после импорта категорий, характеристик, брендов товаров.

22 миллиона варианта категорий для нас показалось более чем приличным объёмом, тем более — вес таблицы с категориями получился чуть больше 1,6 Гиб. С такими размерами страницы начали грузиться дольше, чем хотелось бы. Ввиду того что, сроки на решение проблемы маленькие (чем быстрей тем лучше), руководство решило выделить на эту задачу, две единицы программистов, меня и моего коллегу. Разделив модуль на двоих, мне достались по объёму не самые сливки, но не менее ответственный участок, поскольку в нём — на загрузку данных, уходило значительное время.
Читать дальше →

SQL и NoSQL. Правда ли одно лучше другого?

Время на прочтение13 мин
Охват и читатели37K

Базы данных (БД) существуют с первых дней программирования, а появились они ещё раньше. Это — неотъемлемые части любых приложений. Хорошо спроектированная БД — это один из важнейших компонентов, влияющих на производительность программных проектов. Из-за этого множество архитекторов программных решений исследовали массу подходов к управлению данными, пытаясь выяснить то, какие из этих подходов работоспособны в определённых сценариях, а какие — нет. Выбор подходящей архитектуры БД обычно сводится к выбору между SQL и NoSQL, между реляционными и нереляционными базами данных. А иногда в одном проекте используют и то, и другое.

В этой статье мы сделаем краткий обзор баз данных, поговорим об их истории, постараемся разобраться с тем, что собой представляют базы данных SQL и NoSQL, выясним ключевые различия между ними.

Читать далее

Как повысить безопасность приложений с помощью фабрик строк в psycopg

Время на прочтение7 мин
Охват и читатели6.8K

psycopg — это адаптер базы данных PostgreSQL для Python, то есть одной из его основных задач является автоматическая подстройка типов при составлении запросов и получении ответов между PostgreSQL и Python. И хотя это преобразование отлично применяется к встроенным типам, psycopg также предоставляет нативный способ обрабатывать специализированные типы данных с помощью фабрик строк.
Читать дальше →

15 нейросетей в один Telegram-бот: история успеха и реализация помощника для создателей контента

Время на прочтение3 мин
Охват и читатели44K

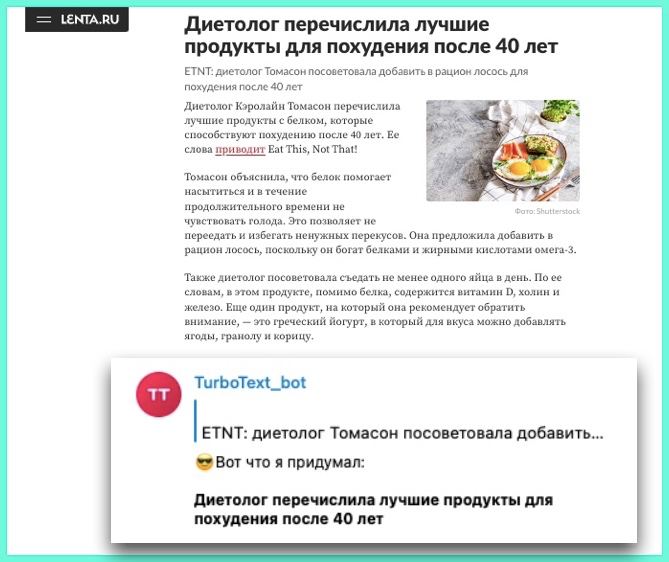
Всем привет! Я занимаюсь NLP в сфере Data Science и хочу поделиться результатами разработки Telegram-бота, у которого под капотом уже 15 нейросетей. Речь идёт о TurboText_bot. Он будет полезен всем, кто причастен к созданию контента. К таким можно отнести блогеров, журналистов, копирайтеров и многих других специалистов.. Даже бабушек у подъезда, ведь бот способен генерировать и обрабатывать новости.

Что удалось реализовать?

Читать далее

Экономим на Azure SQL Databases

Время на прочтение3 мин
Охват и читатели2.5K

Всем привет! В данной статье я расскажу о том, как наша компания смогла сэкономить за счет внедрения Azure SQL Elastic Pool. Дополнительно будут примеры Azure REST API для энумерации SQL Servers, для энумерации SQL databases и для получения метрик.

Самые пытливые в конце статьи узнают сэкономленную величину. Здесь исходники

Читать далее