Обновить
5

Пользователь

Отправить сообщение

Не изобретая велосипед. Кэширование: рассказываем главные секреты оптимизации доступа к данным

Время чтения4 мин
Охват и читатели13K

Точно скажу, что костыли и велосипеды не лучшее решение, особенно если мы говорим о кэшировании, а конкретнее, если нам надо оптимизировать метод доступа к данным, чтобы он имел производительность выше, чем на источнике. Я докажу это на нескольких примерах, приведённых в статье, всего за 5 минут.


Читать дальше →

Обучаемся самостоятельно: подборка видеокурсов по Computer Science

Время чтения11 мин
Охват и читатели135K

И на камнях растут деревья: как написать интересный пост о своём коде, когда это кажется невозможным

Время чтения12 мин
Охват и читатели16K

Мы знаем, что про код писать сложно, но хотим, чтобы посты с ним на Хабре становились всё лучше. Поэтому на ежегодном хабраконкурсе «Технотекст-2021» мы поддержали номинацию «Программирование». А ещё  создали коллекцию советов — как написать крутой пост про свой код и порадовать этим постом аудиторию. 

Мы пройдём по основным шагам работы с текстом и покажем, как работать с темой, форматом и структурой. Научим техноавторским приёмчикам. А в пример приведём посты из нашего блога — и отличные материалы участников «Технотекста-2021». 

Хочу делать интересные посты

Как улучшить архитектуру озера данных: два уровня прокачки

Время чтения3 мин
Охват и читатели4.2K

Lake city by arsenixc

Построение озера данных на основе облачных сервисов предполагает активное использование объектного хранилища S3. Команда VK Cloud Solutions перевела статью, которая раскрывает тонкости Cloud Native Data Lake.
Читать дальше →

Символы Unicode: о чём должен знать каждый разработчик

Время чтения7 мин
Охват и читатели495K


Если вы пишете международное приложение, использующее несколько языков, то вам нужно кое-что знать о кодировке. Она отвечает за то, как текст отображается на экране. Я вкратце расскажу об истории кодировки и о её стандартизации, а затем мы поговорим о её использовании. Затронем немного и теорию информатики.
Читать дальше →

Автоматизация общения

Время чтения7 мин
Охват и читатели4.6K


Научные исследования показывают, что человеку сложно поддерживать стабильные отношения более чем со 150 сородичами (число Данбара). Дело не только в когнитивном лимите, но и в необходимости периодических контактов. Людей нужно пинговать, чтобы вы не забыли их, а они — вас.

Эти задачи вполне можно автоматизировать. Профилактика социальных связей похожа на обслуживание компьютерной сети. Автоматическое выполнение довольно стандартных процессов, которые состоят из рутинных операций. Системные администраторы решают такие задачи ежедневно, за подробностями прошу под кат.
Читать дальше →

Позвольте людям работать руками (или почему вам не нужна автоматизация)

Время чтения9 мин
Охват и читатели19K

Рано или поздно каждый продакт становится достаточно матёрым, чтобы грамотно автоматизировать любую ручную работу:

•‎ Финотдел тратит время на отчет? Вот вам кнопка, жмите, отчет сформируется автоматически!

•‎ Аналитики делают ручные выгрузки? Вжух, и у нас теперь красивый автоматический дашборд!

•‎ Сэйлзы заполняют данные о клиенте вручную? Хоп, и данные уже парсятся автоматом!

Тогда продакт начинает чувствовать себя этакой Белоснежкой, которая улучшает всё, к чему прикоснется. Да и коллеги его хвалят — ведь всем нравится, когда что-то делалось руками, а теперь работает «само по себе». Пусть вкалывают роботы, а не человек!

Но это ошибка. На длинной дистанции автоматизация часто бесполезна и даже вредна для бизнеса. А продакт – как раз тот человек, который должен предостеречь окружающих.

Сегодня расскажу, как вовремя распознать зловредную автоматизацию.

Узнать больше

[API как продукт] Формирование продуктового видения

Время чтения4 мин
Охват и читатели1.8K

Это черновик третьей главы раздела «API как продукт» моей книги о проектировании API.

Описанная в предыдущей главе фрагментация целевой аудитории API, триада «разработчики — бизнес — конечные пользователи», делает управление продуктом API весьма нетривиальной проблемой. Да, базовый принцип — выяснить потребности аудитории и удовлетворить их — всё тот же; только аудиторий у вашего продукта три, причём их интересы далеко не всегда коррелируют. Из потребности конечного пользователя в качественном и недорогом кофе отнюдь не следует потребность бизнеса в API для работы с кофе-машинами.

В общем случае продуктовое видение будущего API тоже должно включать в себя те же три звена:

Читать далее

RabbitMQ tutorial 1 — Hello World

Время чтения6 мин
Охват и читатели568K


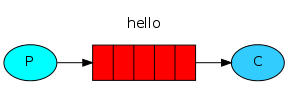
RabbitMQ позволяет взаимодействовать различным программам при помощи протокола AMQP. RabbitMQ является отличным решением для построения SOA (сервис-ориентированной архитектуры) и распределением отложенных ресурсоемких задач.

Под катом перевод первого из шести уроков официального сайта. Примеры на python, но его знание вовсе не обязательно. Аналогичные примеру программы можно воспроизвести практически на любом популярном ЯП. [так выглядят комментарии переводчика, т.е. меня]
Читать дальше →

Тьюринг-полнота Generic типов Java

Время чтения18 мин
Охват и читатели17K

Периодически на хабре можно встретить статьи о том, какие невероятные вещи можно сделать на шаблонах C++: конечные автоматы, лямбда-исчисление, машина Тьюринга и многое другое.


Параметризованные типы в Java традиционно считаются лишь пародией на шаблоны C++ (несмотря на то, что их даже сравнивать как-то некорректно), и причины этого несложно понять. Тем не менее не всё так плохо, и компилятор Java можно заставить производить во время проверки типов любые вычисления, лишь бы хватило оперативной памяти. Конкретный способ это сделать был описан в ноябре 2016-го года в этой прекрасной публикации. Его я и хотел бы объяснить.


Для затравки приведу следующий код. Корректен ли он? Предлагаю скомпилировать и проверить, угадали ли вы результат.


class Sample {

    interface BadList<T> extends List<List<? super BadList<? super T>>> {}

    public static void main(String[] args) {
        BadList<? super String> badList = null;
        List<? super BadList<? super String>> list = badList;
    }
}

Узнать ответ

Компилятор выбросит java.lang.StackOverflowError независимо от размера стэка.


Разберёмся, почему компилятор ведёт себя именно так (я бы не назвал это багом), как понимание данных причин может быть полезно и причём тут машина Тьюринга.

Читать дальше →

Объектная гимнастика

Время чтения7 мин
Охват и читатели38K
В первых двух абзацах оригинального текста автор описывает как он пил пиво с друзьями. Я заменил их пятничной картинкой о гимнастике из детства.

Объектная гимнастика (англ. Object Calisthenics) — это упражнения в программировании, которые состоят из 9 правил, которые Джефф Бей описал в своей книге «The ThoughWorks Anthology». Пытаясь как можно точней следовать этим правилам, вы измените свои привычки написания кода. Это не значит, что вы должны постоянно соблюдать все эти правила. Найдите баланс и используйте только те, которые вам удобны.

Эти правила сфокусированы на читаемости, тестируемости, понятности и поддерживаемости вашего кода. Если вы уже пишите код, который читаем, тестируем, понятен и поддерживаем, тогда эти правила помогут сделать его более читаемым, тестируемым. Понятным и поддерживаемым.

Ниже я прокомментирую этих 9 правил:
  1. Только один уровень отступа в методе
  2. Не используйте Else
  3. Оберните все примитивные типы и строки
  4. Коллекции первого класса
  5. Одна точка на строку
  6. Не используйте сокращения
  7. Сохраняйте сущности короткими
  8. Никаких классов с более чем 2 атрибутами
  9. Никаких геттеров, сеттеров и свойств

Читать дальше →

Совершенный код

Время чтения4 мин
Охват и читатели20K
Always code as if the guy who ends up maintaining your code will be a violent psychopath who knows where you live.
Damian Conway, co-designer of Perl 6

Хороший программный код определяется как минимум тремя признаками: однозначность, эффективность и сопровождаемость.

Однозначность – это в первую очередь стиль кодирования. Однозначность определяется тем, какие имена переменных и функций выбирает программист, как форматирует код, как обрабатывает ошибки и формирует структуру кода.

Эффективный код — это код, состоящий из эффективных алгоритмов. Эффективный не значит хрупкий, сложный или трудно сопровождаемый. Эффективность кода достигается путем использования сильных сторон языка и в то же время избеганием его слабостей.

Сопровождаемость заключается в том, что код пишется в первую очередь для тех, кто будет его сопровождать. Сопровождаемость – легкость использования написанного кода, минимизация возможности появления ошибок при его изменении.
Читать дальше →

Рекомендации по написанию кода на C# от Aviva Solutions

Время чтения40 мин
Охват и читатели85K
Представляю вашему вниманию перевод документа "Coding Guidelines for C# 3.0, 4.0 and 5.0".

Целью создания этого списка правил является попытка установить стандарты написания кода на C#, которые были бы удобными и практичными одновременно. Само собой, мы практикуем то, что создали. Эти правила являются одним из тех стандартов, которые лежат в основе нашей ежедневной работы в AvivaSolutions. Не все эти правила имеют четкое обоснование. Некоторые из них просто приняты у нас в качестве стандартов.

Статический анализатор кода VisualStudio (который также известен как FxComp) и StyleCop могут автоматически применять многие из правил кодирования и оформления путем анализа скомпилированных сборок. Вы можете сконфигурировать их таким образом, чтобы анализ производился во время компиляции или был неотъемлемой частью непрерывной или ежедневной сборки. Этот документ просто добавляет дополнительные правила и рекомендации, но его вспомогательный сайт www.csharpcodingguidelines.com предоставляет список правил анализа кода, необходимых в зависимости от того, с какой базой кода вы работаете.
Читать дальше →

Усиливаем контроль типов: где в типичном C#-проекте присутствует непрошеный элемент слабой типизации?

Время чтения5 мин
Охват и читатели19K

Проблема


Мы привыкли говорить о языках вроде C# как строго и статически типизированных. Это, конечно, правда, и во многих случаях тип, указываемый нами для некоторой языковой сущности хорошо выражает наше представление о ее типе. Но есть широко распространенные примеры, когда мы по привычке («и все так делают») миримся с не совсем верным выражением «желаемого типа» в «объявленном типе». Самый яркий — ссылочные типы, безальтернативно оснащенные значением «null».
В моем текущем проекте за год активной разработки не было ни одного NullReferenceException. Могу не без оснований полагать, что это следствие применения описанных ниже техник.

Рассмотрим фрагмент кода:

public interface IUserRepo 
{
	User Get(int id);
	User Find(int id);
}

Этот интерфейс требует дополнительного комментария: «Get возвращает всегда не null, но кидает Exception в случае ненахождения объекта; а Find, не найдя, возвращает null». «Желаемые», подразумеваемые автором типы возврата у этих методов разные: «Обязательно User» и «Может быть, User». А «объявленный» тип — один и тот же. Если язык не заставляет нас явно выражать эту разницу, то это не означает, что мы не можем и не должны делать это по собственной инициативе.
Maybe в C#: какие есть варианты

Как стать ведущим разработчиком. Часть 1

Время чтения8 мин
Охват и читатели142K
Это перевод статьи, написанной Джоном Оллспоу, который на данный момент является старшим вице-президентом технического отдела в Etsy.

Продолжение перевода здесь

В нашей сфере деятельности нам доступны огромные объёмы знаний, в особенности тех, которые позволяют разработчику стать эффективным. Но почему-то, несмотря на существование множества книг о специфических задачах и обязанностях менеджеров в нетехнических областях, я практически не вижу новых книг или статей о том, как стать хорошим ведущим разработчиком. Замечательным исключением, конечно, являются статьи Кейт Maцудайры [от переводчика: на фотографии, кстати, именно она], немало написавшей о культурных составляющих инженерии.

Но в то же время, все мои знакомые преуспевающие разработчики помнят своих наставников, которые научили их тому, что значит быть „ведущим“.
Читать дальше →

Знай сложности алгоритмов

Время чтения2 мин
Охват и читатели1.1M
Эта статья рассказывает о времени выполнения и о расходе памяти большинства алгоритмов используемых в информатике. В прошлом, когда я готовился к прохождению собеседования я потратил много времени исследуя интернет для поиска информации о лучшем, среднем и худшем случае работы алгоритмов поиска и сортировки, чтобы заданный вопрос на собеседовании не поставил меня в тупик. За последние несколько лет я проходил интервью в нескольких стартапах из Силиконовой долины, а также в некоторых крупных компаниях таких как Yahoo, eBay, LinkedIn и Google и каждый раз, когда я готовился к интервью, я подумал: «Почему никто не создал хорошую шпаргалку по асимптотической сложности алгоритмов? ». Чтобы сохранить ваше время я создал такую шпаргалку. Наслаждайтесь!
Читать дальше →

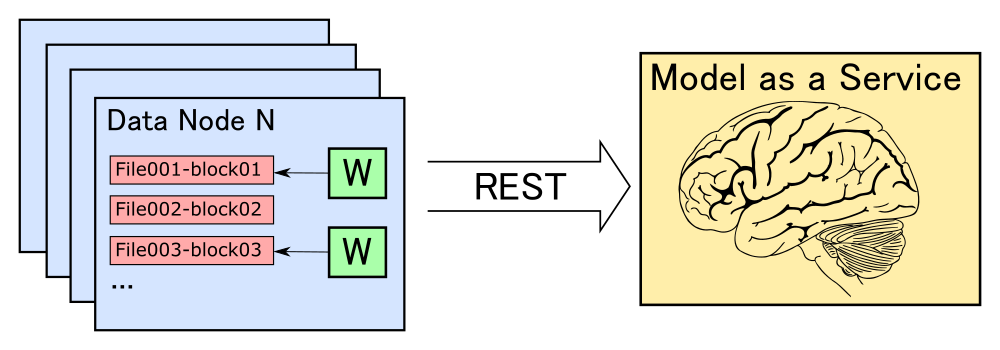
Классификация больших объемов данных на Apache Spark с использованием произвольных моделей машинного обучения

Время чтения18 мин
Охват и читатели14K

Часть 1: Постановка задачи


Привет, Хабр! Я архитектор решений в компании CleverDATA. Сегодня я расскажу про то, как мы классифицируем большие объемы данных с использованием моделей, построенных с применением практически любой доступной библиотеки машинного обучения. В этой серии из двух статей мы рассмотрим следующие вопросы.

  • Как представить модель машинного обучения в виде сервиса (Model as a Service)?
  • Как физически выполняются задачи распределенной обработки больших объемов данных при помощи Apache Spark?
  • Какие проблемы возникают при взаимодействии Apache Spark с внешними сервисами?
  • Как при помощи библиотек akka-streams и akka-http, а также подхода Reactive Streams можно организовать эффективное взаимодействие Apache Spark с внешними сервисами?

Изначально я планировал написать одну статью, но так как объем материала оказался достаточно большим, я решил разбить ее на две части. Сегодня в первой части мы рассмотрим общую постановку задачи, а также основные проблемы, которые необходимо решить при реализации. Во второй части мы поговорим о практической реализации решения данной задачи с использованием подхода Reactive Streams.

Читать дальше →

Oh, My Code: Машинное обучение и аналитика в «Одноклассниках»

Время чтения12 мин
Охват и читатели8.6K


В чём разница между Machine Learning и анализом данных, кто сидит в «Одноклассниках» и как начать свой путь в машинном обучении — об этом мы беседуем в двенадцатом выпуске ток-шоу для программистов.


Видео на канале Технострим

Ведущий программы — технический директор медиапроектов Павел Щербинин, гость — инженер-аналитик «Одноклассников» Дмитрий Бугайченко.

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность