Обновить
256K+

Анализ и проектирование систем *

Анализируй и проектируй

200,41
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Математическая теория того, почему мы обречены на самоуничтожение и можем ли мы этого избежать?

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели6.2K

Одно из самых пугающих свойств технологической цивилизации — это то, что для рукотворной катастрофы нам вообще не нужен даже злой умысел, не говоря уже о каком-то тайном теневом заговоре — достаточно базовой математики некооперативных игр. В теории систем это описывают ситуацией, в которой локально правильный расчёт каждого отдельного игрока детерминированно гарантирует коллективное самоуничтожение.

В этой статье поговорим о том, почему так получается, разберём, как Computer Science и теория механизмов помогают взломать дилемму заключённого и можно ли сделать сотрудничество единственным математически верным сценарием.

Читать далее

Новости

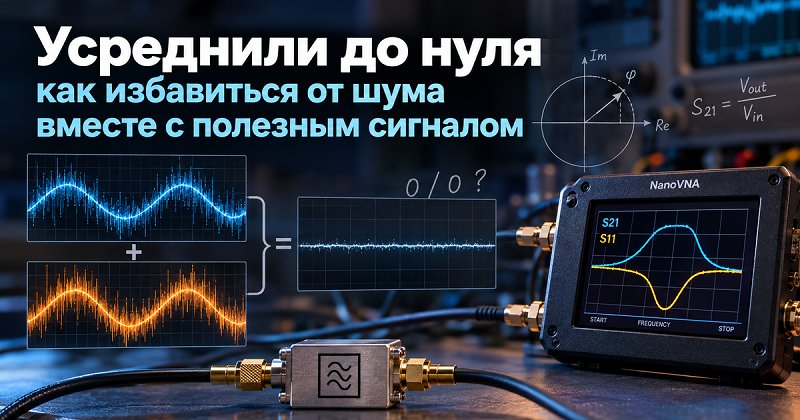
Усреднили до нуля, или как избавиться от шума вместе с полезным сигналом

Время на прочтение18 мин
Охват и читатели8.2K

Обычно несколько измерений усредняют, чтобы уменьшить влияние шума. Но если складывать сигналы без учета их фазы, можно погасить и сам полезный сигнал.

При работе над прошивкой NanoVNA на Rust мне понадобилось разобраться, как продолжать измерение после паузы (ради обслуживания экрана и USB).

Расскажу, почему прежний способ накопления подходил для непрерывного захвата и что пришлось изменить в новой прошивке.

Читать далее

Как исследования реального опыта водителей помогают разрабатывать автономные грузовики

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели5.3K

Привет! Меня зовут Ася, я работаю руководителем сектора исследований пользовательского опыта в Navio — мы разрабатываем технологию автономного вождения для разных платформ: от легковых автомобилей и пассажирского транспорта до магистральных грузовиков.

У вас может возникнуть вопрос: зачем исследовать пользовательский опыт в продукте, цель которого — обеспечить движение без участия человека за рулём?

Но не все так просто.

Чтобы автоматизировать работу водителя, для начала нужно разобраться, из чего она состоит. Понять, как опытный водитель действует в тех или иных ситуациях, как оценивает риски, реагирует, на что в первую очередь обращает внимание, а также определить, какие еще функции он выполняет во время поездки.

Несколько лет назад мы провели исследование работы водителей грузовиков. Эта идея возникла благодаря другой, более локальной задаче — улучшения интерфейса планшета водителя-испытателя. В итоге результаты исследования помогли команде разработки дополнить и уточнить требования к нашему ИИ-водителю.

В этой статье я расскажу о том, как мы к этому пришли.

Читать далее

От ИИ-агента в 1С до мотивации команды: семь коротких докладов на A&PM EVENT 2026

Время на прочтение2 мин
Охват и читатели4.8K

Как превратить личные эксперименты с ИИ в общую практику компании? Что поручить агенту, подключённому к базе 1С? Как руководителю поддерживать доверие и мотивацию команды? Эти вопросы вошли в программу «Открытого микрофона» на INFOSTART A&PM EVENT 2026.

В программе семь выступлений по 20 минут - о конкретных рабочих ситуациях, инструментах и проектном опыте.

Читать далее

Staging-слой на EAV: случай, когда антипаттерн оправдан

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели4.9K

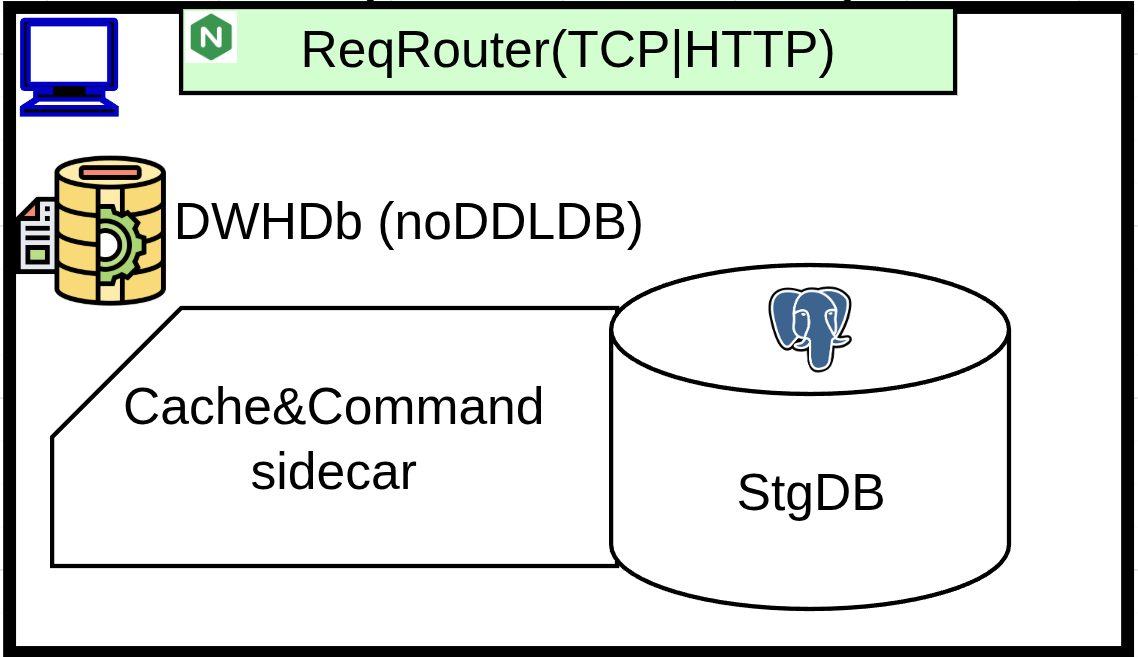
В этой статье — про STAGING-слой нашего DWH и о том, как мы работаем с EAV-паттерном. EAV в реляционной базе — устоявшийся антипаттерн, который в большинстве задач стоит обходить стороной. Рассказываю не о том, хорош EAV в целом или плох, а о конкретном случае, когда он оказался оправдан: почему он к нам пришёл, как мы с ним живём, что он даёт и где реально мешает.

Читать далее

Адрес-идентификатор: как норма о согласии депозитария превращается в требования к криптографии

Время на прочтение24 мин
Охват и читатели3.9K

Привет, Хабр!

 Я Михаил Кулаков, ведущий инженер-аналитик направления «Блокчейн» в компании «Диасофт». 

В этой статье разберу Федеральный закон № 282-ФЗ «О цифровых валютах и цифровых правах» с точки зрения того, кто пишет требования к системе. Какие новые роли вводит закон? Какие компоненты можно будет переиспользовать и доработать, а что необходимо проектировать с нуля? Каким должен быть модуль работы с открытыми сетями?

В конце – список из восьми вопросов, которые важно задать себе и подрядчику до старта проекта.

Читать далее

Все русскоязычные стримы в Postgres раз в 10 минут: 2 млн строк вместо 30 млн и баг, в котором я три недели винил VK

Время на прочтение4 мин
Охват и читатели10K

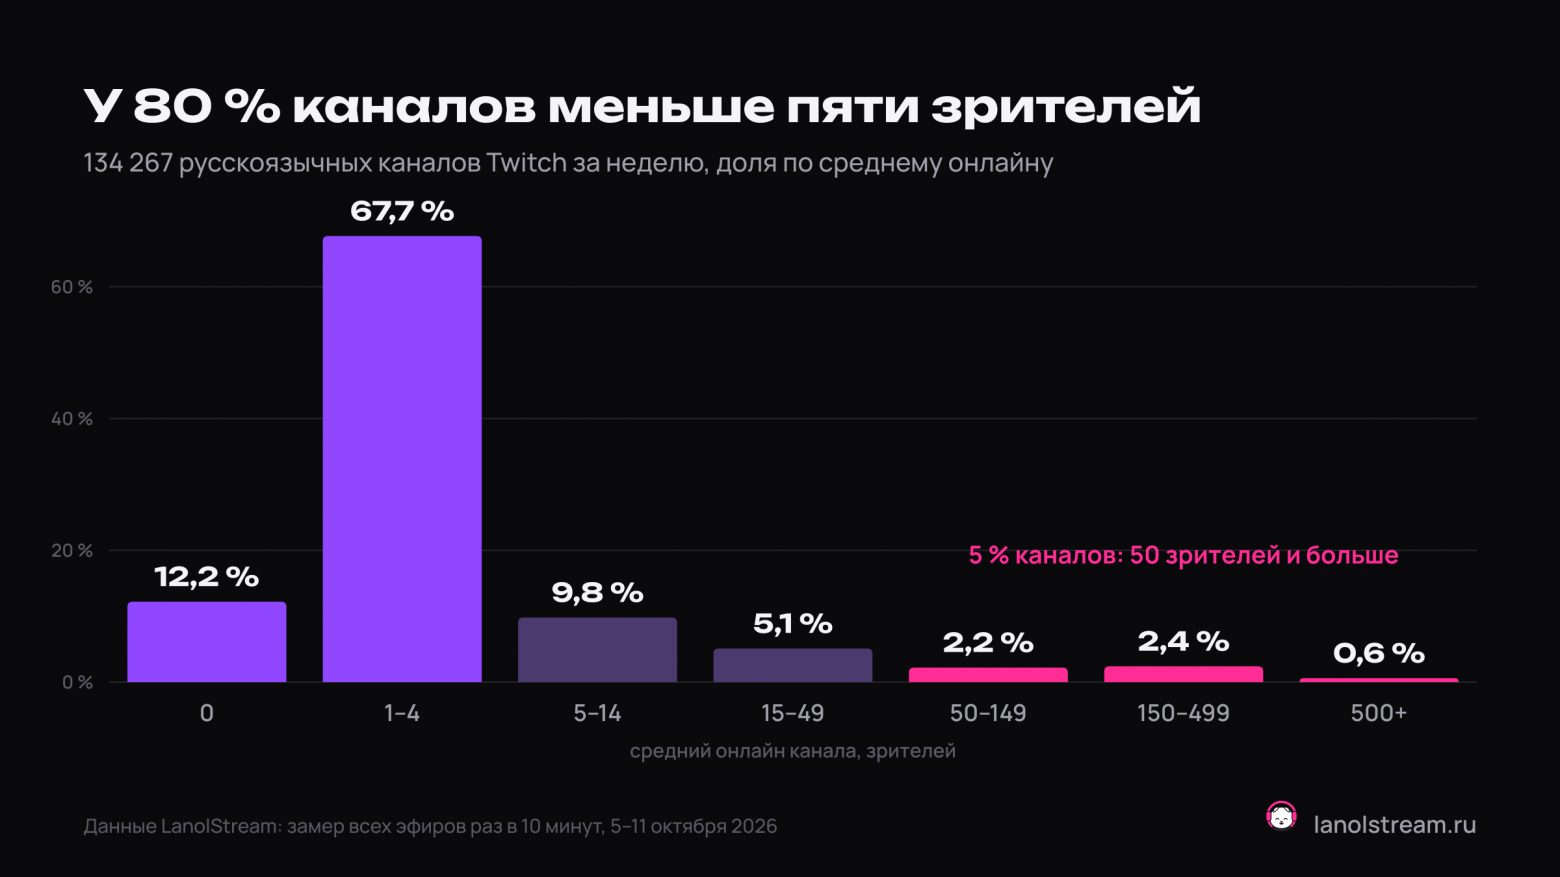
Каждые 10 минут в русскоязычном эфире Twitch и VK Видео Live в среднем 7 200 каналов. Писать их как есть - больше миллиона строк в сутки. Я храню агрегаты, и за четыре недели вышло 2 млн строк. Расскажу, как это устроено и где я три недели искал проблему не там.

Я Максим, разработчик, вечерами пишу LanolStream - инструменты для стримеров, которые мы делаем вместе со стримершей lanolkid. Стримеры часто спрашивают «во сколько лучше стримить» и «много ли у меня зрителей для моей игры». Чтобы отвечать цифрами, а не ощущениями, нужен весь рынок, а не только наши каналы.

Читать далее

Как мы перестали вручную проектировать таблицы и поручили процессы ИИ

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели7.1K

Привет, Хабр! Меня зовут Александр Антипов, я продакт-оунер MWS Tables — платформы для совместной работы и автоматизации на базе таблиц. Раньше на платформе таблицы приходилось собирать вручную: добавлять столбцы, выбирать типы полей, устанавливать фильтры и т. п. Теперь у нас появился ИИ-помощник, создающий таблицы по простому текстовому описанию. А ещё мы научили его связывать таблицы между собой, писать формулы, настраивать отображение данных и делать многое другое. 

Сегодня я покажу, как применять новые возможности на практике.

Читать далее

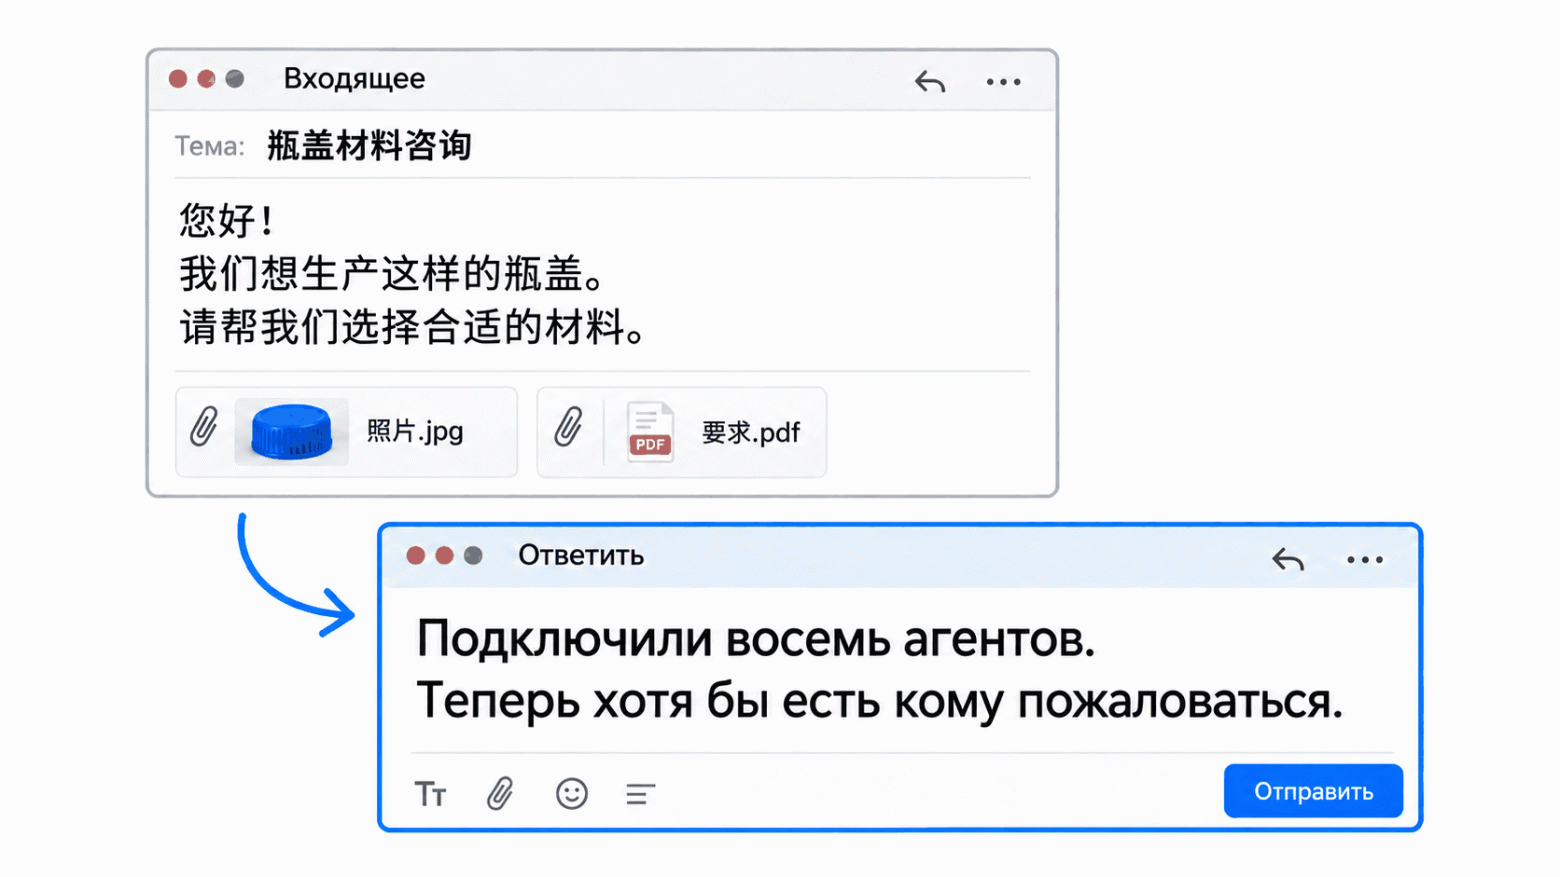
Крышечка из Италии, китайские иероглифы в письме — как всё это привело нас к ИИ

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели5.9K

СИБУР планирует наращивать экспорт, в том числе в Китай, Вьетнам и арабские страны.

Что это значит: больше обращений на почте от зарубежных клиентов — с фотографиями изделий, PDF во вложениях и длинными цепочками переписки. 

Раньше этим занимались люди: прежде чем передать задачу специалисту, они анализировали, кто пишет, что хочет произвести и какая помощь ему нужна. Теперь всё это предстояло разбирать ещё и на разных языках.

Поэтому мы решили собрать ИИ-помощника: пусть сам читает переписку и собирает отчёты. Но кое-что пошло не так.

Читать далее

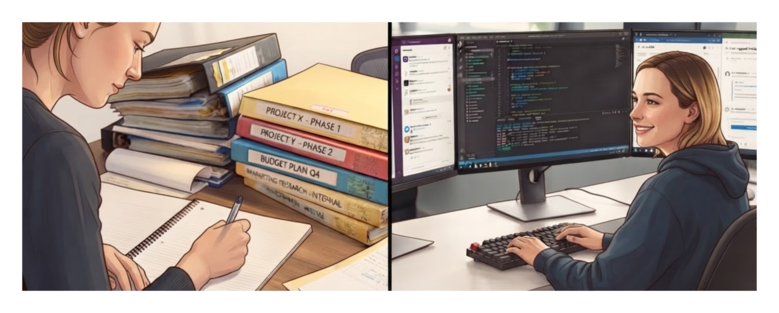
От Word по почте до ИИ‑скиллов: обсудим эволюцию документации и зачем нейросетям бизнес‑контекст

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели5.2K

Мы прошли долгий путь от пересылки ТЗ в Word по электронной почте до автоматической генерации документации нейросетями прямо из Merge Request разработчика. Зачастую это происходит вообще без участия аналитика вплоть до этапа итогового ревью. Но делает ли автоматизация нашу документацию лучше?

В этой статье я хочу оглянуться на эволюцию того, как мы вели проектную документацию, обсудить одну неочевидную проблему работы с ИИ, о которой мало кто задумывается, и показать, как с этим бороться. А в конце я поделюсь полезными материалами — примером репозитория документации для двух подходов (классический водопад с элементами канбана и чистый скрам) с готовым ИИ‑скиллом для анализа изменений в коде.

Узнать об эволюции работы с документацией

Большая фича без бесконечных переделок: Spec driven development с AI, UML, C4 и OpenAPI

Уровень сложностиСредний
Время на прочтение35 мин
Охват и читатели6.7K

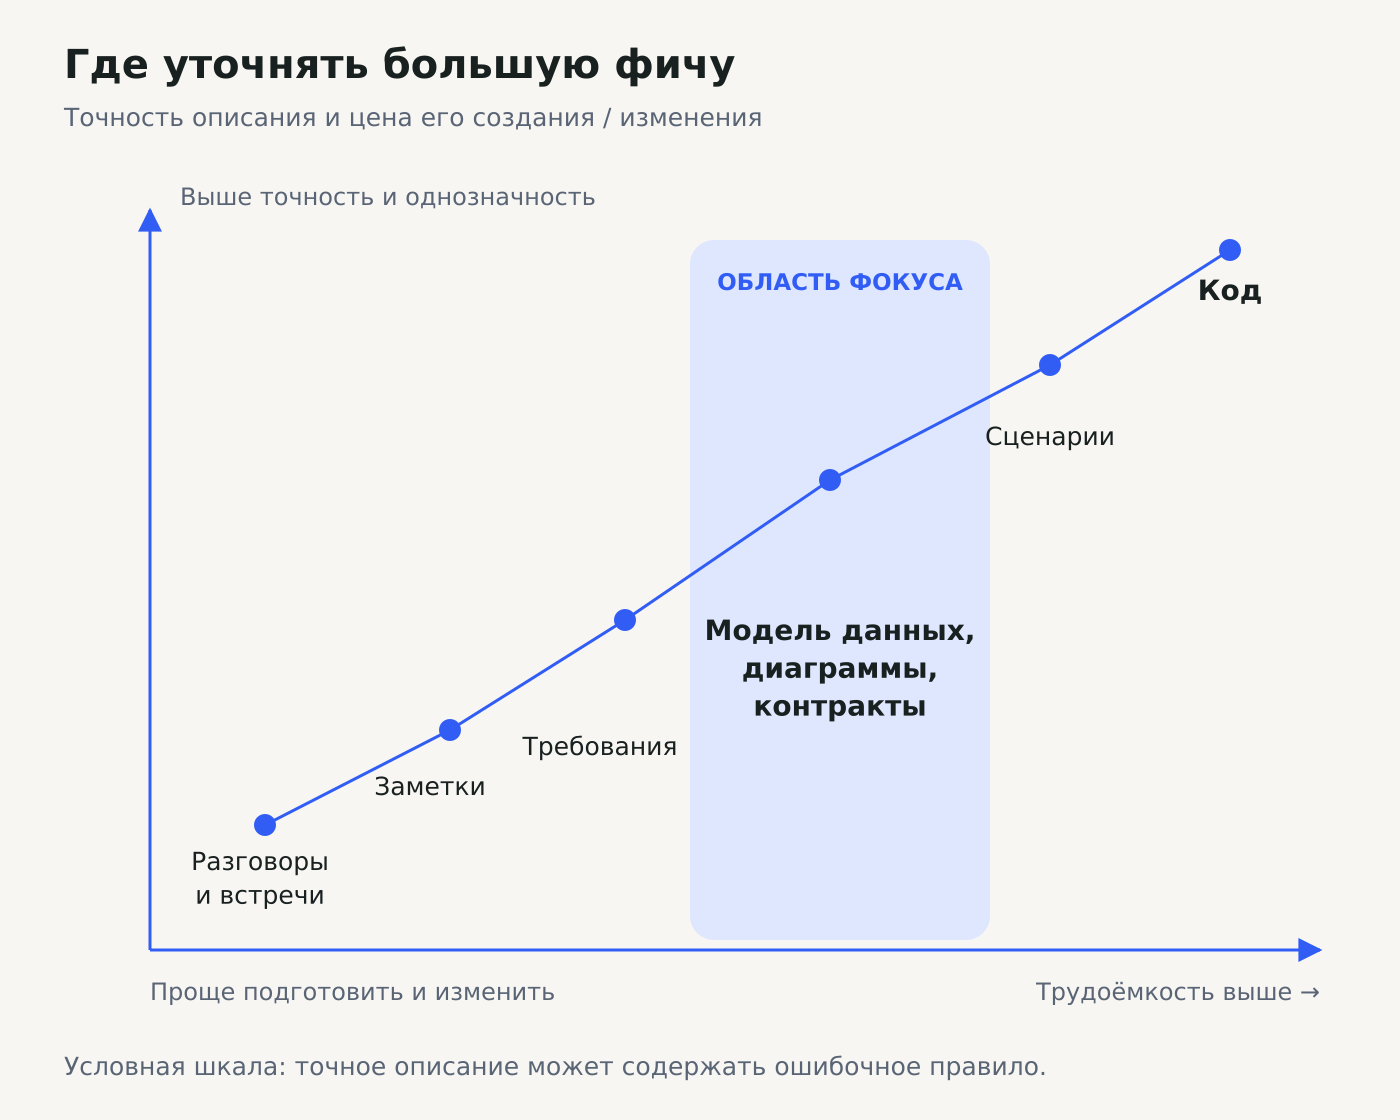
Разработка большой фичи с нуля часто начинается обманчиво легко. Заказчик объяснил идею, команда обсудила экраны, разработчики примерно представляют архитектуру. Можно приступать. Но стоит перейти от общего замысла к конкретному поведению, как появляются вопросы, на которые у каждого участника свой ответ.

Возьмём веб-систему бронирования общего оборудования. Сотрудник выбирает проектор и время, подтверждает бронь, при необходимости отменяет её. Звучит как несколько форм и CRUD. Иллюзия простоты исчезает, когда два человека одновременно бронируют один проектор, временный резерв зависает навсегда, а отменённая заявка продолжает занимать время в календаре.

Разберём, как пройти путь от такой идеи до реализации через LLM: сначала сделать правила видимыми, затем согласовать модель и контракты, после этого передавать агенту небольшие задачи. Это учебный пример, а не отчёт о внедрении или обещание определённого ускорения.

Читать далее

Как сделать RAG по профессиональной документации

Уровень сложностиПростой
Время на прочтение18 мин
Охват и читатели5.8K

Привет, Хабр! Хотелось бы начать статью с такого вопроса: кто из нас еще не использовал чат ассистентов в своей работе и повседневной жизни? Вот и мы, команда Джеймикс, постоянно используем ИИ-агентов и ассистентов в своей рутине. Кто с нами не знаком — мы (Джеймикс, Jmix) open-source  платформа с ИИ-инструментами для стандартизации разработки корпоративных приложений на Java. И так уж вышло, что у нас есть потребность в постоянной поддержке нашего сообщества в эксплуатации и разработке на нашей же технологии. На это мы постоянно выделяли одного разработчика-дежурного, который отвечал на все вопросы наших клиентов. Понимаете куда ведет это повествование? Конечно же, как только появились языковые модели, которые научились сносно отвечать на технические темы — сразу же возникла идея о делегировании самых базовых и простых вопросов ИИ. Ну и, конечно же, мы на поезде хайпа еще в конце 2023-го года создали собственного ИИ-ассистента на базе ChatGPT 4, который отвечал на темы, связанные только с платформой Джеймикса.

Время шло, мы вводили небольшие продуктовые изменения и наш ассистент стал что-то вроде системы индексатора и поисковика для мозга-нейросети. Нас устраивала точность ответов нашего ассистента — но был нюанс. Индексатор-поисковик был нужен еще для внешних агентов, которые вызывали его через отдельный MCP — и тут было больше подводных камней.

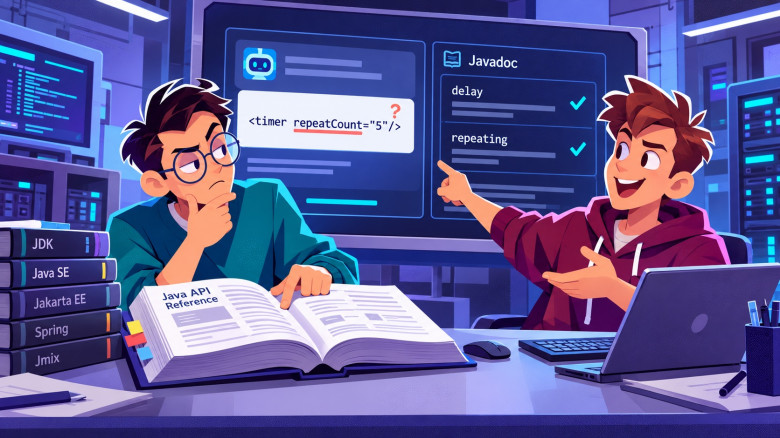
И вот прошло 3 года, и мы решили задать вопрос с подвохом (ну бывает же такое, когда хочется спросить что-то каверзное у ИИ). Звучал вопрос так: “какое значение repeatCount заставит таймер сработать пять раз”. Ассистент уверенно выдал готовый XML, хотя такого атрибута в Jmix нет. Чтобы ИИ-ассистент отвечал точнее, мы перестроили поиск. 

Читать далее

«А нам точно нужен Open Source? Мы же вайбкодим вообще всё!»

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели4.5K

«А нам точно нужен Open Source? Мы же вайбкодим вообще всё!» Это спросил друг, который делает небольшие проекты, и такой вопрос я теперь слышу постоянно. Зачем брать чужую библиотеку или сервис, если за вечер можно навайбкодить своё? Ровно под свою задачу, без лишних фич, без чужой документации и чужих багов.
Вопрос честный, и короткого ответа «потому что так правильно» на него нет. Попробую ответить развёрнуто, на своих проектах.

Читать далее

Ближайшие события

Как ИИ и телематика помогают распределять карьерные самосвалы

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели4.5K

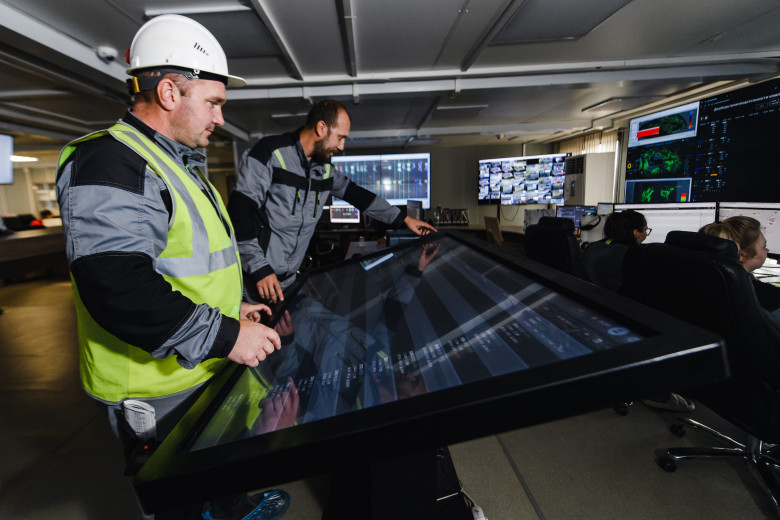
Представьте угольный разрез, по которому ездят более 200 самосвалов. Распределяют их работу диспетчеры по рации. Но человеку очень сложно обработать такое количество информации и не упустить, чтобы все было вовремя: заправка, пересменки и т.д. Как говорит статистика, за смену набегает более 10 000 отклонений от нормы – нереальное число, чтобы человек успел на все отреагировать.

Отсюда и возникла идея у инженеров «Операционного совершенства» (OES): над действующей системой мониторинга создать надстройку из ИИ-модулей, которая балансирует самосвалы и ловит потери и простои в реальном времени.

Читать далее

Кэширование: 5 неочевидных истин для системного аналитика

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели6.3K

Привет, Хабр. Меня зовут Любовь Вайгель. Я системный аналитик в СберЗдоровье — MedTech-компании №1 в России.

Во многих сценариях, сталкиваясь со снижением скорости ответа системы, компании приходят к необходимости внедрения кэша и довольно быстро реализуют кэширование на уровне технологий. Но правда в том, что кэширование, которое часто воспринимают как простой тактический приём для ускорения работы приложения, на практике может сильно изменить свойства системы: согласованность данных, поведение при сбоях, требования к актуальности и доступности информации. Поэтому для системного аналитика важно четко понимать, что мы кэшируем, зачем, на каких условиях и как это будет отражено в требованиях.

В этой статье я разберу пять неочевидных истин о кэшировании, которые часто остаются «за кадром», и покажу, как они влияют на работу системного аналитика.

Читать далее

Карьерный рост аналитика: что сделать, чтобы перейти на следующую ступень и что изменится с приходом ИИ

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели6.6K

Привет, Хабр! На связи Анна Куделина — заместитель технического директора РТЛабс по аналитике.

Пять лет назад я написала статью, как подготовиться к собеседованию на позицию системного аналитика. Она пользовалась большим спросом: 130 тысяч читателей и 263 сохранения, её публиковали в профессиональных сообществах. Мне потом написали несколько человек с отзывом о том, что статья помогла им стать аналитиком или перейти на новую ступень. Я сделала вывод, что формат передачи своего накопленного опыта по росту в карьере полезен, и решила сделать статью-продолжение.

За 6 лет в РТЛабс я прошла вертикальный путь от стартовой должности системного аналитика до руководителя аналитической функции всей компании. На этом пути менялись задачи, ответственность и способ думать. На своём опыте я теперь знаю, где именно спрятаны подводные камни, из-за которых люди застревают.

Если в первой статье речь шла о том, как аналитиком стать, то здесь — о том, что делать дальше.

Читать далее

Ловушка декогеренции

Уровень сложностиСредний
Время на прочтение36 мин
Охват и читатели5.2K

В этом эссе я ввожу понятие декогеренции, то есть накопления в системе моделей, которые по отдельности вполне работоспособны, но несовместимы друг с другом или дублируют друг друга. В такой системе основные затраты на изменения приходятся на согласование этих моделей и предотвращение непредвиденных побочных эффектов.

Иными словами, это то, что происходит, когда низкопробная мешанина заглушает полезный сигнал в бескрайнем море шума.

Читать далее

Потерянные ключи шифрования, или изучение атомарности в Cassandra

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.3K

Привет, Хабр! На связи системный аналитик Илья Глазунов и разработчик Кирилл Дунаев. Мы работаем с платформой аналитического карточного хранилища Т-Банка. Попутно открываем все новые грани одного из главных компонентов нашего детища — Apache Cassandra. 

Мы уже изучили тонну материалов, сами стали носителями знаний, делимся ими в команде и на Хабре. Но не перестаем натыкаться на интересные механики и особенности Cassandra, которые приходится разбирать по принципу «с миру по нитке». 

Та механика, о которой пойдет речь, могла проявиться только в системе со специфическим дизайном, предназначенной для очень конкретных задач, при значительной нагрузке на запись и высоком коэффициенте параллельности.

В статье разберем, почему утверждение «Cassandra — колоночная БД» частично верное. Приоткроем занавес, как база данных работает с мета-данными и объединением неизменяемых файлов при высокой пишущей нагрузке. А еще подискутируем на тему понятия атомарности операций во вселенной Apache Cassandra и разберемся, причем же тут UDT и frozen UDT. 

Читать далее

Как мы незаметно перемещаем десятки петабайт данных внутри S3

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели6.6K

Всем привет! Меня зовут Никита, я старший разработчик в команде Storage. Мы делаем собственное S3-совместимое хранилище в Ozon, которое уже хранит 130 PB данных. Какое-то время назад мы очень подробно рассказали почему нам перестали подходить коробочные решения, по каким критериям мы выбирали технологии для собственной реализации и с деталями описали основную схему получившегося хранилища.

Хранилище постоянно растёт, и вместе с ним появляются задачи, которых раньше просто не существовало в таком масштабе. Одна из них звучит довольно просто: как перенести огромный бакет из одной части S3 в другую, продолжая принимать запросы на чтение и запись и не заставляя пользователей вообще думать о том, что где-то идёт миграция.

Слона будем есть по частям. Чтобы понять, зачем нам понадобилось перемещать данные, сначала коротко разберём архитектуру.

Читать далее

Интеграция 1С через ESB: Digital Q.Integration — OData‑коннектор

Время на прочтение6 мин
Охват и читатели4.6K

На связи Сергей Скирдин, технический директор ИТ-интегратора «Белый код». Уже 2 года я делаю подробные обзоры на продукты класса ESB. Появилась идея детально разобрать решения, которые предлагают те или иные платформы, для интеграции с 1С. В этом материале про возможности Digital Q.Integration.

Читать далее
1
23 ...