Обновить
32K+

Облачные вычисления *

Концепция общего доступа к ресурсам

47,24
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

DBaaS в VMware Cloud Director: как связать Data Solutions Extension и Data Services Manager

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели4.9K

Создать виртуальную машину с PostgreSQL или MySQL несложно. Гораздо труднее превратить базу данных в полноценный облачный сервис, которым арендаторы смогут управлять самостоятельно. Для этого необходимо объединить управление ресурсами, разграничение доступа, резервное копирование и обслуживание СУБД.

В экосистеме VMware эту задачу решает связка Cloud Director, Data Solutions Extension и Data Services Manager. Разберём, как взаимодействуют эти компоненты, как организовать интеграцию и предоставить арендаторам PostgreSQL и MySQL в формате DBaaS. Отдельно рассмотрим инфраструктурные политики, резервное копирование и нюансы эксплуатации.

Читать далее

Как ИИ-нагрузки меняют автомасштабирование в Kubernetes

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели6K

Kubernetes обеспечивает работу значительной части контейнеризованного ПО в мире благодаря разделению обязанностей между двумя циклами управления, которым прежде редко требовалось взаимодействовать. Планировщик размещает поды на существующих узлах, а автоскейлер добавляет узлы, когда поды негде разместить. Десять лет такая архитектура работала хорошо: вычислительные ресурсы были в основном взаимозаменяемыми, и каждый цикл мог действовать, почти ничего не зная о решениях другого. ИИ-нагрузки и ускорители, на которых они выполняются, изменили условия. Для большинства задач такое разделение по-прежнему подходит, но темпы развития ИИ заставляют пересмотреть его ограничения.

Проблема проявляется в ситуации, знакомой всем, кто работает с GPU: под не удаётся разместить, хотя доступные мощности кластера ещё не исчерпаны. Пока под ждёт, дорогостоящие ускорители могут простаивать. Первое предположение — в регионе закончились ресурсы, и иногда причина действительно в этом. Но бывает, что мощности доступны, а под всё равно остаётся в состоянии Pending: автоскейлер готов добавить узел, который планировщик не сможет использовать.

Автоскейлер отвечает на вопрос, для которого его создали: нужно ли добавить узел. Однако сначала нужно понять, подходит ли конфигурация этого узла для нагрузки. Команда VK Tech перевела статью о том,  какую часть проблемы сообщество уже решило, как планирует справиться с остальным и как автоскейлер сможет лучше учитывать работу планировщика.

Читать далее

Токены жгут быстрее, чем успевают строить дата‑центры

Уровень сложностиПростой
Время чтения15 мин
Охват и читатели9.8K

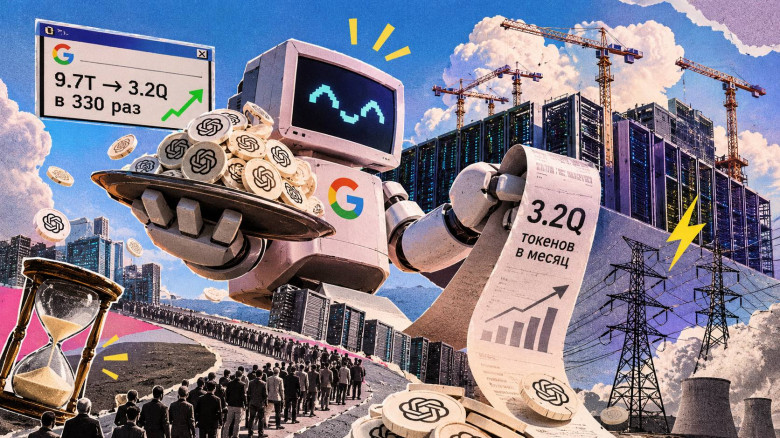
Два года назад Google обрабатывал 9,7 триллиона токенов в месяц. А уже весной 2026-го гендиректор Google Сундар Пичаи назвал со сцены конференции I/O уже больше 3,2 квадриллиона. Это рост примерно в 330 раз.

Представьте ресторан, в который за пару лет стало ходить в сотни раз больше гостей. Блюда подешевели, повара готовят быстрее, а очередь всё равно тянется по всей улице, потому что газ к новой кухне обещают подвести только лет через пять. Примерно так сейчас выглядит индустрия ИИ. Блюда здесь — токены, кухни — дата‑центры, газ — электричество. Чипы компании ещё как‑то находят, а подключение к сети не ускоришь никакими деньгами.

Сегодня посмотрим, как растёт расход токенов у Google, Microsoft, OpenAI и Amazon и почему удешевление токена не сокращает общий счёт. Потом разберём, сколько денег и гигаватт под это закладывают и где всё упирается в подстанции.

Читать далее

На страже доступа: опасные разрешения встроенных субъектов Kubernetes

Время чтения5 мин
Охват и читатели7.2K

Авторизация в Kubernetes — важная, но сложная составляющая безопасности кластера. Ошибки в её настройке могут иметь серьёзные последствия: злоумышленники получают возможность закрепить и расширить доступ к критически важным ресурсам. Поэтому мы решили изучить, как в реальных кластерах настроено ролевое управление доступом (RBAC). В частности, мы рассмотрели привязки, которые могут предоставлять некоторым встроенным субъектам широкий доступ к ресурсам кластера.

Читать далее

Serverless в 2026: когда выгоднее платить за код, а не за сервер

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели4.8K

Serverless — это уже не про «модно», а про математику. И точка перелома наступает раньше, чем вы думаете.

При 100 тыс. вызовов в месяц AWS Lambda почти бесплатна. При 259 млн вызовов (100 rps) — уже ~$484, и в этот момент две инстанции 4 vCPU за $306 выигрывают. Плюс с 2025 года AWS тарифицирует фазу инициализации: миллион холодных стартов подорожал в 22 раза.

В статье — формула стоимости, реальные цифры по AWS и Yandex Cloud, скрытые расходы (API Gateway, ожидание ответа БД, связка памяти и CPU в Lambda) и правило, когда serverless реально выгоден, а когда — контейнеры

Читать далее

Опубликован рейтинг Tор500 суперкомпьютеров в мире

Время чтения3 мин
Охват и читатели6.8K

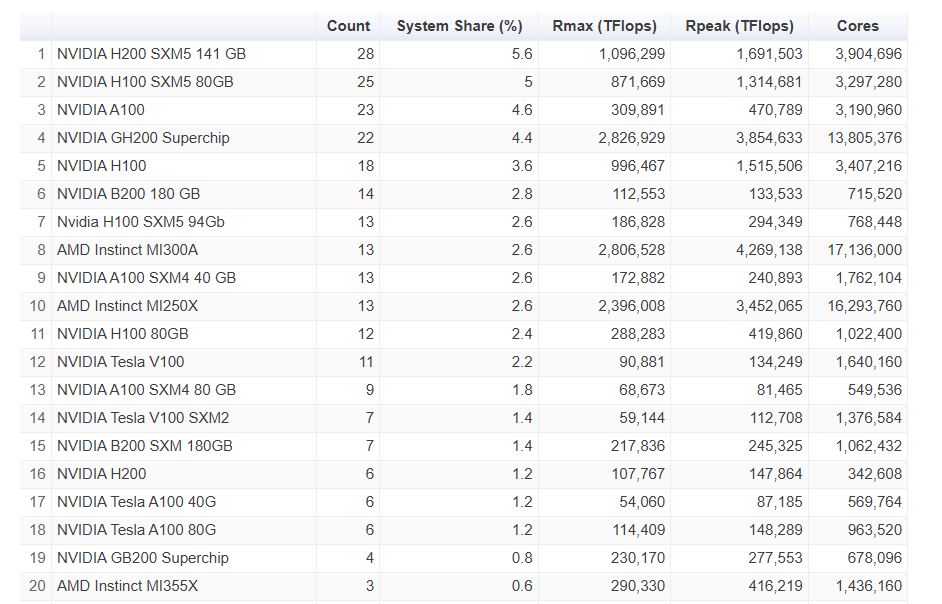
Вышел новый рейтинг Tор500 суперкомпьютеров. В нём система LineShine из Китая сохранила лидерство с производительностью 2,198 эксафлопс в секунду.

Читать далее

Пакет с пакетами: заворачиваем балансировщик в VXLAN, VRF и свой CNI

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели5.5K

Что такое балансировщик? Коробочка, одна стрелка на входе и несколько на выходе. Но не в облаке. Вопросы к этой схеме в контексте облачных сервисов начинаются еще на первой стрелке. Но как пакет вообще попадет в эту коробочку?

Читать далее

Теперь ИИ-компании вкладывают миллиарды в генерацию энергии

Время чтения2 мин
Охват и читатели11K

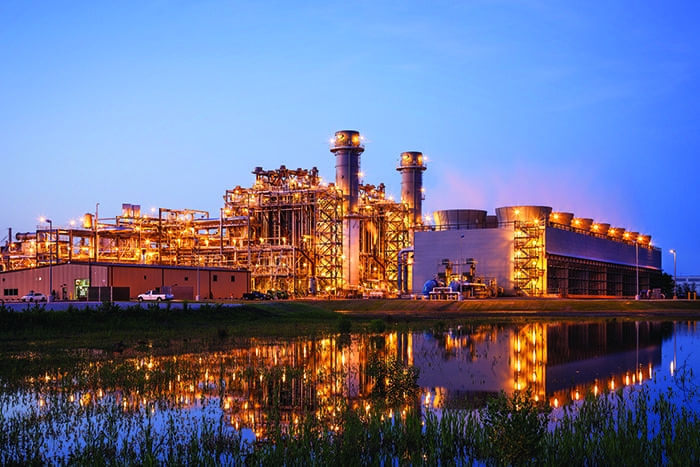
Компания Anthropic заплатила OnePWR Solutions 3,4 млрд долларов. Раньше такие суммы фигурировали в поставках чипов, но на этот раз речь о газовых генераторах для выработки 1,7 ГВт мощности для дата-центров. По данным Financial Times, это крупнейшая разовая закупка энергооборудования ИИ-компанией.

Мы уже привыкли к дефициту чипов для ИИ, особенно высокопроизводительной памяти и GPU, поставки которых расписаны до 2030 года. Теперь наступил черёд ресурсов для работы этих чипов. Текущие энергетические мощности США оказались очень ограничены, а запуск ИИ-центров вызывает протесты местных жителей, для которых стоимость энергии возрастает в разы, – поставщикам выгоднее продать её владельцам дата-центров. Сроки подключения к энергосетям растягиваются до того же 2030 года. Чтобы их сократить, ИИ-компании переключаются на автономную генерацию и даже закупают отработанные авиационные турбины.

Показательно, что Anthropic выбирает не «зелёные» источники энергии, а газ и атомную энергию. Для работы дата-центров нужна постоянная энергия, недопустимо зависеть от облачности и силы ветра. А возможные штрафы за выбросы углерода станут лишь ещё одной строчкой в расходах.

Такой же подход и у других ИИ-компаний: SpaceXSI Илона Маска использует газовые турбины для суперкомпьютеров серии Colossus в Теннесси и Миссисипи, Meta* развивает собственную газовую генерацию в Огайо. Microsoft, Amazon и Google перезапускают атомную энергетику США для получения постоянного источника энергии. Например, Google вложил более 4,4 млрд долларов в Constellation Energy для модернизации текущих АЭС и получения дополнительных 890 МВт мощностей в ближайшие 20 лет.

Читать далее

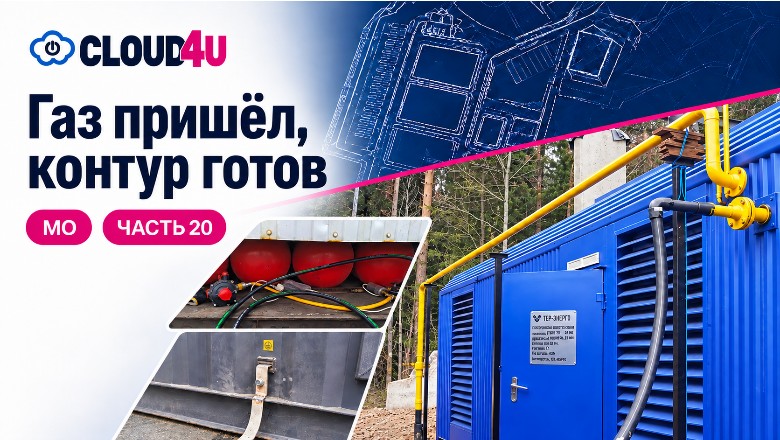
ЦОД в Марфино: газопровод, заземление и путь к энергонезависимости

Время чтения5 мин
Охват и читатели7K

В энергетике ЦОД нет второстепенных деталей. Генераторы могут стоять на фундаментах, но без инженерной инфраструктуры они так и останутся дорогим оборудованием. Показываем, как собирается энергосистема Марфино, и отвечаем на непростые вопросы читателей.

Читать далее

Руцентр запускает облачную инфраструктуру с Kubernetes, S3 и GPU

Уровень сложностиПростой
Время чтения1 мин
Охват и читатели10K

Руцентр представил собственную облачную инфраструктуру для корпоративных клиентов. Сейчас сервисы проходят закрытое тестирование, а общедоступный запуск запланирован до конца 2026 года.

Читать далее

Инфраструктура облачного провайдера ActiveCloud подверглась кибератаке типа ransomware

Уровень сложностиПростой
Время чтения2 мин
Охват и читатели10K

10 ноября 2026 года инфраструктура облачного провайдера ActiveCloud подверглась кибератаке типа ransomware, что привело к шифрованию злоумышленниками части облачной инфраструктуры.

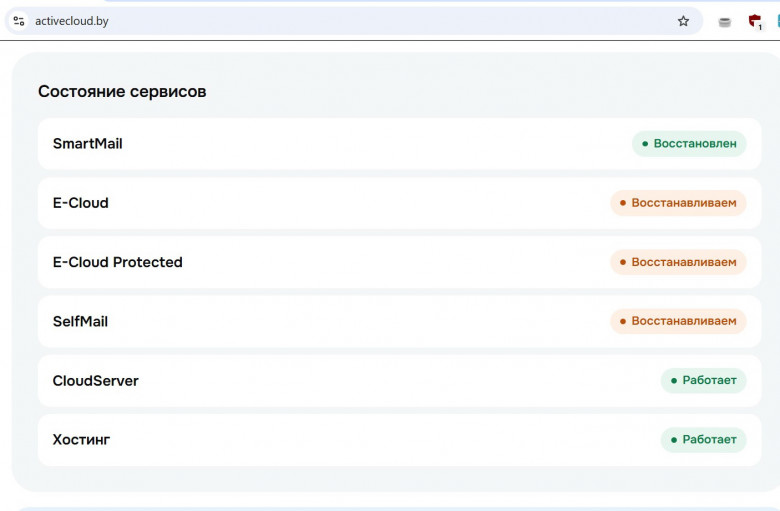
На данный момент восстановлена работа сервиса SmartMail, еще недоступны E-Cloud, ECP и SelfMail. Команда ActiveCloud работала над восстановлением всю ночь, без перерывов. Восстановление происходит поэтапно, сейчас ведутся работы по восстановлению E-Cloud. О каждом восстановленном сервисе они сообщают в своём телеграм канале - https://t.me/s/activecloud_by.

За состояние сервисом можно также следить на официальном сайте https://activecloud.by/

Читать далее

Какие GPU выбрать для обучения ИИ, инференса и работы с графикой: обзор возможностей Рег.облака

Уровень сложностиПростой
Время чтения1 мин
Охват и читатели8.1K

В публичном облаке Рег.облака теперь можно самостоятельно заказать серверы с NVIDIA H100 и RTX PRO 6000 Blackwell, оформить предзаказ NVIDIA H200 или подписаться на уведомление о появлении свободных GPU-ресурсов.

В линейке Cloud GPU Pro представлены три ускорителя для разных вычислительных задач. Разберем, какой из них выбрать 👇🏻

Читать далее

Tatarnetes собирается как суп, Sheeternetes подружился с K8s, Kyvernetria работает на аллелях и другие новости *нетесов

Время чтения16 мин
Охват и читатели6.9K

Вам это, скорее всего, неинтересно, но у меня с самого начала была тактика, и я ее придерживаюсь. В общем, очередная пачка апдейтов моих *нетесов, иронично-исследовательских надстроек или форков куба, начиная с Kyvernetria и Tatarnetes и заканчивая Mysoginetes и Kyvernetria. Новые фичи, новые релизы и всё такое.

Читать далее

Ближайшие события

Инфраструктура завтрашнего дня и K8s для нее: без нод и контейнеров, но с планировщиком электричества

Уровень сложностиСложный
Время чтения90 мин
Охват и читатели9.1K

Инфраструктура почти всегда строится под вчерашние задачи. Unix проектировали для машин с разделением времени, TCP/IP — для сети, которая должна пережить потерю узлов, Borg — для одной компании с собственными ЦОДами, где разнородность машин в основном пряталась за единой моделью ресурсов, а Kubernetes унаследовал от Borg почти всё, что в нём лежит глубже API. Каждая из этих систем была блестящим ответом на свои вопросы, и каждую потом десятилетиями натягивали на вопросы, которыми их авторы даже не задавали. То есть сегоняшние задачи решает конвенциональное решение, принятое индустрией, которое для их решения не предназначено.

В этой статье мы попробуем подойти к этой проблеме с другого конца. Сначала разберёмся, какие задачи будут решаться завтра, какой станет физика вычислений, экономика и требования к доверию, и только потом выведем из этого соответсвующий инфраструктурный слой и соберем прототип, который выбирает не только место и время для задачи, но и саму физику вычисления (от процессора до квантового компьютера и живых нейронов).

Читать далее

Хостинг‑провайдер ESTT: причина сбоя инфраструктуры — кибератака с использованием программы‑шифровальщика

Время чтения2 мин
Охват и читатели7.6K

Хостинг-провайдер ESTT сообщил о причинах аварии 8 ноября и текущем ходе восстановления сервисов. По предварительным данным, причиной аварии стала кибератака с использованием программы-шифровальщика. В результате пострадали кластеры виртуализации и системы управления облачной инфраструктурой ESTT, что привело к нарушению работы клиентских сервисов.

Читать далее

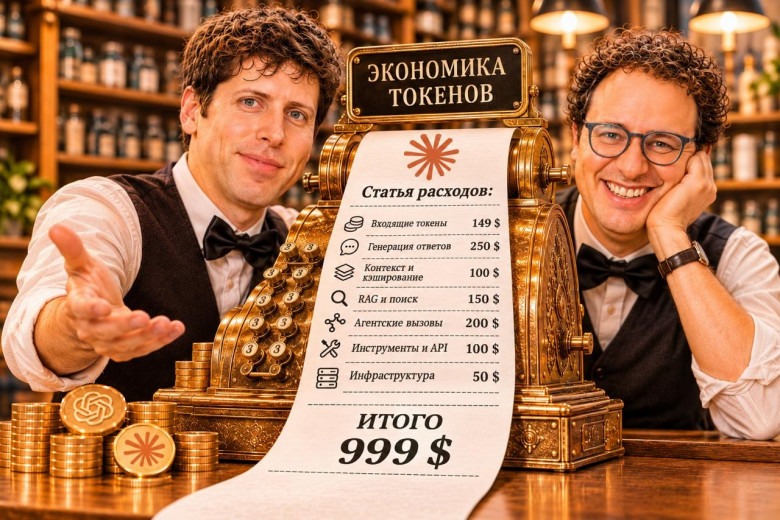
Токены дешевеют, а счета за ИИ растут. Экономика LLM на конец 2026 года

Уровень сложностиСредний
Время чтения22 мин
Охват и читатели8.2K

Всем привет!

В предыдущих статьях я разбирал локальный инференс: на каком железе запускать большие языковые модели и как подключить их к Claude Code. Локальные модели хороши тем, что за каждый токен платить не нужно. Но в мировой корпоративной практике основная нагрузка приходится на облачные модели OpenAI, Anthropic и Google, и вопрос их стоимости становится для продуктовых команд одним из ключевых при планировании.

При этом картина складывается противоречивая. Исследователи фиксируют, что «интеллект» дешевеет на порядок в год. Однако новые флагманские модели 2026 года вышли дороже предшественников, провайдеры урезают лимиты подписок, а корпоративные расходы на ИИ продолжают расти.

Читать далее

Дайджест Рег.облака за октябрь

Уровень сложностиПростой
Время чтения2 мин
Охват и читатели3.9K

В октябре расширили каталог ИИ-моделей, запустили инференс на NVIDIA B300, усилили защиту облачного WAF и обновили личный кабинет. Месяц прошел под знаком больших вычислений и небольших улучшений, которые упрощают повседневную работу. Собрали главное за месяц, приглашаем подвести итоги вместе с нами. 

Читать дальше →

Scale-to-zero для LLM: на что уходят 294 секунды после первого запроса

Время чтения14 мин
Охват и читатели6.3K

Когда запросы к LLM приходят лишь несколько раз в день, GPU большую часть времени простаивает, но платить за ноду приходится круглосуточно. Хочется освобождать карту между запросами: удалять поды с моделью, когда нагрузки нет, и запускать их снова, когда она появляется. Для обычного веб-приложения такая схема работает с задержкой в несколько секунд, и это вполне допустимо. LLM же после запуска пода нужно загрузить веса и прогреть движок, поэтому первый запрос может ждать ответа несколько минут.

В июле команда H Company рассказала, что новая реплика их крупнейших моделей выходила в готовность до 27 минут. Команда использует vLLM на GPU-нодах Kubernetes и добавляет реплики по мере роста нагрузки от агентов. Автоскейлер быстро увеличивает число подов, но дальше начинаются скачивание образа, загрузка весов, компиляция и прогрев движка. Ускорить эти этапы настройками масштабирования не получится.

Я ожидал, что большую часть времени занимает загрузка весов, и решил посмотреть публичные замеры. У Tensorfuse запуск Llama 3.1 8B на L40S занял 294 секунды, из которых на скачивание модели и перенос весов в GPU ушло только 94. Остальные 200 секунд потребовались на компиляцию, захват CUDA graphs, инициализацию движка и импорты. Значительную часть этой работы новый под повторяет при каждом старте, хотя её результаты можно сохранить на ноде.

В статье разберём, как настроить запуск LLM из нуля и сократить холодный старт: откуда KEDA получает сигнал о нагрузке, пока подов нет, что стоит заранее закэшировать и какие таймауты позволят первому запросу дождаться модели. На публичных замерах посмотрим, сколько времени дают эти оптимизации, а затем перейдём к манифестам KEDA HTTP Add-on, DaemonSet для предзагрузки и настройкам vLLM. Это поможет платформенным инженерам оценить, подходит ли такой режим их нагрузке или лучше оставить тёплую реплику.

Читать далее

Пентест по PTES: руководство по Metasploit от создателей индустрии

Время чтения4 мин
Охват и читатели5.6K

Пентестерам посвящается. Вы запустили готовый модуль, получили доступ к системе — и на этом все остановилось. Как понять, что вообще дает этот доступ? Через неделю выясняется, что ваш пэйлоад ловит антивирус заказчика, и вы не понимаете почему. А когда проект наконец доходит до облака, выясняется, что про побег из контейнера и атаки в AD вы знаете только обрывками из случайных статей или ответов нейросети. Узнаете свою работу?

Читать далее
1
23 ...